腾讯发布Hy-Nomas:8B扩散模型打破世界模拟限制,文本与连续相机控制双向交织
原创 CV君 2026-10-30 22:56 江苏
自回归推演新范式
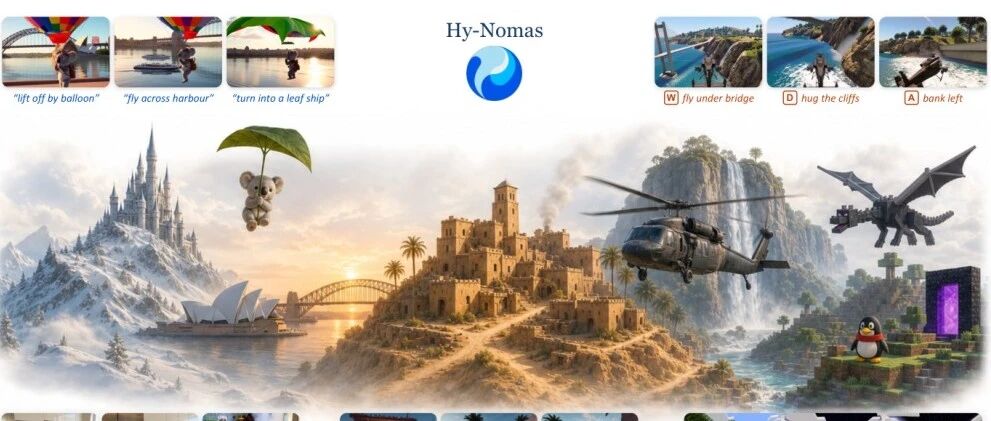
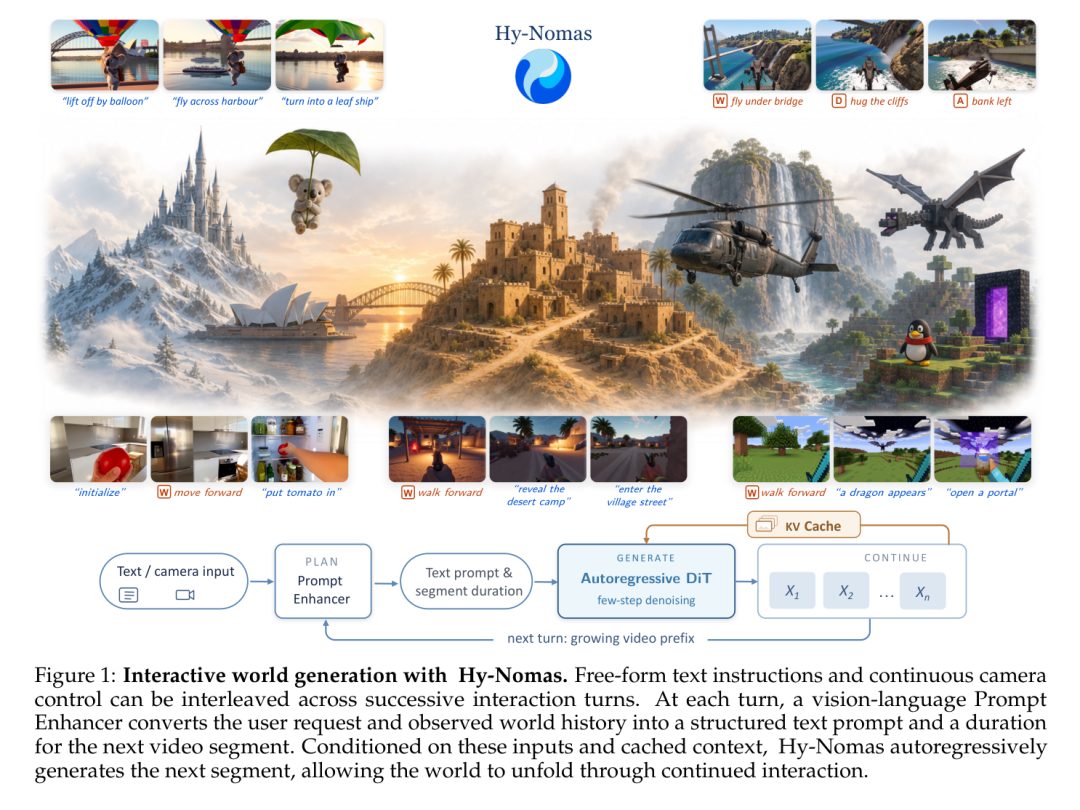
腾讯混元视觉生成团队近期发布了一项关于交互式视频世界模型的重要成果——Hy-Nomas。该系统基于一个 8B 参数的扩散 Transformer 主干,首次在单一生成架构中原生融合了自由文本指令交互与连续相机轨迹漫游。
模型命名解析:Hy-Nomas 的名称由“Hy”(Hunyuan,代表腾讯混元体系)与“Nomas”(源自希腊语词根,意为“游牧者、漫游者”,象征着在虚拟生成世界中穿梭探索)结合而成,寓意其兼具语义演变跟随与广阔空间自由漫游的能力。
Hy-Nomas 支持长达数分钟的连续交互生成。针对自回归扩散模型中常见的“动作抢跑”、“旧动作反复重播”以及“自回归误差自放大”等痼疾,系统通过引入动作感知因果注意力与段级自暴露训练(Segment Forcing),为交互式世界模型建立了标准化的闭环生成架构,并配套开源了包含 280 个测试用例的系统评测基准 Hy-Nomas-Bench。

背景与动机:开环视频生成通往交互式世界的两道鸿沟
从固定提示词生成一段几秒钟的高清视频,到建立一个支持人在回路(Human-in-the-loop)的实时交互虚拟世界,存在着本质的技术代差。
首先是时序因果与语义约束的矛盾。在传统双向扩散模型(Diffusion Transformer, DiT)中,时间维度的注意力是全连通的;而视频世界模型必须以自回归的方式一帧一帧或一段一段向未来推演。如果简单地施加因果掩码,模型往往会出现严重的语义错乱:一方面,当前帧的动作容易错位或抢跑;另一方面,由于模型历史上下文一直保留着过去的文本描述,已经做完的动作(例如“拔剑”、“放下杯子”)会在后续分段中像幽灵一样反复触发重演。
其次是自回归推演中的复合误差爆炸(Exposure Bias)。在标准训练模式下,模型总是被喂入纯净的真实视频上下文(Teacher Forcing)。但在实际推理时,模型依赖的是自己上一段刚刚生成的画面。上一段微小的画面失真与语义偏差,会变成下一段的强输入证据,最终导致几轮交互之后场景迅速崩溃。
此外,现有世界模型通常将控制维度二值化或严重割裂:要么只支持离散方向键导航(如 Genie 3),要么将语义指令与相机运动拆分为多个互不相连的专门模型(如 Happy Oyster)。Hy-Nomas 的核心目标,就是用一个统合主干打通语义控制、连续相机控制与跨轮次交替混合控制。
方法详解:结构化监督与动作解耦架构
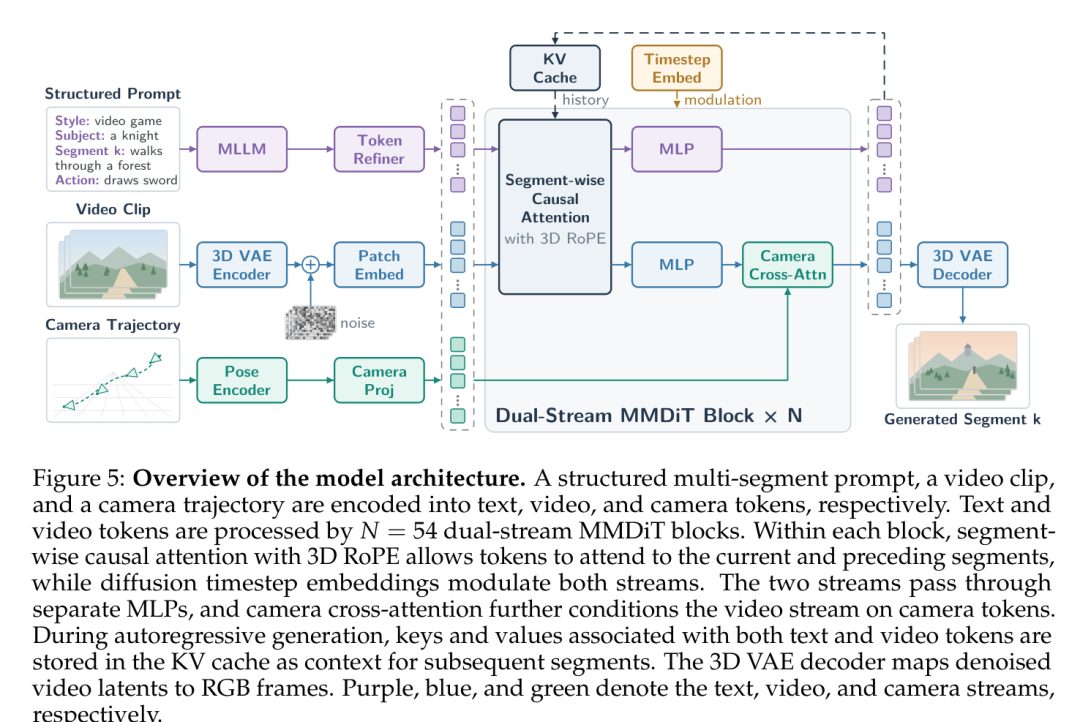
Hy-Nomas 基于 HunyuanVideo 1.5 演进而来,整体包含 54 层双流多模态扩散 Transformer(Dual-Stream Multimodal Diffusion Transformer, MMDiT Block)。为支撑超长多轮视频生成,系统在数据标注、因果掩码、显式相机注入及推演策略上进行了全链路重构。
1. 结构化字幕与动作感知因果注意力(Action-aware Causal Attention)
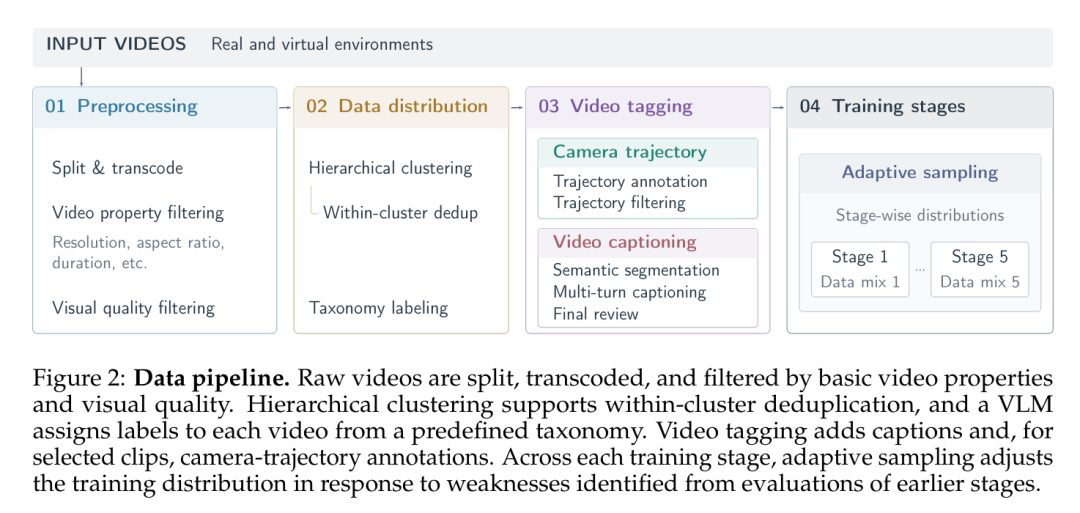
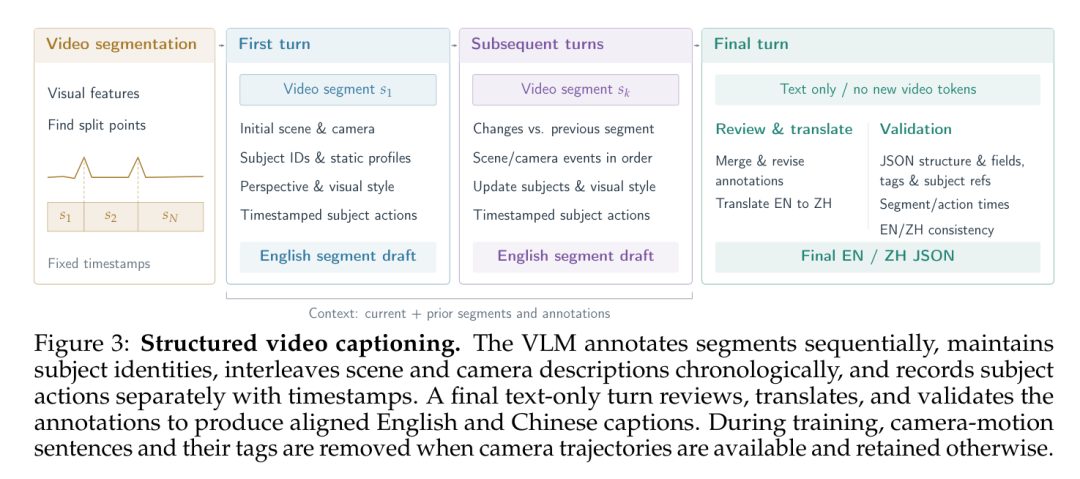
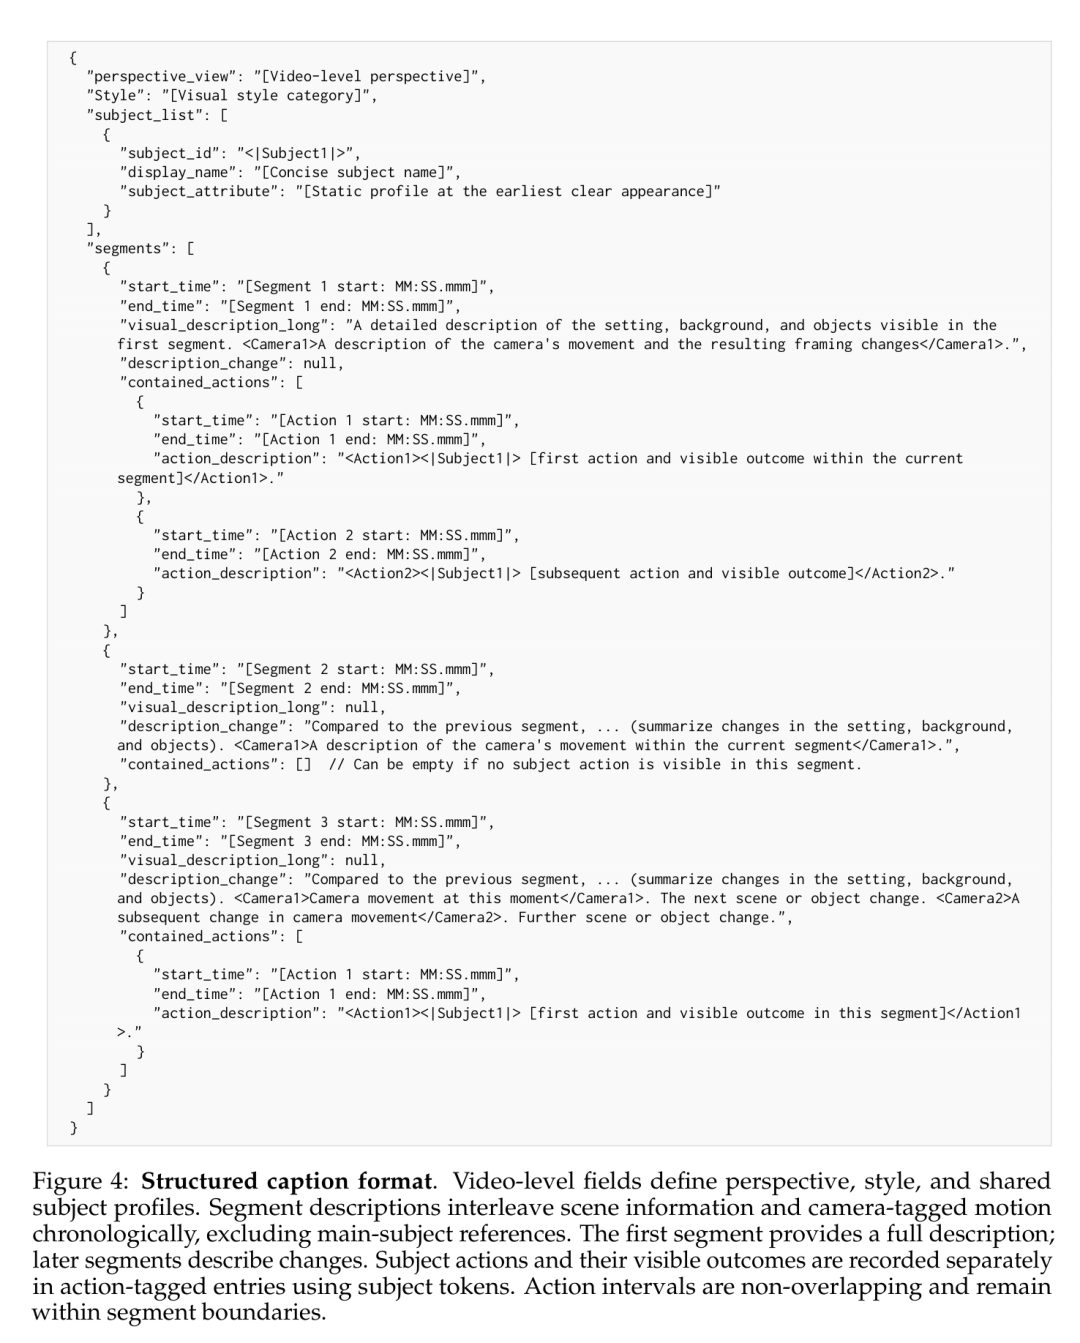
为了从数学机制上杜绝旧动作指令的跨段重播,系统在数据端利用视觉特征提取器 V-JEPA 2 与多模态大模型进行分段标注(图3),设计了严格结构化的 JSON 标注格式(图4)。在注意力层面上,系统将语义描述拆分为“环境背景前缀(Descriptive Head)”与“时间窗动作后缀(Action Tails )”。
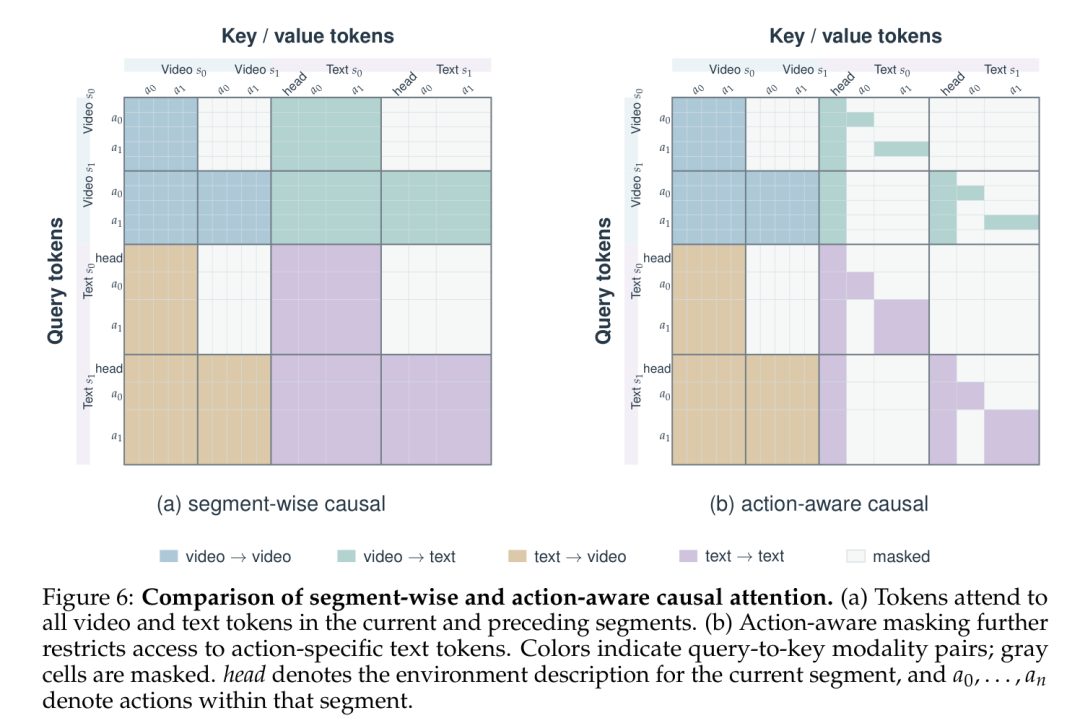
对比常规的段级因果掩码(图6(a)),Hy-Nomas 提出的动作感知因果注意力(图6(b))施加了更精密的访问隔离:
段内时序对齐:处于特定动作时间窗的视频查询标记(Query Token),仅能访问当前段的环境描述与该特定动作的描述,其他时间段的动作被完全屏蔽,消除动作抢跑;
跨段动作隔离:环境背景描述(如地貌、光影、主体初始外观)随时间向后全局开放,保留持久世界记忆;而动作文本指令仅在当前段可被查询。后续分段只能通过视觉 Token 看到过去动作遗留的物理结果,而无法再访问过去动作的文本 Token。
2. 连续相机轨迹表征与无缝混合控制
与将相机控制离散化为单一按键指令的方案不同,Hy-Nomas 接收连续的 6 自由度相对相机轨迹。在分段内,系统将相邻帧位姿变换表示为相对运动 ,将 4 帧连续变换矩阵展平为 64 维分组外参向量,通过独立的相机交叉注意力(Cross-Attention)模块与视觉特征交互。
在训练阶段,系统以 50% 的概率随机剔除相机轨迹;当开启相机轨迹注入时,系统会强行抹除提示词中的 <CameraN> 描述,杜绝文本捷径泄漏,从而让单一主干真正学会文本控制与相机漫游在任意轮次的交错切换。
3. Segment Forcing:单步外推与流式反向传播
为消除自回归暴露偏差,团队提出了 Segment Forcing(段级自暴露训练)。如图 7 所示,在处理长序列的连续视频段时,对于当前段 (输入加噪特征 与历史缓存 ),模型预测流匹配(Flow Matching)速度 :
随后,模型利用所预测的速度进行单步去噪外推,构造一个低噪声的隐变量:
并将该外推状态的键值(Key-Value)压入缓存,作为后续段 的自回归输入上下文。
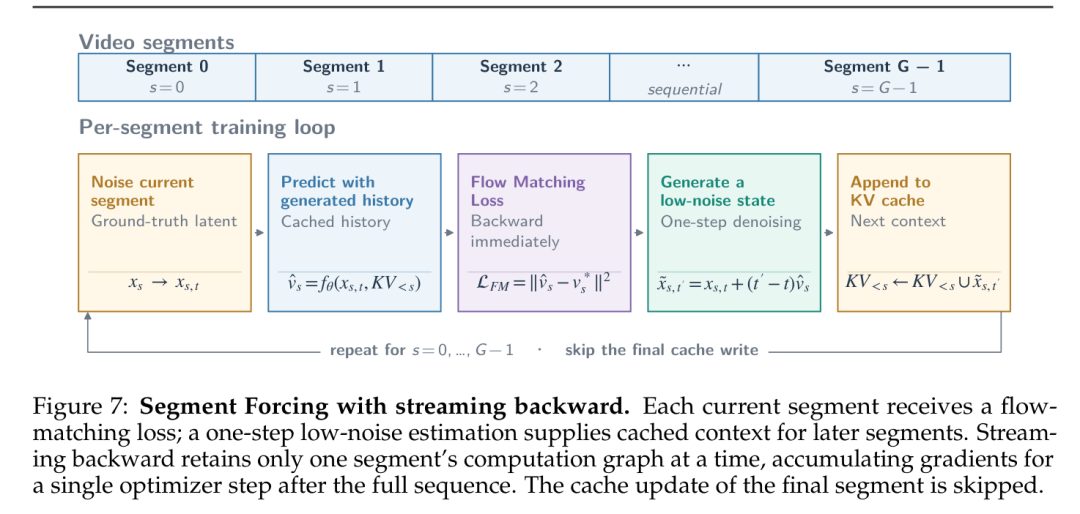
为了防止反向传播在长序列多段展开时打爆显存,系统采用了流式反向传播(Streaming Backward):计算出当前段的 后立即执行反向传播并释放该段的中间计算图与激活值,梯度在全序列跨段累加,待全序列处理完毕后再统一步进一次优化器。这使模型显存占用与展开段数完全解耦。
4. 智能体导演(Prompt Enhancer)与推理加速
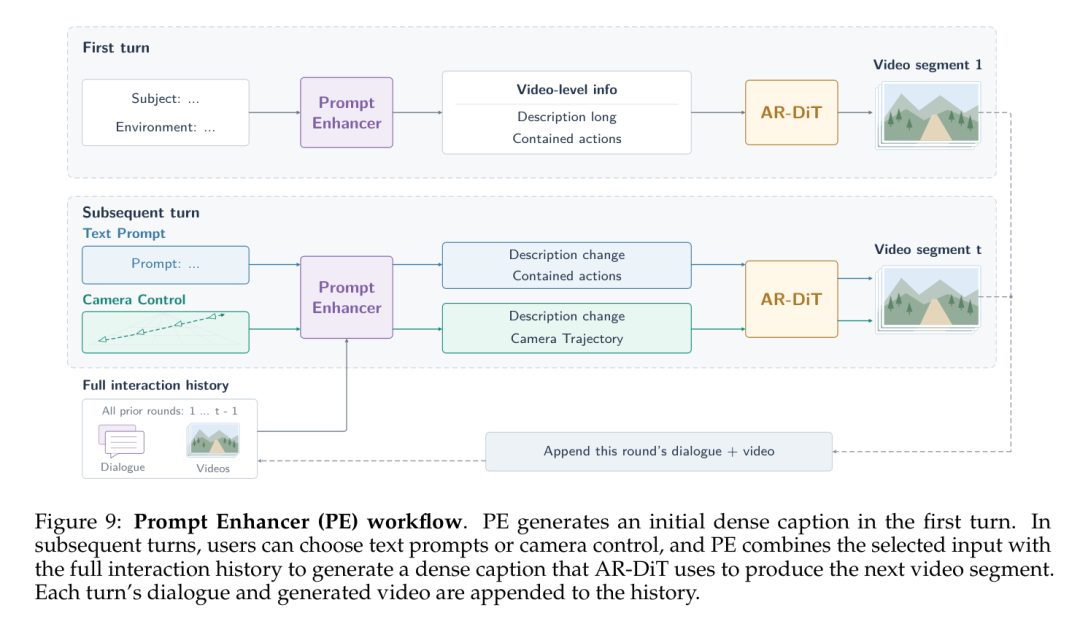
在推理阶段,用户无需手动撰写复杂的结构化字段。系统搭载了一个经多轮多模态对话微调的视觉语言模型——Prompt Enhancer (PE)。PE 作为“智能体导演”,将用户的简短输入结合上一轮生成视频与对话历史,自动扩写为标准化的分段结构化 JSON,并动态决定下一段生成的物理持续时长。
结合两阶段扩散蒸馏(Causal PCM 初始化 + DDMD 对抗精馏),模型将每段采样步数压缩至 4 步 NFE(Network Function Evaluations)。配合 INT8 权重与 KV 缓存量化、滑动窗口注意力(Sliding-Window Attention, SWA)及 CPU 卸载(Offload),在单张 NVIDIA RTX 4090(24G 显存)上生成 100 秒、跨越 7 段、1280×704 @ 24 FPS 的超长视频,峰值显存占用仅为 20.53 GiB。
实验与评测:Hy-Nomas-Bench 实战对决
为了全面检验世界模型的复杂长程推演能力,团队构建了包含 280 个用例的 Hy-Nomas-Bench,涵盖多轮文本交互(B1)、相机导航(B2)、交织混合控制(B3)与空间记忆回访(B4)四大场景。
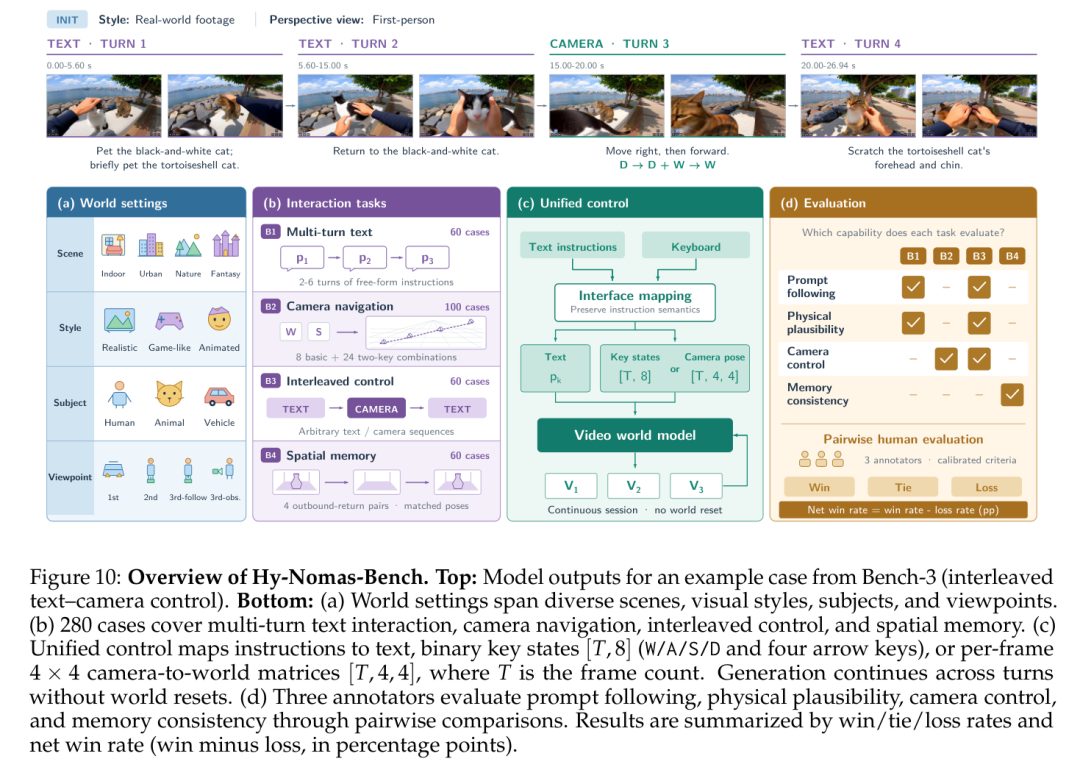
评测由 3 名独立标注员执行严格的双盲成对打分(Pairwise Human Evaluation),并统计相对净胜率(Net Win Rate = 胜率 - 败率)。
1. 多轮文本与物理交互(Bench-1)
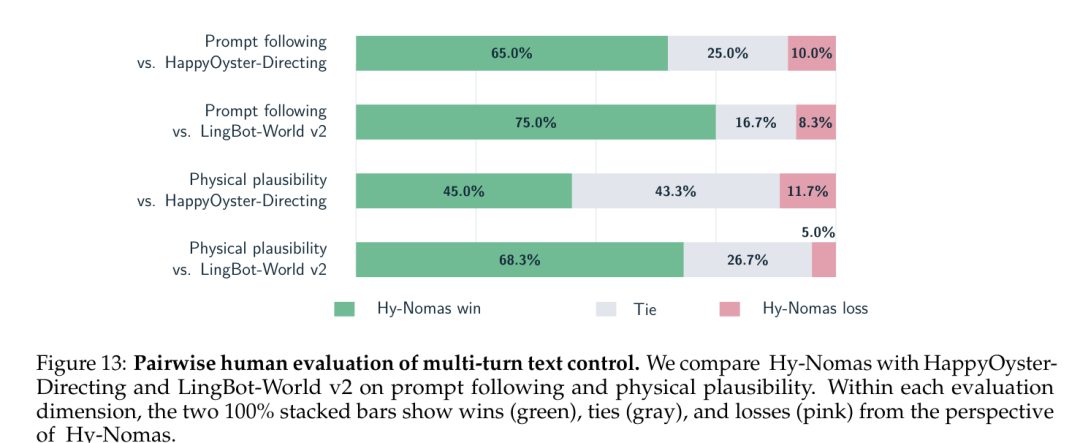
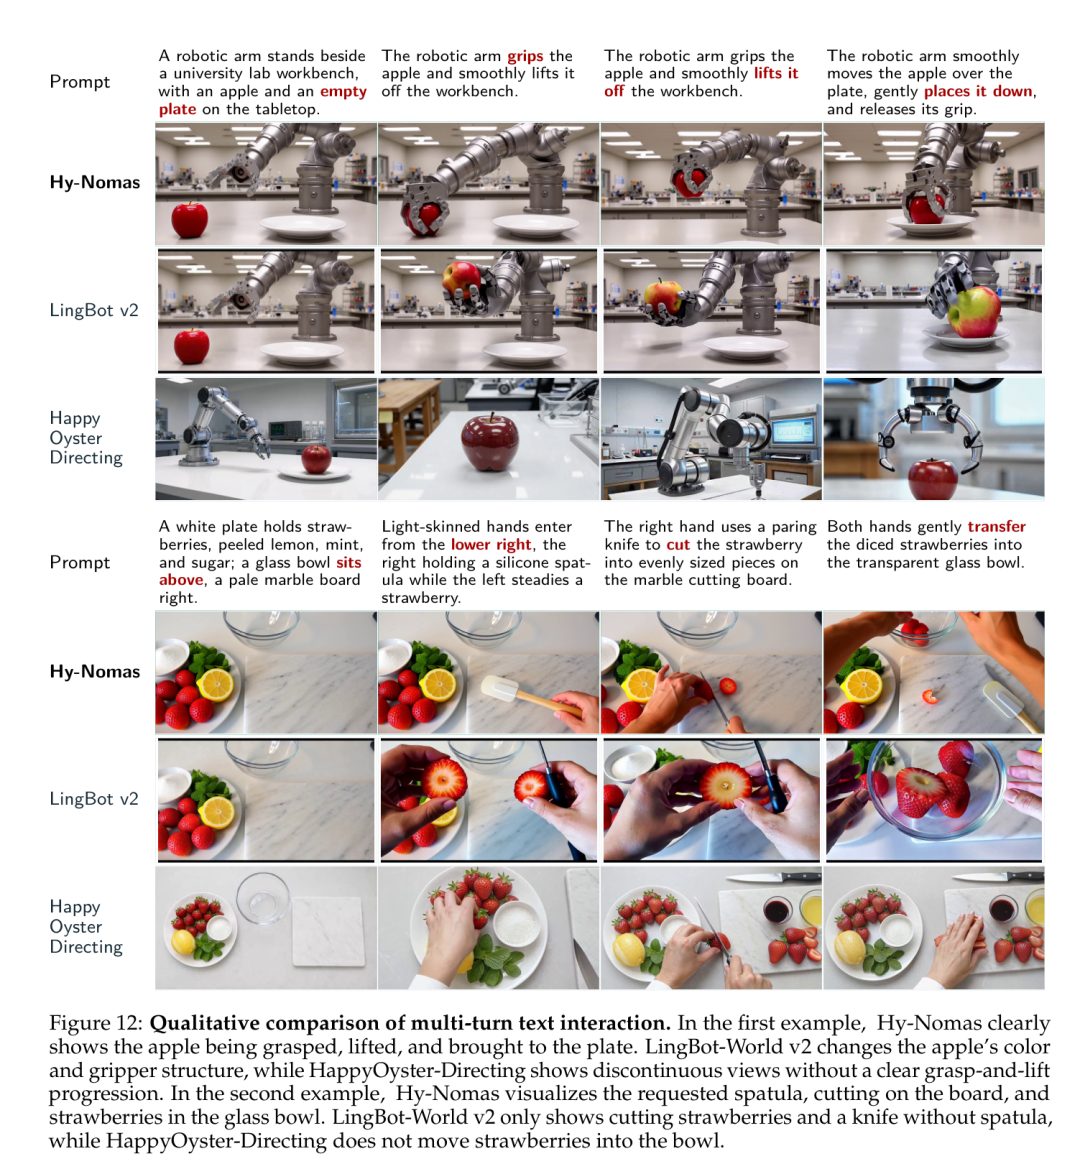
在 60 个多轮文本指令跟随场景中,面对以语义指导见长的 HappyOyster-Directing 与开源模型 LingBot-World v2:
指令遵循(Prompt Following):Hy-Nomas 相对 HappyOyster 斩获 65.0% 胜率(平局 25.0%,败率仅 10.0%);相对 LingBot-World v2 斩获 75.0% 胜率(平局 16.7%,败率仅 8.3%);
物理真实性(Physical Plausibility):相对 HappyOyster 胜率 45.0%(平局 43.3%,败率 11.7%);相对 LingBot-World v2 胜率 68.3%(平局 26.7%,败率 5.0%)。
定性对比(图12)表明,在多轮机械臂抓取苹果并放置到盘子的复杂动作链中,Hy-Nomas 完整重现了接近、合拢夹爪、提升及落盘释放的全过程,而对比模型出现了苹果颜色变异、夹爪结构形变或视角跳跃割裂。
2. 相机漫游与交织混合交互(Bench-2 & Bench-3)
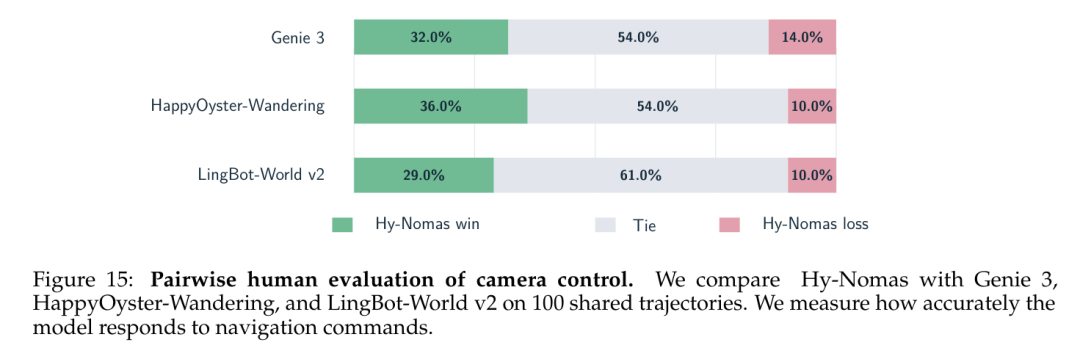
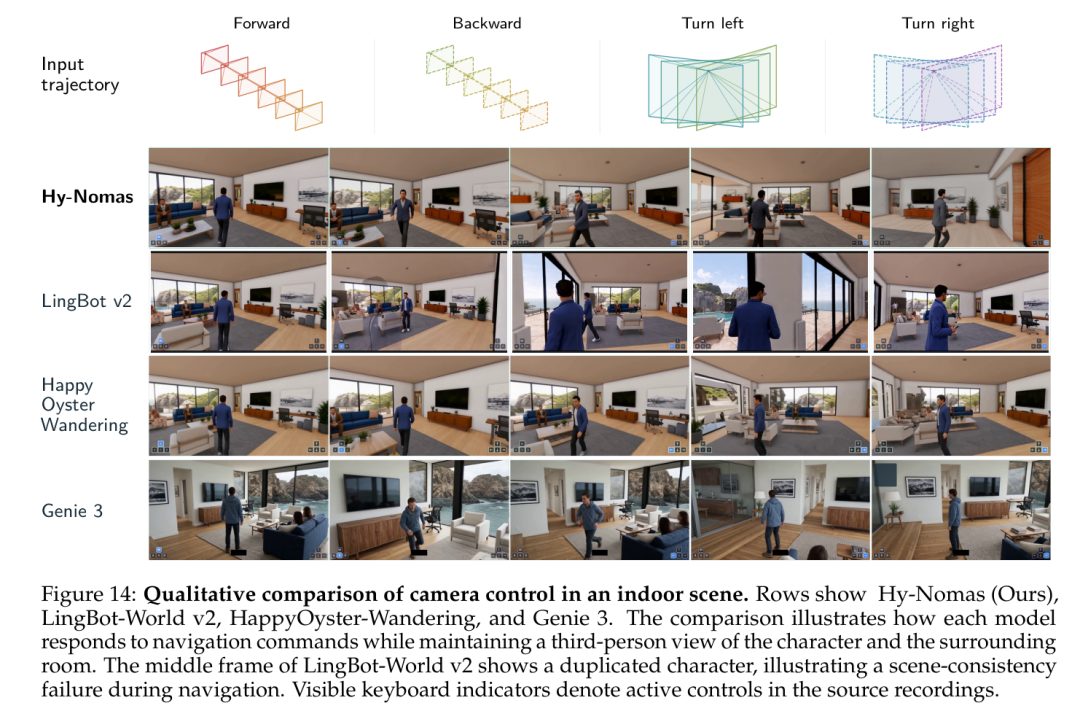
在包含 100 条复杂往返运动的相机导航基准(Bench-2)中,Hy-Nomas 表现稳定:相对 Genie 3 取得 32.0% 胜率与 54.0% 平局(败率 14.0%);面对 HappyOyster-Wandering 获得 36.0% 胜率与 54.0% 平局(败率 10.0%);面对 LingBot-World v2 获得 29.0% 胜率与 61.0% 平局(败率 10.0%)。
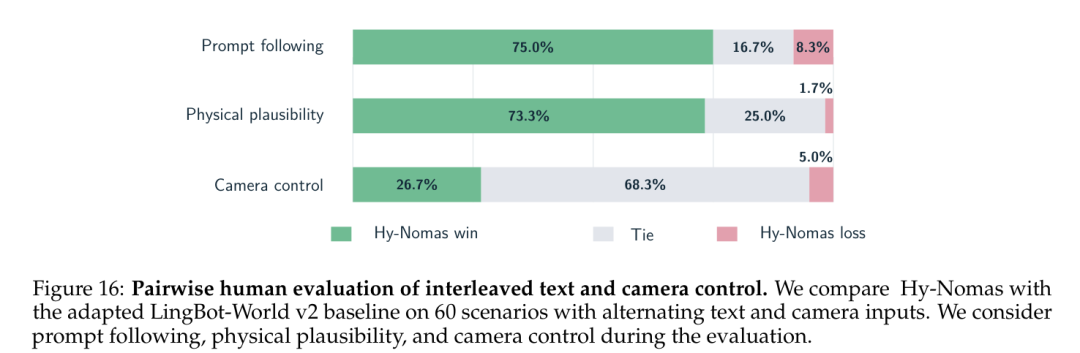
在最为严苛的文本与相机交错混合基准(Bench-3)中,系统展现出了极佳的指令连续性,面对适配后的 LingBot-World v2,在指令遵循上打出 75.0% 胜率(败率 8.3%),物理真实性上打出 73.3% 胜率(败率 1.7%),相机控制维持相当水准(胜率 26.7%,平局 68.3%)。
3. 空间记忆与回访一致性(Bench-4):客观面对短板
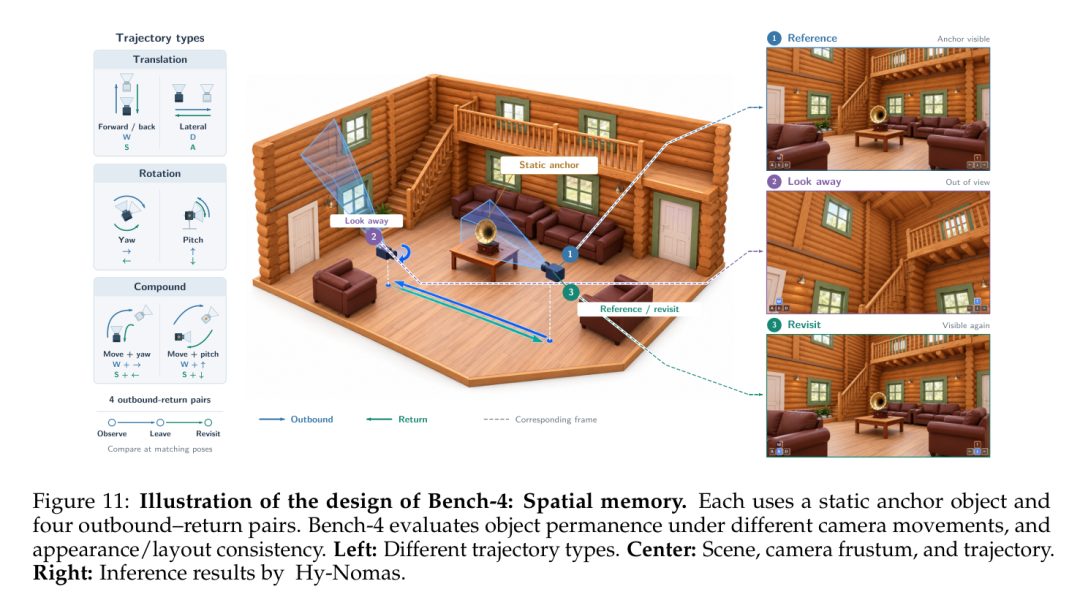
空间记忆设计了专门的“视线离开-重新回访”轨迹(图11)。面对环境内的固定锚点物体(如工具箱),模型在大幅度运镜回看时能否保持物体与场景不变?
评测数据显示:Hy-Nomas 相对 LingBot-World v2 实现了 58.3% 的绝对优势(平局 40.0%,败率仅 1.7%),并与 HappyOyster 相当(30.0% 胜 vs 23.3% 负);但在面对拥有街景真实数据先验的 Genie 3 时,Hy-Nomas 录得 13.3% 胜、56.7% 平与 30.0% 负。
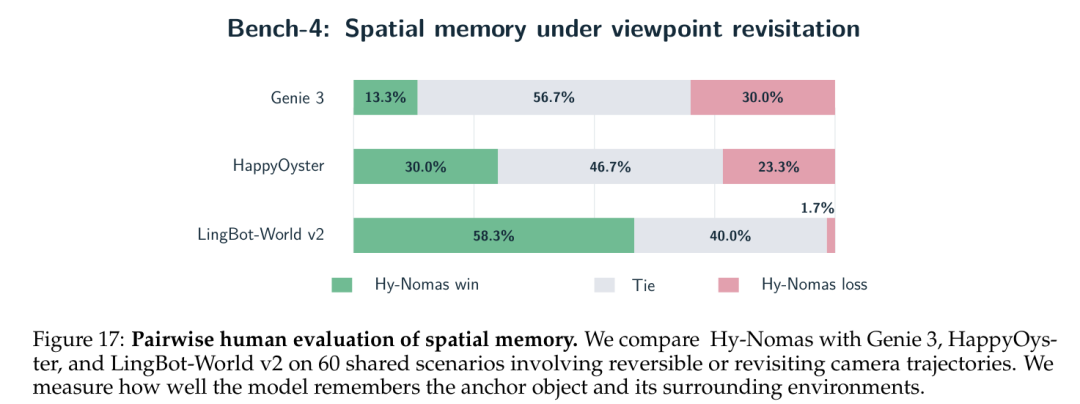
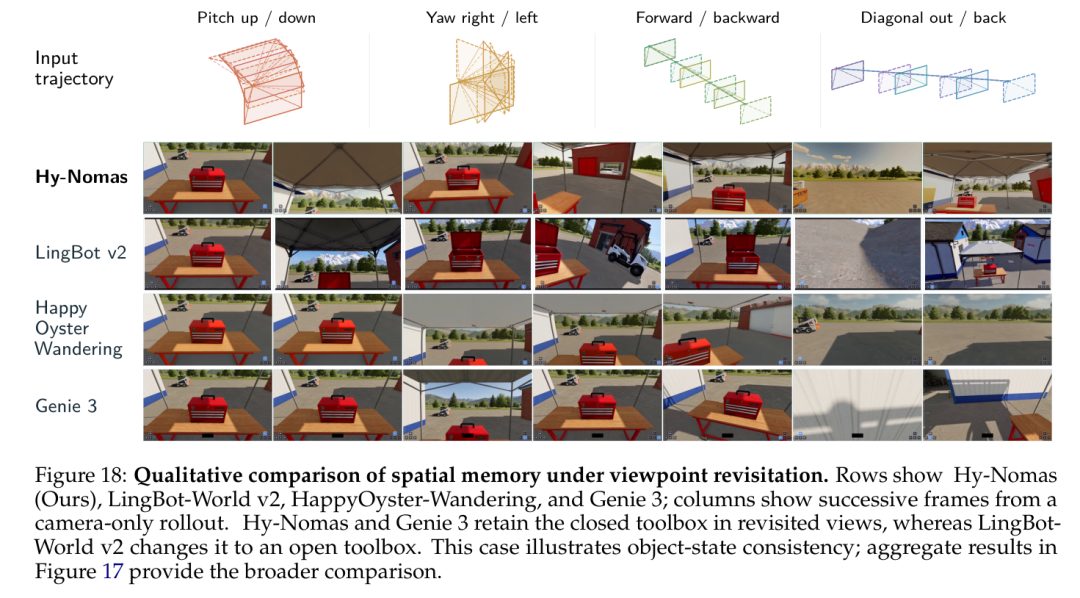
论文对此极为克制与坦诚,分析指出这一落后源自 Genie 体系对大规模物理三维街景强先验的深度结合,并指出未来可以通过显式记忆检索与环路轨迹强化来弥合这一差距。
下游低成本微调实践:LoRA 权重无缝合入蒸馏模型
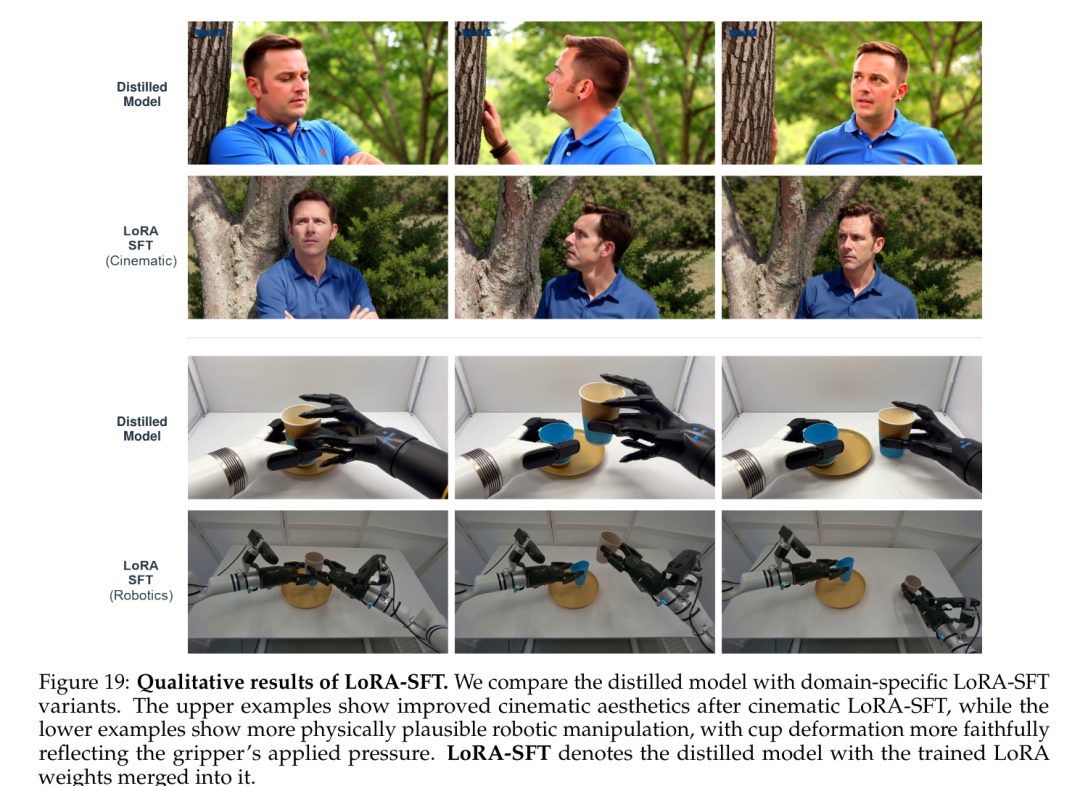
对于下游开发者与具身智能研究者,重新全量蒸馏一个世界模型的算力成本通常难以承受。Hy-Nomas 提出了一种极具工程借鉴价值的适配范式:仅在未蒸馏的基模上使用约 100 条样本完成低秩自适应(Low-Rank Adaptation, LoRA)微调,随后将 LoRA 权重直接 Merge 进 4-NFE 的蒸馏检查点。
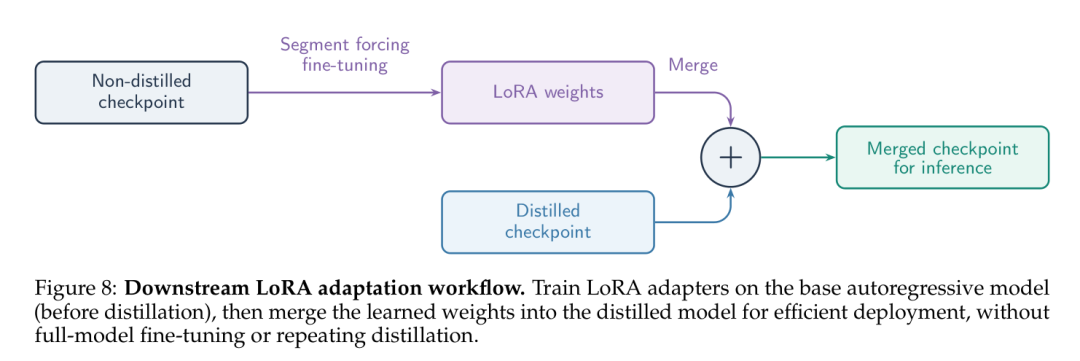
实验表明,仅用 128 条真实双臂机器人操作样本微调出的 LoRA 权重,在直接合并进蒸馏版模型后,便能顺利迁移至双臂操作这一分布外场景,且纸杯受压变形的物理反馈更加真实自然。
一点思考
从技术演变路径来看,Hy-Nomas 的最大启示在于生成架构对结构化数据规范的深度反哺。它没有盲目推崇“纯像素黑盒”的大规模暴力堆叠,而是通过对自然语言指令在时间尺度上的精确切分,配合注意力掩码与自暴露训练,优雅地化解了多轮交互中的动作重放与误差放大难题。
虽然在面对极端视角折返的长程三维空间一致性上,基于纯视频自回归的架构相比结合显式 3D 几何先验的系统仍有提升空间,但 Hy-Nomas 在单卡 4090 上的平民化部署验证、轻量级 LoRA 下游迁移机制以及兼备语义与相机交织的控制范式,无疑为多模态物理交互世界的演化铺平了关键基石。
论文标题: Hy-Nomas: Towards Free-form Interactive World Generation
论文机构: 腾讯
Hugging Face:https://huggingface.co/tencent/Hy-Nomas
混元官方介绍:https://hy.tencent.com/model/open-source-model/detail?id=hy-nomas
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。