视频生成已经很逼真,但物理保真吗?PVBench 用物体级物理量检验生成视频
原创 52CV 2026-10-31 12:25 江苏
一段生成视频里,小球落地后顺畅弹起,机械臂自然地搬动物体,镜头也足够清晰。乍看之下,它似乎已经学会了现实世界的运行方式。
但如果进一步追问:小球是否越弹越高?碰撞前后的动量是否合理?机械臂搬动的物体有没有悄悄改变尺寸?被遮挡的物体再次出现时,还是原来那个吗?答案就未必令人满意。
画面逼真,并不意味着物理合理。 当视频生成开始走向具身智能、仿真和世界模型,评测也需要从“看起来对不对”,走向“哪些物理量出了问题、偏离了多少”。
来自浙江大学 APRIL Lab、华中科技大学和腾讯优图实验室的研究团队提出 PVBench,通过物体级物理量测量,系统评估生成视频的物理合理性。基准覆盖 7 个领域、46 个评测维度,其中物理层包含 25 个维度;配套 600 组同场景文生视频/图生视频提示词,其中 30% 涉及具身智能体场景。
论文题目:PVBench: Quantifying Physical Plausibility in Video Generation with Object-Level Physical Measurements
01 为什么需要一把新的“物理标尺”?
现有视频评测已经能从语义对齐、画面质量、运动流畅度等角度衡量模型能力。不过,一个视频即使清晰、流畅,也可能出现物体穿透、尺寸漂移、凭空消失或碰撞后异常加速。
针对物理合理性的评测中,多模态大模型和人工判断提供了重要工具。但只回答“符合/不符合物理规律”,往往难以进一步解释:究竟是深度关系不一致,还是轨迹不连续?是姿态变化不合理,还是能量变化违反了场景约束?
PVBench 的核心思路是:在可测量的维度上,先从视频中提取物理量,再依据物理规律检验其一致性。
例如,对一个碰撞场景,除了观察“撞击动作是否自然”,还可以追踪物体位置,估计碰撞前后的速度,并在提示词给定质量比等条件下计算动量残差。这样,评测结果就能与具体物理约束建立联系。
图 1:PVBench 从语义、感知和物理三个层次评估生成视频,物理层进一步覆盖物体属性、空间关系与时空动态。
02 三层评测:既看画面,也看物理
PVBench 没有把物理合理性孤立出来,而是将其与语义和感知质量共同考察。这样可以区分:模型究竟是没理解任务、画面生成不好,还是完成了动作却违反物理规律。
评测层次 | 领域 | 主要关注点 |
|---|---|---|
| 语义层 14 个维度 | 条件与语义忠实度 | 是否遵循输入条件,物体属性、空间关系、场景及镜头等是否符合要求 |
行为、因果与常识一致性 | 动作与事件是否按要求发生,行为及其因果、时序关系是否符合常识 | |
| 感知层 7 个维度 | 感知与时序质量 | 主体和背景一致性、画面质量、运动平滑度、闪烁等 |
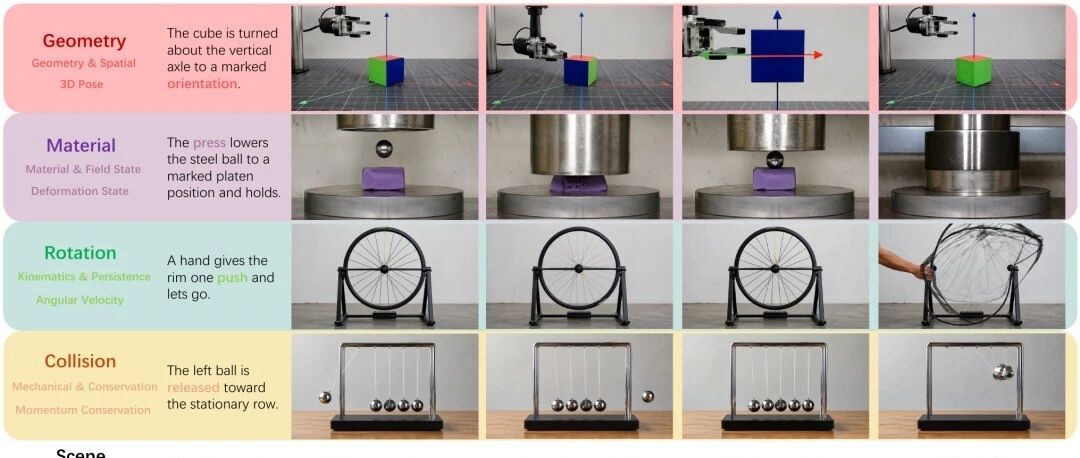
| 物理层 25 个维度 | 几何与空间一致性 | 深度、法向、形状、尺度、姿态及跨帧几何等 |
材料属性与场状态 | 形变、材质、光影、热辐射、电磁现象及相变等 | |
运动学与时空持续性 | 位移、速度、加速度、角速度、运动连续性及物体恒存性 | |
力学合理性与守恒定律 | 静态稳定性、力的动态效应、动量守恒与能量守恒 |
03 如何把“物理合理性”变成可计算的分数?
PVBench 的评测流程可以概括为:识别和追踪物体 → 提取几何与运动信息 → 检查物理约束 → 映射为分数。
具体来说,评测器结合深度估计、三维重建、物体分割、轨迹跟踪和姿态估计等专用视觉模型,获得相应的物理量或一致性残差。
几个例子可以帮助理解:
形状是否稳定? 对跨帧重建的物体点云进行对齐,测量形状差异,检查刚体是否在运动中异常变形。
运动是否连续? 利用三维轨迹和帧插值误差,检查物体是否瞬移、运动是否出现异常突变。
碰撞是否合理? 结合物体轨迹与提示词指定的质量比,计算碰撞前后的动量残差。
能量变化是否合理? 在适用场景中检查机械能是否近似恒定;对存在摩擦的场景,则检查其是否合理衰减,避免出现无缘由的能量增加。
当然,并非所有物理现象都能可靠地从视频中直接量化。对于材料属性、热辐射、电磁交互和相变等维度,PVBench 使用多模态大模型辅助评估。
按照论文中的划分,25 个物理维度中,17 个采用纯数值评测,4 个采用测量与多模态判断结合的方式,4 个采用纯多模态语义评分。
04 600 组配对场景,让物理问题真正“看得见”
物理评测首先需要合适的场景。如果关键动作发生在画面之外,或者碰撞过程被完全遮挡,再好的评测器也难以做出可靠判断。
PVBench 在提示词构建阶段,就将目标维度与可观测性要求绑定,明确物体、动作过程以及关键物理现象应如何呈现在画面中。提示词经过大模型辅助起草与人工筛选,并为图生视频版本合成对应的首帧参考图。
600 组提示词包括:
230 组单维度场景:46 个维度各设计 5 组提示词。
230 组组合场景:围绕 23 对相关维度,每对设计 10 组提示词。
140 组高难度补充场景:引入具身智能体,并结合遮挡、相机运动等挑战。
总计 180 组涉及机械臂、人形机器人、四足机器人或多智能体等具身场景,占全部提示词的 30%。
每组均提供对应的文生视频(T2V)与图生视频(I2V)版本,使研究者能够在相同场景设计下,比较文本条件和首帧图像条件带来的差异。
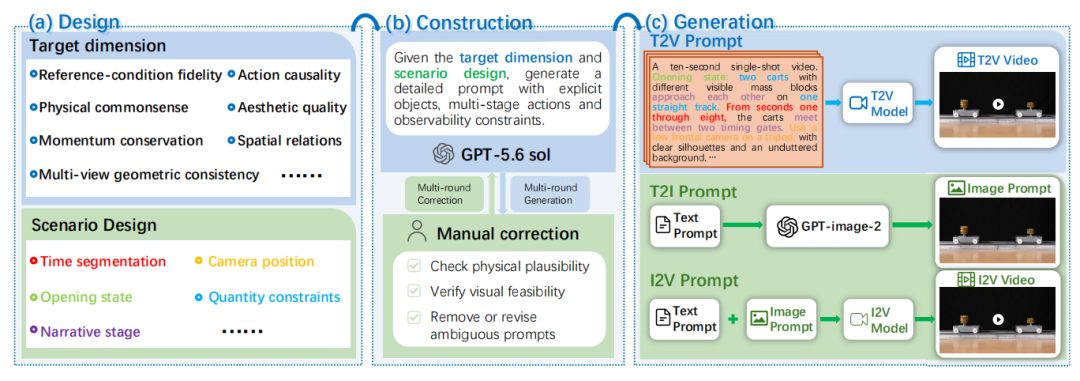
图 2:从目标维度和场景设计出发,经多轮提示词构建与人工审核,形成 T2V/I2V 配对任务。
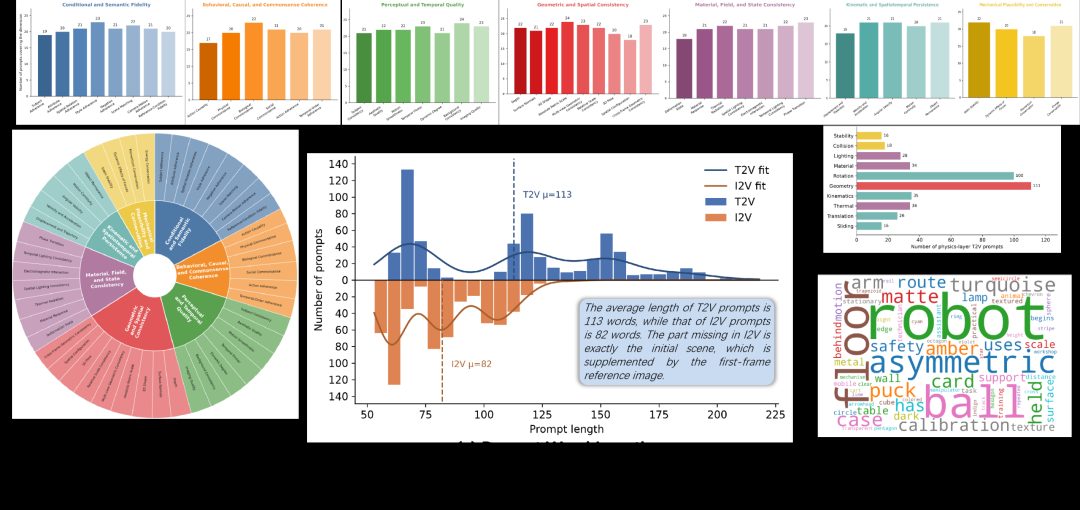
图 3:PVBench 提示词集合的统计分析,展示维度分布、文本长度、物理场景覆盖与关键词等信息。
05 实验发现:生成得好看,距离物理可靠还有多远?
论文评测了 SANA-Video 2.0、Wan2.1、Wan2.2、LingBot-Video、MiniMax H3 和 Seedance 2.5,共 6 个 T2V 配置与 6 个 I2V 配置。
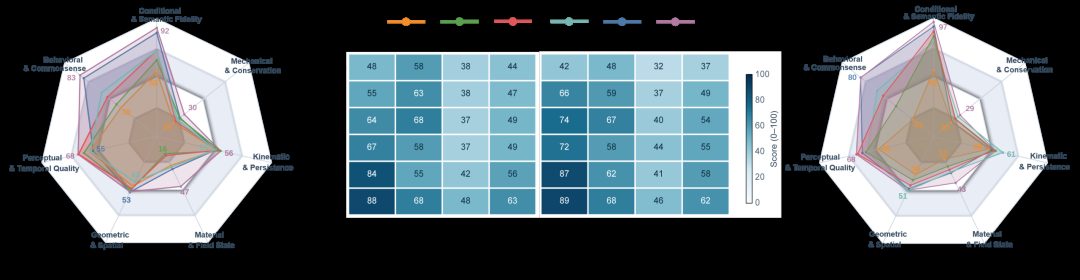
图 4:不同模型在七个领域的表现。物理能力具有明显的领域差异。
发现一:视觉质量不等于物理合理性
以 Seedance 2.5 的 T2V 结果为例,其条件与语义忠实度得分为 92.2,感知与时序质量为 68.4,而力学与守恒仅为 30.0。
论文发现,模型在语义、感知与物理层面的表现并不完全同步。即使视频能够遵循提示词,并呈现清晰、连贯的画面,也不能据此认定它符合物理规律。因此,视觉质量与语义对齐之外,还需要独立考察物理合理性。
发现二:力学与守恒定律仍是突出短板
在全部受测配置中,力学与守恒领域的得分位于 18.7—30.0。相比之下,几何与空间一致性、运动学与时空持续性的表现整体更高。
这表明,保持外观和一般运动轨迹,与正确建模碰撞、受力及能量变化之间,仍存在明显差距。上述分数来自不同维度各自的评分准则,应结合具体任务理解,不能直接解释为违反物理规律的样本比例。
发现三:复杂场景使多数模型的物理表现下降
当场景涉及具身智能体、遮挡、视觉杂乱或相机运动时,模型需要同时处理目标保持、结构恢复与动态关系。
在论文构建的高难度子集中,T2V 和 I2V 均有 6 个模型中的 5 个出现物理层得分下降。这也提示我们,简单场景中的表现,并不能直接代表模型在复杂交互任务中的能力。
发现四:首帧先验主要改善条件跟随与感知质量,物理量并非全面受益
首帧图像可以约束初始外观,但后续运动和交互仍需要模型持续生成。
以 MiniMax H3 为例,从 T2V 切换到 I2V 后,条件与语义忠实度由 88.0 提升至 92.8,感知与时序质量由 55.4 提升至 62.5;但几何与空间一致性由 52.6 降至 48.9,力学与守恒由 25.3 降至 20.1。
不同模型的变化并不完全一致,但这一结果说明:初始画面更确定,不代表整个物理过程就更可靠。
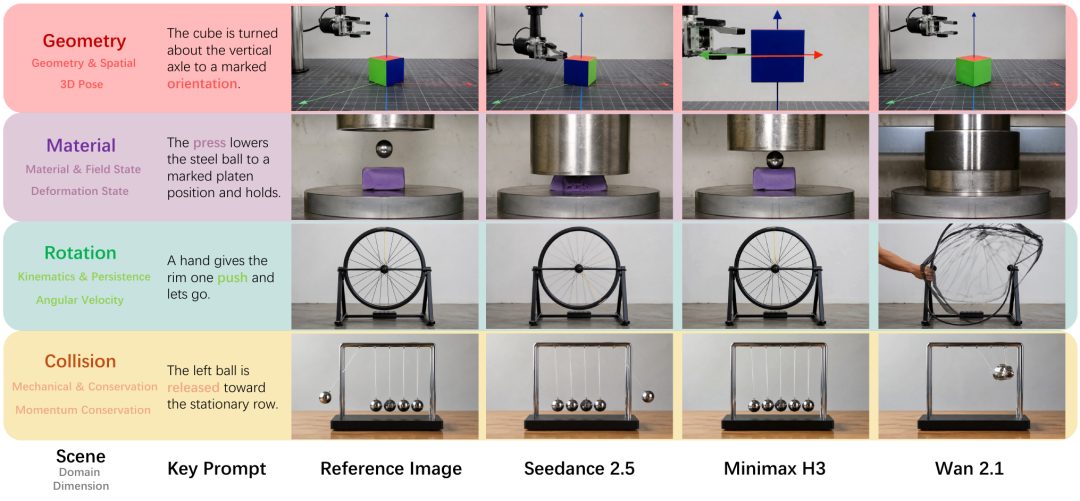
图 5:论文中代表性 I2V 模型的定性对比,展示几何、材料、运动及守恒等方面的生成差异。结合不同时间帧,可以观察物理关系是否在视频中持续成立。
发现五:物理量计算提供了更有区分度、更贴近人工判断的评测信号
针对相同物理维度的对照实验显示,物理量数值评分与人工评分的 Spearman 相关系数达到 0.84,直接使用多模态大模型评分则为 0.14。后者有 73.7% 的评分集中在最高分,而数值评分的满分比例为 15.5%。
数值评分的全局熵也更高(2.25 对 1.12),维度间方差更大(1.05 对 0.14),说明它更能区分不同样本和物理维度的表现,避免评分大量挤在最高档。
这组对照支持了 PVBench 的设计选择:对于能够量化的物理问题,显式测量有助于获得更有区分度、也更贴近人工判断的信号。 这一结论对应论文中的受测维度与实验设置,并不意味着多模态大模型在所有评测任务中都缺乏价值。
06 评测有效性:与人工判断是否一致?
为了验证自动评测的有效性,研究团队选择 3 个 T2V 模型,在每个物理维度上使用 5 条提示词,并由 10 位标注者独立评分后取平均。
结果显示,自动评分与人工评分在物理层总体上的 Spearman 相关系数为 0.772,Kendall 相关系数为 0.643;四个物理领域的 Spearman 相关系数介于 0.660—0.805。
此外,更换多模态评测后端后,不同后端评分的两两 Spearman 相关系数约为 0.71—0.84,为评测对后端选择的稳健性提供了支持。
07 从“看起来真实”走向“物理上可用”
PVBench 提供了一种更细粒度的观察方式:当模型在某个场景中失败时,除了得到一个总分,还能沿着几何、材料、运动和守恒等维度进一步分析问题。
这类评测对于视频生成研究和具身应用都有意义。一方面,它帮助研究者区分视觉质量提升与物理能力提升;另一方面,它为筛选生成内容、诊断模型短板,以及探索物理约束下的训练和优化提供了参考。
当前评测仍依赖视觉模型的估计精度,部分维度也需要多模态判断补充。生成失败、物理现象不可观测或评测器跳过的样本,同样需要结合有效样本覆盖情况解读。
当生成视频开始被期待用于理解、预测和交互,我们需要关心的,就不只是它能否骗过眼睛,还包括它能否经得起物理规律的检验。
欢迎通过论文和项目主页了解 PVBench 的评测体系、实验结果与可视化案例。代码及配套资源的具体可用范围,请以项目页面和仓库说明为准。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。