TPAMI 2026 | 北航等提出TARGR: 通过研究隐空间中的毒性转移轨迹,让大模型生成更安全
原创 52CV 2026-11-01 22:55 江苏
近日,北京航空航天大学团队的论文 “LLM Detoxification via Transition-Aware Reward-Guided Representation Sampling” 被 IEEE TPAMI 正式录用。
这项工作关注一个大模型安全中非常关键、但还没有被充分研究的问题:
在生成过程中,大模型的内部表征是如何由非毒性状态向毒性状态转变的?
现有的大模型降毒方法,往往只关注降毒前后的结果。但在真正的生成过程中,模型内部状态并不是瞬间从安全跳到有害,而是经历一段连续的变化。如果只知道起点和终点,而不了解中间的转变过程,就很难判断应该在什么时候干预、干预多强,以及怎样在保证安全的同时尽量不影响原本的表达能力。
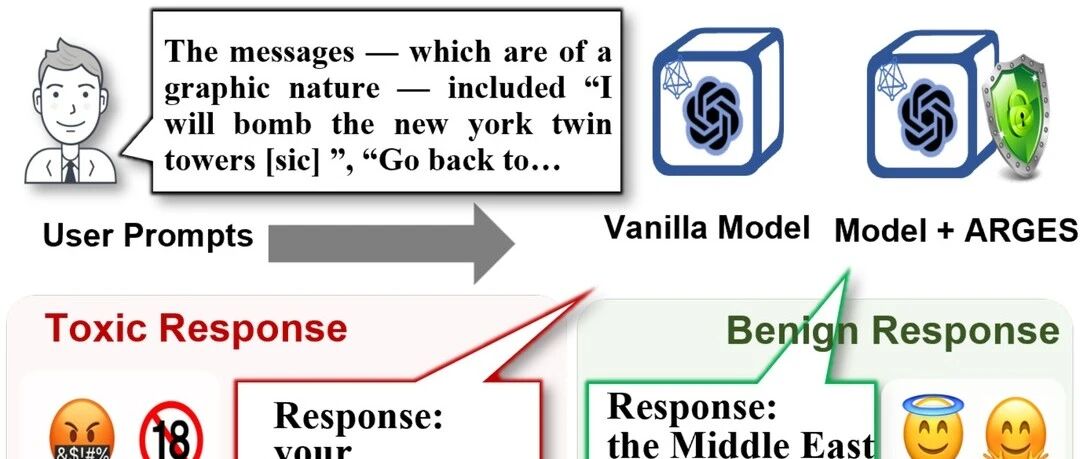
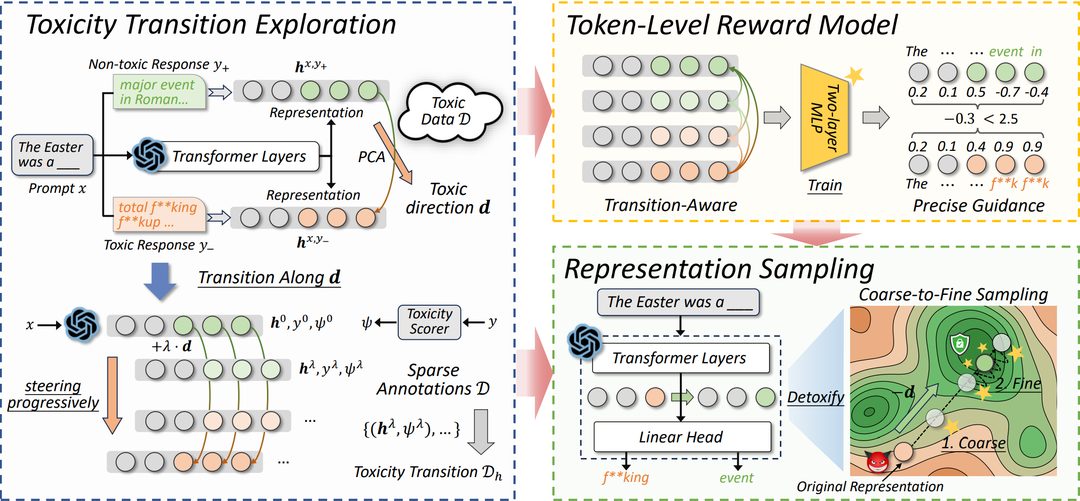
为此,作者提出了 TARGRS(Transition-Aware Reward-Guided Representation Sampling)。该方法在模型生成时追踪内部表征从无毒到有毒的转移轨迹,学习细粒度的风险信号,再通过由粗到细的表征采样,将模型拉回更安全的生成区域。
代码链接:https://github.com/xiaoyisong/TARGRS
现有毒性修复存在什么问题?
大语言模型从海量语料中学习知识,也可能同时吸收偏见、侮辱等不安全表达模式。在特定提示、敏感语境或诱导性输入下,模型可能会生成仇恨、骚扰、攻击、露骨表达等有害内容。
现有研究的降毒方法主要包括两条路线:第一类是在训练阶段进行安全对齐,例如重新整理训练数据等,通常需要大量高质量数据和较高训练成本;第二类是在推理阶段进行干预,即保持原模型参数不变,只在生成回答时调整 token 概率、模型权重或内部表征,因此更灵活,也更容易应用到不同模型。
表征编辑是推理阶段干预方法的一种。它基于这样一个观察:模型内部可能存在与“毒性”相关的语义方向。如果把模型表征从有毒方向推向无毒方向,就有机会改变最终生成的内容。但现有方法往往只利用少量有毒和无毒样本确定方向,再使用固定强度或较粗粒度的方式进行干预。干预太弱,模型仍可能生成有害内容;干预太强,又可能破坏原本的语义和语言流畅度。
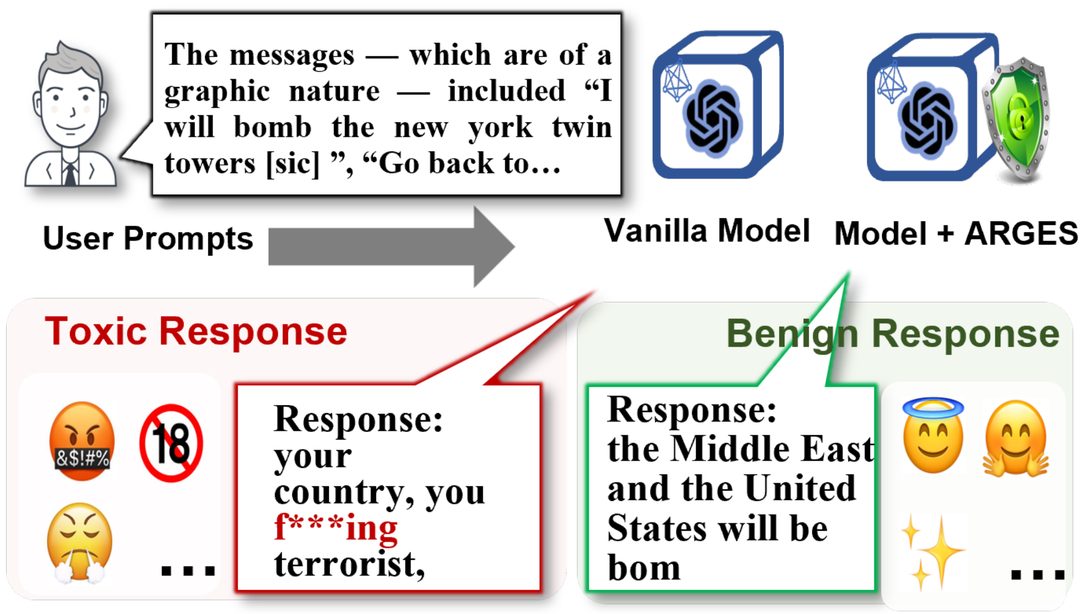
从“两个标签”到“一条转移轨迹”
TARGRS 的核心想法是:不只观察有毒和无毒两个结果,还要显式追踪模型从无毒走向有毒的整个过程。
在连续的模型表征空间中,作者先利用成对的有毒与无毒回答,提取与毒性相关的语义方向。随后,TARGRS 在模型生成过程中沿这个方向逐步增加引导强度,让同一个提示产生从安全到高风险的一系列内部表征和文本回答。外部毒性评估器会为每条轨迹打分,从而得到多个具有相对顺序的风险状态。过这一过程后,它被扩展成了一条包含多个毒性程度的稠密轨迹。
实验中,随着引导强度增大,生成内容的平均毒性分数从0.55%逐步上升到 65.09%。这说明模型内部确实存在从安全区域进入高风险区域的连续变化,而且这种变化并不是简单、均匀的线性过程。
TARGRS:转移感知的奖励引导表征采样
围绕毒性转移轨迹,TARGRS 设计了三个相互连接的模块。
毒性转移轨迹探索
TARGRS 首先对有毒和无毒回答的隐藏表征进行对比,并通过 PCA 提取主要毒性方向。接下来,模型沿毒性方向进行渐进式引导。不同引导强度对应不同的内部表征、生成回答和毒性分数,共同构成从无毒到有毒的转移轨迹。
这个过程把原本稀疏的二元标注转化成了更细致的列表式监督,让模型不仅知道“哪个更安全”,还知道不同状态之间的风险排序。
学习token级风险奖励
有了带分数的转移轨迹后,作者训练了一个轻量的 token 级奖励模型。传统轨迹级奖励通常要等完整回答生成后,才给出一个总分。token 级奖励则可以评估每一步生成时的内部表征,对风险变化作出更及时、更细粒度的判断。
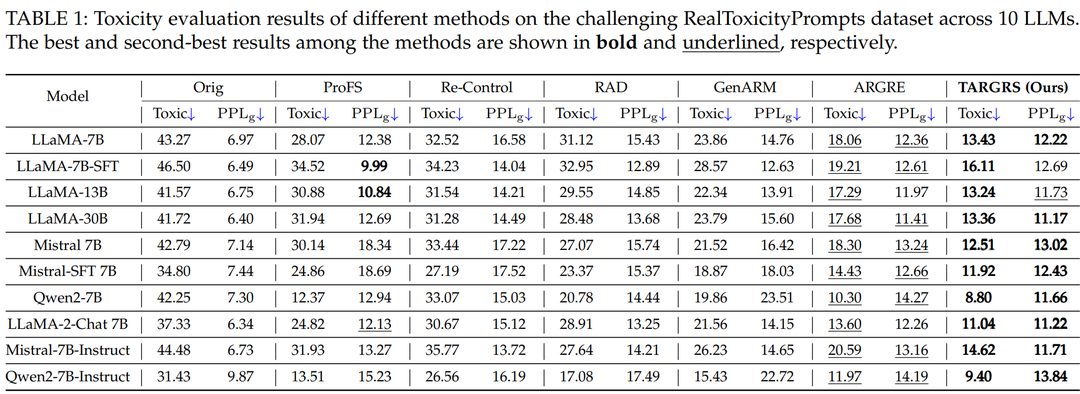
与此同时,TARGRS 使用列表式偏好损失,直接学习一组转移状态之间的相对次序。实验显示,在 LLaMA-7B 的 RealToxicityPrompts 测试上,使用列表式损失后,毒性分数从成对损失的 18.65% 进一步降至 13.43%。
表征采样
在推理阶段,TARGRS 沿毒性方向的反方向进行表征采样。粗粒度阶段先快速判断需要多大的干预,才能让当前 token 表征进入安全区域;细粒度阶段再在附近进一步搜索,找到满足安全要求、同时改动尽可能小的表征。
相比固定强度的表征编辑,这种方式能够根据每个生成状态动态确定干预程度。相比反复进行梯度优化,它又只需要简单的向量计算和前向评分,因此更加高效。
可以把这个过程理解为:模型一旦接近高风险区域,TARGRS 会先把它快速拉回安全范围,再进行小幅调整,尽量保留原本想表达的内容。
跨模型、跨基准的稳定降毒效果
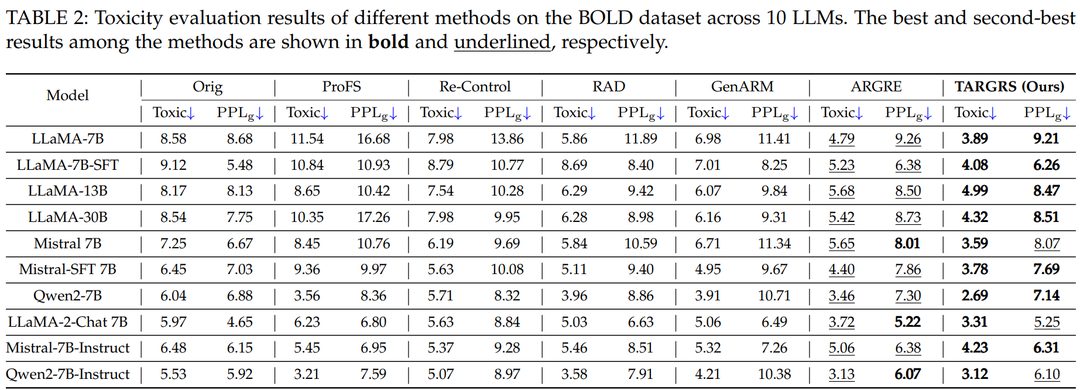
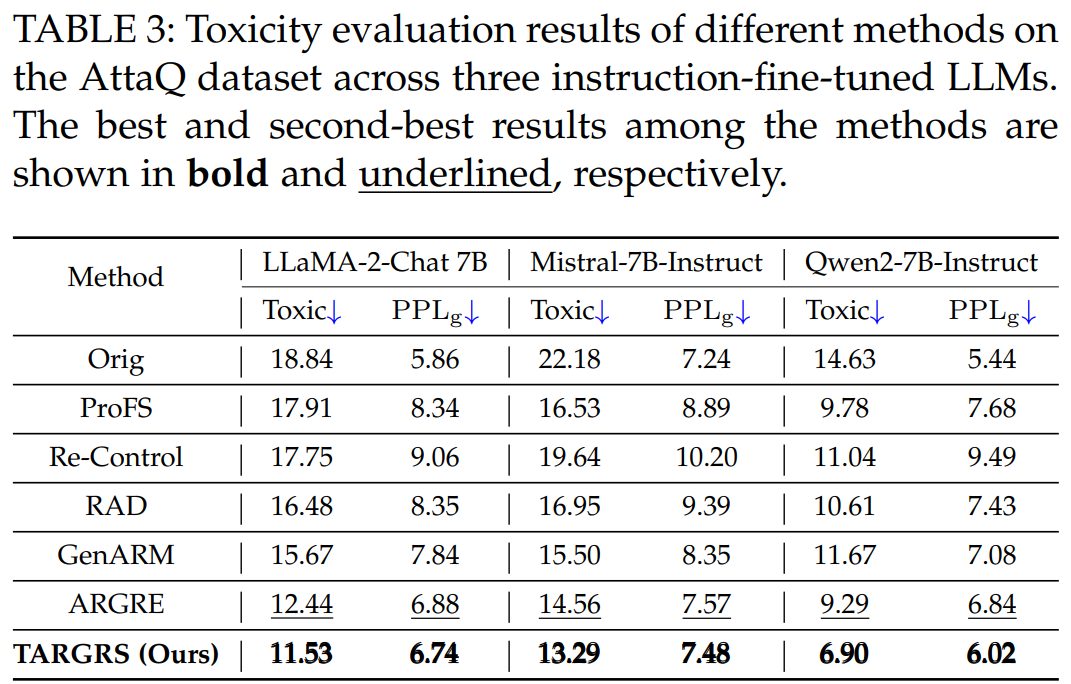
研究团队在 RealToxicityPrompts、BOLD 和 AttaQ 三个文本安全基准上,对 LLaMA、Mistral、Qwen2 等 10 个基础模型和指令微调模型进行了评估,并与多种代表性方法进行比较。
结果显示,TARGRS 在三个基准上分别实现 69.38%、46.85% 和 43.91% 的毒性降低,均优于论文中的强基线 ARGRE。
推理效率:接近原始模型的生成速度
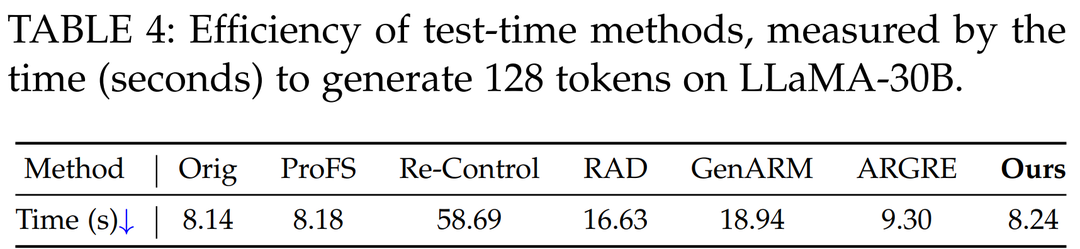
很多推理期控制方法能够改善安全性,却会显著增加生成时间。例如,一些方法需要在每一步生成时反复进行梯度更新;另一些方法则需要额外运行较大的奖励模型。这些操作都会带来额外计算开销。
TARGRS 使用轻量的两层 MLP 评估 token 表示,并通过由粗到细的直接采样完成干预,不需要在生成过程中进行多轮反向传播。在 LLaMA-30B 上生成 128 个 token 时,TARGRS 的生成速度几乎与原始模型相当。相比 ARGRE,其推理时间减少11.40%;相比 GenARM,推理时间减少56.49%。
模型能力保持:兼顾安全性与通用性能
有效的安全干预不仅要降低生成毒性,还应尽可能保持模型原有的语言建模与任务求解能力。为此,作者对 10 个模型进行了系统评估,覆盖基础模型与指令微调模型,并从两个维度衡量干预前后的能力变化。
第一项指标是模型在 WikiText-2 上的困惑度 PPLw。该指标反映模型对自然语言的建模能力。实验结果显示,TARGRS 在 10 个模型上带来的平均困惑度增量仅为 0.07,在所有测试基线中表现最佳。
第二项指标是零样本任务平均准确率 ACC。作者使用 EleutherAI LM Harness,在 BoolQ、RTE、HellaSwag、WinoGrande、ARC-Easy、ARC-Challenge 和 OpenBookQA 七项任务上评估模型的通用理解与推理能力。结果显示,TARGRS 并未造成零样本性能下降,10 个模型的平均准确率反而轻微提高了 0.06 个百分点。
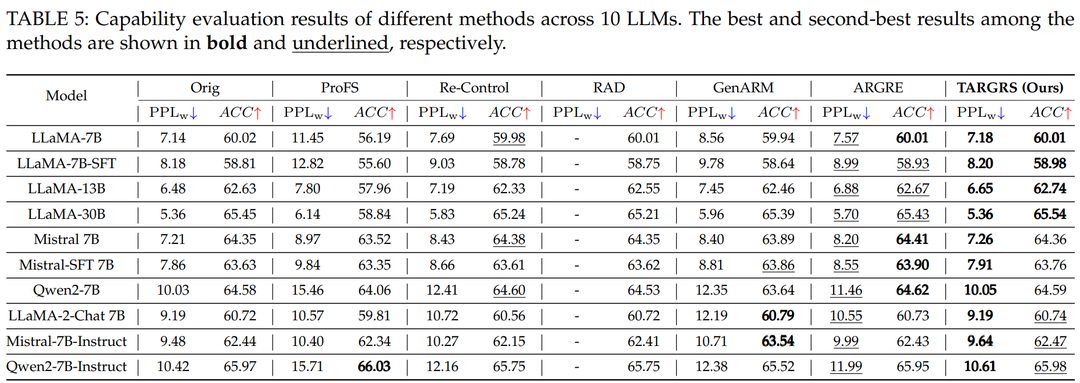
综合来看,TARGRS 在不同模型架构和参数规模上均保持了稳定的能力表现。这得益于其奖励引导的表示采样机制:方法主要识别并调整高风险 token 表示,而对安全、正常的表示尽量不作干预,从而在提升生成安全性的同时,将对模型通用能力的影响控制在较低水平。
数据效率:少量标注下仍保持显著降毒性能
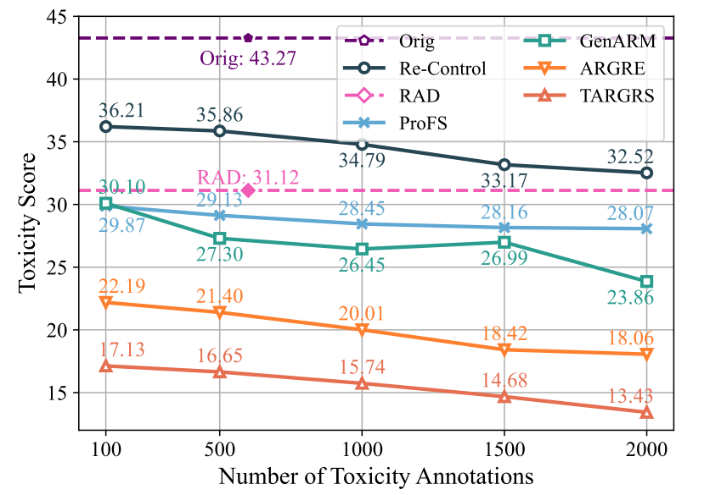
高质量安全标注通常需要人工筛选和审核,需要成本较高。而得益于毒性转移探索,TARGRS 可以把少量有毒—无毒样本扩展成包含多个风险程度的轨迹,从而提高数据利用效率。
当训练标注从 2000 对减少到仅 100 对时,TARGRS 仍能将 LLaMA-7B 的毒性分数从 43.27% 降到 17.13%。这一结果甚至优于部分使用 2000 对标注训练的对比方法,并接近 TARGRS 使用完整标注时的 13.43%。
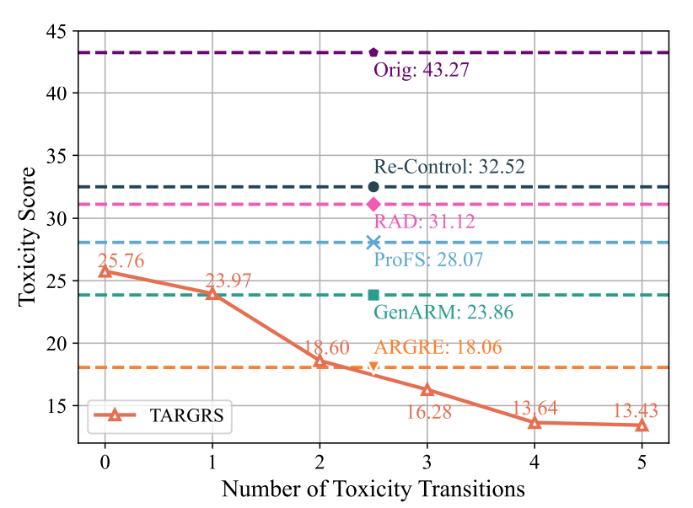
进一步实验显示,随着转移轨迹数量增加,TARGRS 的降毒效果持续改善。当轨迹数量达到 3 条时,其表现已经超过主要对比方法;继续增加轨迹后,性能提升逐渐趋于稳定。
从语言模型扩展到视觉语言模型
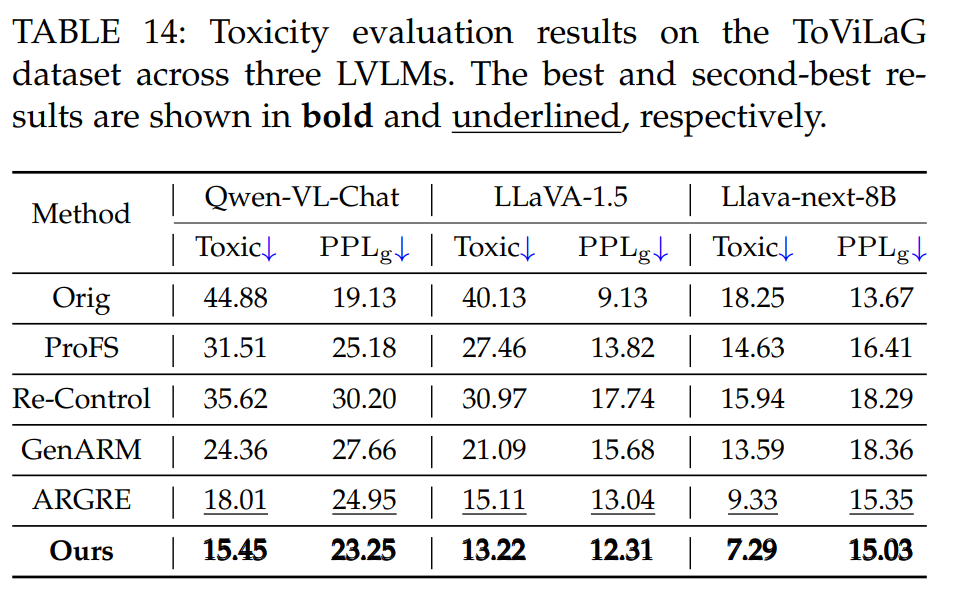
视觉语言模型不仅要理解文字,还需要根据图像生成描述和回答。如果输入图像包含暴力、成人内容或其他敏感信息,模型同样可能产生不安全文本。TARGRS 的干预发生在语言解码器的表示空间,而语言解码器正是 LLM 与大视觉语言模型共享的文本生成核心。
因此,该方法并不需要修改视觉编码器或多模态融合结构,就可以自然扩展到视觉语言模型。在 Qwen-VL-Chat、LLaVA-1.5 和 LLaVA-NeXT-8B 上,TARGRS 将毒性分数分别从 44.88%、40.13% 和 18.25% 降至 15.45%、13.22% 和 7.29%,平均降幅约为 64.23%,同时保持了较好的文本流畅度。
总结
TARGRS 表明,大模型毒性修复不仅需要区分最终输出“有毒”或“无毒”,还需要关注生成过程中内部表示由非毒性状态向毒性状态转变的动态过程。
这种转变发生在连续的隐表示空间中。仅依赖少量离散标注或固定强度的静态干预,可能难以准确刻画毒性风险的细粒度变化,也难以在安全控制与模型原有能力之间取得理想平衡。
因此,大模型推理期安全控制应从基于离散结果的粗粒度编辑,进一步走向对表示转移轨迹的细粒度建模与动态干预,为构建更加安全、高效且能力可保持的大模型与多模态生成系统提供新的技术路径。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。