个性化视频技术:历时七年的算法演进
原创 抖音用户体验算法 2026-11-02 19:03 北京
01 | 前言
个性化视频算法是抖音体验算法团队在行业内最早创设的方向,曾于 24 年发表详述,参考:
首度揭示!个性化视频技术——短视频体验的秘密!
Personalized Playback Technology: How Short Video Services Create Excellent User Experience(https://arxiv.org/abs/2410.17073)
数年以来,团队笃行不怠,多路并进,与当时披露的内容相比又有更多进展,在此做一详细盘点,希望可以引导、促进业界水平的提升。
回顾历史,音视频技术自互联网开端时即已成为显学,在之前三十多年的发展历程中,行业的关注重点主要在编解码标准、流媒体协议和框架开发等方向,虽然一直有零散的算法工作,意图解决实际工作流程中某一环节的问题,但抖音这条路径是通过 VLP、UIAE、Reward、CDNPilot、TACO、Demand、Vision、PRIME 等一系列算法将整条音视频链路串联起来建模,构建出完整、精细,同时又真实的个性化视频技术体系。
需要说明的是,抖音在基础视频消费之外,还承载了包括商业化、直播、电商、生活服务、短剧、游戏、搜索等数十种不同业务,需要在更高的性能资源占用约束下,追求流畅度、画质、稳定性、失败率、成本等方向的综合最优,对其中的算法技术而言,就需要其个性化算法涉及的规模和精度,与他人做法拉开跨代、量级上的差距,才能保证市场竞争优势。
与相对“传统”的音视频工作相比,个性化视频技术同时追求算法的实际价值、创新度与复杂度,因此在常规的优化武库之外,会将视野投向包括大型推荐模型、强化学习、控制论、因果推断、运筹优化、认知科学等在内所有具备潜在可能的技术,令其与音视频技术结合,交融并汇,才有希望达成“具备跨代、量级差距”的效果。
02 | 服务端:从单点规则到系统运筹
2.1 视频价值预测:VLP
VLP(Video Lifecycle Prediction)是大型短视频服务需要回答的一个基础问题:每个视频(预期)到底值多少钱?这个值将决定转码资源的分配优先级、CDN 缓存策略和分发权重,甚至影响前处理流程、内容理解的推理预算。每天抖音有几千万到上亿条视频上传,传播与消费价值差异巨大,需要模型对每条视频的未来价值(vv、播放时长)做出预测,才能更精确地决定在后续链路上如何处理与干预。
抖音或其他短视频 App 的生产-消费模式,均处于一种基尼系数极高的情况,极少的视频投稿就可以覆盖多半以上的视频播放,而由于大量对视频的处理——例如转码、前处理、内容理解——十分昂贵,在满足基础服务及内容安全要求的前提下,提高大规模视频处理系统的整体效率成其为必然。
本质上,虽与 Ranking 或 CTR 问题有别,VLP 面对的仍是一种高精度的预测问题,适合用与推荐、商业化等领域相近的解法,因此有参考许多字节内外推荐团队的工作,未来的思路也会尽力与推荐、计算广告等领域的前沿工作对齐,吸纳其在建模、模型结构、特征运用、样本分析等方面的进展,并针对音视频领域调整。
VLP v1(2021) 让视频价值第一次在音视频链路中高精度地被计算出来,此前业务只能按粉丝数、历史播放vv做规则排序——也是业界的习惯做法,一些视频服务曾构建过预测服务但精度甚低,VLP v1 搭建了完整类推荐的召回、排序链路,引入数十个作者、视频特征,用排序模型把价值预估变为监督学习,将输出归一化到 0~1 的热度分供转码排序使用。VLP v3(2023)第一次使用超大规模稀疏 DNN 并支持天级更新,稀疏特征经 Embedding 拼接后送入多层前馈网络,用 LHUC 方式依据作者/类目表征生成取值 [0, 2] 的逐层缩放向量做个性化调制,以 BIAS 让关键特征直连输出层(wide & deep 思想),同时从「单一价值分」升级为多任务,一个模型同时预测未来 1d/3h 的 vv、完播、播放时长等目标,并用 GradNorm 自适应平衡各任务损失:
(往左滑动查看完整公式)
VLP v8(2026) 深度实践了 LRM scaling-up 路线,进一步推动了个性化推荐、计算广告与音视频领域的技术交叉,v7 的人工特征交叉(MMCN 等)结构复杂且天花板低,self-attention 加深后 token 表征趋同(cosine相似度 0.9+,即 over-smoothing),v8 在广泛尝试对比了不同推荐技术进展的效果后,选择字节推荐团队的 TokenMixer 结构堆叠替代特征交叉主干,用 PerTokens AFFN为FFN 引入 token 级自适应门控,剪枝冗余结构后将 dense 参数扩至 1B,可验证视频价值模型同样服从scaling law(Reg-AUC 较 v7 +1.36%,MFU +167%),其核心结构与规模规律可概括为:
(往左滑动查看完整公式)
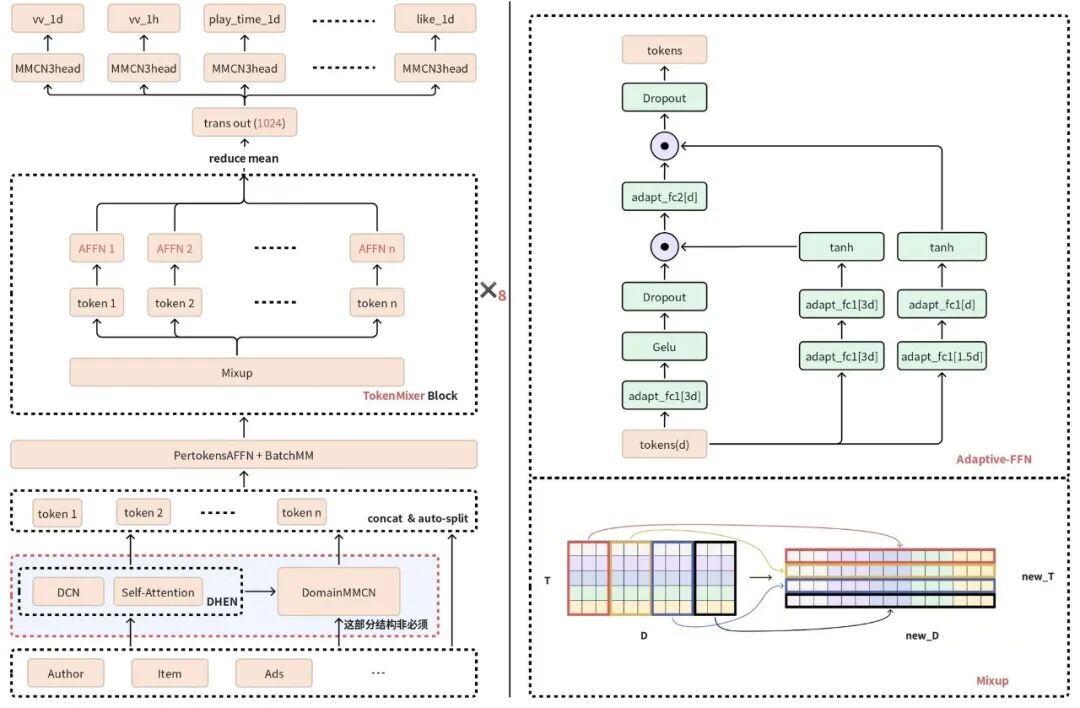
图1:VLP v8 的 TokenMixer 主干、Adaptive-FFN 与 Mixup 结构
配合模型复杂度提升,v8 在特征侧同步做了大幅度扩展,新增了数十个 LLM 挖掘特征(视频互动水平、投稿信息、作者生态等),基于视频内容理解大模型生产的 124 个高阶语义特征(音视频画质、美学、结构、热度分析、...),接入多模态 Embedding 和投稿侧序列特征等。此外,拆分了 CAPP(Content and Creator Profile-Aware Popularity Prediction)模型作为 0vv 冷启动场景的补充,专门解决新视频在无历史数据时的流行度预测问题。
2.2 档位组合决策:UIAE
档位组合解决「给每个视频转几个版本、每个版本什么规格」的问题,由于视频压缩基本不可瞬时完成的特性,对同一源片提前准备多个码率/档位视频给不同用户(或同用户的不同访问时段)消费,以求取更高的用户体验,是行业惯例。
与 Content Aware Encoding 内容感知编码受到「传统」音视频算法工程师的关注不同,由我司参考 Brightcove 公司Context Aware Encoding 概念所开创的档位组合(UIAE 及其前序技术)方案视野更投向链路乃至业务的整体最优,首次令服务端与客户端的音视频链路得以形式化的方式串联到一起,将优化目标与终极目标重新塑造一致并统筹优化,是个性化视频领域的基石技术之一。个性化视频技术追求全链路精确可计算、全链路最优化,UIAE 的发展将视频处理与用户未来动态的选择进行链接,支持精确预测与在线运筹,指向全链路的理论上限。
UIAE(User-Item Aware Encoding)前序使用的方案主要采用离线预计算出的固定档位组合,在不同国家和地区均曾取得良好收益,而 UIAE 的思路是,根据用户播放行为和视频编码特性,实时地动态输出可变组合,同时把决策粒度从「群体统计」推进到「用户×视频」,在转码成本约束下最大化个体期望体验:
(往左滑动查看完整公式)
参考:A User-Item Aware Encoding Framework for Short Video(https://ieeexplore.ieee.org/document/11461328)
UIAE v1(2024) 把前序方案的固定组合改为模型预测的可变组合,将问题建模为带约束的最优化,以各档位的播放概率 p(R) 对体验加权求期望,在码率区间、相邻档位码率差、档位数量与 CRF 等约束下选出期望 QoE 最高的一组档位,简化来看,QoE 可视为画质、卡顿、首帧三项 QoS 的组合,当视频价值上升触发「加转」时会触发重新计算:
(往左滑动查看完整公式)
UIAE v2(2025) v2 补回了 v1 中被简化的变量,沿「系统拆分+场景细分+自适应」的方向精细化,先按不同系统分别预估 QoS/QoE,把播放环境按不同选档策略细分统计概率,使用 Convex Hull 在 RD 曲线上筛出高性价比候选 CRF 点、枚举生成候选组合集合,再让不同编码器基于各自线上 Context 联合决策。QoE 则改进为 mVMAF(VMAF 的均值变体)、码率、卡顿时长的组合,超参数随场景与人群差异化(如 iOS 画质权重高于 Android),最终取期望体验最大的组合并辅以规则微调:
(往左滑动查看完整公式)
UIAE v3(2026) 沿同一决策框架扩展,新增 864p 等多个非常规候选档位,并调整多个现有档位超参,同时把转码决策与多码率下发策略联合优化——将设备能力、高峰 / 非高峰时段、大包 / 小包等下发规则纳入约束与统计场景(如低端机过滤高码率档、窄屏低清处理等),即目标函数不变,但在候选空间与可行域上大幅提升:
(往左滑动查看完整公式)
2.3 转码资源调度:Reward
Reward 算法回答大规模音视频链路中另一个未曾充分建模的问题:有限的转码资源如何分配给海量视频?抖音每日亿级投稿量下,转码集群容量始终有限,Reward 将问题看作资源约束下的收益最大化问题,从召回的 { 视频,档位 } 候选中选择子集提交转码,使总收益最大。
Reward 算法与 VLP、UIAE 算法一道,逐步构成了个性化视频链路中转码端的三大核心算法,将大规模音视频系统的最优化问题,进行了关联到全局收益和成本的完整建模。具体到算法本身,由于其明显的运筹属性,未来存在参考广告库存管理、物流调度、激励投放等领域的前沿技术,辅以音视频领域的先验知识,进一步提升的空间。
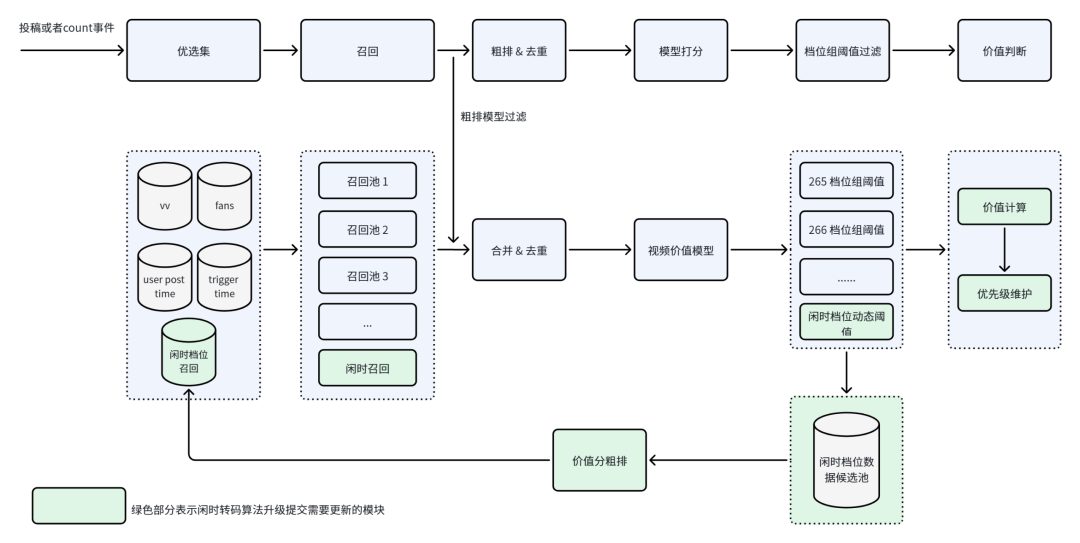
图2:Reward 从投稿事件到价值判断的召回、粗排、打分与UIAE剪枝链路
Reward v1(2024)
以 Reward = Income(QoE) - Cost 为目标、TotalAvailableCost 为总资源上限,将其建模为背包问题,以动态规划求解,落地时做了剪枝,只保留码率收益一项,简化为:
(往左滑动查看完整公式)
码率收益取自码率光谱(大盘新增某档位后的平均码率变化),基础档位之外仍按视频价值分排序提交。
Reward v2(2025) 逐项补回剪枝,码率收益改由预估模型给出(基于原视频与已转档位的预测差),免去码率光谱每加一档都需要重新统计,补回 QoE 项并以统计映射近似 ,目标函数扩展为:
(往左滑动查看完整公式)
指数项是编码耗时对收益的折损(价值按未来 24/3 小时计,编码过程不计收益),并将原本独立的两条编码器队列合并为混合调度,按拥堵程度动态分配普通档位与档位组合的资源比例。
Reward v3(2025) 转向解决高价值档位的重复转码,用小时级时序价值分二次推断能否达到阈值(阈值取 0.8 时准确率超 90%),新增 0vv 价值分,同时把 UIAE 触发门槛降低下来,优化了长视频与转码耗时的 trade-off。但 v3 仍有部分瓶颈,决策范围窄、粒度粗、容量调节被动滞后(仅凭回传队列长度后验调整,恢复慢)。
Reward v4(2026) 针对以上瓶颈升级,调度范围扩到所有线上档位(包含 UIAE 档位),而目标函数精细到视频粒度:
(往左滑动查看完整公式)
其中
 由 VLP 预测,
 与
 由多目标模型预估,
 为耗时折损函数(对预期高峰 vv 却需较长转码的任务加大惩罚,因档位转出前无播放收益),𝓇 为仅作用于 UIAE 的经验权重,用于提升提交 UIAE 档位倾向的超参数。
容量侧用 G/G/1 排队论建模转码队列,以 Kingman 公式估计平均队列长度
 (
 、
 为入/出队变异系数,
 为利用率,EWMA/EWMV 滚动更新均值方差),锚定目标L₀反推提交速率
 ,再按
 映射为每次提交上限,未来还可以视频内容与档位为 State、提交为 Action、带宽/体验为 Reward,用在线小流量 RL 学习更优策略。
IdleTrans(2025) 是 Reward 算法的闲时调度补充模块,把夜间等闲时的闲置算力转为增量转码资源,由于闲时允许任务堆积、提交侧不感知实时资源,故建模为无资源约束的最优化问题,只在「视频×档位」粒度最大化净收益:
(往左滑动查看完整公式)
其中 为画质/QoE业务价值,
 为带宽节省,
 、
 为计算与存储开销,各项按渗透率折算
 (𝓌为折算系数),真实渗透
 ,即期望渗透减去转码延迟渗透(档位转出前不产生收益)。召回与提交上,忙时与线上共享数据池、优先高价值视频,闲时启用独立数据池纳入低价值视频,以实时净收益作为「视频×档位」提交优先级——未提交按收益排序提交、已提交未转出持续刷新、已转出幂等去重,并对短剧链路加权,从而在堆积时让高收益档位尽早产出。
2.4 CDN调度:CDNPilot
CDN 调度的问题已经存在很多年,主要回答「内容该放在哪个节点、何时搬运」以及「这次请求给谁」,但其中前者在短视频时代的重要性比传统视频业务要更高。此外,传统 CDN 被动回源、就近接入,热点来临时才消耗跨网与回源带宽,CDNPilot 更倾向于借助 VLP 的预测能力与质量评估把调度从「事后兜底」变为「事前布局」,可以沿冷热分层、闲时预热、实时择优三条线递进展开。
通过CDN预热带动业务收益,行业中 Netflix 因其具备OpenConnect这样的CDN模式而自然推动,堪称先驱,但短视频的预热问题需要处理高 3-4 个数量级的视频,同时应对不同 CDN 供应商,较之远为复杂。CDN 调度相似,主要的挑战来源于规模、供应商状态以及与实际用户请求的配合,需要遵从第一性原理进行实际数据的分析、推导与建模。
冷热调度(2020) 解决「全量铺太贵、集中怕回源」的矛盾,成本关系为  ,而视频热度近似服从 Zipf 分布
 ,设全网视频量为𝓃、边缘容量覆盖比例为𝓮,边缘只需覆盖头部少量文件,回源比例即随𝓮快速下降:
分类器侧用树模型替代人工规则,综合播放行为与增长斜率预测冷热,为提前捕捉仍在增长的视频,训练时按「增长空间×时间提前量」加权,并对漏判(FN)施加更大惩罚:
(往左滑动查看完整公式)
预测结果落地为热、温、冷、极冷四层差异化调度,大致概念类似如下规则,极冷走商业存储直接回源,冷视频 hash 到单一厂商,温视频 hash 到三家厂商,热视频走正常 CDN,模型复杂化后分类更准,温热流量回源带宽下降 27%。
资源预热(2023) 把调度时机提前到流量到来之前,特定 CDN 节点分布式、异构且无法实时回源,正好利用凌晨低谷带宽预部署以削峰填谷;但边缘存储有限、推送本身也耗带宽,因此实际只推高热文件,把推送建模为存储与闲时带宽双约束下的期望收益最大化:
(往左滑动查看完整公式)
其中 为文件热度概率,线上由 XGBoost 产出以控制计算复杂度,KEPC-Push 方法进一步用知识图谱刻画相似作者、内容与时长视频间的热度关联,缓解新视频无历史的冷启动,并以分层算法适配异构边缘节点,在仿真中降低峰值 CDN 成本 20%、提升平均下载速度 7%。
质量调度新算法(2025) 在服务端消费客户端实时上报的性能数据,在国家—省份—运营商粒度构建域名质量偏序库,以令牌桶承载各厂商动态分量作为硬约束,仅对热流视频逐请求分配最优子域名,本质是带容量约束的实时 0-1 指派问题:
(往左滑动查看完整公式)
其中 为质量库给出的用户—域名体验预估,
 为令牌桶实时更新的域名分量约束,且每个请求恰好指派一个域名,初版上线后卡顿用户渗透 -0.2312%、卡顿1s 以上用户渗透 -0.4403%、网速 p50+0.5816%,后续迭代为基于 Feed 上报网速与网速分布决策、通过画像兜底的方案。
参考:Smart Data-Driven Proactive Push to Edge Network for User-Generated Videos(https://ieeexplore.ieee.org/abstract/document/10621410)
KEPC-Push: A Knowledge-Enhanced Proactive Content Push Strategy for Edge-Assisted Video Feed Streaming(https://www.usenix.org/conference/atc24/presentation/ye-ziwen)
2.5 CDN流量调控:TACO
流量调控主要源于中国区的一个特定问题:带宽成本是按 95 峰计费、由计费周期内少数高峰采样点决定,而抖音等应用存在相对固定的消费高峰(午间、晚间与节假日),若能综合运用不同时段提供用户消费的技术策略,当能保证体验与成本的综合最优。抖音给出的解法是用算法来进行预测和控制,调控目标是在体验约束下压降超出目标水位的峰值。
TACO 算法在解决的不仅是视频大厂的特有问题,更是中国区的独有问题,技术上缺乏参照,且由于涉及较广,组织难度更高,除基于第一性原理进行建模、推导外,充分的仿真证据对推动落地也不可或缺。
TimeValue(2022) 是 TACO 的前序方案,针对商业CDN 的月 95 计费规则,账单由计费周期内 p95 的采样点决定,且不同 CDN 资源、不同供应商分别统计 95 峰,因此策略分为两类——在计费点附近降级减流量的「削峰」,与在低谷时段、不抬升 95 峰的前提下提升质量的「填谷」,记BWₜ为时刻𝓉的带宽、𝒯为目标水位、 ,调控目标是在体验下限约束下压降超水位峰值:
TimeValue 以「预测+模拟+统计」的融合方法圈定固定调控时段,初期仅晚高峰档位降级 80 分钟即可带来 CDN 成本 -2.14%,系列策略累计取得 -7% 成本优化与 LT、时长等体验收益,但月 95 峰预测存在固有难点,节假日、特殊事件等因素稀疏难学(不确定性),且策略干预改变波形、波形又反过来决定预测结果(反身性),固定时段策略很容易在多年迭代中失效。
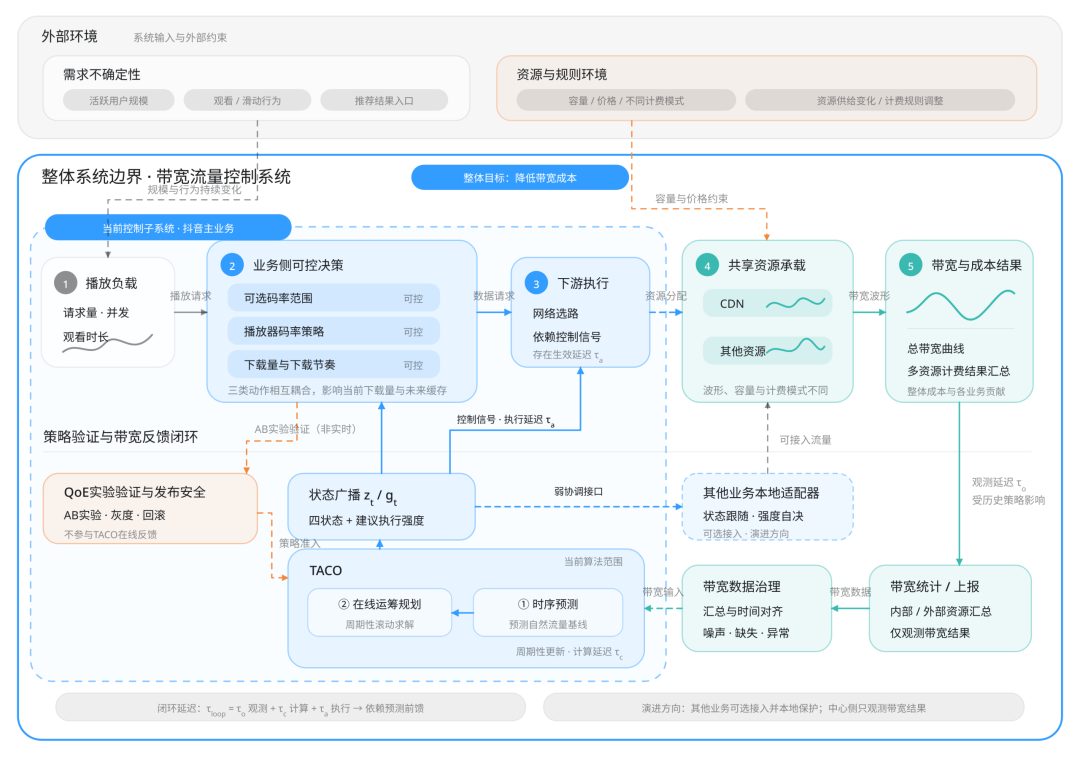
图3:播放带宽流量控制系统的整体结构,TACO 承担其中的时序预测与在线运筹规划
TACO(2026) 从「观察干预后波形」转向反事实的自然流量建模,通过纯净域名反转实验还原无干预波形,用 Transformer 深度时序模型预测未来 24 小时自然带宽:
再以混合整数规划把全天划分为削峰、填谷、免费、idle 各类时段,逐时刻求解干预幅度aₜ,削峰段压低超水位流量、填谷段释放体验空间,并以相邻时刻幅度差约束抑制波形突变:
(往左滑动查看完整公式)
算法初期上线后,95 峰等价带宽约 -2.4%,同时画质 UFQ 指标均有增加。
03 | 客户端:从静态规则到实时决策
3.1 统一下载决策:Demand
下载算法所希望回答的问题是,在用户还没划到下一个视频之前,应该提前下载哪些数据、下载多少?下载得少,滑到即卡顿,下载得多,用户划走后未播放的数据即成为纯粹的带宽浪费——在巨大的流量规模下,任何一点冗余都会被放大,其难点在于,决策必须在观看行为发生之前做出,因而本质是一个「以观看概率为权重、在体验收益与带宽成本之间取平衡」的预测与调度问题。
随着内容生态从纯短视频扩展到中长视频、直播与短剧,决策粒度也并不意外地从单视频、固定 Size 逐步细化到播放列表级、按秒与下载 Range 级。
音视频链路算法化的难点始终在建模上。作为前AI时代与互联网伴生发展的若干最复杂的技术领域之一,它很早就被「古法」程序员们使用各种抽象组合式、控制论式、复杂系统式的方法搭建了似简实繁的工程技术栈(播放器、流媒体服务),同时其实际工作时又依托于复杂、极具噪声的网络环境背景,此外,由于决策的频次极重,对性能损耗的容忍与一般的端智能模型相比有数量级的差异。因此每次建模和决策方式的提升尝试,背后的主要工作将是如何克制地运用算力、引入先验知识并克服偏置,「驯服」基本的变量,推动对应的工程改造,使其在复杂系统之中并不带来额外损失,且得到所需的计算性质。
短视频最早策略化的部分是预加载,常用的是固定策略,于当前视频下载完成后预加载后续 N 个视频、每个视频提前加载数百 KB,在抖音这些参数均由海量实验筛选得出,它在短视频为主的阶段十分有效,打败了大量看似精巧的算法方案,但稍长的视频引入后,还是会带来命中率低、数据浪费、卡顿上涨等问题。
早期抖音还采用过一种名为水位阀的技术,引入安全水位 S 与危险水位 D 双阈值闸门,当前缓冲水位高于 S 时开闸,将后续视频预加载任务串行插入当前视频 Range 请求间隙,低于 D 时关闸保播放,同期还结合了端智能快慢滑预测的能力来调整预加载大小。
Dynamic v1(2022) 在水位阀基础上引入动态水位机制与预加载Ladder设计,从有限个固定大小任务变为多任务配置组合,基于网速、卡顿、播放进度、快慢滑标签等多维信号动态调整阈值、预加载个数与大小,对抖音的用户活跃度有明显正向影响,带宽成本也有较大下降。
Dynamic v2(2023) 有三项演进:一是引入Weibull 观播时长建模,用形状k、尺度λ、位置μ三参数描述CDF ,支持服务端离线多维画像(片源/用户/视频)与端云联合在线预测,带宽成本-3%以上;二是可信播控,按观播时长调整目标缓存水位,短视频下压省成本、长视频上调减卡顿;三是按秒预加载,基于 MP4 封装特点将按时长决策预加载大小与按Size混合,提升中长视频起播速度。全链路缓存(2023)改进进一步用条件期望
 替代固定配置值。
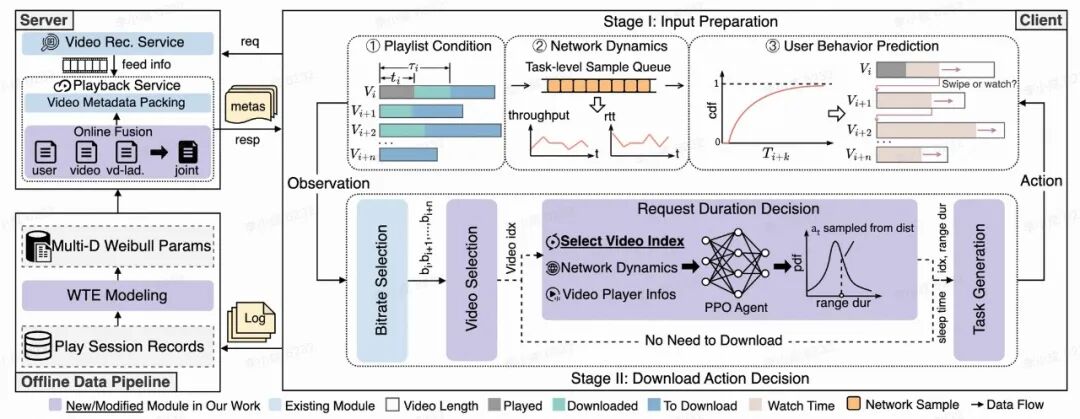
图4:客户端下载与播放的两阶段决策——Stage I 输入准备与 Stage II 下载行动决策
在 Dynamic 等预加载算法的基础上,Demand(2024) 以「统一 IO 决策」视角将抖音的预加载与播放下载在工程和策略上均收敛为一套逻辑,提出「下载需求」概念,从单视频决策扩展为播放列表级决策,最优下载拆为两阶段,一阶段按 选出列表中需求最高的视频,二阶段对候选视频 𝓲 判断是否下载Range 𝓇:
 。整体优化目标
 ,统一决策何时下载、下载哪个视频及档位、下载哪部分数据及下载方式。
Demand 算法的 RL 版 DeLoad(2025)用强化学习自适应地调整Range大小,策略 读取播放列表状态特征 s,输出 Range 决策 a,目标最大化期望累积回报
 ,更适配网络动态变化,但迁移成本较高。论文参考:
DeLoad: Demand-Driven Short-Video Preloading with ScalableWatch-Time Estimation(https://dl.acm.org/doi/10.1145/3746027.3754849)
Range-Level Preloading with Scalable Watch-Time Estimation for Billion-User Streaming Systems(https://ieeexplore.ieee.org/document/11538175)
3.2 播放实时选择:Vision
播放选择(档位选择)算法回答的是,在多码率环境下,当前该播哪个档位,进一步而言,所选择的不仅是某一视频档位,还包括针对该视频起始播放时,采取的一系列与所选档位配合策略,例如是否做超分和后处理,更改播放器运行的配置等。
音视频行业自 2008 年左右明确步入了多码率时代——之前 90 年代虽有先兆但并不普及,在复杂策略(规则)技术主导的几年之后,ABR 即(根据网络状态的)多码率自适应选档算法在 2014、2015 年左右逐步在各大公司成为了显学。短视频领域的消费中,预加载命中率可达 90% 以上,而在一次视频观看(vv)中,被观看的视频存在多个可消费档位的概率,则几乎在 100%。
这条路径的关键是逐步建立对最终上屏体验的精准理解,以规则负责兜底,通过性能模型预测动作后果,运用个性化信号刻画收益,联合决策框架统筹,最终达到画质、流畅性、负载与成本的综合最优。
选档曲线(2019) 抖音早期曾使用了名为选档曲线的技术,在线统计不同网速段下播放各码率视频的卡顿时长分布,例如将「单vv卡顿时长低于阈值(例如15ms)」定义为基本流畅,筛选有效「网速-码率」点后用多项式拟合映射曲线,输入当前网速即可输出推荐码率。该方法逻辑简单、可解释、易回滚,但所有用户、视频和设备共享同一条曲线,其映射可写为:
分群自适应(2020) 针对全局曲线无法区分用户差异的问题,按画质敏感用户、画质敏感视频等群体标签对曲线参数做差异化调整,端上超分的考量也在此阶段加入,按设备 CPU/GPU/ 内存能力圈选适用范围并结合实时负载设置运行条件,证明了个性化的必要性——同样档位对不同用户和设备的收益成本比不同。分群后的映射为:
Vision(2025) 将选档、超分、锐化和解码降级纳入同一决策体系,通过明确接口实现联合优化而非用模型替代,超分决策模块判断各档位是否适合超分及方式并将增强后画质反馈给选档,播放性能预估模块将候选档位的画质、卡顿与设备负载映射为统一性能价值,选档模块比较「档位 × 增强动作」的综合影响,单步目标函数为:
(往左滑动查看完整公式)
使用 MPC 在播放列表时域上滚动求解未来动作序列:
Vision 还引入了用户维度的个性化,基于历史卡顿事件构建了用户卡顿退出率画像,对退出率高的用户提高流畅性权重,对耐受度高的用户保留更多画质空间。实验显示卡顿退出率 -2% 以上,起播稳定性和播放流畅度显著优化,在播放时长增长的同时,码率降低还带来了较大幅度成本收益。
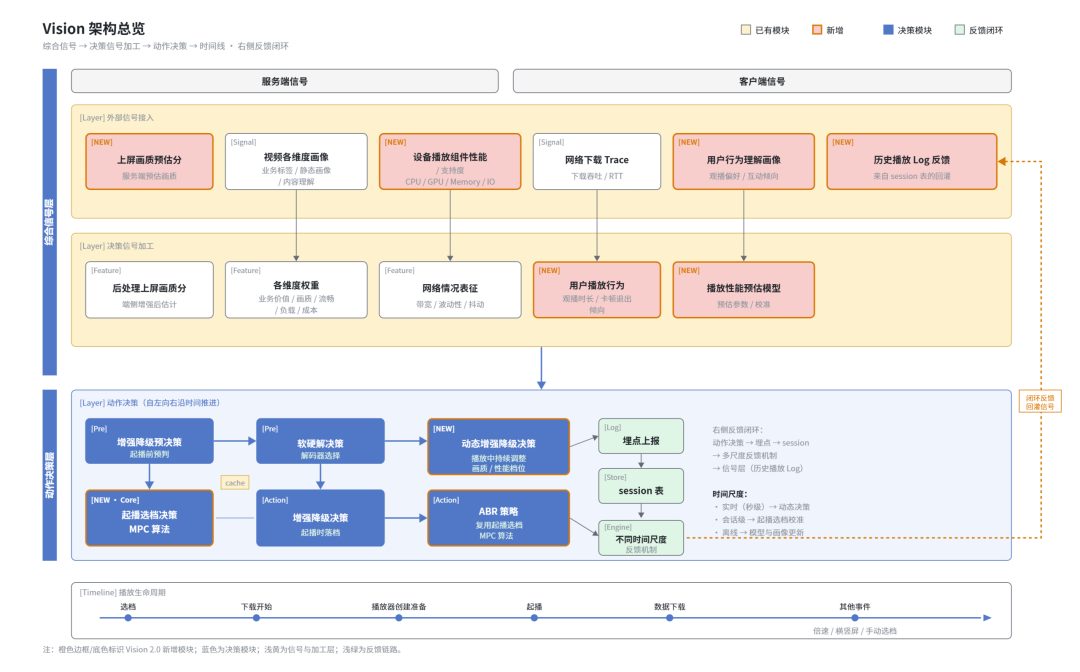
图5:Vision 的综合信号层与动作决策层架构,含信号接入、决策信号加工、动作决策与反馈闭环
3.3 客户端选路:ParaFlow与PRIME
ParaFlow 与 PRIME 回答的问题主要是「数据走哪条路径、用哪个网络资源」,移动设备常在 Wi-Fi 与蜂窝多路径间切换,路径质量时刻波动,客户端选路需要在多路径、多资源间做实时择优,其中 ParaFlow 是多路径选路的框架名,下文的 CROSS 与 Amphi 分别是它的两代实现,PRIME 则把决策对象从路径指向网络资源。
多路选择在业内不算很新的概念,但其他公司、团队或者上线者寥寥,或者并未达到足以令人满意的效果,学术界或者其他公司在此的尝试,弊病有时在于对于算法化「不够相信」或者「理解不深」,有时在于缺乏对基建的充分理解,假设失配或者先验误设。
可以例证的是,在形如 PRIME 的工作中,通过将优化目标直接与业务收益(包括用户指标、营收指标和成本)挂钩,就带来了巨大的价值,过程中较难的部分并非算法设计或者调参,而是在于长周期内,对底层工程链路的拆解重写,令其对齐建模时的相关基础假设。
CROSS 同时优化的是数据路径与 ACK 路径,数据侧发起两个并行下载任务,每次下载绑定一条路径,从源头减少跨路径乱序,buffer 告急时动态回退 minRTT 调度补带宽,ACK 侧对带宽、单向时延、丢包率归一化后加权打分,并针对 LTE 的上行瓶颈与 Wi-Fi 双向竞争做了差异化修正,按综合得分择优:
(往左滑动查看完整公式)
该版本基于XQUIC,吞吐+25%~38%,卡顿最高-52%,论文参考:
CROSS: A Dual-Sided Scheduling Framework for Efficient Multipath Video Streaming
Amphi 针对「用户随时滑走」与「移动网络波动」并存的短视频场景做跨层协同,应用层的多流调度器同时为多个候选视频分配带宽,减少卡顿与无效下载,传输层的多路径调度器将每路流分发至多条网络路径,增强对 Wi-Fi/ 蜂窝波动的鲁棒性,两层之间通过 ACK 反馈联动,这样多流 × 多路径的联合带宽分配可形式化为:
(往左滑动查看完整公式)
其中 为流𝒮在路径𝒫上分配的速率,Cₚ为由ACK反馈实时估计的路径容量,Uₛ(·)为流𝒮的边际效用函数,应用层多流调度与传输层多路径调度共享同一分配结果,并随 ACK 反馈滚动更新。该版本 QoE+18.6%~75.2%,带宽浪费 -6.3%~13.4%。

图6:Amphi 的应用层多流调度器与传输层多路径调度器通过 ACK 反馈联动
PRIME(2026) 的思路是,把决策对象从「路径」指向「网络资源」,综合各资源的实时性能、带宽单价、用户播放状态与个性化观播时长估计体验收益,在候选资源集合中做「体验收益-带宽成本」的统一权衡并灵活切换,在抖音上线过程中已累计取得约 -8.5% 的带宽收益,其决策可写为:
论文参考:PIRA: Pan-CDN Intra-video Resource Adaptation for Short Video Streaming(https://arxiv.org/pdf/2510.18606)
3.4 网络测速:单队列 vs SHEF
网络测速 面向的是这样一个问题:「当前有多少网络资源可用」,它本身不做播放决策,但会作为 Demand、Vision 和其他算法策略的共同输入,测速偏低会直接压低码率,因此它的鲁棒性还决定了其他下载策略能否顺利上线。
网络测速算法的输出是客户端音视频算法的基础输入,本身存在多年,原始版本行业通用,十分简单有效,并且经过了多种对比评估,证明其他许多精巧的设计并不能带来增益;但另一方面,抖音在经过仔细观察,仍然可以做出形如SHEF的改进并带来直接效果,这个事实再次、明确地提醒我们:一切价值均可结合环境重估,基础环节仍可改进。
单队列测速(2019) 即常见的被动式单队列架构,播放下载组件的 Range 下载完成回调产生一个采样点,送入定长 FIFO 队列统一给出估计,默认算法为加权中位数,以每次下载的数据量Sᵢ为权重,取累计权重首次过半的采样点,避免异常采样拉偏结果:
算法本身较为简单基础,同期也试过 MLP、GBR 回归预测网速等各种策略,但队列长度超过 15 后改善很小,认知为移动网络波动大导致时序预测空间有限,因此很长时间内仍以加权中位数为主要默认算法。
鲁棒性修正(2023) 不是针对算法精度修改,主因是观测被其他策略污染,Range 的缩小抬高了建联开销占比、缓存控制又减少了高网速时段采样、多样化 CDN 资源与分片并行下载等都会改变观测值,结果是码率沦为其他策略调整的副产品,所以在不改主框架的情况下,可以叠加几项修正,其中建联开销修正由 反解得到:
 为窗口内平均任务大小,
 为建联开销粗估值,静态基准
 用于把该开销的影响固定,迭代方向是引入更多 RTT 特征、改为预估指定分片的下载耗时,并按 CDN 类型分别估计等。
SHEF(Stratified Heterogeneous Estimation Fusion,2026) 的目的是更彻底地解决单队列的结构性局限,由于采样只在下载完成时产生,更新频率受下载节奏支配,稳态播放下采样间隔可达数秒,网络劣化时只能沿用很旧的估计。SHEF 相当于把「窗口取长还是取短」的 trade-off 从窗口移到加权的维度,即将下载完成、过程、超时等不同类别事件分入不同队列,再按网络状态加权融合:
(往左滑动查看完整公式)
不同采样共享同一数据结构,仅以事件类型区分语义,让测速值在连续下载中持续变化,配合突变弱网检测影响下载决策,替换后带来 LT 上升、画质提升、卡顿率下降、成本下降等收益。
04 | 小结
在团队过往的总结中,曾经定义了 L1-L5 级别的个性化能力标准,虽然当前抖音仍在 L4 的层次上前行——
对齐最先进的个性化技术
建立千级别的干预点
支持半自动化挖掘新干预点和自动化评估
支持高阶信号如长序列、多模态等
支持业务影响视角进行特征构建,支持通过数据挖掘驱动特征构建
视频和用户全类型覆盖
达到十万分之一的业务优化精度
......
但随着 AI 浪潮近几年的推动,L5 等级所描述的全系统、全链路精准感知与计算,自动化拓展状态空间,策略统筹、模型精度方面达成理论最优等目标,也并非天方夜谭、遥不可及,期待后续抖音可以将技术理想实践落地,为用户带来极限的音视频体验。
本文转载自微信公众号「字节跳动技术团队」,查看原文。版权归原作者所有,如有侵权请联系删除。