复旦等提出 RSI-Nav:统一视觉—语言—动作学习,让导航模型实现数据驱动的自我进化
52CV 2026-11-02 18:00 江苏
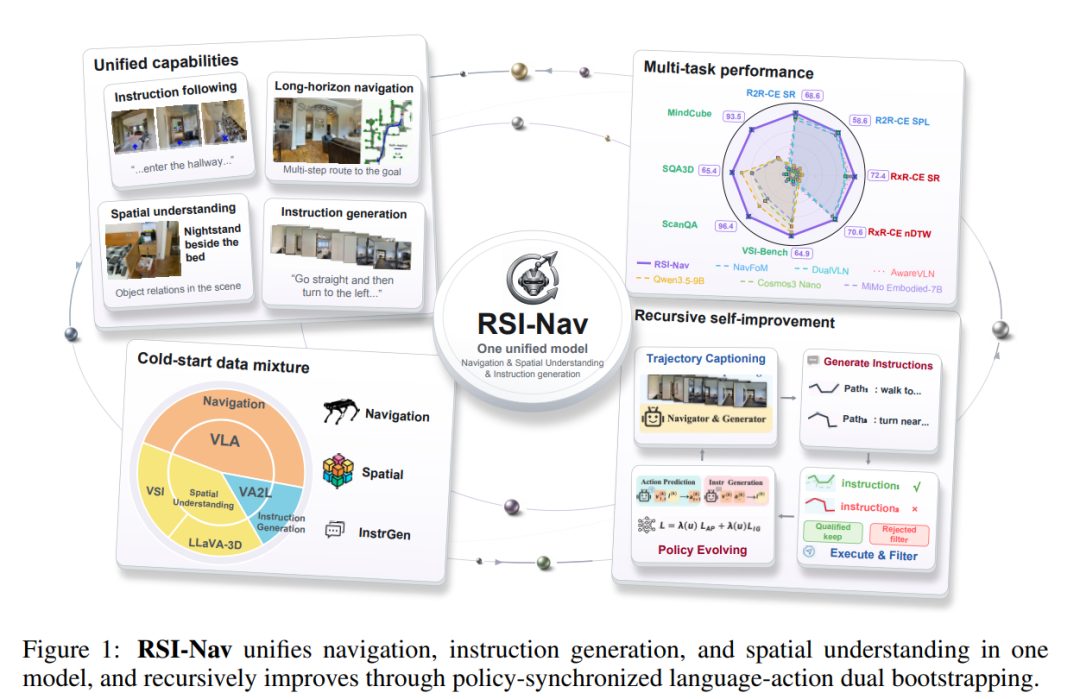
只用 RGB 视觉输入,R2R-CE / RxR-CE 导航成功率分别达到 68.6% / 72.4%;相比初始模型提升 15.7 / 17.7 个百分点。代码、模型和数据均已开源。
论文标题: Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
导航模型能否自己生产训练数据?
视觉语言导航(Vision-Language Navigation, VLN)要求智能体结合第一视角图像和自然语言指令,在陌生环境中连续决策。相比单次图文理解,VLN 还考验跨视角的地标定位、空间关系推理和长程动作规划。
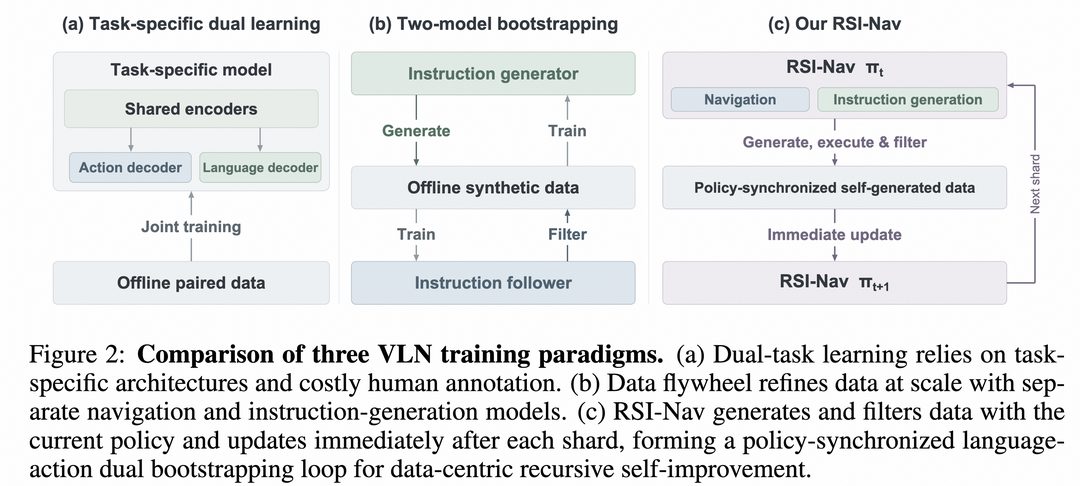
训练这类模型需要大量“指令—轨迹”配对数据,而现成的无标注导航轨迹远比人工指令丰富。过去的做法通常是先由指令生成器批量标注轨迹,再拿合成数据训练导航器。但这里存在两处关键断点:其一,指令生成与导航执行分属不同模型或任务专用模块,双向知识难以充分共享;其二,离线合成数据不能及时响应导航策略的变化,形成 Policy Gap。
RSI-Nav 的思路是:让同一个视觉语言模型既能根据语言行动,也能根据视觉—动作轨迹生成语言,再以真实执行结果筛选监督、更新自身。
两个设计:统一双向学习,缩小 Policy Gap
设计一:VL2A 与 VA2L 共用一个模型
基于 Qwen3.5-9B,RSI-Nav 以任务 Prompt 区分三类能力:VL2A 根据视觉历史和指令预测导航动作;VA2L 根据沿途图像与动作生成路线指令;Spatial Understanding 则提供方位、地标和空间关系理解。三者共享参数,无需额外训练独立的 Speaker 或专用输出头。
这一设计的意义不只是减少模型数量。对 VA2L 而言,描述一段路线需要辨认沿途地标、转向和终点;对 VL2A 而言,这些恰好是将指令落地为动作的关键视觉语义。把双向任务放在同一模型中,可以让语言监督与动作决策相互受益。
设计二:Policy-Synchronized Language-Action Dual Bootstrapping
对于每一批无标注轨迹,当前模型依次完成四个步骤:
Generate:根据视觉—动作轨迹生成导航指令;Execute:从起点执行该指令;Filter:依据是否抵达目标及路径效率筛选样本;Update:使用通过验证的指令与原始参考轨迹进行监督微调,然后让更新后的模型处理下一批数据。
这里,执行轨迹负责验证,原始轨迹负责动作监督,避免把试走时的动作偏差当成学习目标。训练采用分批、及时的 SFT 更新,不需要额外的强化学习过程。虽然轨迹来自离线数据池,但生成和验证由不断更新的模型负责,因此称为 Policy-Synchronized,而非严格的 On-Policy。
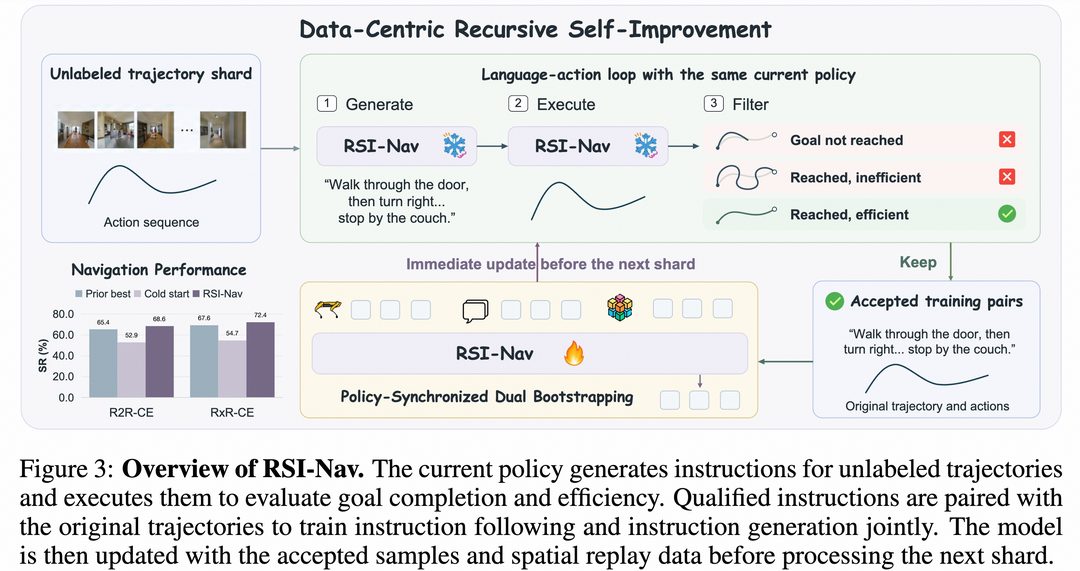
借助这一流程,RSI-Nav 累计构建约 250 万条导航训练样本和 110 万条指令生成样本。其核心并非单纯扩大数据量,而是让监督的生成与质量检验持续跟随当前模型。
实验:提升的不只是导航成功率
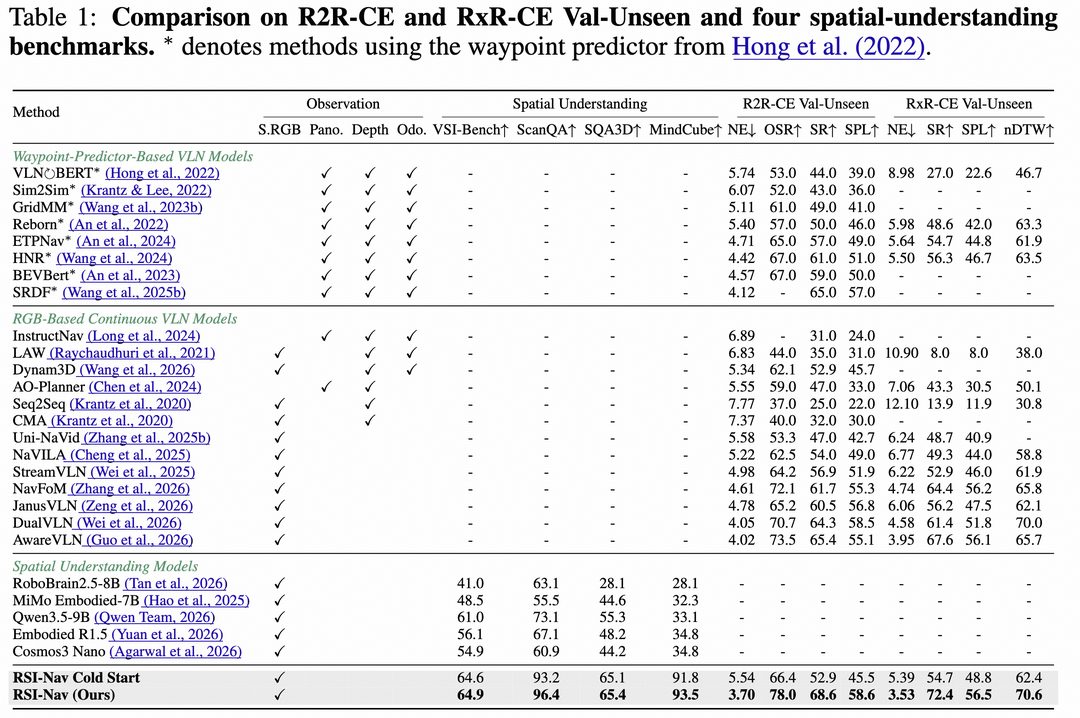
在 R2R-CE 与 RxR-CE Val-Unseen 测试中,RSI-Nav 仅使用第一视角 RGB 图像,不依赖额外深度、里程计或外部 waypoint predictor。相较自进化前的 Cold Start 模型:
导航基准 | Cold Start SR | RSI-Nav SR | 提升 |
|---|---|---|---|
R2R-CE | 52.9% | 68.6% | +15.7 个百分点 |
RxR-CE | 54.7% | 72.4% | +17.7 个百分点 |
与此同时,R2R-CE 的 SPL 从 45.5% 提升至 58.6%;RxR-CE 的 nDTW 从 62.4 提升至 70.6,说明提升不仅体现在抵达终点,也体现在路线执行质量。
更值得关注的是两项验证。
双向学习确实有效。 仅使用导航监督时,模型获得 44.7% SR;加入 VA2L 轨迹指令生成后升至 48.8%,再结合空间理解监督达到 52.9%。
指令质量能转化为下游收益。 将生成指令用于训练同一导航模型,采用 RSI-Nav 指令时的 SR 为 41.3%,高于 SRDF 指令的 36.8%。这比仅评估文本相似度更直接地反映合成数据的训练价值。四项空间理解评测也较 Cold Start 均有小幅改善。
从 Benchmark 到真实机器人
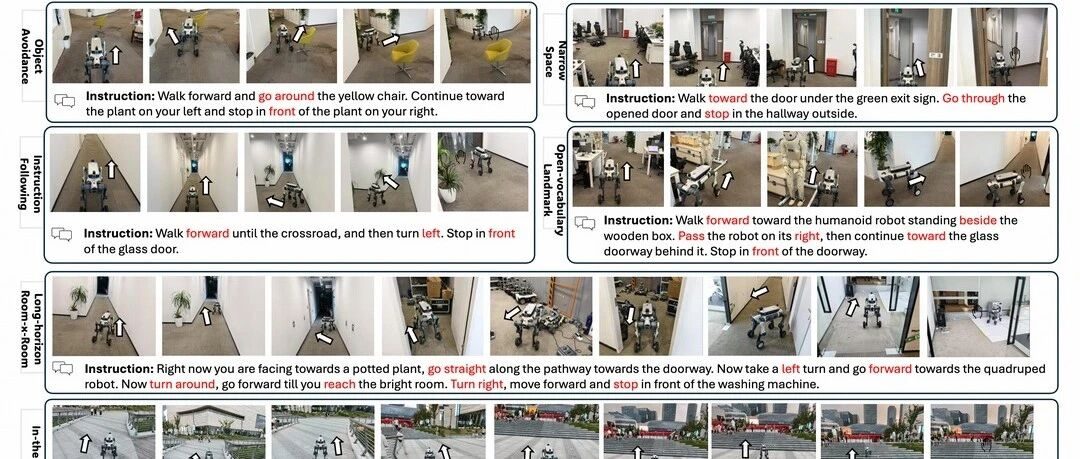
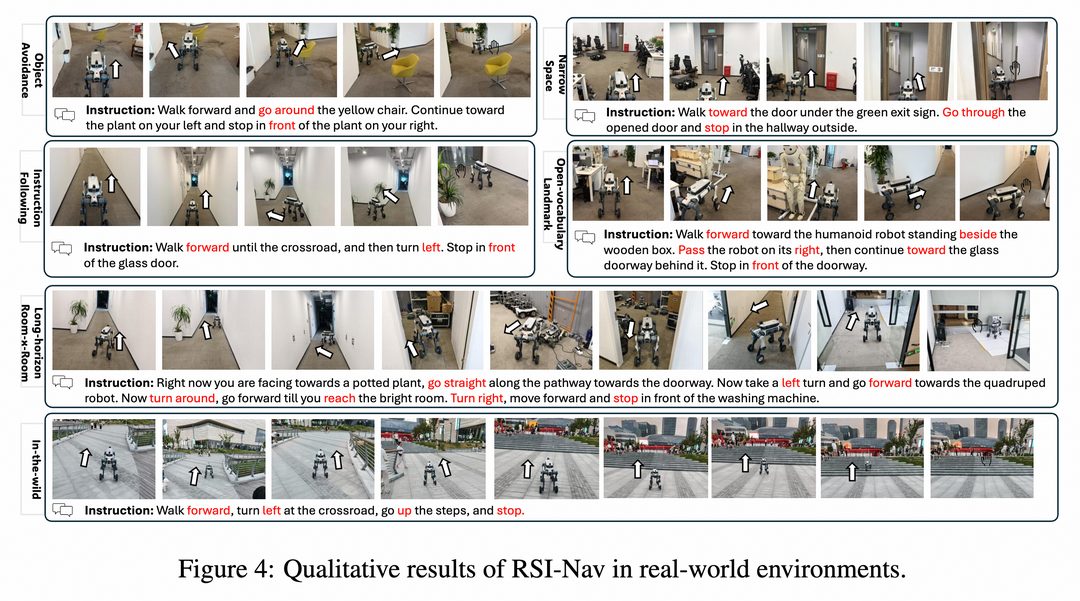
团队进一步在 DEEP Robotics M20 四足机器人上进行了 RGB 闭环导航演示,包括室内外避障、狭窄空间通行、开放词汇地标定位以及跨房间长程指令跟随。
总结
RSI-Nav 的价值在于把 VLN 中两个天然互补的方向——视觉语言到动作(VL2A)与视觉动作到语言(VA2L)——转化为一个可验证、可迭代的数据学习闭环。与传统“先合成、后训练”的静态流程相比,模型不仅消费训练数据,也参与生产和筛选下一轮数据,为 Data-Centric Recursive Self-Improvement 提供了一条不依赖 RL 的路径。
相关资源:
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。