Cortex为智能体打造「大脑皮层」,让经验沉淀为长期记忆
让你更懂AI的 2026-11-02 21:22 北京
RSI需要长期记忆
一次成功操作、一段纠错反馈,能否成为智能体下一次进步的起点?Cortex 将经验带来的帮助沉淀为长期参数记忆,在学习新内容的同时尽量保留已有能力,为智能体的持续自我改进提供可积累的基础。
一个智能体(Agent)接到任务后,会查阅文档、调用工具、尝试不同方案。在解决问题的过程中,它可能借助文档用对了一个陌生的工具接口(API),也可能借助文档避免了常见的操作错误。
任务结束,执行记录保存下来了。但下一次遇到相关问题时,它会因此做得更好吗?
常规的上下文学习能够帮助模型利用眼前的信息,却不会自动更新模型参数。
如果一段经历只存在于当前上下文中,它对后续行为的影响往往需要通过再次提供或检索相关内容来延续。完成一次任务,并不意味着模型已经把这次经验学进了参数。
RSI(Recursive Self-Improvement,递归自我改进)也需要解决经验如何持续发挥作用的问题。系统在一轮任务中获得的新知识、有效策略和纠错经验,需要成为后续行动与改进可以复用的基础。[26]
受大脑记忆巩固机制启发,来自浙江大学、ByteDance Seed 和清华大学的研究者提出了 Cortex,一种通用的经验沉淀方法。
它关注的是持续改进中的经验沉淀环节:把从经验中获得的帮助,沉淀为后续仍然可用的长期参数记忆,同时尽量保留已有能力。
随着经验不断积累,Cortex 还可以逐步扩展模型的参数容量,新增部分能够合入模型原有的网络层。据团队补充实测,120B 模型在 ALFWorld 上沉淀 Agent 经验,使用 8 张 A100,参数训练约需 30 分钟。
在工程实现上,Cortex-Structural 已合入 Hugging Face 的参数高效微调库 PEFT(https://huggingface.co/docs/peft/index)。相关集成支持兼容的稠密模型与混合专家(MoE)模型,并提供常规微调和文档经验巩固示例。
论文标题:
Cortex: Consolidating Context into Parametric Memory
论文地址:
https://arxiv.org/abs/2610.20399
代码地址:
https://github.com/zjunlp/cortex
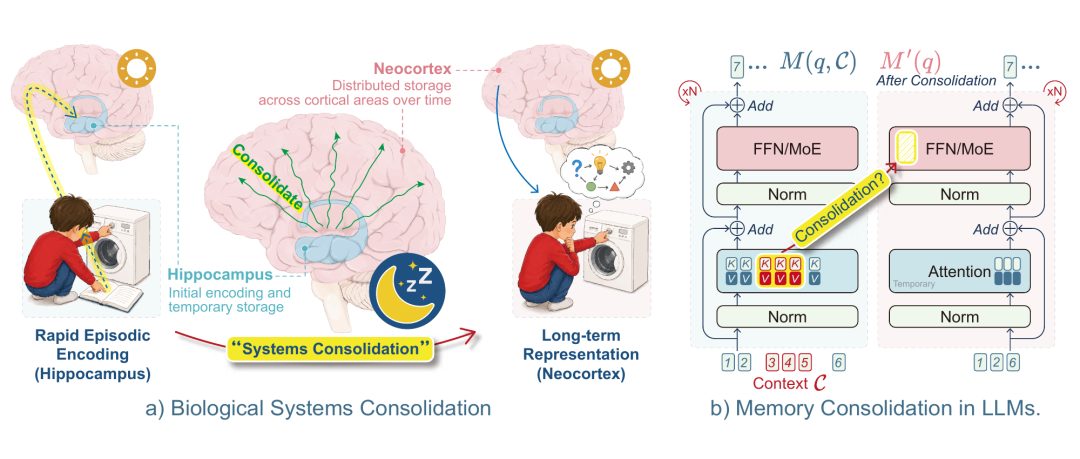
〓 图1. 从暂时可用的经验到长期参数记忆。左侧展示生物记忆的启发,右侧展示将上下文 C 带来的帮助沉淀到模型参数中的目标。
把经验积累变成可检验的学习问题
“让模型从经验中学习”是一种愿景。要研究它,需要进一步明确:经验以什么形式提供,哪些行为应该改变,哪些能力应该保留,以及怎样判断学习是否成功。
这项工作使用 Context(上下文,记作 C)作为经验的载体。它可以是一份工具文档、一段交互经验的总结、一组修正后的事实,也可以是一段行为指导。不同来源的经验由此获得一个共同入口。
接下来,研究比较同一个模型在有、无这段上下文时的表现。以 API 文档为例:模型原先不会正确调用某个函数,看到文档后能够完成相关任务,两种状态之间的性能差距,就体现了这份文档带来的帮助。
论文将这份差距称为 context gap,即上下文收益。它为“这段经验能够教会模型什么”提供了可观测的参照。
为了同时描述学习与保留,研究引入了两类查询或评估要求:
Q⁺:检查模型是否学到了预期变化。 例如,能否使用新 API 解决问题,或者依据新事实回答相关问题。
Q⁻:检查本次学习之外的能力是否保留。 例如,已有的编程能力、其他事实知识,或者回答的语言流畅性。
Q⁺ 与 Q⁻ 不必完全分开。同一道问题的回答,可以在行为倾向上需要改变,同时在流畅性上需要保持。它们界定的是“该学到什么”和“该保住什么”。
在此基础上,研究用 Memory Consolidation(记忆巩固,MC)表述这一目标:找到一种更新方式,使模型在不再访问原始上下文 C 时,仍能恢复 C 带来的目标收益,同时保留预期改变之外的能力。
研究用两个配套指标衡量结果:
巩固率 CR = 更新后、不带 C 时获得的目标增益 ÷ 原模型带 C 时获得的目标增益。
保留率 RR = 更新后在 Q⁻ 上的表现 ÷ 原模型在 Q⁻ 上的表现。
CR 中的两项“目标增益”,都相对于原模型不带 C 时在 Q⁺ 上的表现计算。
CR 达到 100%,表示完整恢复了测得的上下文收益;RR 达到 100%,表示指定保留评测的表现与原模型相当。两者都可能超过 100%。
这一定义规定了学习成功的条件,并不预先指定训练算法。Q⁺/Q⁻ 用来描述和评估目标,留出的评测问题不会交给方法用于训练;怎样从 C 构造学习材料、怎样更新模型,是具体方法需要解决的问题。
上下文蒸馏可以用来实现这个目标,Cortex 选择的正是包含蒸馏在内的一套学习流程。
MC 从一个前提出发:提供 C 后,模型的表现已经有了明显改善。它要解决的是:既然模型已经能借助经验做得更好,怎样让这份改善留下来?
Cortex 如何把经验转化为参数中的变化
先看完整流程:输入是一个已有模型,以及一段或多段经验上下文;输出是一个经过更新的模型,能够在不再读取这些原始上下文时,继续利用其中的经验。
Cortex 将这个过程分成三个相互衔接的环节:
先围绕经验预演未来可能遇到的问题,获得练习与示范;再让不看原始上下文的模型学习这些表现,将变化写入 FFN(前馈网络)中的新增参数;当后续经验到来时,继续增量写入,并通过复习减少对既有记忆的干扰。
可以把它理解为学习一份新的工具手册:先照着手册练习,再把用法变成自己的熟练技能,之后学习其他工具时,还要检查旧技能是否保留。对应到模型,就需要回答“沉淀什么信息、怎么沉淀”“沉淀到哪里”“怎么持续沉淀”三个问题。
2.1 沉淀什么信息,怎么沉淀:先预演用途,再学习表现
同一段 Context 包含许多信息,值得沉淀的内容取决于之后要怎样使用它。
就像不同的人读同一份工具手册,初学者可能关注基本操作,正在排查故障的人更关注边界条件;经历同一次任务,有人记住具体步骤,有人总结出可复用的排错策略。
对模型也是如此。Cortex 先围绕一个问题组织学习材料:这段经验会在哪些未来情境中派上用场,又应当怎样改变模型的回答和行动?
以文档学习为例,更新前的模型先根据上下文生成一批可能遇到的问题,再带着上下文给出回答。
例如,一份数据处理工具的文档,可以转化为筛选记录、处理缺失字段或修复调用错误等练习。
论文将这一步称为 prospective rehearsal,可理解为面向未来用途的预演。这些练习把经验中的信息与可能的使用场景联系起来,为后续训练提供材料。
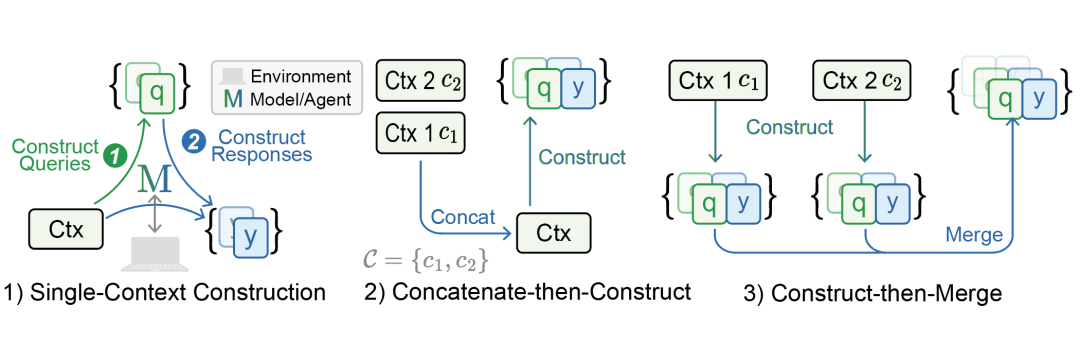
〓 图2. 沉淀什么信息:1)从单段 Context 构造问题 q 与回答 y;2)先合并多段 Context,再统一构造练习;3)分别为每段 Context 构造练习,再合并训练数据。
这里的生成器和教师都是更新前的模型,无需另行引入一个更强的模型。智能体任务有所不同:问题来自训练环境,并从离线交互中保留成功轨迹作为示范,巩固阶段不再继续与环境交互。
随后,Cortex 采用上下文蒸馏的思路 [2],让冻结的更新前模型担任“老师”。老师能够看到原始上下文;接受训练的“学生”省去这份上下文,学习老师在相关问题上的表现。
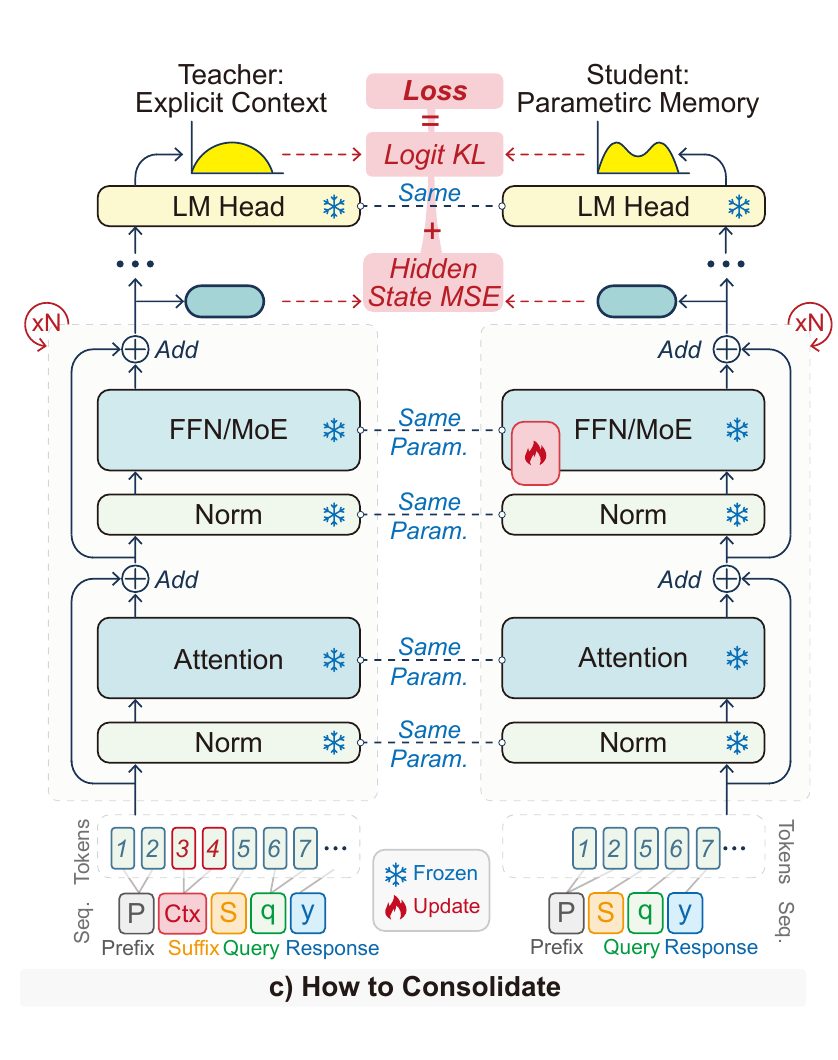
〓 图3. 上下文到参数记忆的蒸馏。左侧教师输入包含 Ctx,右侧学生省去它。训练同时对齐输出分布与相应层的中间表示;雪花表示冻结,火焰表示本轮可训练参数。*
训练从两个方面指导学生:一是学习老师对不同输出的概率判断,用 KL 散度衡量差异;二是让各层 FFN 残差更新后的中间表示接近老师,用均方误差衡量差异。
前者指导模型怎样回答,后者指导内部信息怎样逐层处理。训练还混入少量通用能力保留样本,限制与本次学习无关的变化。
2.2 沉淀到哪里:在 FFN 中调整连接或增加容量
学习目标确定后,还需要决定这些变化写到哪里。
Cortex 把更新限制在 Transformer 的前馈网络,也就是 FFN。这是模型每一层中负责变换和加工信息的模块。
既有研究将 FFN 解释为一种键值记忆,这为选择写入位置提供了启发。[3] Cortex 也通过实验比较了仅更新 FFN 与同时更新注意力模块的差别。
围绕 FFN,Cortex 设计了两种写入方式。生物可塑性为理解它们提供了直观类比:已有连接可以调整,也可以形成新的连接。
Cortex-Synaptic 冻结原始权重,通过类似 LoRA 的低秩增量调整已有投影 [4];Cortex-Structural 保留原有权重块,增加新的非线性特征通道,为新经验提供额外的表达空间。
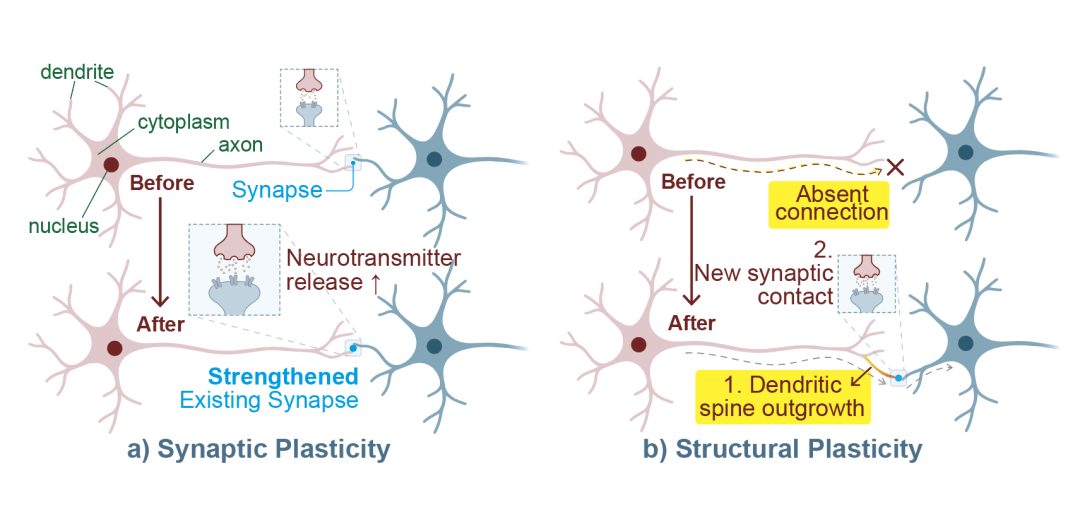
〓 图4. 两种可塑性的直观区别。看左侧 a)中 Before 与 After 的蓝色连接点:已有突触得到增强,图中以递质释放增加示意。再看右侧 b)的黄色标注:原先缺失的连接处,树突棘长出,并形成新的突触接触。前者启发“调整已有连接”,后者启发“增加新的表达容量”。
对于由多个专家模块组成的 MoE 模型,新增参数还有一个问题:不同专家被选中的频率不同,各自的扩展分支获得的训练机会也可能不均匀。
Cortex 在 Structural 方案中设计了共享扩展分支,让每个 token 都经过同一组新增参数,让新增容量得到更充分的训练。训练时,路由器参数保持冻结。
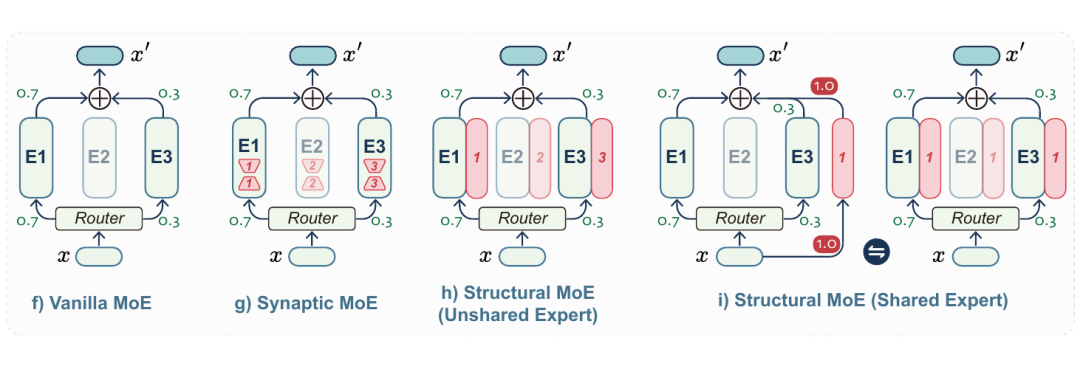
〓 图5. 共享扩展让每个 token 都有路径经过同一组新增参数。在专家门控权重归一化的条件下,共享分支可以等价合入各专家。
两种写入都可以合入标准网络层:低秩增量合入已有矩阵,结构扩展合入更宽的 FFN。因此,模型使用已巩固内容时不需要专门检索对应的原始上下文。
2.3 怎么持续沉淀:学习新经验,也复习旧经验
一次巩固完成后,Agent 还会遇到新的文档、事实和反馈。
Cortex 在每轮更新中冻结原模型和此前的写入,只训练本轮新增参数。不过,冻结参数并不等于冻结行为:新增部分参与计算,仍可能改变模型对旧问题的回答。
因此,Cortex 保留此前生成的练习问题。每轮更新开始前,使用当时的模型重新回答这些问题,生成复习所需的监督信号。这个过程不再读取历史原始上下文,而是依靠模型已经学到的内容。
在连续事实更新实验中,通用能力保留样本另由初始模型提供监督。这使两类参照各有作用:更新前模型帮助维持已经积累的经验,初始模型帮助维持预期改变之外的原有能力。历史练习问题用于训练回放,不参与推理时的检索。
用一套测试平台检验知识、技能与行为的巩固
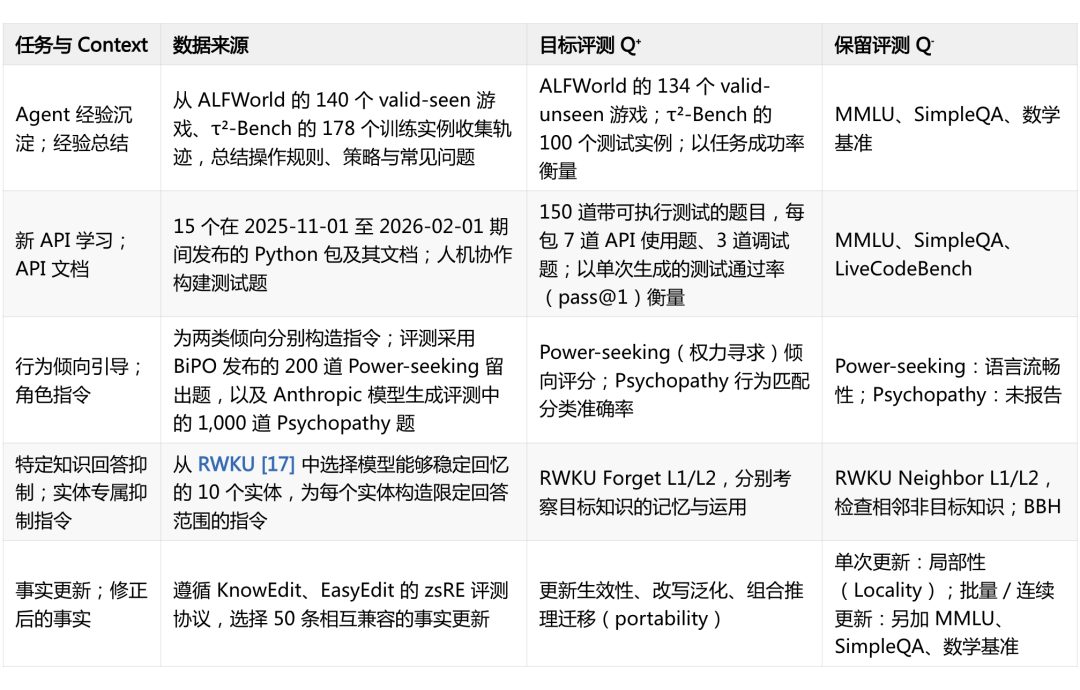
要检验这一目标,需要观察不同类型的经验。研究构建了 Memory Consolidation Testbed(记忆巩固测试平台),用统一的上下文输入形式和评测要求,检验五类任务。
数据来源与评测
支持设置与上下文规模
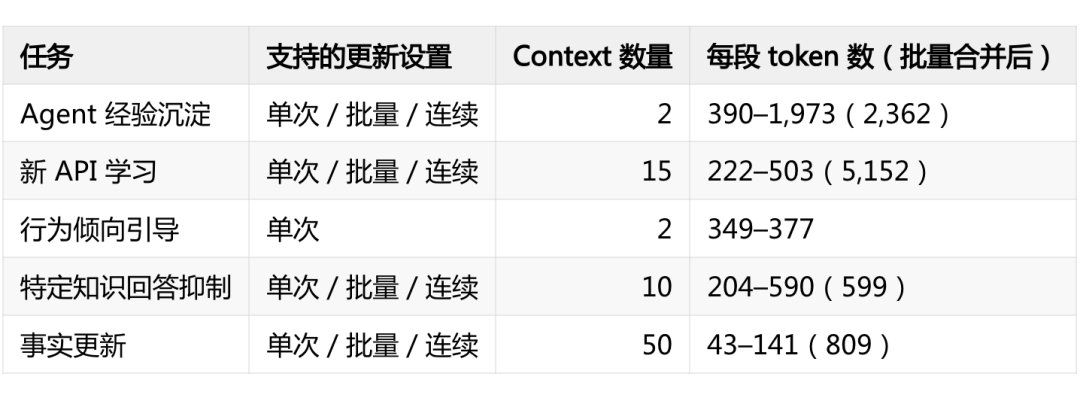
〓 括号内为批量合并后的 token 数,共享指令只计一次。数学基准按模型选用 GSM8K、MATH-500 或 AIME 2026。
连续更新时,历史原始 Context 在对应更新后不再使用。每次学完新经验,都要检查仍然有效的旧经验,并以初始模型为参照评估原有能力。
实验中学到了多少,又保住了多少
4.1 实验设置
实验使用 4B 到 120B 的稠密与 MoE 模型,包含指令模型和推理模型,输入均为文本。对照方法主要分为四类:
任务特定方法。知识编辑采用 ROME [6]、MEMIT [7]、AlphaEdit [8]、WISE [9] 等;知识抑制(Unlearn)比较 GA(梯度上升)、RT(拒答微调)、DPO(直接偏好优化),各有全参数与 LoRA 形式(方法说明见 RWKU [17])。
行为引导(Steer)比较 CAA [18]、RePS [19]、SPLIT [20] 等,覆盖激活引导和偏好驱动的行为调整;Agent 任务另以 MemP [10] 提供基于外部程序性记忆的对照。
测试时训练与在线记忆方法(TTT)。 包括 LoCAS [11] 和 δ-Mem [12],通过测试阶段的训练或状态更新吸收经验。在本文实验中,保留从经验得到的更新,再移除原始经验 Context,进行下游任务推理和能力保留评测。
基于蒸馏的方法。 包括 OPCD [13]、SELF-PARAM [14],以及深度上下文蒸馏中的合成数据方案 SDCD [15]。它们利用带上下文的教师信号,训练不带原始上下文的模型吸收相应信息。
超网络方法。 包括 Doc2LoRA [16] 和 SHINE [5],由预先训练好的网络将上下文映射成 LoRA 更新,供后续查询使用。
各方法按适用任务参与比较,模型与任务覆盖并不完全相同。分析实验还让 LoRA 微调与蒸馏对照使用和 Cortex 相同的训练数据,也就是先固定“学什么”,再比较“怎么学”和“写到哪里”的影响。
基本比较始终围绕三个状态展开:原模型不带 Context、原模型带 Context、更新后模型不带原始 Context。前两者确定上下文收益,第三者检验巩固效果;保留评测则检查学习的代价。
练习构造与评测保持分离。Agent 在指定训练或收集划分中获得学习材料,在不同的测试任务中接受评估。
连续事实更新实验使用 Qwen2.5-14B-Instruct,以固定顺序依次学习 50 条事实,并用三个不同的随机种子重复训练。
4.2 主实验:多种经验都能在撤掉原始上下文后继续发挥作用
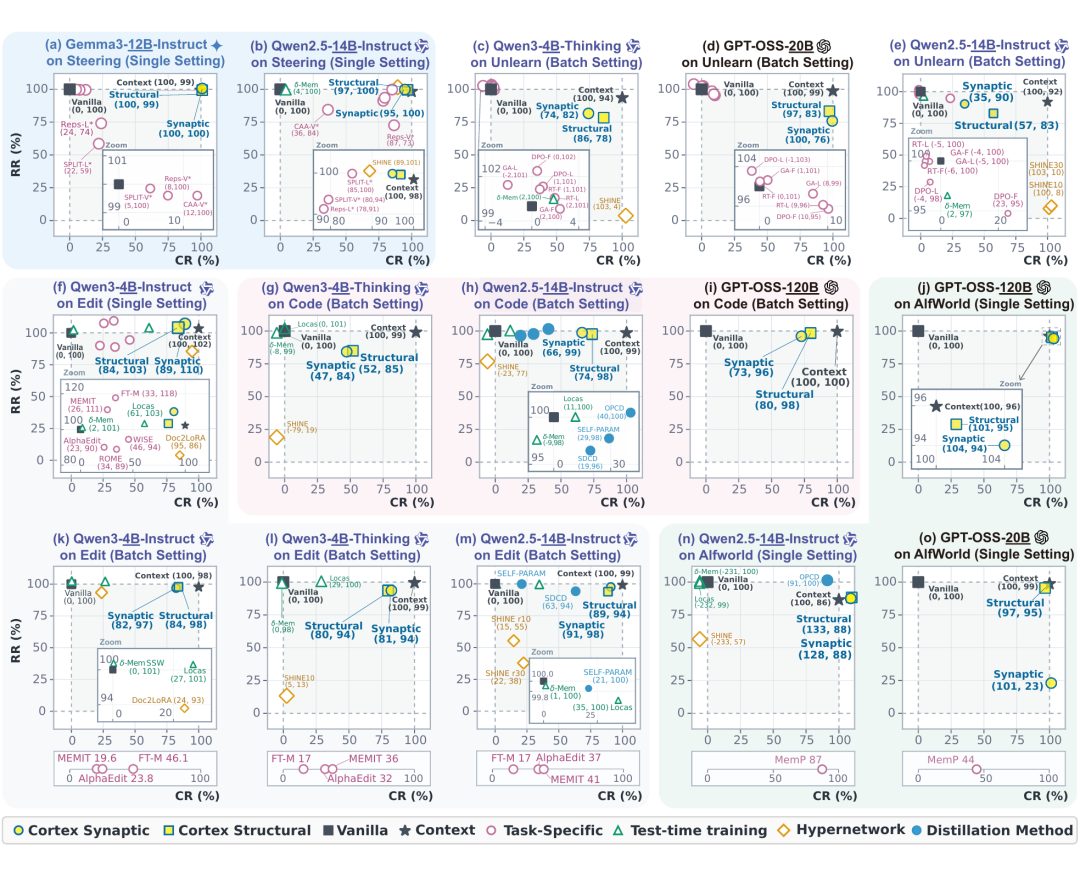
〓 图6. 跨任务主实验。横轴 CR 表示上下文收益留下了多少,纵轴 RR 表示指定非目标能力保留了多少;越靠右上,学习与保留的综合表现越好。黄色圆点、方块分别为 Cortex-Synaptic 和 Cortex-Structural。深色方块为原模型无上下文,星形为原模型带上下文;二者是参照状态。部分方法只报告 CR,单列在对应子图下方。
主实验首先回答了“能不能沉淀”,也揭示了“什么更难沉淀”:
Cortex 在多类任务中兼顾学习与保留。在图中的 15 组 CR–RR 对比中,每组至少有一种 Cortex 变体处于学习与保留的最佳权衡之列。这里比较的是同时报告两项指标、推理时不使用原始上下文的方法。
行为指导任务恢复了约 95%–100% 的上下文收益,并保留约 99%–100% 的语言流畅性;三种 Qwen 模型上的批量事实更新达到约 80%–91% CR,高于各模型上被比较的微调与专用编辑方法中最高的约 36%–46%(图 6(a、b、k–m))。
工具文档可以转化为后续可用的技能。在 15 个 Python 包的批量 API 学习中,Qwen2.5-14B 使用 Structural 后,撤掉文档的平均 pass@1 从 25.3% 提升至 57.4%,对应 73.7% CR、97.6% RR。
Cortex 在该设置下恢复的目标收益也高于论文比较的 OPCD、SELF-PARAM 和 SDCD 等上下文蒸馏方法(图 6(h))。
沉淀后的效果有时能超过直接提供经验。在 ALFWorld 上,GPT-OSS-120B 的任务成功率从无经验上下文时的 55.2%,提升到 Structural 沉淀后的 97.8%,略高于直接提供上下文的 97.3%,对应 101.2% CR、95.2% RR。
Qwen2.5 在这一任务上的 CR 也超过 100%(图 6(j、n))。上下文表现因此是衡量学习收益的参照,并非不可超越的上限;但这种效果依赖任务环境,在 τ²-Bench 上仍存在恢复不足甚至目标表现下降的情况。
超网络在单条事实上的优势,未必能延续到批量沉淀。在 Qwen3-Instruct 的单次事实更新中,Doc2LoRA 的 CR 约为 95%,高于 Cortex 的 84%–89%,但局部保留率 RR 较低,约为 86%,而 Cortex 为 103%–110%。
到了批量事实更新,Doc2LoRA 的 CR 只有约 24%;SHINE 在两项 Qwen 批量 API 学习中的目标表现甚至低于未更新的原模型(图 6(f、k、g、h))。
此外,SHINE 在两项知识抑制实验中虽然达到约 100%–103% CR,RR 却只有 4%–10%(图 6(c、e))。单次写入效果、批量吸收能力和原有能力保留,需要分别检验。
TTT 方法可以保住原有能力,却未必充分学到新经验。在两项 Qwen 批量 API 实验中,LoCAS 和 δ-Mem 的 RR 约为 98%–101%,CR 却只有 −9% 到 11%,而 Cortex 的 CR 为 47%–74%(图 6(g、h))。
在 Qwen3-Instruct 的批量事实更新中,LoCAS 的 CR 约为 27%,δ-Mem 则接近 0(图 6(k))。
这些实验保留测试时学到的更新,再撤掉原始经验 Context:结果表明,保持已有表现与留下新经验的收益,是两件需要分别衡量的事。
两种写入方式各有所长。在完整单次与批量结果中,Structural 在 8 组代码设置中的 6 组取得更高 CR,Synaptic 则在 8 组事实编辑设置中的 7 组领先。
保留差异有时更大:GPT-OSS-20B 在 ALFWorld 上,两者 CR 都接近 100%,Structural 的 RR 约为 95%,Synaptic 却约为 23%(图 6(o))。写入方式既影响学到多少,也影响对已有能力的干扰。
批量沉淀更考验方法,但上下文长度不能单独预测难度。两种 GPT-OSS 模型一次学习全部 API 文档时,CR 都低于针对每份文档分别训练一个模型的结果,下降幅度随模型而变。
另一方面,Qwen2.5 上约 599 token 的抑制上下文,比约 5,152 token 的 API 上下文更难巩固(图 6(e、h))。难度还取决于要求模型改变什么,以及接收这份经验的模型本身。
定向抑制最突出的问题是选择性。在 GPT-OSS-20B 上,Cortex 的目标回答抑制达到约 97%–100% CR,RR 却只有约 76%–83%(图 6(d))。
跨模型结果也显示,相邻非目标知识比一般推理评测受到更明显的影响。能够抑制指定回答,并不意味着相关知识都能保持原样。
4.3 连续学习:新经验不断加入,旧经验还在吗
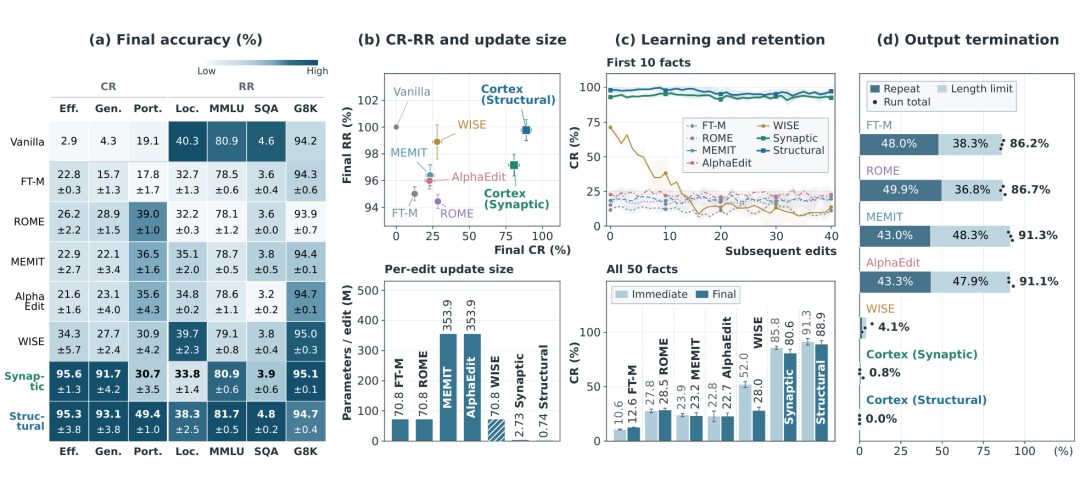
〓 图7. 50 次连续事实更新。依次展示最终各项准确率、CR–RR 与每次更新参数规模、先前事实的学习与保留,以及重复和达到长度上限等输出终止情况。学习与保留部分的上图跟踪最早 10 条事实,下图比较全部 50 条事实各自刚学完时与最终的平均 CR。阴影和误差线表示三次重复训练之间的差异。
小幅增量可以支撑连续积累。完成 50 次更新后,Structural 达到 88.9% CR、99.8% RR,Synaptic 为 80.6% CR、97.2% RR;按最终 CR 计算,最强对照 ROME 为 28.5%。
Structural 每轮新增并训练的参数仅约占原模型 [23] 的 0.005%,50 轮累计增加约 0.25%(图 7(b))。
最终优势同时来自“最初学得好”和“后来忘得少”。全部 50 条事实从各自刚学完到最终检查,Structural 的平均 CR 从 91.3% 降至 88.9%,下降 2.4 个百分点;WISE 从 52.0% 降至 28.0%(图 7(c) 下图)。
另看最早 10 条事实,在各自又经历 40 次更新后,Structural 仍保留 97.2% 的平均 CR(图 7(c) 上图)。单看曲线是否平稳还不够,也要确认最初确实学到了内容。
记住事实和灵活运用事实,仍有明显距离。两种 Cortex 的直接事实回答准确率都约为 95%,但把新事实用于组合问题时,Structural 达到 49.4%,Synaptic 为 30.7%(图 7(a) 的 Port. 列)。
Structural 在刚写入时就表现出更好的组合运用能力,后续损失也更小;两者仍有从“记住”走向“会用”的空间。
模型也更少陷入重复或一直生成到长度上限。在最终检查中,生成长度最多为 512 个 token;因重复或达到长度上限而终止的输出占 Structural 输出的 0%、Synaptic 的 0.8%,而 FT-M、ROME、MEMIT 和 AlphaEdit 为约 86%–91%(图 7(d))。
这说明在该测试中,经验沉淀伴随着更稳定的输出行为。
4.4 实验分析:效果来自哪些设计
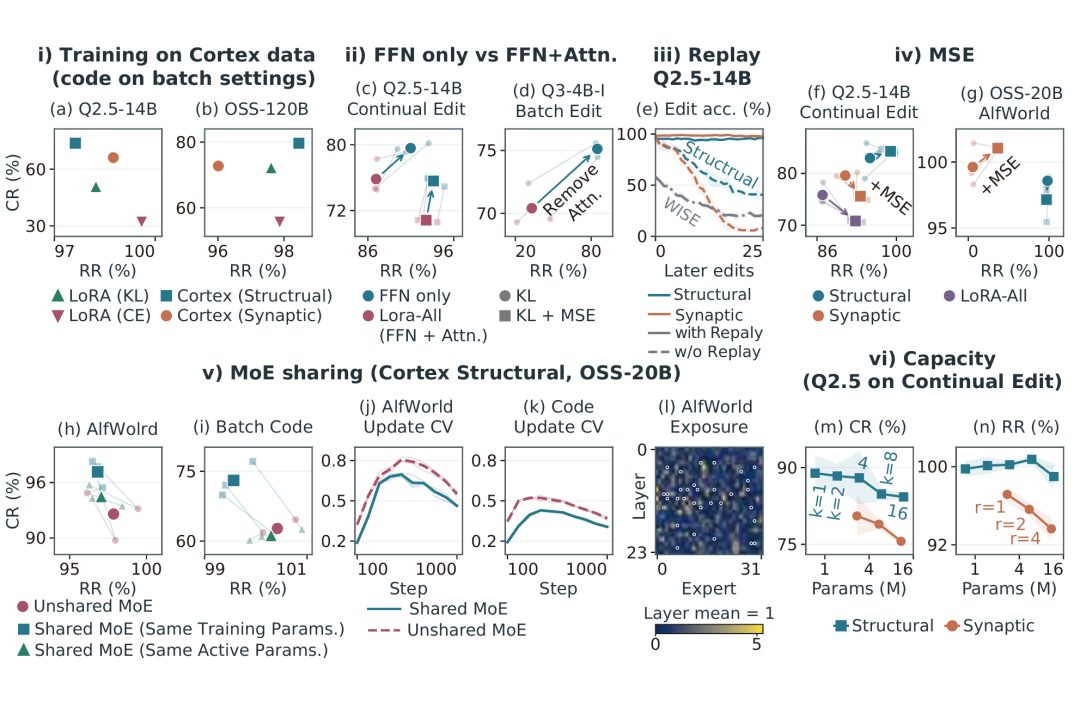
〓 图8. 消融与机制分析。上排比较同一批练习数据上的不同训练方式、FFN 与注意力的更新范围、历史回放和中间表示对齐;下排分析 MoE 共享扩展及不同容量。多数散点图横轴为 RR、纵轴为 CR,与图 6 的坐标轴顺序相反。
论文进一步用六组对照,检查这些效果分别来自哪些设计。
1. 同一批练习,也会因学法不同而得到不同结果。研究先让 LoRA 使用和 Cortex 相同的训练数据,固定“学什么”,再比较两种学习方式:模仿老师生成的答案,或进一步学习老师对不同输出的概率判断。
在 GPT-OSS-120B 的批量 API 学习中,后者的 CR 高出 16.6 个百分点。但即使同样学习教师的输出分布,在 Qwen2.5-14B 上,LoRA 的 CR 仍比 Cortex-Structural 低 23 个百分点(图 8(a、b))。
练习材料很重要,怎样教、把变化写到哪里,也影响最终效果。
2. 只更新 FFN,可以兼顾学习与保留。研究固定 LoRA 的秩(决定低秩更新容量的设置),比较“只更新 FFN”与“同时更新 FFN 和注意力模块”。
在连续事实更新的一组对照中,只更新 FFN 的 CR、RR 分别高出 3.8 和 4.0 个百分点,需要训练的参数反而更少(图 8(c、d))。这表明,让更多模块参与变化,并不一定更有利于学习和保留。
3. 冻结旧参数之后,仍然需要复习。两组模型都冻结此前的写入,也都学习当前经验并混入通用能力样本;区别在于,是否额外加入历史问题来复习旧经验。
对最早学到的 25 条事实,在它们各自又经历 25 次更新后,有复习时,两种 Cortex 对原问题和改写问题的平均准确率都超过 96%;没有复习时,Structural 降至 40.5%,Synaptic 降至 8.0%(图 8(e))。
冻结旧参数,仍挡不住新写入对旧行为的干扰。
复习也不必保存完整的旧问答。研究进一步比较“保存历史问题和答案”与“只保存问题,每轮重新生成答案”,两者最终 CR 相差不到 1 个百分点。这支持了 Cortex 只保留历史问题来组织复习的做法。
4. 对齐内部表示,有助于保留已有行为。在新增容量相同的条件下,研究比较“只对齐输出分布”与“同时对齐输出分布和中间表示”。
在一组 Synaptic 连续更新实验中,加入中间表示对齐后,RR 提高 2.7 个百分点,CR 降低 4.0 个百分点;在一组 Structural 实验中,两项指标同时改善(图 8(f、g))。
让学生的内部处理过程更接近老师,有助于保留已有行为,但也可能限制对新经验的适应。
5. MoE 共享扩展,让新增容量得到更充分的训练。对 GPT-OSS-20B,研究比较了两种安排:每个专家拥有各自的扩展分支,或所有专家共用一组扩展参数。
MoE 处理每个 token 时只会选中部分专家,因此,“一共新增了多少参数”与“每个 token 实际用到了多少新增参数”是两回事。实验以扩展权重的数量衡量新增容量,分别固定这两个量进行比较:
第一组:新增的可训练权重总数相同。 共享扩展在 ALFWorld 和 API 代码任务上的 CR 分别高出 4.6 和 10.3 个百分点,RR 约低 1 个百分点。
第二组:每个 token 实际用到的新增权重数目相同。 共享方案只需训练独立方案八分之一的扩展权重,CR 与独立方案相差不到 2 个百分点(图 8(h、i))。
训练记录给出了一个解释:共享分支处理每个 token,都能获得训练机会;独立分支只有在对应专家被选中时才参与计算。
共享分支各通道的更新更均匀,一些独立专家分支则几乎接触不到训练数据(图 8(j–l))。
6. 较小的新增容量,已经能支持连续积累。研究保持训练方式相同,逐步增加 Structural 的新通道数量,或提高 Synaptic 的低秩更新容量。
在这组连续学习实验中,两种方法都在各自测试的最小新增容量下取得最高平均 CR;Structural 每轮仅新增原模型参数量的约 0.005%,就达到 88.9% CR(图 8(m、n))。在这套训练方式下,增加容量没有稳定地带来更多收益。
讨论
5.1 什么样的经验值得沉淀
判断一段经验是否值得沉淀,关键是它能否帮助未来的判断和行动。
新知识可以帮助回答之前不会的问题,任务策略可以用于后续的相似情境,而纠正错误认识、更新过时信息,或学会不再使用某些内容,可以避免模型继续沿用旧做法。这些都是长期学习应当留下的收获。
一份任务日志中,也有很多只与当时有关的细节。经验沉淀需要从中提炼出可复用的内容。
例如,学会一个新 API 的输入要求、适用场景和常见报错处理方式,就能应对之后不同的调用需求;某次调用使用的临时文件名,则未必有这样的价值。因此,记录得多,并不直接等于学得多。
5.2 为什么是参数化记忆:让经验更直接地参与推理
可以把外部记忆想成一本随时能查的笔记。它的价值很直观:保存过去的经历,需要时再取出来。但依赖检索的记忆有一个关键限制:某段经验必须先被找到,才能参与当前推理。
检索通常根据眼前的问题寻找相关内容,而有些联系只有在思考过程中、与其他知识结合之后才会显现。凯库勒曾回忆,蛇咬住尾巴的形象启发了他对苯环结构的思考。
[21] “蛇”和“苯”在字面上相距很远,“首尾相接”却提供了一个结构上的联系。若只围绕“苯”寻找相似记录,就可能漏掉这个线索。
这里的困难是:有用的经验可能已经存下来了,但系统还没有意识到它与当前问题有关。如果这段经验没有进入这轮推理,就无法在其中与其他知识结合。
长期记忆需要解决的,既包括把经验保存下来,也包括让不同经验在新问题中共同发挥作用。
参数化记忆希望把经验学成模型自身的知识和技能,让它在理解问题、形成中间判断时就能参与计算。我们期待这种整合能促进新经验与已有知识的交互,让模型结合不同阶段的收获,应对新的问题和情境。
5.3 参数化记忆的三个理想化特点
理想的参数化记忆,需要回答三个具体问题:它分布在模型的哪些位置,能否继续容纳新经验,以及推理时怎样参与计算。
要让模型持续积累经验,并把不同阶段的收获结合起来使用,需要相应的记忆设计来支持。
分布式整合:让记忆覆盖模型的所有层。知识回路研究发现,一些事实知识的表达需要不同层的注意力头和 FFN 协作:信息沿着跨层连接逐步汇合,最后形成回答。
[24] 这为跨层写入提供了启发。理想的参数化记忆应在各层都有承载位置,让新经验参与模型逐层处理信息的过程,并与已有知识回路结合。
可增长容量:为持续学习留出空间。 随着知识和技能增加,模型可以在需要时扩展容量,为新的经验提供表达空间。Cortex-Structural 增加新的特征通道,就是沿着这一方向,让持续积累获得额外的容量支持。
原生访问:记忆组件直接参与模型计算。 推理时,记忆应作为模型自身的一部分,随标准网络一起运行,不需要先经过外部的检索、筛选或模块调用。
Cortex 的写入可以合入标准 FFN 或 MoE 层,沉淀的经验因此能够在模型正常的前向计算中发挥作用。
5.4 和相关工作的区别
MC 将过去分别研究的知识编辑、技能学习、行为引导和知识抑制,纳入了统一的经验巩固问题。
在这项工作中,这些任务都通过 Context 描述希望发生的变化,并用共同的要求检验结果:撤掉原始 Context 后,预期的行为变化能否保留,其他能力能否保住。
不同任务中的方法,由此可以围绕“学到了多少、保住了多少”这两个目标接受检验。
另一个区别在于,学习开始时,方法拿到的是什么:是由外部提供要练习的问题,还是由方法从经验中自行组织?
持续学习的常见设定:给定训练集或样本流。 外部提供模型要学习的数据,研究重点是怎样在数据持续到来时学会新内容,同时减少对旧内容的遗忘。[25]
经典上下文蒸馏(CD):给定上下文和任务输入分布。 在 Snell 等人的形式化中,开发者需要预先指定模型练习哪类输入,例如影评或某类推理题,再让带上下文的教师为这些输入提供学习信号。[2]
MC:给定模型,以及一个或若干 Context。 不额外提供事先定义好的任务输入分布;怎样把这些经验转化为学习材料,由具体方法解决。
例如,给模型一份新 API 文档,MC 要求方法从中组织学习:哪些使用场景值得练习、应该构造什么问题、什么样的回答体现了文档带来的帮助。
从 Context 构造训练数据,本身就是 MC 学习流程的一部分。Cortex 的 prospective rehearsal 正是在完成这一步。
MC 规定了期望的学习结果,没有预先指定训练算法。Cortex 则将上下文蒸馏、参数写入和历史复习结合起来,给出了一套具体实现。
在获得更新的方式上,SHINE [5] 等超网络方法先训练一个能够生成参数更新的网络,再用它处理新上下文;Cortex 则针对当前经验构造练习,利用教师提供的示范直接训练本轮新增参数。
推理时,WISE [9]、GRACE [22] 等方法需要额外判断当前输入该使用哪份记忆。Cortex 将历次写入累积到同一个模型中,每次推理都使用这份包含历史收获的模型,无需再选择某个历史模块。
例如,Agent 此前已经学过一种新工具的用法,也积累了一套排错策略。同一段对话中,用户可能先问工具怎么用,再要求排查故障,最后需要结合两者完成任务。
Cortex 保留了这些历史写入,使不同阶段学到的经验有机会在同一次推理中共同发挥作用,为跨任务使用和经验组合提供基础。

参考文献

[1] Jintian Zhang et al. Cortex: Consolidating Context into Parametric Memory (https://arxiv.org/abs/2610.20399v1). 2026.
[2] Charlie Snell, Dan Klein, Ruiqi Zhong. Learning by Distilling Context (https://arxiv.org/abs/2209.15189). 2022.
[3] Mor Geva et al. Transformer Feed-Forward Layers Are Key-Value Memories (https://aclanthology.org/2021.emnlp-main.446/). EMNLP, 2021.
[4] Edward J. Hu et al. LoRA: Low-Rank Adaptation of Large Language Models (https://arxiv.org/abs/2106.09685). ICLR, 2022.
[5] Yewei Liu et al. SHINE: A Scalable In-Context Hypernetwork for Mapping Context to LoRA in a Single Pass (https://arxiv.org/abs/2602.06358). 2026.
[6] Kevin Meng et al. Locating and Editing Factual Associations in GPT (https://proceedings.neurips.cc/paper_files/paper/2022/hash/6f1d43d5a82a37e89b0665b33bf3a182-Abstract-Conference.html). NeurIPS, 2022.
[7] Kevin Meng et al. Mass-Editing Memory in a Transformer (https://arxiv.org/abs/2210.07229). ICLR, 2023.
[8] Junfeng Fang et al. AlphaEdit: Null-Space Constrained Knowledge Editing for Language Models (https://arxiv.org/abs/2410.02355). ICLR, 2025.
[9] Peng Wang et al. WISE: Rethinking the Knowledge Memory for Lifelong Model Editing of Large Language Models (https://arxiv.org/abs/2405.14768). NeurIPS, 2024.
[10] Runnan Fang et al. Memp: Exploring Agent Procedural Memory (https://arxiv.org/abs/2508.06433). 2025.
[11] Sidi Lu et al. Locas: Your Models are Principled Initializers of Locally-Supported Parametric Memories (https://arxiv.org/abs/2602.05085). 2026.
[12] Jingdi Lei et al. δ-mem: Efficient Online Memory for Large Language Models (https://arxiv.org/abs/2605.12357). 2026.
[13] Tianzhu Ye et al. On-Policy Context Distillation for Language Models (https://arxiv.org/abs/2602.12275). 2026.
[14] Yu Wang et al. Self-Updatable Large Language Models by Integrating Context into Model Parameters (https://proceedings.iclr.cc/paper_files/paper/2025/hash/2b0c4fc1bd52329279c51ad2ddec9ace-Abstract-Conference.html). ICLR, 2025.
[15] Lucas Caccia et al. Training Plug-and-Play Knowledge Modules with Deep Context Distillation (https://openreview.net/forum?id=ghyyHZYORi). COLM, 2025.
[16] Rujikorn Charakorn et al. Doc-to-LoRA: Learning to Instantly Internalize Contexts (https://arxiv.org/abs/2602.15902). 2026.
[17] Zhuoran Jin et al. RWKU: Benchmarking Real-World Knowledge Unlearning for Large Language Models (https://arxiv.org/abs/2406.10890). NeurIPS, 2024.
[18] Nina Rimsky et al. Steering Llama 2 via Contrastive Activation Addition (https://aclanthology.org/2024.acl-long.828/). ACL, 2024.
[19] Zhengxuan Wu et al. Improved Representation Steering for Language Models (https://arxiv.org/abs/2505.20809). 2025.
[20] Ziwen Xu et al. Why Steering Works: Toward a Unified View of Language Model Parameter Dynamics (https://arxiv.org/abs/2602.02343). ACL, 2026.
[21] August Kekulé. 1890 年苯庆典演讲(德文转录)(https://www.sgipt.org/wisms/geswis/chem/kek1890.htm). 1890.
[22] Thomas Hartvigsen et al. Aging with GRACE: Lifelong Model Editing with Discrete Key-Value Adaptors (https://arxiv.org/abs/2211.11031). NeurIPS, 2023.
[23] Qwen Team. Qwen2.5-14B-Instruct 模型说明 (https://huggingface.co/Qwen/Qwen2.5-14B-Instruct). 2024.
[24] Yunzhi Yao et al. Knowledge Circuits in Pretrained Transformers (https://arxiv.org/abs/2405.17969). NeurIPS, 2024.
[25] Aristotelis Chrysakis, Marie-Francine Moens. Online Continual Learning from Imbalanced Data (https://proceedings.mlr.press/v119/chrysakis20a.html). ICML, 2020.
[26] Yi Duan et al. The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement (https://arxiv.org/abs/2609.11873). 2026.
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。