DDL 2.0 AIGC安全论坛在三大学术会议成功举办
组委会 2026-11-03 23:37 江苏
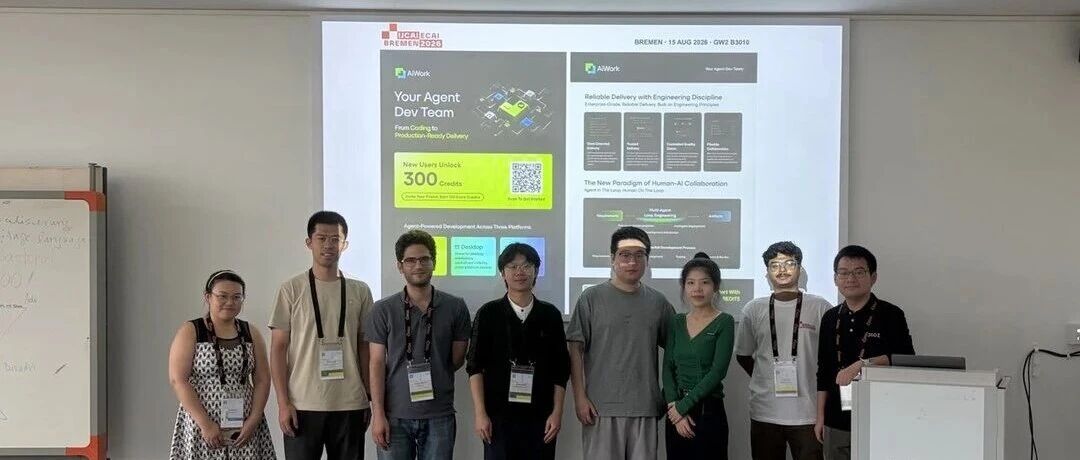
2026年,DDL 2.0先后在乌鲁木齐ChinaMFS、不来梅IJCAI-ECAI和西安CCBR举办,围绕模型与内容安全开展研讨、竞赛及成果交流。
一 以DDL提醒AI安全的紧迫性
DDL源于首届深度伪造检测、定位与可解释性研讨会(Deepfake Detection, Localization, and Interpretability)的名称,也借“deadline”的紧迫感,提醒我们在AI技术快速发展时及时关注安全问题。DDL 2.0进一步将议题拓展至模型安全与内容安全,通过论文、挑战赛和专家报告交流研究与应用。
二 组织团队
Workshop组织委员会
14位成员共同推进学术交流与赛事组织。
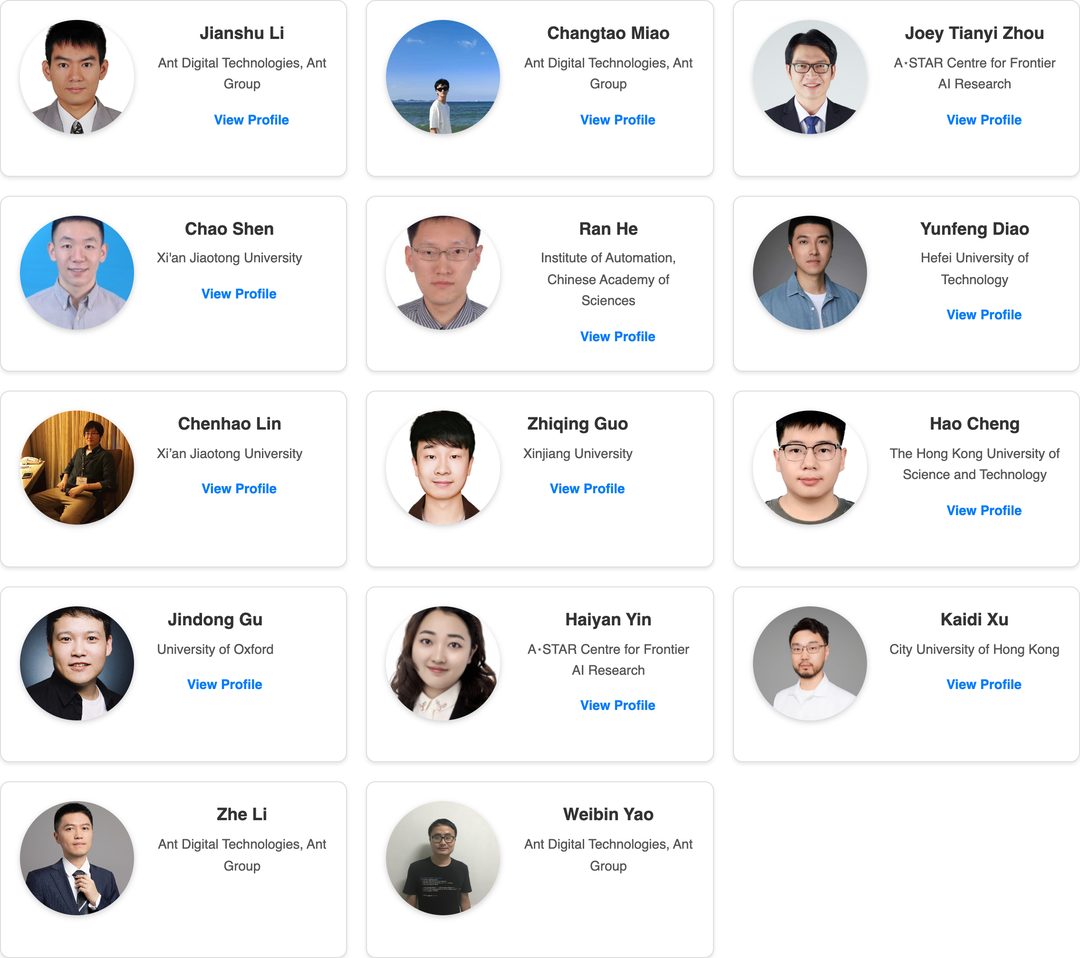
OpenClaw安全攻防挑战赛组织委员会
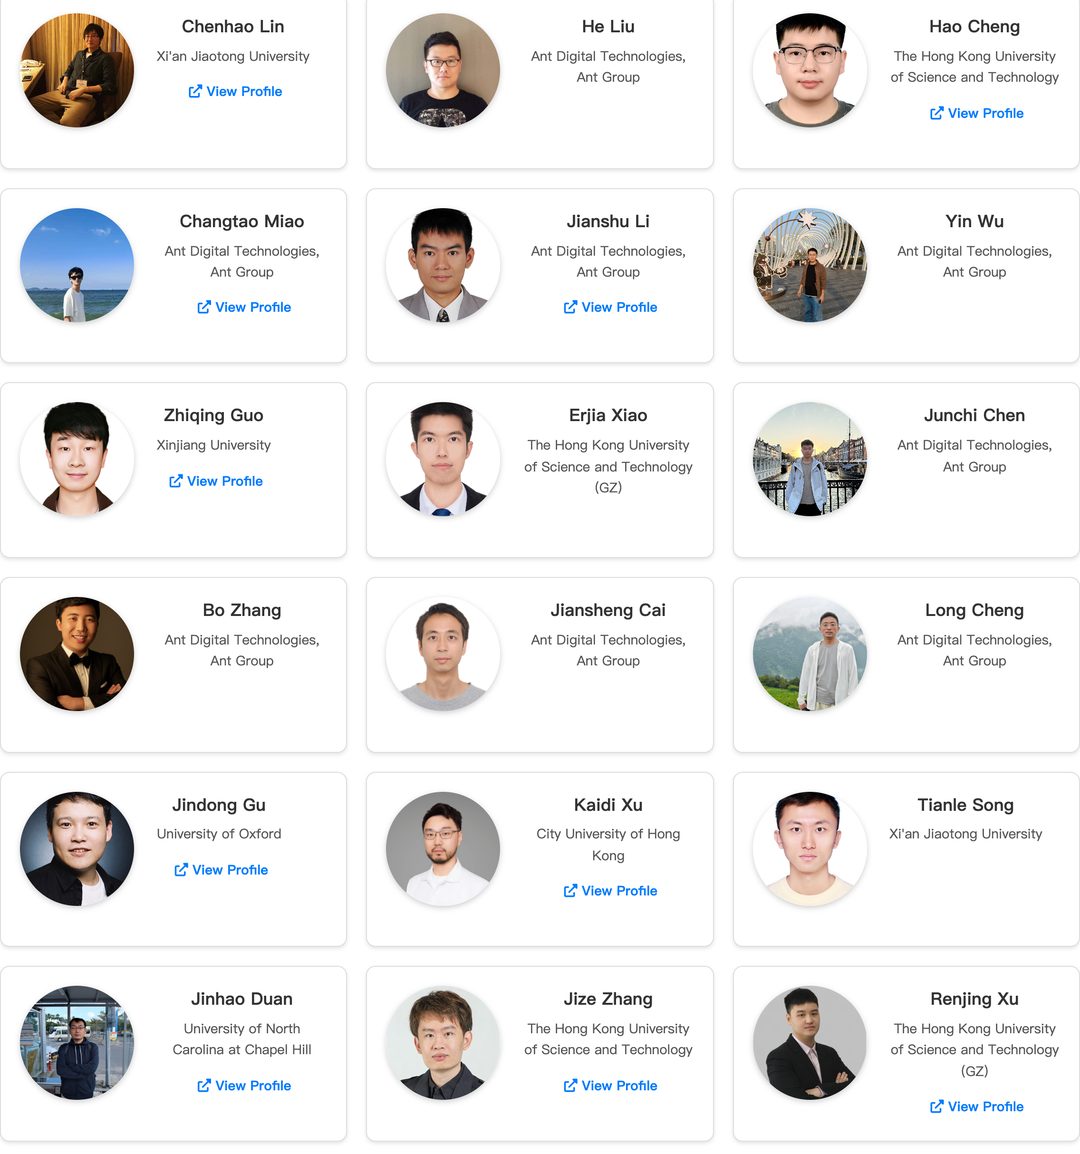
通用AIGC音视频检测挑战赛组织委员会
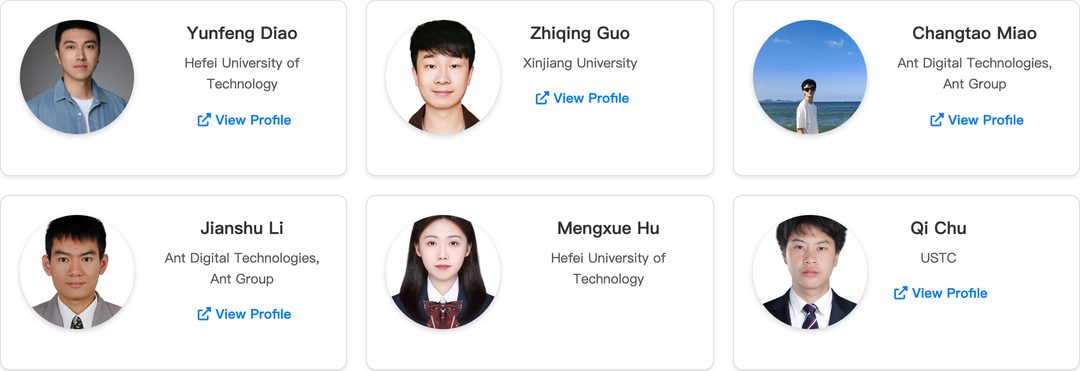
Deepfake检测定位与可解释性挑战赛组织委员会
三 三项挑战赛
OpenClaw安全攻防挑战赛
258支队伍参赛,产生1189次有效提交,考察智能体授权边界与工具使用安全。
| 名次 | 队伍 | 所属单位 | 得分 |
|---|---|---|---|
1 | AISEC | 西安交通大学 | 1.00 |
2 | PoliteInjection | 中国电信人工智能研究院(TeleAI) | 0.95 |
3 | 这题得烧不少Token | 武汉大学 | 0.84 |
4 | HCLab | 独立研究者 | 0.79 |
5 | Wo Duzi Shengji | 深圳技术大学 | 0.50 |
6 | wonder | 湖北工业大学 | 0.47 |
7 | 111 | 中国科学院信息工程研究所 | 0.42 |
8 | MoWan (魔丸) | 中国科学技术大学 | 0.39 |
9 | nick5419780528 | 百度 | 0.27 |
10 | 暗渡陈仓 (AnDuChenCang) | 独立研究者 | 0.26 |
10 | AAAtoken批发 | 网络空间部队信息工程大学 | 0.26 |
通用AIGC音视频检测挑战赛
101支队伍参赛,基于十万级样本、23类生成技术评测音视频真伪判断与模态组合识别。
| 名次 | 队伍 | 所属单位 | 得分 |
|---|---|---|---|
1 | HIT VIRLAB | 哈尔滨工业大学 | 0.8460 |
2 | ZJSU | 浙江工商大学 | 0.8438 |
3 | VeriLens | 香港科技大学(广州) | 0.8426 |
4 | AIGVDete | 浙江大学 | 0.8406 |
5 | MVADetection Team | 独立研究者 | 0.8349 |
Deepfake检测定位与可解释性挑战赛
113支队伍参赛,联合评测真假分类、伪造区域定位及文本解释。
| 名次 | 队伍 | 所属单位 | 得分 |
|---|---|---|---|
1 | HIT_VIRLAB | 哈尔滨工业大学 | 0.8940 |
2 | CBSR_what_the_dog_doing | 中国科学院大学 | 0.7025 |
3 | XQ999 | 独立研究者 | 0.5770 |
4 | ACVLAB | 阳明交通大学(ACVLab) | 0.3505 |
5 | newtester | 杭州电子科技大学 | 0.2522 |
6 | Institute of Image Processing and Pattern Recognition, Hebei University of Technology | 河北工业大学 | 0.1630 |
名次与成绩按官网列示,各赛道采用独立评测标准。
四 论文交流
Workshop收录31篇论文。《From Echo to Nexus: How Attacker Personality Dictates Success in Jailbreaking LLMs》获最佳论文奖,《LatentGuard: Safeguarding Autonomous Driving VLMs via Latent World Logic Repair》获最佳学生论文奖。
《SREM: Semantic-space Reconstruction Evidence Mining for Generalizable AI-Generated Image Detection》,《Hydra: Towards Massively Multi-Target Backdoor Attacks against VLMs》,《Forensic-Aware Continual Adaptation with Fisher-Guided LoRA Surgery for Image Forgery Localization》获最佳论文提名。
五 专家报告
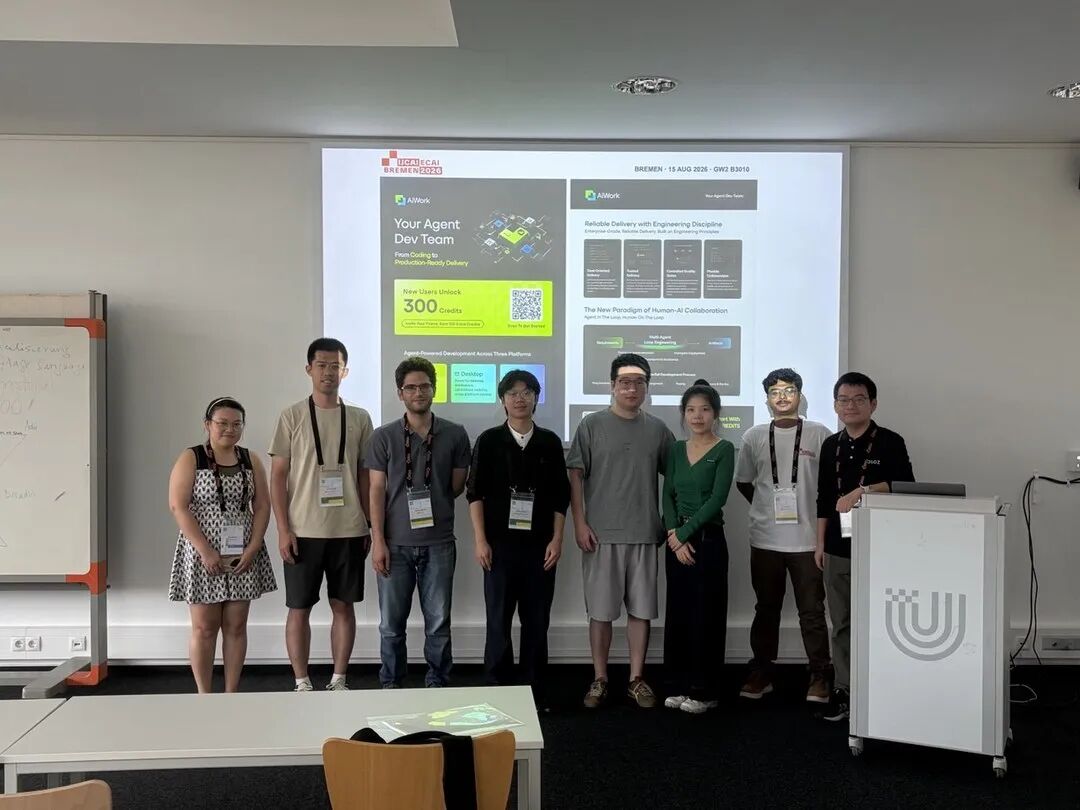
不来梅主论坛
牛津大学及Google DeepMind的Jindong Gu研究员作“Responsible Visual Generative AI”报告,介绍安全对齐、有害内容抑制与图像来源追踪。
中国海洋大学李岳尊教授作“Generalizable Face Forgery Detection: From Uni-modal to Multi-modal”报告,探讨从视觉单模态到多模态的人脸鉴伪。
香港城市大学Kaidi Xu教授作“From Uncertainty to Risk-Controlled Decisions: Split Conformal Prediction for Reliable AI”报告,分享共形预测支持风险可控决策的方法。
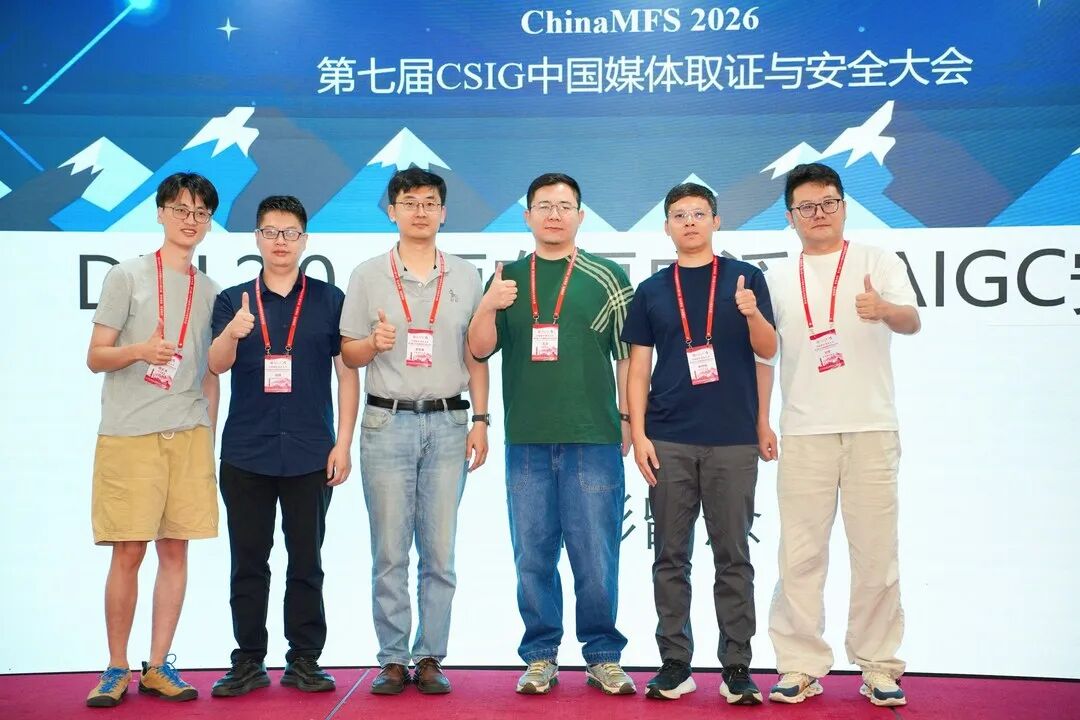
乌鲁木齐国内分论坛
大湾区大学余梓彤教授作“可泛化可解释Deepfake检测”报告,讨论检测泛化能力与可解释性的协同提升。
中国海洋大学李岳尊教授作“从单模态到跨模态的人脸鉴伪探索”报告,探索应对未知伪造方式的跨模态方法。
蚂蚁数科王洋研究员作“构建AI原生信任底座:身份、凭证与智能体的纵深防御体系实践”报告,分享身份核验、凭证验真与智能体防护实践。
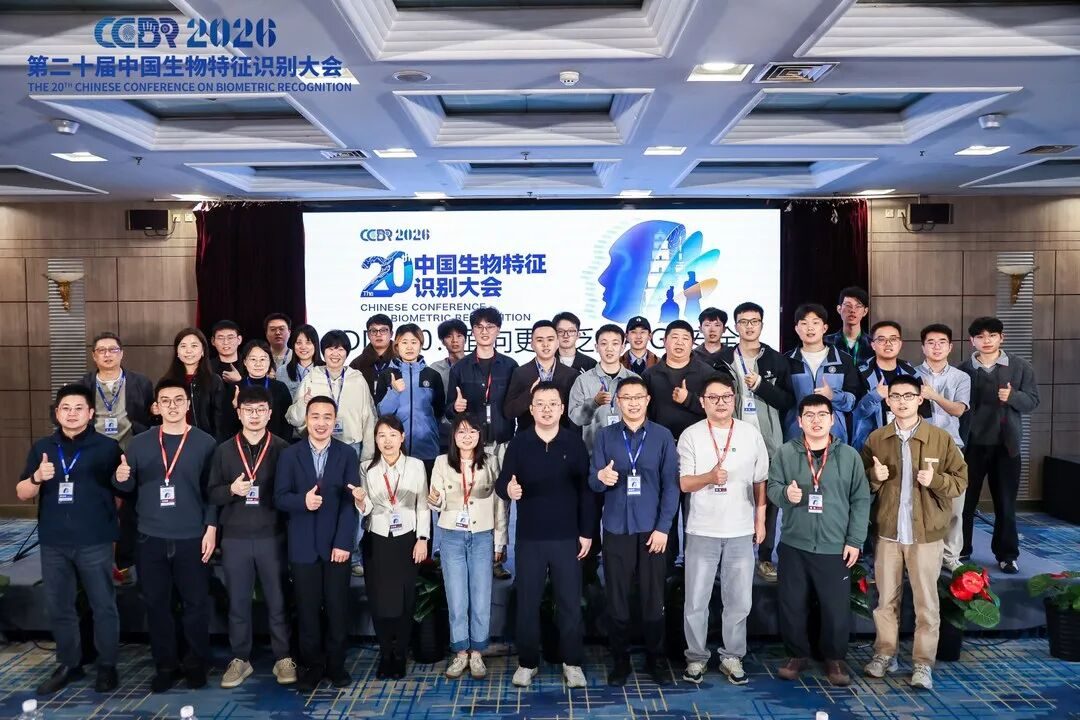
西安国内分论坛
暨南大学夏志华教授作“深度伪造检测、溯源及防御技术”报告,介绍深度伪造的技术路径与防御思路。
复旦大学陈静静教授作“视觉生成内容鉴别与溯源”报告,探讨开放环境中的真实性识别与来源追踪。
西安交通大学赵正宇教授作“AIGC用于对抗样本生成:可行与慎行”报告。
四川大学王宏霞教授作“面向复杂场景的人脸深度伪造检测”报告,分享跨域泛化、鲁棒检测与伪造区域定位研究。
上海交通大学刘笑宏教授作“多模态图像可控生成与编辑”报告,介绍多参考生成、局部编辑与反馈迭代方法。
蚂蚁数科刘贺研究员作“AI安全算法解决方案的演进与展望:蚂蚁数科企业化AI安全技术方案与商业实践”报告,分享输入理解、安全对齐及企业防护实践。
相关资料
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。