NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成
机器之心 2026-11-07 12:04 辽宁
研究社区探索可验证Agent学习的一个起点
在训练 Tool-Calling Agent 的过程中,我们反复遇到一个看似简单、却非常关键的问题:训练数据从哪里来?
Tool-Calling Agent 需要根据用户意图调用外部 API、整合中间结果,并最终给出答案。要通过 Reinforcement Learning 训练这样的 Agent,我们需要大量任务,每个任务都应当带有正确的中间 tool calls 和可以被验证的最终答案。即使是数据效率较高的 RL 方案,也往往需要数千个这样的任务;而目前主流的 agent benchmark,每个通常只提供几十到几百个任务。
一个自然的想法是让 LLM 来合成任务。但很快我们就会遇到下一个问题:一个由 LLM 想象出来的任务,它的 ground truth 真的正确吗?更进一步,如果这些任务依赖真实世界的 API,而 API 的返回结果随时可能变化,我们又该如何在训练中反复复现同一个环境?
我们逐渐意识到,问题的关键可能并不在于 “如何生成更好的任务”,而在于生成任务的顺序本身。
换句话说,我们认为:与其先出题、再寻找答案,不如先在真实 API 上探索,再根据已经观察到的结果反向出题。
在我们的 NeurIPS 2026 工作 Firefly: Illuminating Large-Scale Verified Tool-Call Data Generation from Real APIs 中,我们沿着这一思路,构建了一个从真实 MCP Server 生成可验证 tool-call 数据的 pipeline,并配套了一个可离线复现的 Retrieval-Augmented Tool-Call Simulator。基于这一 pipeline,我们得到了覆盖 240 个 server、993 个工具的 5,144 个可验证任务。我们希望,这项工作不仅能够提供一份可用的训练数据,也能为 “如何大规模构造可验证的 Agent 训练数据” 这一问题提供一个新的思路。
会场时间:Thu, Dec 10, 2026・10:00 AM EST in Hall C1・Atlanta Poster Session 3
01 | 规模、真实与可验证:现有训练数据的三重困境
目前,构造 Tool-Calling 训练数据的方式大致可以分为三类:人工标注、纯模拟环境下的合成,以及基于真实工具的前向合成。在实际工作中,我们发现这三类方法各有所长,但都很难同时做到规模化、真实性和可验证性。
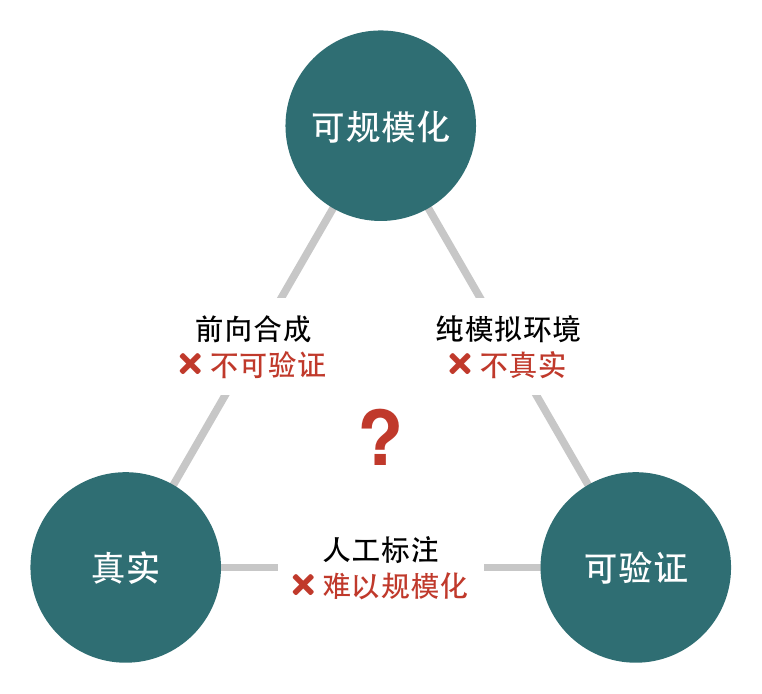
图 1:可规模化、真实、可验证,现有三类方法各缺一角。
1.1 | 人工标注:足够可靠,却难以规模化
人工标注能够保证用户意图的自然性和答案的正确性,Tau-Bench 系列、API-Bank 等工作都采用了这一方式。但人工标注成本高、领域依赖强,很难覆盖真实 API 的长尾。以 Tau2-Bench 为例,每个领域仅有 50 到 115 个任务;MCPMark 提供 127 个任务,MCP-Atlas 公开了 500 个任务。这些数量适合评估,却远不足以支撑 RL 训练。
人工构造可验证任务的价格也不低。根据 Epoch AI 对行业的访谈,AI 实验室购买一个 RL 任务通常要花 200 到 2,000 美元,独家授权的价格还要再高 4 到 5 倍。这样的价格和独家条款,使这类数据主要集中在少数大厂手中。
1.2 | 纯模拟环境:足够可扩展,却偏离真实 API
为了突破规模限制,一类工作让 LLM 同时扮演 “用户” 和 “工具”:工具的返回结果同样由 LLM 生成。这样的环境易于扩展,但 LLM 编造的工具输出往往与真实 API 的行为存在差异。真实世界中的字段格式、边界情况、报错方式乃至数据本身,都很难被准确模拟。在这样的环境中训练出的 Agent,学到的可能是 “如何与模拟器交互”,而不是 “如何与真实世界交互”。
1.3 | 前向合成:足够真实,却缺乏可验证的 ground truth
另一类工作使用真实工具,采用我们称之为 Forward Generation 的流程:先把所有工具的描述交给 LLM,由它写出一个需要调用这些工具的用户任务;再由另一个 solver 模型针对这个任务 rollout 出一条 tool-call 轨迹,solver 的最终答案就被当作该任务的 ground truth。考虑下面这个简单的例子:
Which domain was registered first, amazon.com or netflix.com, and how many years apart were they registered?
在 Forward Generation 中,这个问题是先被写出来的,出题的 LLM 并不知道工具实际会返回什么。由此带来两种失败。第一,任务本身可能无法完成:它要求的最终状态在真实工具上根本不可达。第二,solver 可能做错,比如查错了域名或者算错了年份差,而它的答案会被原样当作 ground truth。换句话说,这类任务的 ground truth 没有任何机制保证它是对的。
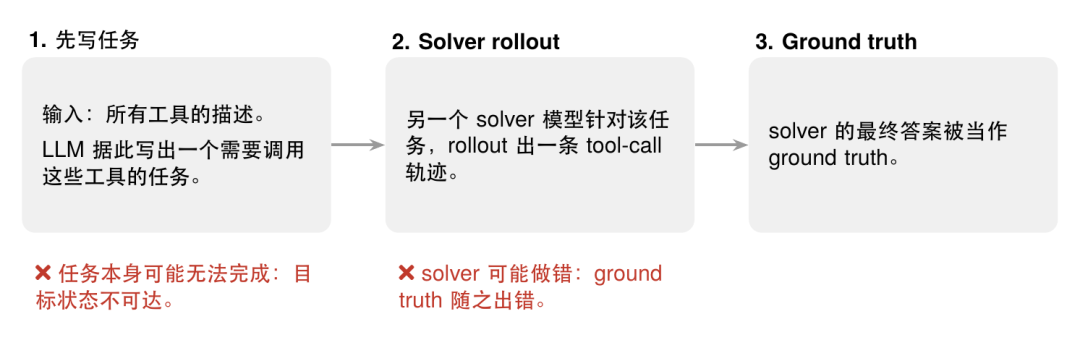
图 2:Forward Generation 的流程,以及它的两种失败方式。
1.4 | Environment Drift:即使有了可验证的任务,也难以训练
更进一步,即便我们已经拥有了基于真实工具、并且可以验证的任务,直接在 live API 上做 RL 训练仍然非常困难。许多 MCP 工具依赖搜索索引、天气、金融数据、DNS 记录等外部数据源,它们的输出会随时间变化;server 可能下线;RL rollout 中的大量重复调用也可能触发 rate limit。结果是,同一个任务在今天和下周可能得到不同的工具返回,训练和评估都难以复现。
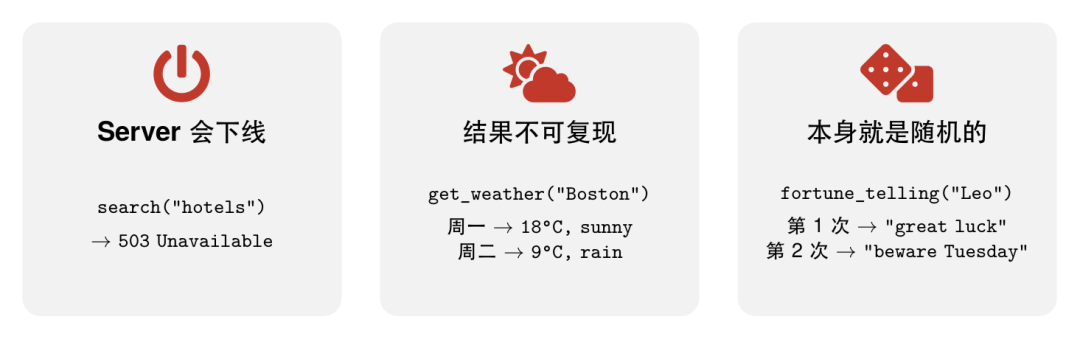
图 3:直接在 live server 上做 RL 的三个问题。
因此,构造可规模化、真实、可验证的训练任务,并配套一个在 RL 过程中保持可复现的环境,仍然是一个开放问题。这使我们开始思考:是否存在一种方式,让 ground truth 的正确性不再依赖事后过滤,而是在数据生成的那一刻就被保证?
02 | 反转合成流程:让 ground truth 的正确性成为一种构造性质
我们的核心观察是:Forward Generation 之所以难以保证 ground truth 正确,很大程度上是因为 “出题” 发生在 “观察” 之前。如果把顺序颠倒过来,问题可能会变得简单得多。
2.1 | Back-Chaining:先探索,再出题
回到上面的域名例子。在 Firefly 中,这个任务并不是先被写出来的。恰恰相反,一个强 LLM 首先在真实的 MCP Server 上进行探索,它调用了 networkcalc-mcp 中的 whois 查询工具,分别查询了 amazon.com 和 netflix.com,并实际观察到了它们的注册年份:1994 和 1997。只有在这之后,LLM 才围绕这两次调用的输出,反向写出了上面的问题,并把 ground truth 整理为结构化字段:
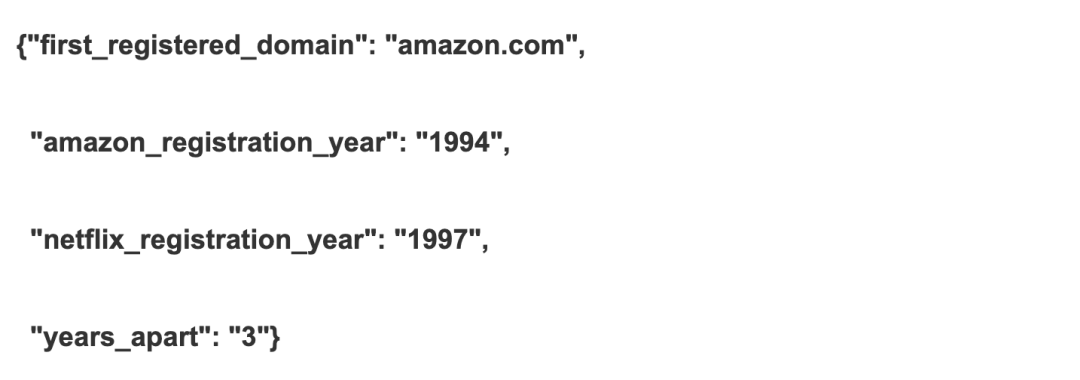
我们将这一过程称为 Back-Chaining。由于每一个 ground truth 都来自真实工具实际返回过的状态,它的正确性不再依赖事后的筛选或人工核查,而是由数据的生成方式本身所保证。
换句话说,ground truth 的正确性从 “需要过滤才能获得的结果”,变成了 “数据生成过程的构造性质”。
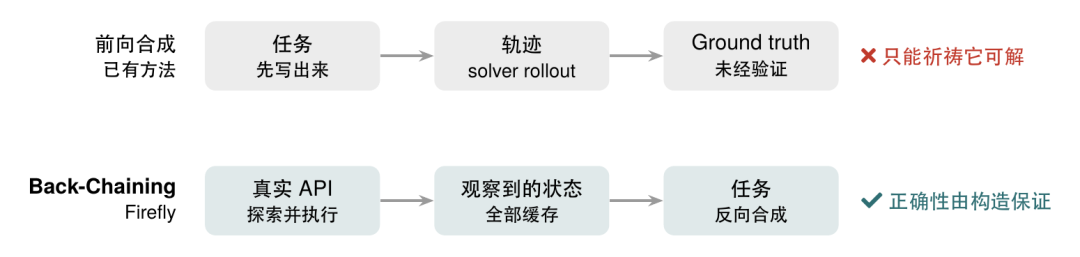
图 4:把 “先出题、后求解” 反转为 “先探索、后出题”。
2.2 | 从小工具空间到真实 MCP 生态
需要说明的是,“从轨迹反推任务” 这一思想并非由我们首次提出。同期工作 Trajectory2Task 在较小或固定的工具空间中应用了类似的想法,在那里,可能的工具链可以被枚举或人工约束。因此,真正的开放问题在于:Back-Chaining 能否在真实世界 MCP 生态的规模下工作?
这并不是一个简单的工程问题。当工具数量增长到近千个、分布在数百个异构 server 上时,至少会出现两个小工具空间中不存在的挑战:
第一,探索的可扩展性。工具组合的数量随工具数量迅速增长,漫无目的的探索会把大部分调用浪费在语义上毫无关联的工具组合上。
第二,训练环境的可复现性。Back-Chaining 保证了 ground truth 在生成时是正确的,但如果训练时 API 的返回已经发生变化,这个 ground truth 就可能不再与环境一致。
当然,Back-Chaining 并不意味着人工标注不再有价值。人工标注的 benchmark 在任务自然性和评估可信度上仍然不可替代,实际上,我们也正是在这些 benchmark 上检验 Firefly 的迁移效果。我们希望解决的,是训练数据在规模上的缺口。
03 | Firefly:从真实 MCP Server 到可离线复现的 RL 训练
在设计 Firefly 时,我们希望同时回答三个问题:
如何从开放的 MCP 生态中,筛选出适合构造可验证数据的工具?
如何在近千个工具中高效探索,得到语义连贯的多工具轨迹?
如何让训练和评估摆脱对 live API 的依赖,同时保持工具返回的真实性?
围绕这三个问题,Firefly 由三个阶段组成:MCP Server Collection、Task Synthesis 和 Reinforcement Learning。
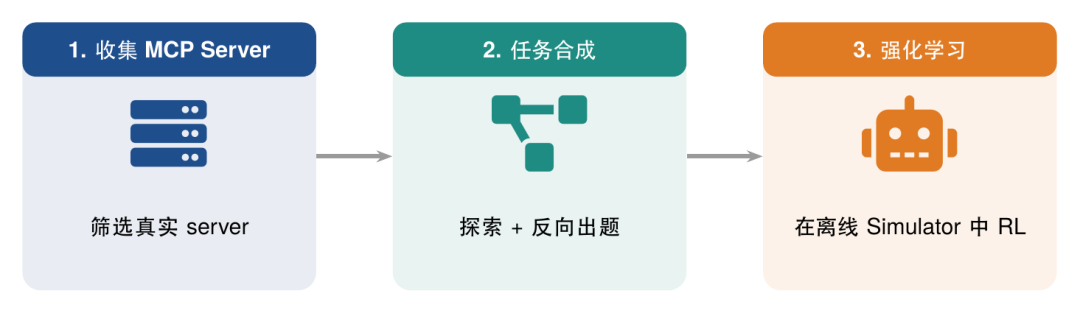
图 5:Firefly 整体框架。
3.1 | Server Collection:从 3,000 个 server 到 240 个
我们从 Smithery registry 中收集 MCP Server,综合使用广泛的列表查询、前缀枚举和领域关键词搜索。去重后,我们得到约 3,000 个 server,其中约 900 个至少暴露了一个工具。
但并不是所有 server 都适合用于构造可验证的数据。我们使用 LLM 依据四个标准进行筛选:Statelessness(没有跨调用的会话状态)、No User Authentication(不需要 OAuth 或用户自己的凭证)、Schema Clarity(参数类型与描述清晰)以及 Non-Triviality(不是 echo 或纯诊断类工具)。只有同时满足四项的 server 才会被保留。最终,我们得到 240 个 server,共 993 个工具。
3.2 | Tool Graph:为探索提供一个弱语义先验
面对近千个工具,一个直观的方案是根据 schema 的类型匹配来判断哪些工具可以串联。但类型匹配过于粗糙:两个 string 字段在类型上兼容,语义上却可能毫无关系。
因此,我们在所有工具上构建了一个有向的 Tool Graph。每个节点是一个工具,每条边表示源工具的输出可以被转换为或直接用作目标工具的输入。我们让 LLM 根据工具描述和 schema 逐对判断这种兼容性,并为每条边标注 high、medium 或 low 的置信度。最终的图包含约 83K 条有向边,平均每个工具有 88 个后继,其中约 64K 条为 medium 及以上置信度,并且同时包含 server 内和跨 server 的边。
我们认为,Tool Graph 的作用并不是规定 “应该生成什么任务”,而是提供一个弱语义先验:它让最终任务保持开放,同时把探索引向更可能产生有意义、可组合轨迹的邻域。
3.3 | DAG Exploration:在真实 server 上生长工具调用图
每次探索从一个至少具有两个 high-confidence 后继的工具开始。随后,一个强 LLM 在 live server 上交互式地构建一个 tool-call DAG:每一轮,它从已完成节点在图中的后继里获得一个随机子集,并可以选择并行调用多个工具(fan-out)、串联一个后继(sequential),或者将多个先前节点的输出合并到一次调用中(fan-in)。这一过程持续到 tool-call budget 耗尽或没有可用后继为止。
DAG 中的每个节点都记录了工具名称、输入参数和实际输出。由于它们都来自对 live server 的真实执行,所有状态都保证是可达的。这些 DAG 既是后续任务合成的原材料,也是之后 Simulator 的索引来源。
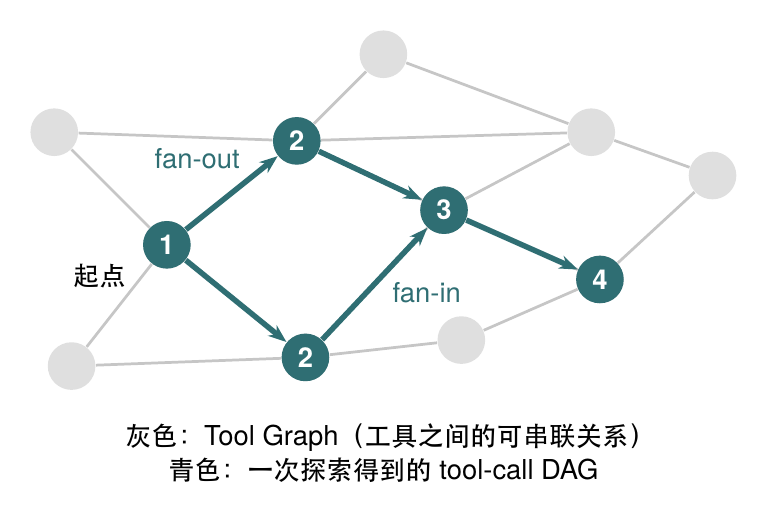
图 6:在 Tool Graph 上的一次探索,fan-out 与 fan-in 都在真实 server 上执行。
3.4 | Back-Chaining Task Synthesis 与 Task Validation
对于每一个 DAG,LLM 选择其中一部分节点,围绕它们构造自然语言任务。任务描述中包含填写 tool-call 参数所需的信息,ground truth 则直接从所选节点的输出中提取;其余节点自然成为干扰项或无关的探索路径。通过选择不同的节点子集并变化表述,同一个 DAG 可以产生多个复杂度不同的任务。
每个任务还配有一个结构化的 Answer Schema(带命名占位符的 JSON 模板)和对应的自然语言 Answer Template。这样,评估可以通过字段级比较自动完成,而不必依赖自由文本匹配。
为了保证任务质量,我们使用 LLM Judge 从五个维度对每个 task-trajectory pair 进行验证:Verifiability(答案可以客观检查)、Well-Specifiedness(有且仅有一个正确答案)、Interpretability(输出是人类可读的,而不是不透明的 ID)、Realism(真实性评分不低于 5/10)以及 Difficulty Calibration(标注难度与轨迹复杂度一致)。任何一项不通过的任务都会被移除,这一阶段大约过滤掉一半候选任务。
3.5 | Retrieval-Augmented Tool-Call Simulator:让 RL 摆脱 live API
为了解决 Environment Drift,我们缓存了探索阶段观察到的每一次 tool call,包括工具名称、输入参数和返回结果,并基于这些缓存构建了一个 Retrieval-Augmented Tool-Call Simulator,在训练和评估中完全替代 live server。当 Agent 发出一个 tool call 时,Simulator 按三层策略处理:
Exact Match:对输入参数做哈希查找,命中则直接返回缓存的真实输出。
Fuzzy Match with LLM Generation:检索输入最相似的 top-k 历史调用(优先当前任务的 ground-truth 轨迹),再由 LLM 以这些真实输出为条件,选择或生成一个响应。
No Data:如果该工具没有任何历史调用,则返回错误。
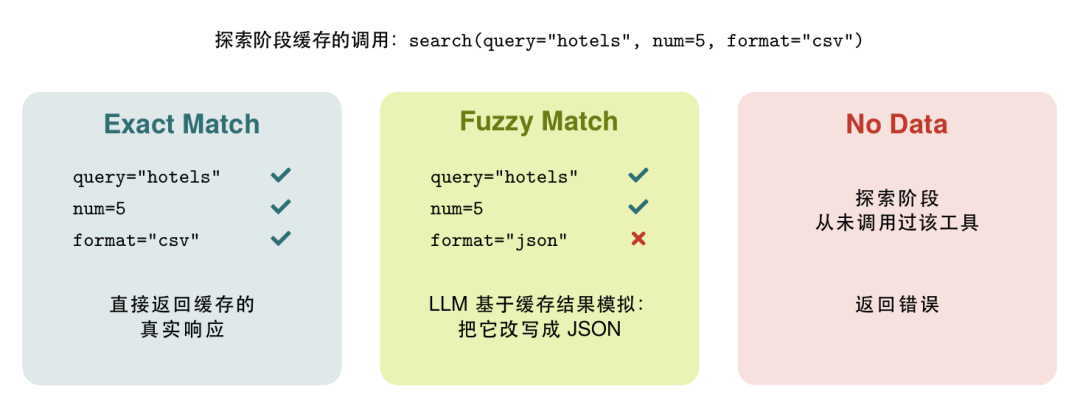
图 7:Simulator 的三层策略。Fuzzy Match 主要处理参数基本一致、只有格式等细节不同的调用。
第三层的设计是有意保守的。因为每个任务都是从一条已知轨迹反向合成的,远离缓存轨迹的调用很可能并不是正确解法所必需的,因此也不应该被奖励。
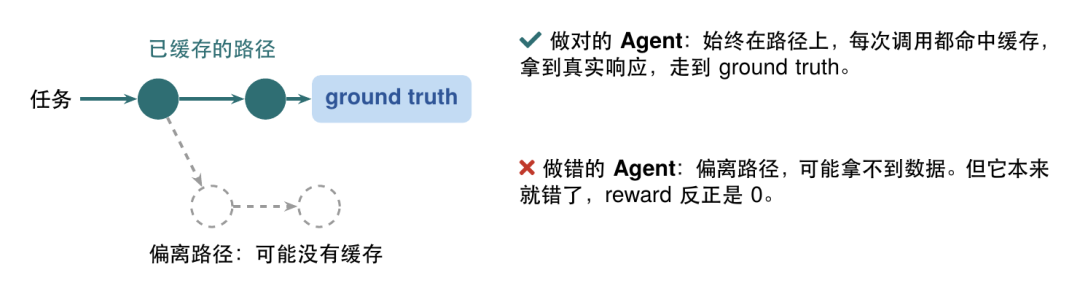
图 8:核心假设是通往 ground truth 的路径都已被缓存。做对的 Agent 不会缺数据;做错的 Agent 缺不缺数据都不影响 reward。
与纯模拟环境不同,这个 Simulator 的每一个响应都根植于真实的 API 输出。它带来两个重要性质:其一是 Reproducibility,同一个任务无论何时重跑,都会得到完全一致的工具返回;其二是 Verifiability,推导每个 ground truth 所需的响应都已被索引,始终可以通过 Exact Match 获得。
在 RL 训练中,Agent 始终与 Simulator 交互。奖励是二值的:首先尝试与 Answer Schema 做字段级精确匹配,失败时再由 LLM Judge 判断语义是否等价。由于同一个 Simulator 也作为评估环境,训练和评估使用的是完全相同的工具行为,并且可以在没有 API 成本和可用性顾虑的情况下进行大规模 rollout。
04 | Firefly 数据集:可验证、多步、基于真实 API
对于一个数据生成框架而言,仅仅描述方法是不够的。我们将完整 pipeline 应用于真实 MCP 生态,构建了 Firefly 数据集,并将它与 Simulator 一起开放,作为可直接用于离线 RL 训练和评估的资源。
从 Smithery registry 上约 3,000 个 server 出发,经过筛选保留 240 个 server、993 个工具。工具链探索产生了 9,749 条 DAG 轨迹,Back-Chaining 从中合成出 9,275 个候选任务,最终 5,144 个任务通过全部质量标准。我们保留 200 个任务作为固定测试集,其余 4,944 个用于训练。每个任务都配有 ground-truth 轨迹、Answer Schema,以及离线回放所需的全部 tool-call 响应。
4.1 | 任务特性
任务覆盖三个难度:easy(19.5%)、medium(77.0%)和 hard(3.5%)。Ground-truth 轨迹平均需要 3.0 次 tool call(范围 1 到 10),Answer Schema 平均包含 4.6 个字段,这意味着大多数任务需要整合多方面信息,而不是单值查询。
值得注意的是,约 38.5% 的任务需要跨多个 server 组合工具。大多数已有 benchmark 将任务限制在单一 API 提供方内,而跨 server 组合恰恰是真实 MCP 生态中的常见场景。仅测试集就覆盖了 98 个不同的 server 和 221 个不同的工具。LLM Judge 给出的平均真实性评分为 7.8/10。
4.2 | Simulator 覆盖率
一个自然的担心是:RL 过程中 Agent 可能会发出大量探索阶段未曾见过的调用,从而频繁落入 No Data 层。在完整的训练过程中,42.2% 的 Agent tool call 通过 Exact Match 解决,57.8% 通过 Fuzzy Match 解决,落入 No Data 层的比例为 0%。这表明探索阶段为离线训练提供了足够的覆盖。
4.3 | 生成成本
整个数据集使用 Claude Sonnet 4.5 通过 AWS Bedrock batch inference 生成,共消耗约 23.5B tokens(输入 21.4B,输出 2.0B),总成本约 $47K。这是一次性的投入:生成的数据集和 Simulator 可以被反复使用,支持后续不再产生 API 费用的离线 RL 训练。
4.4 | 与已有数据集的对比
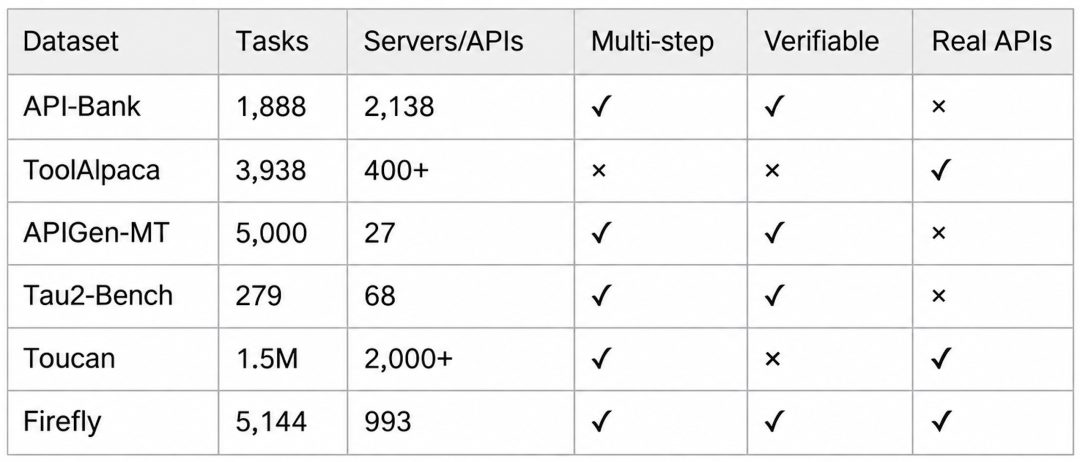
在我们比较的数据集中,Firefly 同时提供多步轨迹、可验证的 ground truth,并且基于真实而非模拟的 API server。当然,我们也注意到,不同数据集的设计目标各不相同,例如 Toucan 在规模上远超 Firefly。我们希望 Firefly 补充的是 “可验证” 与 “真实” 之间长期存在的缺口。
05 | 实验结果:小模型、大提升与跨分布迁移
为了验证 Firefly 的有效性,我们以 Qwen3-4B-Thinking-2507 为起点,在 4,944 个训练任务上使用 GRPO 与 Dynamic Filtering 进行 RL 训练。每个 prompt 采样 8 条 rollout;当模型在某个 prompt 上 8 条全对时,该 prompt 会被永久移出训练集,而全错的 prompt 则会被保留。这种类似 curriculum 的机制,使训练逐步聚焦于模型仍觉得困难的任务。训练共 300 步,基于 Slime 框架,使用 16 张 GPU 运行 actor、另 16 张 GPU 运行异步 rollout engine。
5.1 | Firefly Test Set:4B 模型与 Claude Sonnet 4.6 相当
在 200 个 held-out 任务上,Firefly RL 将 Qwen3-4B 的 pass@1 从 28.1% 提升到 41.5%(+13.4 points),与同一评估协议下的 Claude Sonnet 4.6(42.2%)基本相当。在 pass@8 上,微调后的模型达到 52.8%,超过 Claude Sonnet 4.6(50.3%),并接近 Claude Opus 4.7(54.4%);在 pass@16 上,它达到 57.0%,与 Claude Opus 4.7 持平(Claude Sonnet 4.6 为 53.0%)。
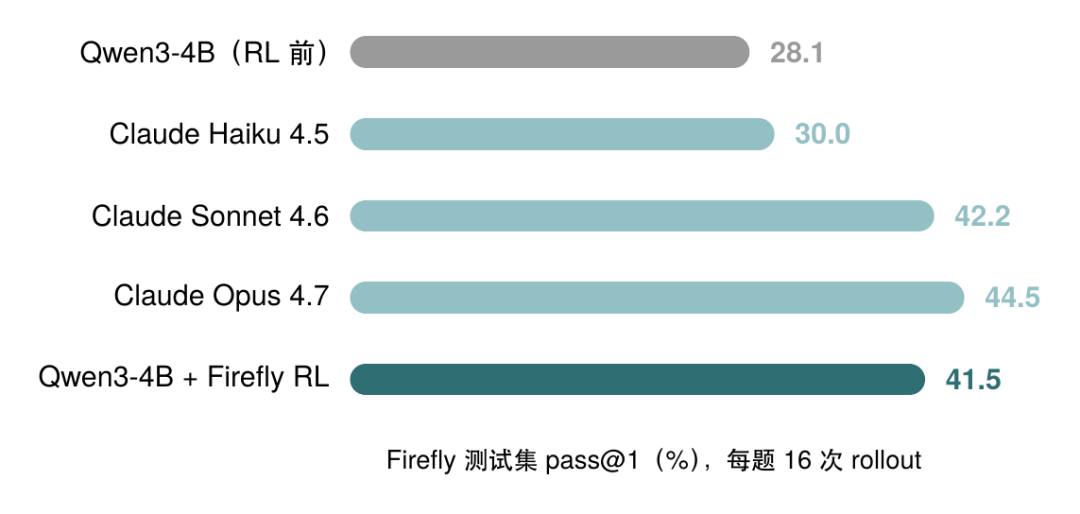
图 9:Firefly 测试集上的 pass@1,同一评估协议。
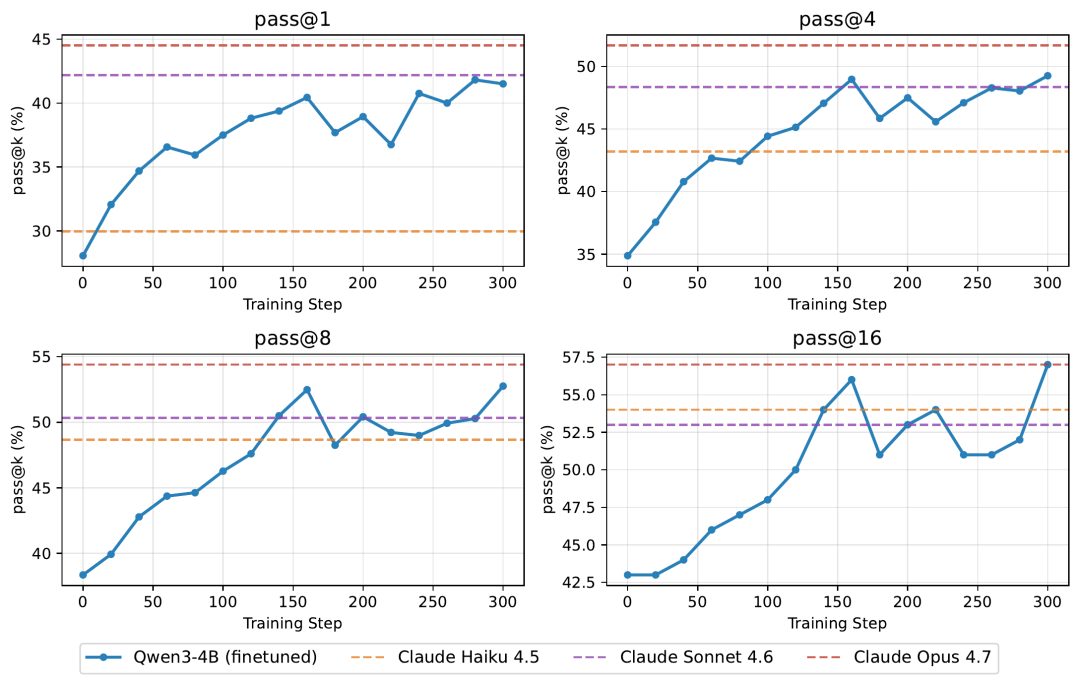
图 10:训练过程中 Firefly 测试集上的 pass@k 曲线,虚线为三档 Claude 模型。
如训练曲线所示,模型在各个 k 值上都呈现出稳定的提升。与此同时,我们也注意到 pass@16(57.0%)与 pass@1(41.5%)之间的差距并不大,这提示部分更难的任务可能超出了 4B 模型的能力范围,即使给予多次尝试也难以解决。
5.2 | 公开 Benchmark:不只是记住了缓存轨迹
在自己的测试集上取得提升是一回事,能否迁移到分布不同的公开 benchmark 是另一回事。Firefly 是一个单轮、多步的数据集:每个任务只有一条用户消息,但需要 Agent 规划并执行多次 tool call。而我们评估的公开 benchmark 在工具来源和环境设计上都与 Firefly 有显著差异,其中 Tau2-Bench 还要求多轮的用户与 Agent 交互。
实验结果表明,Firefly RL 在所有评估的公开 benchmark 上都带来了提升:
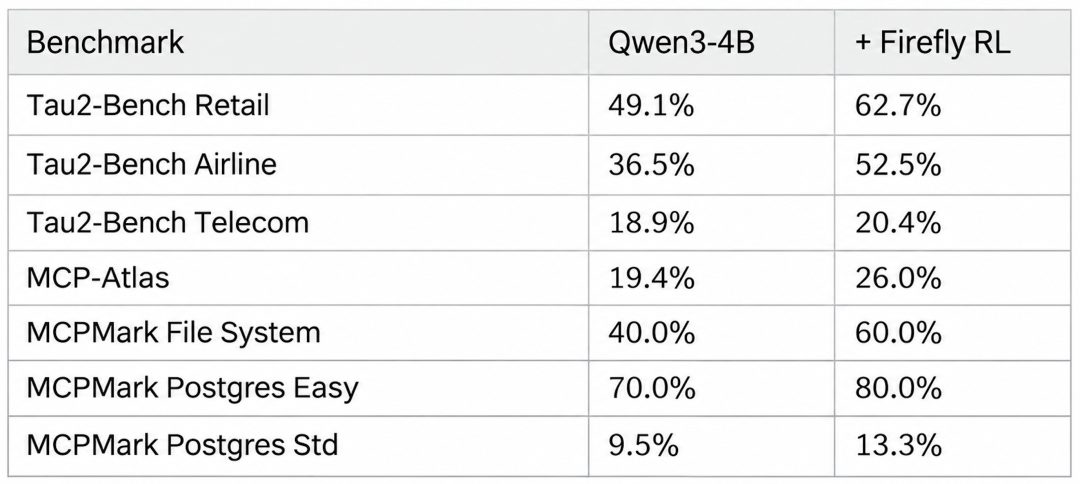
提升幅度因任务而异,例如 Tau2-Bench Telecom 上的提升相对有限。但一致的正向变化提示我们,模型并不只是记住了 Firefly 中的缓存轨迹。我们认为,在可验证的单轮多步任务上训练,可能提升了一些可迁移的 tool-use 行为:选择相关工具、根据观察结果填写参数、串联中间输出,以及从结构化的工具响应中推导最终答案。
其中最让我们感兴趣的是 Tau2-Bench 上的提升。尽管 Firefly 只包含单轮任务,而 Tau2-Bench 需要跨多个用户轮次的交互,但后者的许多核心难点,例如工具选择、状态追踪、API grounding 和多步推理,仍然与 Firefly 所训练的能力高度相关。这提示我们,单轮多步的监督信号,或许也能在一定程度上惠及多轮场景。
06 | 从可验证数据到可验证的 Agent 学习
到这里,我们已经介绍了 Firefly 的核心思路、pipeline 和实验结果。但对我们而言,这项工作更有意思的部分,可能并不局限于目前的数字。我们真正关心的是:当 ground truth 的正确性可以由数据生成方式来保证时,Agent 的训练还能向哪些方向延伸?下面是三个我们尤其感兴趣的方向。
6.1 | 从单轮到多轮:让 Back-Chaining 覆盖真实对话
目前,Firefly 中的所有任务都采用单轮格式:用户发出一个请求,Agent 通过多步 tool call 完成它。但在真实场景中,用户往往会补充说明、修改需求,或者在之前结果的基础上继续提问。
一个值得探索的问题是:Back-Chaining 能否自然地扩展到多轮对话?例如,我们是否可以将一个 DAG 切分为多个阶段,让每个阶段对应一轮用户请求,同时保证每一轮的答案仍然可以被验证?又如何在合成过程中引入澄清、修正等更接近真实用户行为的交互模式?我们认为,这是 Firefly 最自然的下一步。
6.2 | 从 4B 到更大的模型:可验证监督的上限在哪里?
受计算资源限制,我们目前只训练和评估了 4B 模型。前文提到,pass@1 与 pass@16 之间的差距并不大,这提示 4B 模型可能已经接近其在更难多步任务上的能力边界。
我们推测,更大的模型(例如 30B 及以上)可能从 Firefly 的可验证监督中获益更多,同时提升 pass@1 的上限和 pass@16 的覆盖范围。但需要强调的是,这一点目前仍是假设,需要后续实验验证。从更长远的角度看,我们也很想知道:随着模型规模增长,可验证数据的规模和难度分布应该如何同步调整?当前数据中 hard 任务仅占 3.5%,这对更强的模型是否足够?
6.3 | Verified by Construction:一种更通用的数据范式?
我们认为,这可能是 Firefly 最值得继续思考的方向。Firefly 的核心并不是某一个具体模块,而是一个更一般的想法:先在真实环境中产生可观察的结果,再围绕这些结果构造任务,并把环境本身缓存下来。这样,数据的正确性和环境的可复现性就不再是两个独立的问题。
但要把这一想法推广到更广泛的场景,还有不少开放问题。例如,为了保证可验证性,我们在筛选阶段排除了有状态和需要用户认证的 server,而真实世界中有大量重要的工具恰恰属于这两类,如何在有状态环境中实现 Back-Chaining 和可复现的回放?又如,Simulator 的 Fuzzy Match 层依赖 LLM 生成响应,这些响应在多大程度上忠实于真实 API 的行为?再如,除了 tool calling,这种 “先观察、后出题” 的思路是否也适用于 Web Agent、Code Agent 等其他 Agent 场景?
因此,我们并不认为 Firefly 已经解决了 Agent 训练数据的可验证性问题。相反,我们希望它能够成为进一步研究这些问题的一个切入点。
07 | 结语:先点亮,再出题
随着 Tool-Calling Agent 从研究原型逐渐走向真实应用,如何为它们构造大规模、真实且可验证的训练数据,正在成为一个越来越重要的问题。在这项工作中,我们尝试从一个相对基础的问题出发:生成训练任务时,“出题” 和 “观察” 应该以什么顺序发生?
我们认为,人工标注可靠却难以规模化;纯模拟环境可扩展却偏离真实;前向合成真实却缺乏可验证的 ground truth。而将顺序反转过来,先在真实 API 上探索,再从观察到的结果反向合成任务,可能是在三者之间建立平衡的一种自然方式。基于这一思考,我们提出了 Firefly:用 Tool Graph 将 Back-Chaining 扩展到近千个真实工具,用 Retrieval-Augmented Tool-Call Simulator 让 RL 训练与评估完全离线且可复现。
随着 Agent 在真实环境中承担越来越多的任务,训练数据的研究重点也有机会从 “生成更多数据” 转向 “生成可以被信任的数据”。我们希望 Firefly 不仅仅是一份数据集,也能够成为研究社区探索可验证 Agent 学习的一个起点。为此,我们开放了数据集、Simulator 和训练代码,希望能够为后续研究提供便利,也期待有更多研究者共同探索这一方向。
第一作者介绍
卢雨轩,美国东北大学(Northeastern University)博士生,导师为 Dakuo Wang 教授。研究方向为 LLM Agent、HCI/UX 系统与人类行为模拟,关注 Tool-Calling Agent 的训练数据与 RL 基础设施,在 NeurIPS、ACL、ICLR、EMNLP 等国际会议发表多篇论文。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com
本文转载自微信公众号「机器之心」,查看原文。版权归原作者所有,如有侵权请联系删除。