TPAMI 2026|西南财大&电子科大等提出MIIB:打破多视角冗余假设,多模态自监督解耦新范式
原创 CV君 2026-11-09 00:00 江苏
破解跨模态协同瓶颈
在当前的多模态自监督学习中,以 CLIP 为代表的对比学习方法占据着主流地位。这类方法通常建立在多视角冗余假设(Multi-view Redundancy Assumption)之上,即预设各模态之间具备高度对等的语义,下游任务所需的关键信息主要存在于模态间的共享语义中。然而在医疗诊断、情感计算及图文跨模态分析等真实场景下,不同模态往往展现出极大的异质性与信息不对称性:各个模态不仅拥有独特的私有特征,更存在大量仅在模态联合出现时才能涌现的“协同特征”。
针对这一痛点,西南财经大学、复旦大学、电子科技大学、中国科学院深圳先进技术研究院、四川大学与国防科技大学等多家机构联合提出了一种理论扎实且计算可行的多模态自监督表示学习框架——多模态信息交互瓶颈(Multimodal Information Interactions Bottleneck,简称 MIIB)。该论文已被计算机视觉与模式识别领域顶级期刊 IEEE TPAMI 录用。
论文命名解读:MIIB 的命名根植于信息论中的部分信息分解(Partial Information Decomposition, PID)与信息瓶颈(Information Bottleneck, IB)。所谓“信息交互(Information Interactions)”,指系统将跨模态互信息严格分解为冗余(Redundancy)、独有(Uniqueness)与协同(Synergy)三组正交组成;而“瓶颈(Bottleneck)”则指模型在单模态编码与跨模态融合两个层级同时施加“极小充分表示”约束,在最大化保留下游任务相关信息的同时,过滤掉与任务无关的冗余噪声。
背景与动机:多视角冗余假设的局限与协同信息的缺失
在自监督多模态表示学习中,通常包含两个核心步骤:单模态特征提取(Modality-Specific Representation Learning)与多模态融合(Modality Fusion)。这两个阶段并非割裂存在,而是呈现出前向级联与反馈约束的交织状态。
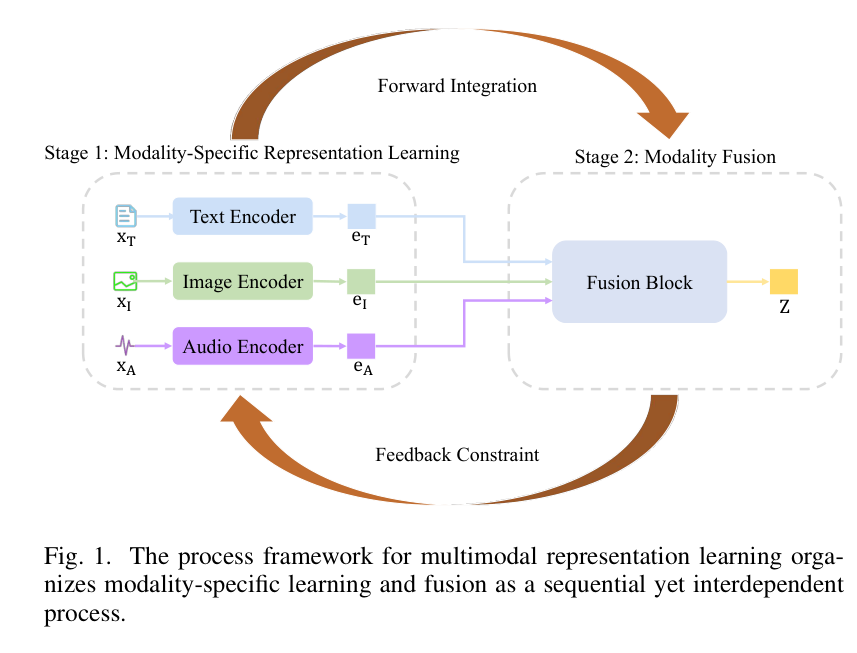
如上图所示,单模态特征提取决定了融合模块的输入表征纯度,而融合阶段的对齐与交互效果又会倒逼单模态编码器进行梯度更新。当任意一个模态的信息捕获出现偏差时,误差便会在这种双向依赖中级联放大:
多视角冗余假设的局限:传统对比学习(如 InfoNCE 目标)强行让文本、图像等表征在特征空间中靠近,容易让模型过度拟合于模态间的浅层重叠信号,进而压缩甚至丢弃各模态专属的独有特征(Uniqueness)。
跨模态协同(Synergy)建模困难:许多复杂语义(例如反讽、幽默或医疗时序综合表征)仅依靠单一模态无法推断,必须依赖跨模态的深层协同交互。FactorCL 等前沿工作虽尝试解耦共享与独有特征,但未能有效建模协同特征;后续的 CoMM 虽引入协同概念,但在分离与捕获机制上仍存在结构性瓶颈。
连续确定性网络下的互信息发散:若直接在神经网络中套用经典信息瓶颈,由于确定性编码器的连续映射会导致条件微分熵发散为负无穷,常规互信息估计器极易失真或带来巨大的计算开销。
为了从根本上化解上述矛盾,MIIB 提出了“双流架构解耦”与“可微超球面熵/对齐代理目标”,构建了端到端的自监督优化闭环。
MIIB 技术详解:双流 Transformer 与确定性信息瓶颈代理
1. 系统架构与数据流走向
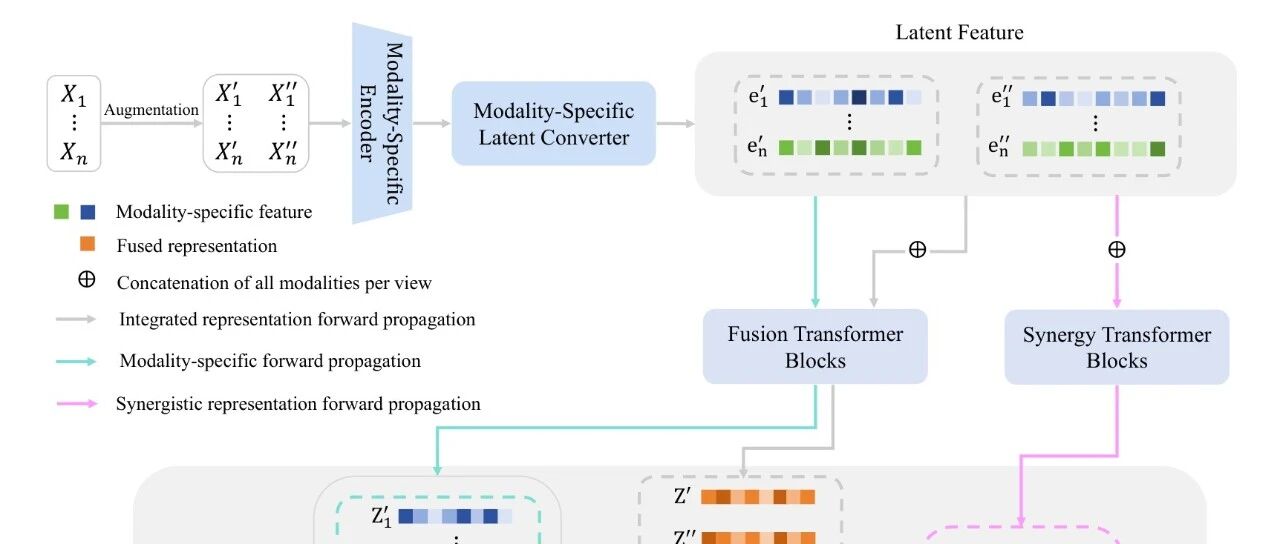
MIIB 采用双视角增强与双流 Transformer 的解耦处理管线,整体架构如下图所示:
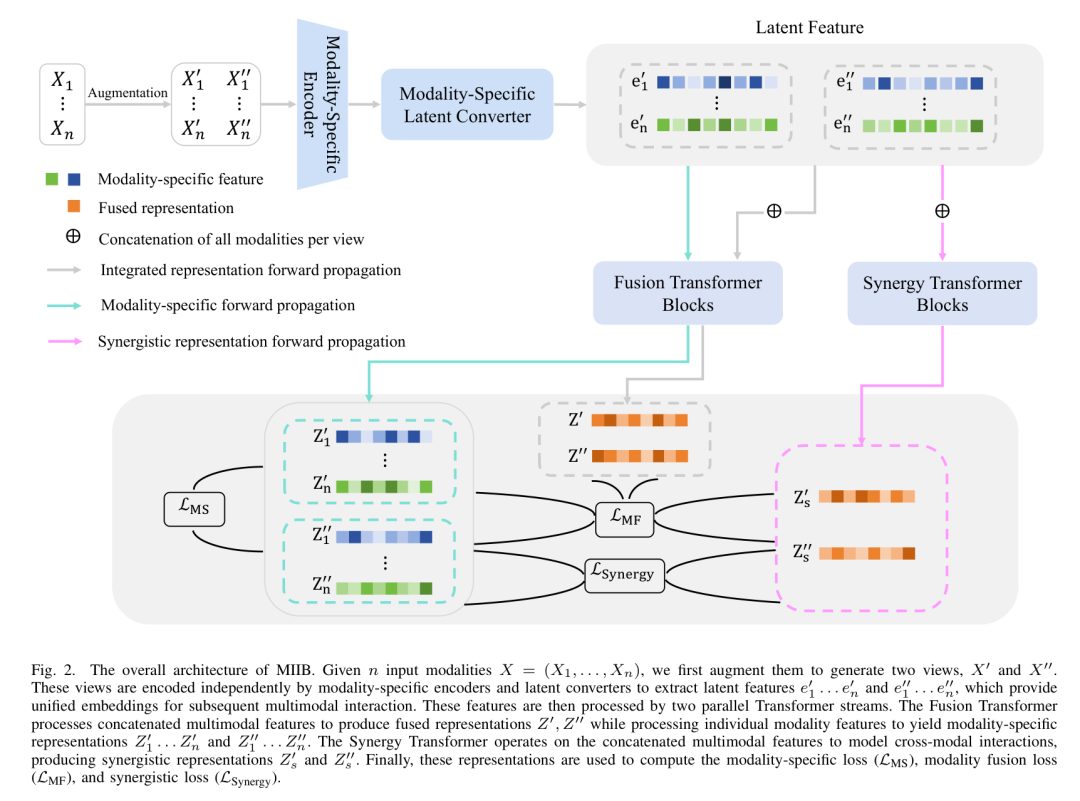
输入阶段(Input):给定 个模态的数据 ,经两组多模态数据增强采样 生成双视角 和 。
单模态编码:两视角数据分别送入相互独立的单模态编码器 ,提取潜变量特征 与 。
双流 Transformer 前向传播:
融合流(Fusion Transformer,):接收拼接的多模态特征,生成两视角的全局融合表征 与 ;同时单独输入单模态特征,映射出单模态表征 与 。
协同流(Synergy Transformer,):专门接收所有模态拼接特征,显式提取跨模态协同表征 与 。
输出阶段(Output):各流输出的嵌入向量共同计算模态特异性损失 、模态融合损失 与协同损失 ,用于自监督端到端更新。
2. 信息交互分解与损失函数设计
在信息论框架下,两个模态 对下游目标 的总互信息可分解为:
其中 为冗余信息, 为协同信息, 为各自的独有信息。
针对这三类信息,MIIB 在理论层面上构建了三组信息瓶颈目标:
模态特异性约束():迫使单模态特征 仅包含该模态输入中与对侧视角重合的有效信息(),并惩罚条件互信息 以压缩模态内多余噪声。
多模态融合约束():通过跨视角全局对齐()、跨视角单模态对齐()以及跨视角协同对齐(),引导融合表征捕获完整的 集合。
- 协同表征约束():协同流旨在仅保留多模态联合时产生的互补特征 。为防止协同表征退化或退回到单模态捷径,MIIB 引入了基于余弦相似度的铰链解耦损失(Cosine Disentanglement Loss):该式通过边缘超参数 约束单模态向量与对侧协同向量之间的夹角,推动几何正交解耦。
3. 面向确定性网络的代理目标转化
为解决连续确定性网络中互信息发散的理论困境,MIIB 借鉴确定性信息瓶颈(Deterministic Information Bottleneck, DIB)思想,将互信息项拆解为边缘熵与条件熵。由于条件分布在确定性映射下退化,丢弃发散常数项后,最小化条件互信息即等价于最小化边缘条件熵,进而转化为跨视角表征的内积对齐;同时,最大化边缘互信息转化为最大化单位超球面上的边缘熵。
借助基于 von Mises-Fisher(vMF)核的评分熵估计(Score-Based Entropy Estimation),MIIB 将原本难以直接求解的信息瓶颈目标转化为形式优雅的超球面正则化代理目标:
从流形正则化视角审视,这一损失具有非常明确的物理意义:
超球面边缘熵最大化(前三项):保证各模态特异表征、全局融合表征与协同表征在单位超球面上均匀分布(Uniformity),最大化保留各流信息容量并防止表征坍缩;
跨视角表征内积对齐(中间三项):实现表征之间的充分性约束与条件熵最小化(Alignment),将跨模态共享信息与协同互补信息深度沉淀到统一空间;
余弦解耦铰链损失(最后一项):迫使协同特征流与单模态特征流在几何空间上趋向正交,杜绝协同流退化为单模态特征。
这一设计彻底规避了连续确定性网络中互信息发散与高维互信息估计的高方差问题,转变为平滑、数值稳定的端到端训练算法。
实验结果与多维度分析
1. 合成基准 Trifeature:R、U、S 解耦验证
在基于 Trifeature 构建的受控双模态实验中,研究团队分别设定了冗余任务(识别共享形状)、独有任务(识别专属纹理)与协同任务(判断跨模态颜色-纹理映射规则是否成立)。
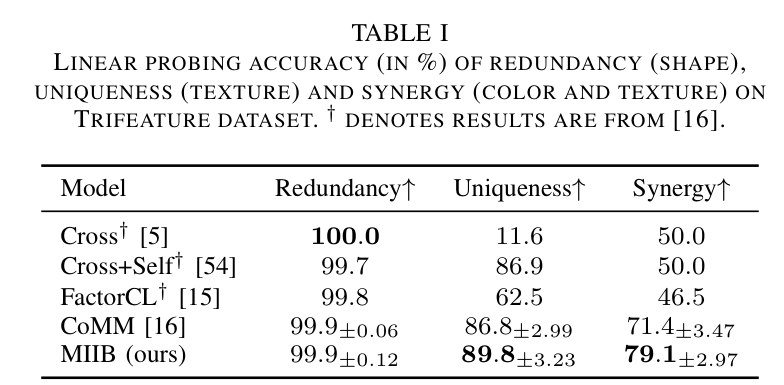
如上表所示,传统的对比学习方法 Cross 在协同任务上的准确率仅为 50.0%(与随机猜测持平),表明其完全无法捕捉协同关联;而 MIIB 在保持冗余准确率(99.9%)的前提下,独有信息准确率提升至 89.8%(超越 CoMM 3.0 个百分点),协同信息准确率显著提升至 79.1%(相比 CoMM 的 71.4% 大幅提升 7.7 个百分点),展现了对三类信息交互的解耦能力。
2. MultiBench 与三模态扩展基准
在涵盖医疗(MIMIC)、情感分析(MOSI、UR-FUNNY、MUSTARD)以及机器人触觉感知(Vision & Touch)的真实基准 MultiBench 上,MIIB 在自监督线性探测和全微调两种协议下均展现出稳定优势。
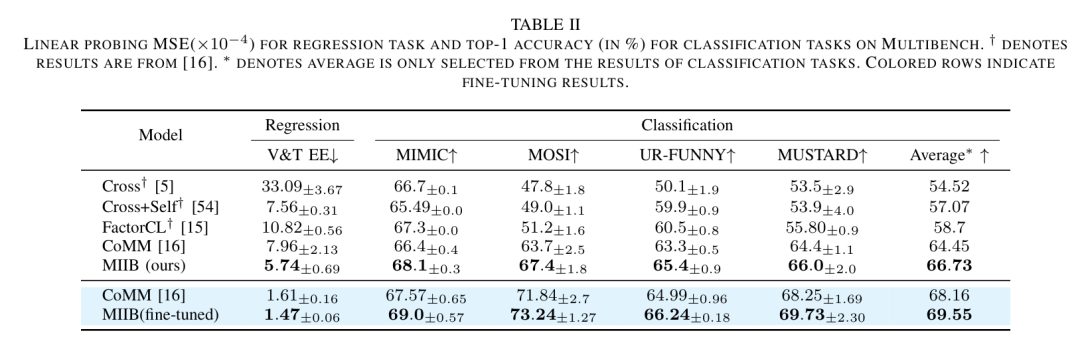
线性探测(Linear Probing):MIIB 分类平均准确率达到 66.73%,全面优于 CoMM(64.45%)、FactorCL(58.70%)与 Cross(54.52%)。其中在 MOSI 和 UR-FUNNY 上分别取得了 3.7% 和 2.1% 的明显增益;在触觉末端执行器姿态回归任务(V&T EE)中,均方误差降至 ,同样显著优于现有对比基线(CoMM 为 )。
监督微调(Fine-tuning):在全参数微调阶段,MIIB 的分类平均值进一步刷新至 69.55%。
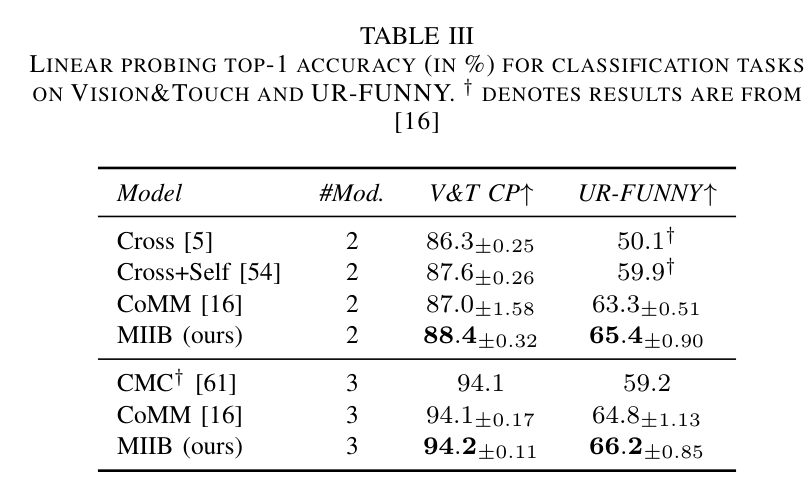
当扩展至三模态场景时,MIIB 依然能够稳步吸收新增模态带来的增益:在 Vision & Touch 接触预测任务(V&T CP)上,准确率由双模态的 88.4% 跃升至 94.2%;在 UR-FUNNY 三模态幽默预测上达到 66.2%,均优于多模态对比基线 CMC 与 CoMM。
3. 多标签多模态影片分类与少样本泛化
在规模更大、存在长尾分布与显著图文语义鸿沟的 MM-IMDb 数据集上,MIIB 与 CoMM 均采用相同的预训练 CLIP 骨干进行评测。
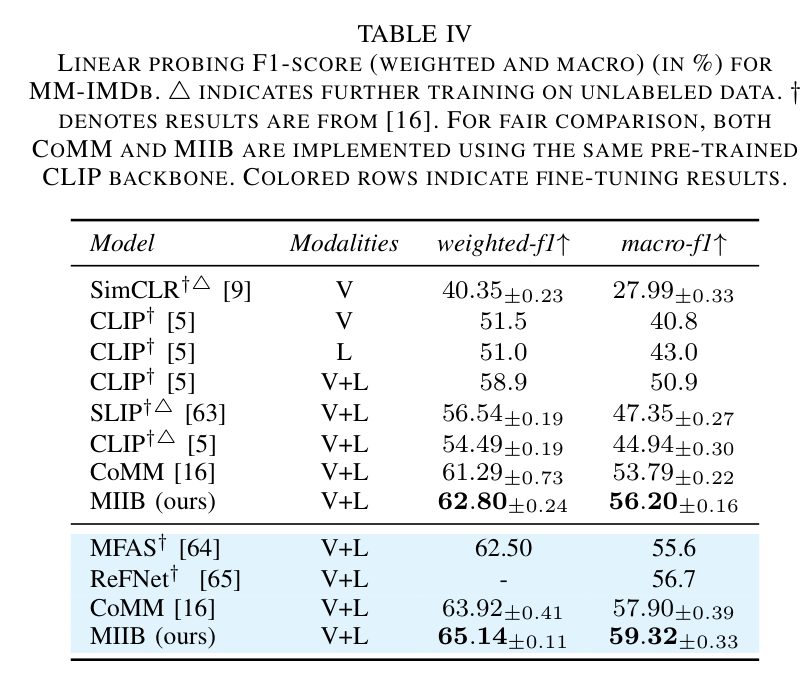
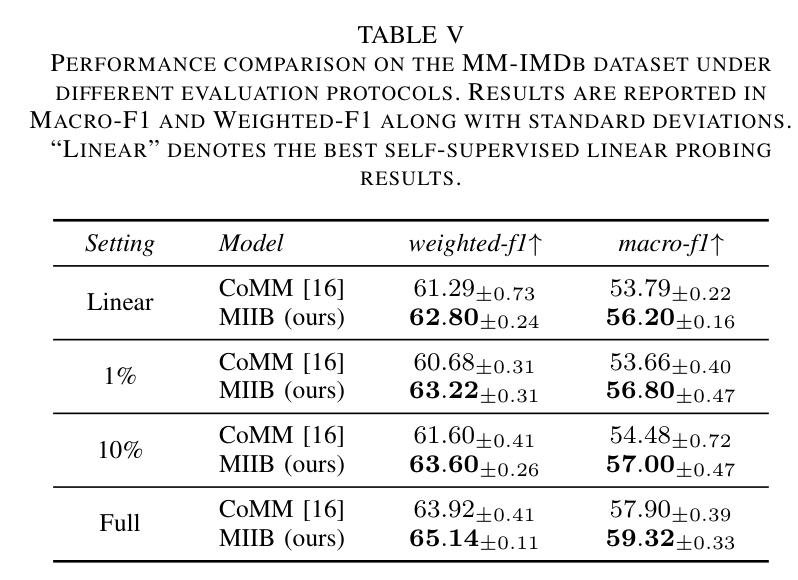
全局表现:线性探测下,MIIB 取得 62.80% 的加权 F1 与 56.20% 的宏 F1,显著超过进一步无监督微调后的原始 CLIP(54.49% / 44.94%)。
极少标注样本泛化:在仅使用 1% 标注数据的低资源微调下,MIIB 的加权 F1 达到 63.22%、宏 F1 达到 56.80%,相较 CoMM 分别提升 2.54 和 3.14 个百分点,展现出较强的数据表征迁移效率。
4. 跨模态交互可解释性分析(InterSHAP)与表征可视化
为了定量验证模型究竟是依赖单模态捷径还是真正利用了多模态交互,研究引入了基于博弈论 Shapley 值的 InterSHAP 指标(跨 15 个随机种子进行成对 t 检验)。
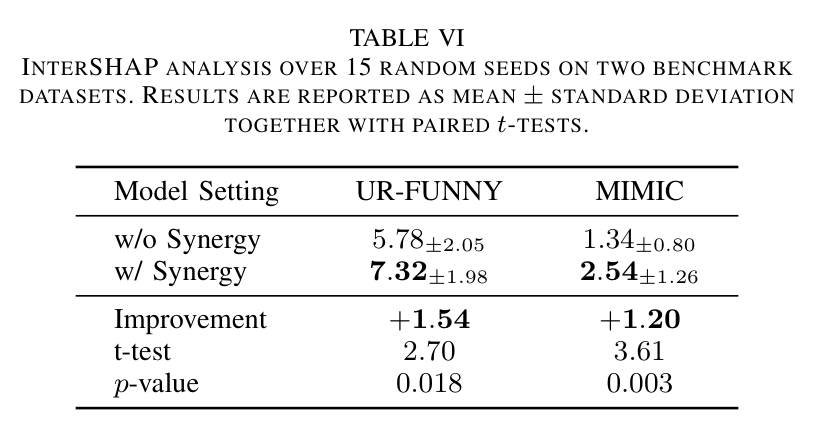
结果表明,启用协同约束后,跨模态交互贡献比例在 UR-FUNNY 上由 5.78% 显著提升至 7.32%(),在 MIMIC 医疗数据上由 1.34% 提升至 2.54%()。这一统计检验直接证明了协同流在决策中的切实参与。
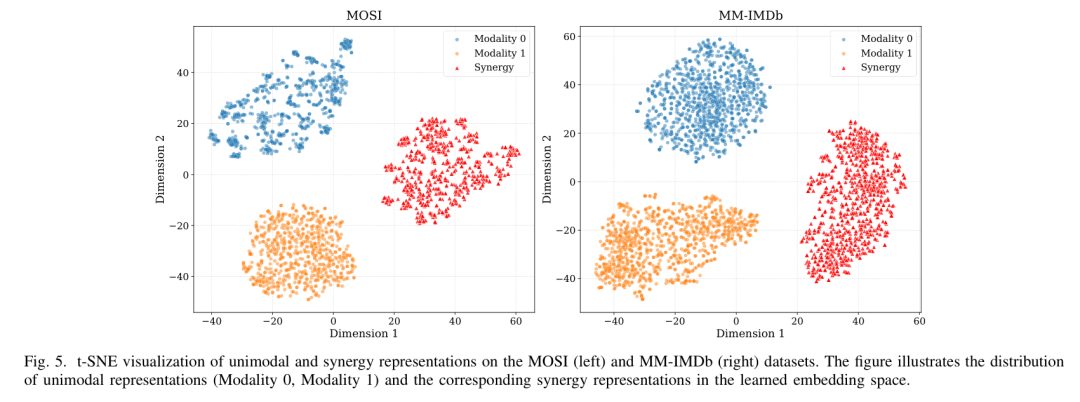
在 MOSI(左侧子图)和 MM-IMDb(右侧子图)的 t-SNE 可视化投影中,两个单模态表征簇(Modality 0、Modality 1)与协同表征簇(Synergy)在潜空间内呈现出清晰的聚类隔离,验证了余弦解耦铰链损失对特征空间正交分离的引导作用。
算力消耗与工程落地指引
许多引入信息论约束的方法常伴随成倍增长的显存开销与缓慢的训练收敛。MIIB 在单张消费级 GPU(NVIDIA GeForce RTX 4090)上对计算开销进行了详尽基准测试:
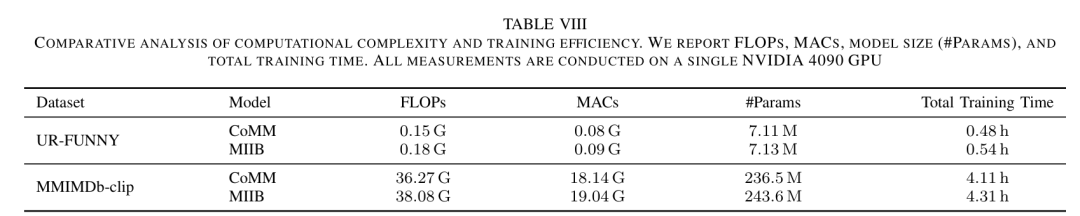
从实测数据来看:
在轻量级任务 UR-FUNNY 上,协同 Transformer 的加入仅带来 0.02M 的参数增长,完整训练仅耗时 0.54 小时(约 32 分钟);
在大参数量的 MM-IMDb(CLIP 骨干)上,模型总参数量为 243.6M,计算量与耗时相较于 CoMM 仅增加约 3%~5%,训练总时长为 4.31 小时。
这意味着多模态研究人员无需依赖庞大的多卡算力集群,使用单张 RTX 4090 即可完成全套自监督预训练与评估复现。
思考与局限
MIIB 从信息论和部分信息分解(PID)切入,针对传统多模态自监督“重对齐、轻协同”的偏向,给出了一套结构化的解法。论文也在文末坦承了现存的边界:当前框架中的协同目标更多是作为一种诱导偏置(Inductive Bias),在工程上引导模型关注跨模态交互,并非在严苛数学上无条件精确辨识 PID 理论值 ;此外,目前的实验主要验证于静态图像、文本、音频切片及中等体量骨干网络。如何将此机制进一步推广至长视频流式交互及超大多模态大模型底座,仍是后续值得探索的方向。
论文标题: Multimodal Information Interactions Bottleneck for Multimodal Self-Supervised Learning
所属机构: 西南财经大学、北京具身智能机器人创新中心、中国科学院深圳先进技术研究院、四川大学、国防科技大学、复旦大学、上海科学智能研究院、电子科技大学、成都恒图科技
代码仓库: https://github.com/wanglingzaishi/MIIB (已公开仓库地址,尚未开源)
录用期刊: IEEE Transactions on Pattern Analysis and Machine Intelligence (TPAMI)
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。