G.O.S.S.I.P 阅读推荐 2026-11-11 省钱的功能没在省钱,程序还一声不吭 | ICSE 2027
Ying Zhang 2026-11-11 23:31 德国
今天推荐一篇 ICSE 2027 的论文,聊的是 prompt caching。拿 Claude 或 GPT 的 API 做过 Agent 的朋友对它应该不陌生,Anthropic、OpenAI、Gemini、Bedrock 家家都有,Cline、OpenHands、Goose 这些开源 Agent 也都接上了。命中缓存的那部分输入,按官方价格大约只收一折,这么划算的事,谁不开呢。
开是开了,用没用对就是另一回事了。作者翻了 10 个热门开源 Agent 的 148,947 个已合并 PR,从里面找出 120 个跟 prompt caching 有关的缺陷。其中 108 个跑起来一个错都不报,模型回答也完全正确,只是缓存没命中,或者统计出来的缓存用量是错的。论文标题 Silent and Costly 说的就是这件事。
先放几个数字,赶时间的朋友看完这段也行:
10 个开源 Agent 里找出 120 个缺陷,归成 8 种根因
90% 的缺陷不报错,只能从账单、延迟或者缓存用量上看出来
68% 的修复是静态、局部或者只改用量统计的小改动
作者做的检测工具 CacheLint 在 571 个仓库里报出 32 个新缺陷,开发者已经确认 21 个、修了 18 个,Anthropic 官方的 .NET SDK 也在里面
01 先看一个时间戳
PrivateGPT 是一个挺有名的开源 RAG 框架。开发者想让模型知道现在几点,就在 system prompt 最前面拼了一个 datetime.now().isoformat()。需求很正常,代码也就一行,缓存就这么没了。
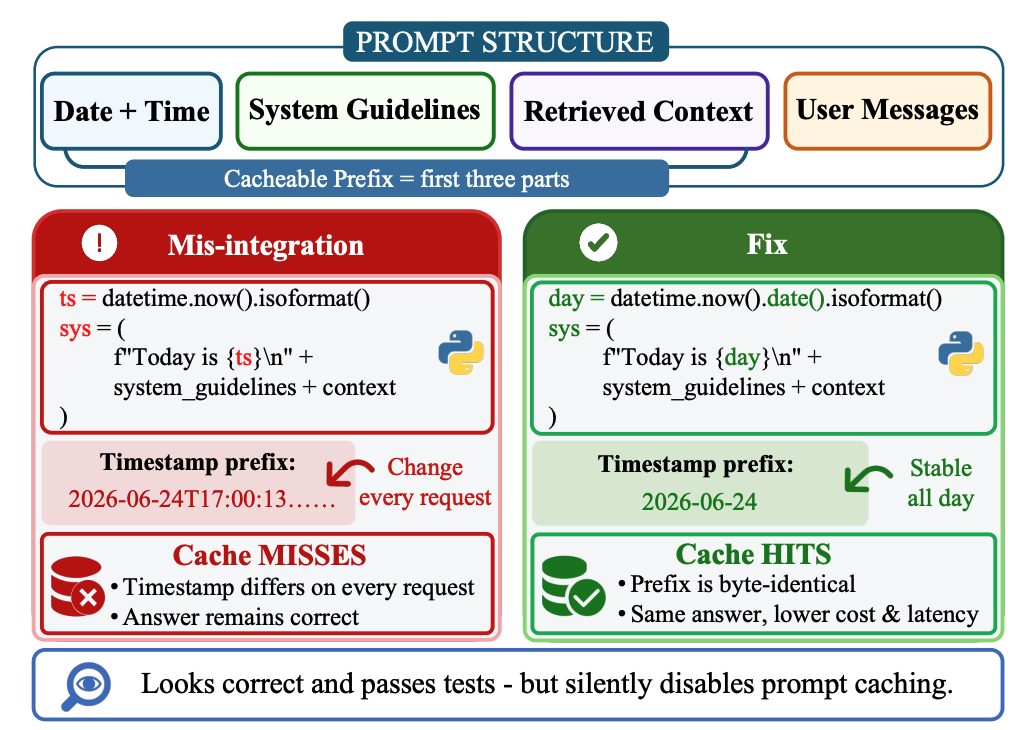
图:PrivateGPT 的例子,左边的时间戳精确到秒以下,放在 system prompt 最前面,每次请求的前缀都不一样。右边改成只精确到天,前缀一整天都不变
prompt caching 要求新请求的前缀从第一个 token 开始就跟缓存里的一字不差。isoformat() 精确到秒以下,每次请求的第一行都不一样,后面几千个 token 的指令和检索内容再稳定也没用,全部按原价重新算一遍。程序照常跑,回答也没毛病,要等哪天有人翻账单才会发现不对劲。
修起来倒是简单,把 isoformat() 换成 .date(),时间只精确到天,前缀一整天都稳稳的。
论文把这类问题叫作 prompt caching mis-integration,意思是应用代码没按提供商的要求去开启、配置或者统计缓存。提供商那边的缓存机制本身没毛病,问题出在应用自己的代码里。
02 缓存对应用有两条硬要求
Agent 每轮调用模型时,prompt 一般由 system 指令、工具定义、检索或环境上下文和对话历史拼成。相邻两轮前面一大段基本一样,变的只有最新那条消息。prompt caching 就是让提供商把这段公共前缀的计算结果存起来,下一轮直接拿来用。论文引用的数据是,命中部分的输入费用大约是原价的十分之一,延迟最多能降 80%。
想吃到这个优惠,应用得守两条规矩。第一条是前缀要稳,从第一个 token 起必须完全一致,改一个字或者换两段的顺序,从改动的地方往后就全部失效。第二条是参数要对,偏偏各家的规矩还不一样。Anthropic 要在请求里显式加 cache_control 标记,Bedrock 用的是 cachePoint,两家都限制每个请求能加几个标记。OpenAI 和 Gemini 则是自动缓存,不用加标记。
更麻烦的是规矩还会改。Bedrock 给部分模型加了可选的一小时缓存,Anthropic 把默认缓存时长从一小时缩到了五分钟,没改过代码的部署,命中率也跟着明显受了影响。
03 120 个缺陷是怎么挖出来的
作者先在 GitHub 上搜关键词。一类是缓存标记,像 cache_control、cachePoint、cachedContent、prompt_cache_key,一类是用量字段,像 cached_tokens、cache_read、cache_creation,再加上 "prompt caching" 这个短语,一共搜到 581 个仓库。
筛选标准有三条。项目得是面向终端用户的通用对话或编码 Agent,推理引擎、顺带有个 Agent 的编辑器和单一用途的工具都不算。项目得还在维护。源码里得真的实现了 prompt caching,HTTP 缓存、会话缓存这类不算。最后按 star 数取前十:OpenClaw、Hermes-Agent、AutoGPT、OpenCode、LobeHub、OpenHands、Cline、Goose、Aider、Nanobot。
这十个项目加起来有 148,947 个已合并 PR。作者用关键词捞出 622 个候选,三位作者各自从头到尾看了一遍,筛掉 502 个只是碰巧沾上关键词的,剩下 120 个缺陷,每个都有一个已经合并的修复 PR。接着三个人又各自用开放编码给每个缺陷标上根因、症状和修法,意见不一样的地方再坐下来商量着定。
04 八种根因
120 个缺陷先分成两大类。97 个出在发请求的环节,应用发出去的请求本身就有问题。剩下 23 个出在读结果的环节,缓存其实好好的,是应用把读回来的用量数字处理错了。再往下分一共八种根因,下面直接用论文里的原名。
Provider compatibility,47 个,占 39%。 应用加了缓存配置,可选的模型或提供商并不支持,配置要么被悄悄忽略,要么请求直接被拒。
- Model-name gating
,37 个,八种里最多。代码拿模型名字来决定开不开缓存。
cline#3343只给名字以claude开头或者带anthropic的模型加缓存标记,后来上游给一个 Gemini 2.5 模型改了 ID,这个模型就被挡在了门外,缓存悄悄关掉,一点报错都没有。OpenHands#8365也差不多,模型名后面的latest一去掉,缓存就跟着没了。 - Incompatible marker
,10 个。
nanobot#2687给所有走 OpenRouter 的模型都加上了 Anthropic 的cache_control标记,GPT、Gemini、DeepSeek 都不认这个标记,请求直接 401。
# cline 3343,论文里的简化版- if model.id.startswith("claude") or "anthropic" in model.id:+ if registry.supports_cache(model.id):block["cache_control"] = {"type": "ephemeral"}
Prefix stability,41 个,占 34%。应用自己拼出来的前缀每次都不一样,跟上一次存下的对不上。
- Prefix reassembly
,15 个。每次调用都换个顺序或结构重新拼前缀。
hermes-agent#754的网关每轮都把 system prompt 重新组装一遍,成本涨了大约 75%。 - Volatile value
,13 个。时间戳、UUID 这种每次请求都变的东西混进了缓存前缀,比如
goose#2434在 system prompt 里放了实时时间,跟 PrivateGPT 是一个路数。 - Nondeterministic serialization
,10 个。内容一样,序列化出来的字节却不一样。
openclaw#64198里 map 的顺序每个实例都不同,hermes-agent#3991更干脆,直接拿随机的uuid4当 call-id。 - Misplaced marker
,3 个。缓存标记加在了会变的那条消息上,稳定的前缀反倒没加。
Cross-turn mutation,9 个,占 8%。 两轮之间程序改了状态,顺手把上一轮已经缓存的内容也改了。openclaw#58038 到第三轮以后会裁掉历史消息里的图片,已经缓存的对话前缀就这么被改掉,之后每次压缩上下文都得重新写一遍缓存。
Usage miscount,23 个,占 19%。 这一组就是出在读结果环节的那 23 个。缓存命中得好好的,应用在解析、累加、计价或者展示 cache token 数的时候算错了。cline#10266 属于活干了账没记上,它在两个提供商的处理代码里把 cache-creation token 数硬编码成了 0,用量显示没有缓存,缓存其实一直在命中。
Provider compatibility 和 Prefix stability 两组加起来有 88 个,占了七成多。
05 九成缺陷不报错
120 个缺陷里,108 个不会产生任何错误。没有异常,没有断言失败,也不崩,模型照样答得对,只有缓存在悄悄变差。
这 108 个里,86 个是缓存直接不命中了,程序照常跑,能看出问题的只有多出来的费用和延迟,得专门去翻用量数据才知道。另外 22 个是缓存明明在工作,报给开发者的 cache token 数却被解析错、加错或者显示错了。开发者本来想靠这个数确认缓存有没有生效,结果这个数本身就不准。
只有 12 个会崩,其中 8 个是 Incompatible marker。比如 OpenHands#3689 往 Vertex 发了 cache_control 字段,被回了一句 "Extra inputs not permitted"。这种问题第一次跑就会暴露,普通测试就能抓到。剩下那九成,测试跑多少遍也不会报一个错。
06 修起来不难,难在发现
八种根因对应六种修法,论文里分别叫 capability lookup、marker guard、cache-boundary fix、prefix canonicalization、lifecycle guard 和 usage-counter fix。翻成大白话就是:按模型能力决定开不开缓存,只在提供商认的地方加标记,把会变的内容挪出缓存区,让序列化结果固定下来,别让后面的轮次改掉前面缓存过的内容,再就是把用量的算术改对。
作者算了一下,给每种根因套上它最常见的修法,120 个修复里能猜对 95 个,其中有五种根因每次都是同一种修法。比如 23 个 Usage miscount 全是改用量算术,13 个 Volatile value 全是把会变的值挪出缓存区。
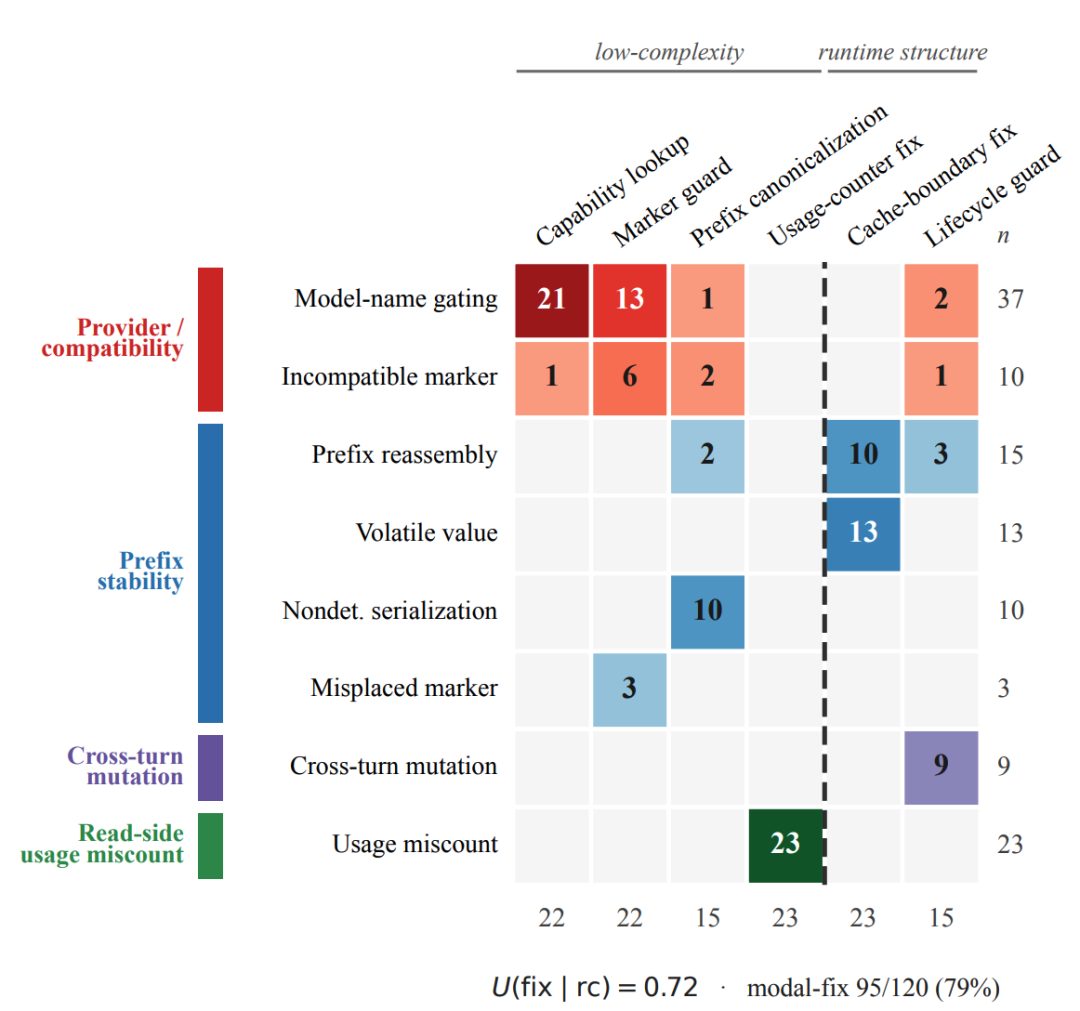
图:根因和修法的对应关系,每格是缺陷数,按根因分组上色,颜色越深数量越多
补丁也都不大。六种修法里有四种是静态的、局部的,或者只动用量统计,加起来覆盖 82 个修复,占 68%。最常见的就是加一个判断条件、改一个判断条件,或者把 token 数的算术改对。
所以这类缺陷真正费劲的地方在发现。开发者得先注意到费用或者延迟涨了,再一路往回查到拼请求的那段代码。找到以后,改动通常很小,不同项目的修法也都差不多。
07 CacheLint 是怎么查的
大部分缺陷不报错,靠跑测试基本发现不了,修法又这么固定,作者干脆把它们反过来写成了检测规则,这就是 CacheLint。
CacheLint 把每类问题看成一对东西,一个是缓存调用点 m,一个是这个调用点必须满足的条件。条件分三类,正好对应三组根因,论文里叫 STAB、CAP 和 ACCT,分别管前缀稳定、提供商能力和用量统计。如果程序走到 m 之前没有任何检查能保证条件成立,就算一处问题。Cross-turn mutation 和 Prefix reassembly 要比较不同轮次的前缀,光看一个程序状态判断不了,作者把它们划在了检测范围外面。
具体分三步:
先用 CodeQL 把缓存调用点都找出来,支持 Python、JavaScript/TypeScript、Ruby、Go 和 C#。
CAP 条件不问 LLM,直接查表。CacheLint 维护了一张提供商能力矩阵,每条记录都来自官方文档,还标了核对日期。把代码对模型能力的假设拿去和矩阵一对,结论就出来了。有意思的是,CAP 条件的对错会随时间变。Bedrock 推出一小时缓存以后,有些原本没问题的代码一行没改,就变成了缺陷。
STAB 和 ACCT 条件交给 LLM 判断,论文管这一步叫 guard check。CacheLint 把调用点和它所在的函数一起交给
gpt-5.4-mini,只问一个问题:有没有什么检查能保证条件成立,并且走得到这里,比如date()截断、sort_keys或者or 0。传统静态分析在这一步一般会做跨过程的后向切片,可 Agent 代码里动态分派和反射太多,切片很不靠谱,所以作者换成了问 LLM。
查出问题以后,CacheLint 会报警告,顺便把这类根因最常见的修法一起附上。
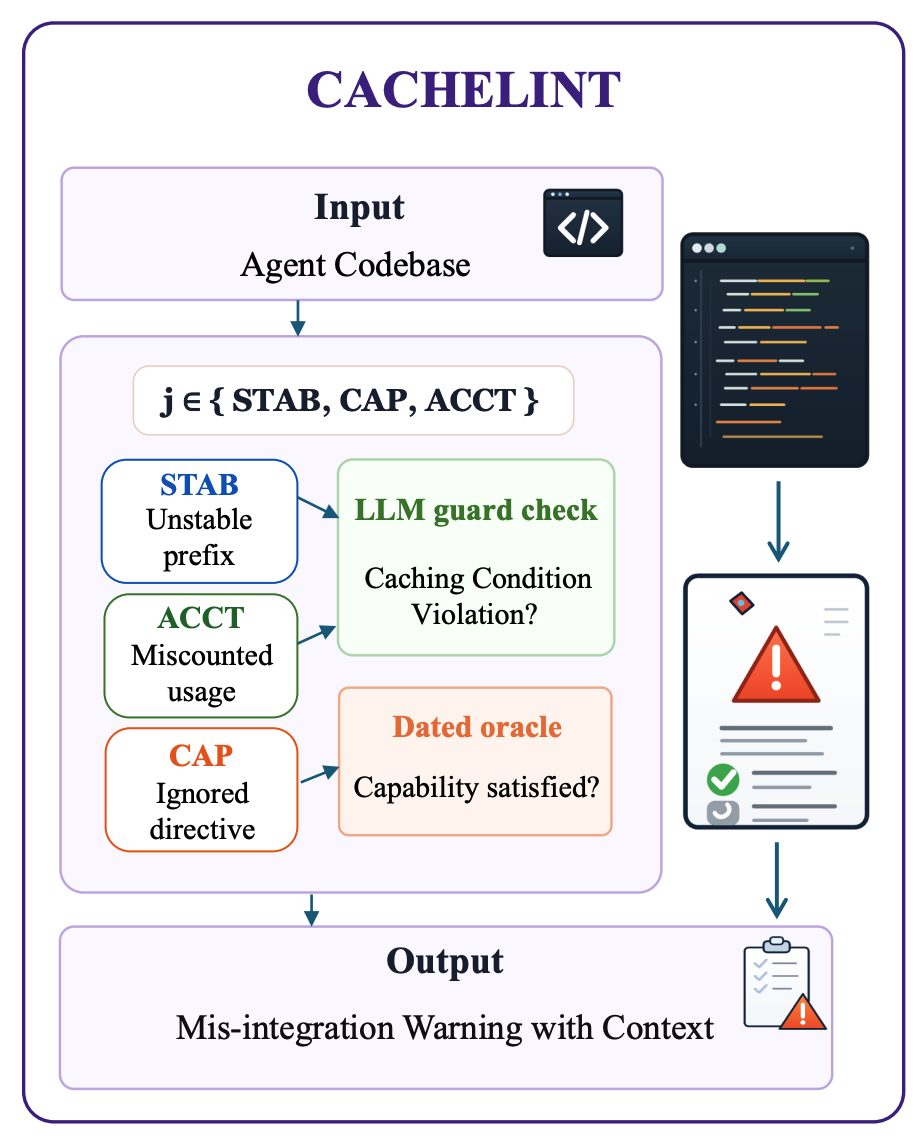
图:CacheLint 的工作流程,CAP 条件去查带日期的能力矩阵,STAB 和 ACCT 条件交给 LLM 做 guard check
08 效果怎么样
Dataset A 就是做实证研究的那 10 个项目,拿 120 个缺陷当标准答案。CacheLint 报了 132 条警告,94 条是真问题,38 条是误报,漏掉 26 个缺陷,精确率 0.71,召回率 0.78。漏掉的 26 个里,24 个是 Prefix reassembly 和 Cross-turn mutation,分别是 15 个和 9 个,本来就在检测范围外面。剩下 2 个是 Volatile value,会变的值是在所在函数外面引进来的,guard check 看不到那么远。所以范围内的 96 个,CacheLint 找到了 94 个。不过规则就是从这批修复里总结出来的,论文自己也说了,这个召回率只能算样本内的上界。
Dataset B 是剩下的 571 个仓库,实证研究没收的 SDK、框架和单一用途的工具也都在里面。CacheLint 报了 37 条警告,32 条是真问题,5 条误报,精确率 0.86,涉及 33 个项目,大到 19.5 万 star 的 n8n,小到一个人维护的工具都有。这 32 个真问题作者全都复现了一遍。n8n 踩的坑和开头的 PrivateGPT 一样,缓存的 system prompt 前面拼了个毫秒级时间戳。
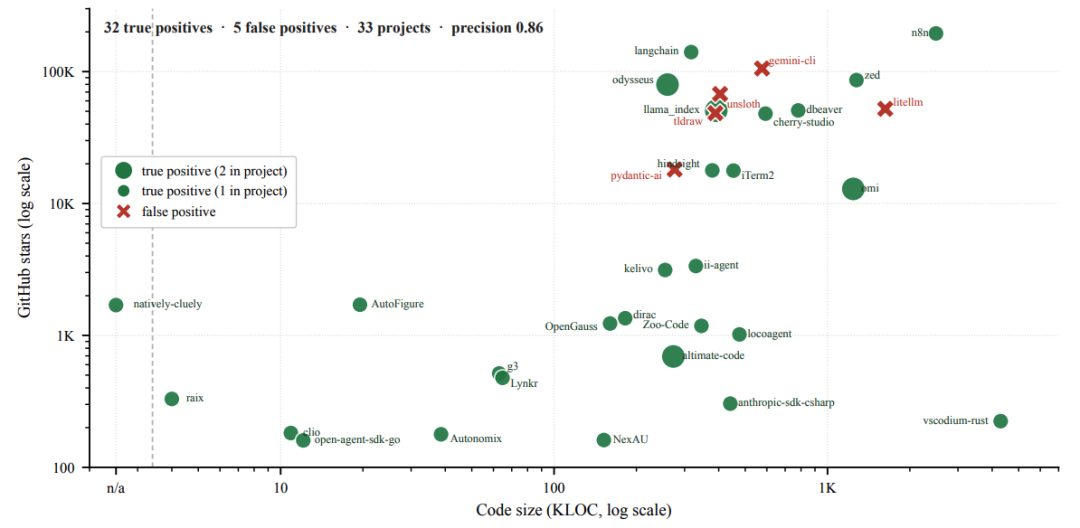
图:CacheLint 在 33 个项目里的发现,按代码规模和 star 数排开
消融实验看的是两个组件各自有多大用。做法是拿掉一个组件,换成不带这部分上下文的 gpt-5.4-mini 来判断,都在 Dataset B 上跑。去掉 guard check 的版本用一个通用的 API misuse prompt 去问,不再具体问有没有 date() 截断或者 sort_keys 这类检查。去掉能力矩阵的版本让 LLM 凭自己的知识判断模型支不支持缓存。
配置 | 真问题 | 误报 | 精确率 |
|---|---|---|---|
CacheLint 完整版 | 32 | 5 | 0.86 |
去掉 guard check | 18 | 41 | 0.31 |
去掉能力矩阵 | 17 | 349 | 0.05 |
去掉 guard check 以后,unsloth 里那个已经截到天的时间戳被当成问题报了出来,litellm 里用 .get(..., 0) 兜过底的 token 统计也没逃掉。去掉能力矩阵就更热闹了,误报直接涨到 349 个,大多是路由、模型注册表和测试代码里那些人畜无害的模型名判断。作者还顺手做了个小实验,把矩阵里 33 条带日期的一小时缓存记录拿去问 gpt-5.4-mini,它只对其中 5 条答得既肯定又正确,训练截止以后才发布的模型它干脆不知道。所以能力这件事,作者还是交给了带日期的外部矩阵。
两个版本连真问题都变少了,从 32 个掉到 18 个和 17 个。论文的解释是,少了这部分上下文,LLM 容易把 prompt caching 的问题当成普通的 API 调用来看,真缺陷看漏了,没毛病的地方倒报了一堆。完整版就稳多了,跑五次,精确率最多差 0.02,波动全来自一条时有时无的误报。
09 报上去以后
作者把 32 个真问题都报给了上游。截到论文定稿,21 个已经被确认,18 个修好了,11 个还没回音,一个被拒的都没有。确认的项目里有 AutoGPT、n8n,还有 Zed。论文里讲了三个例子:
连 Anthropic 官方的 .NET SDK,也就是 anthropic-sdk-csharp,也在里面。API 返回的 cache-creation 和 cache-read token 数是可选字段,SDK 把它们反序列化成可空属性以后,没判空就直接拿来用了,响应里一旦少了这两个字段,缓存用量就统计不对。维护者已经修了。
altimate-code 只给一组写死的 Anthropic 原生模型路径加
cache_control,同样的请求换成走 OpenRouter 或者 Bedrock 这类网关,就没有标记,缓存也就用不上了。维护者改成了按能力判断。iTerm2 的 AI 助手在缓存的 system prompt 开头附近放了一个每次请求都会变的值,缓存自然命中不了。维护者把这个值挪出了缓存区。
10 写 Agent 的朋友可以对照查一查
把八种根因反过来看,差不多就是一份自查清单:
开不开缓存按模型能力来判断,别把模型名写死
缓存标记只发给认它的提供商和模型
时间戳、UUID 这类每次都变的值,放到缓存前缀外面去
序列化结果要固定,比如给 map 的 key 排个序
缓存标记加在稳定的前缀上
会话进行到一半,别去改已经缓存过的历史
读用量字段之前先判个空
程序跑得好好的,也说明不了缓存在命中,所以隔一阵子最好去看看响应里的缓存用量字段,比如 cache_read 和 cached_tokens 这类字段。
论文也交代了 CacheLint 管不到的地方。提供商在模型侧自动开启的隐式缓存目前不在检测范围内,论文把它留到了以后。能力矩阵用的是 2026 年 5 月 10 日的快照。作者接下来打算把能力矩阵扩展到更多提供商,再试试自动生成和验证修复。
项目主页,数据集和 CacheLint 源码都在这里:https://sites.google.com/view/prompt-caching-mis-integration
如果你也对 LLM Agent、软件工程、AI 安全和 LLM 安全感兴趣,想一起研究这些方向的问题,欢迎加入,先去 Yi Liu 老师的主页逛逛吧。
本文转载自微信公众号「安全研究GoSSIP」,查看原文。版权归原作者所有,如有侵权请联系删除。