南洋理工新研究全面实测371张顶会配图:生成式AI绘图存在明确清晰度与美学冲突
原创 CV君 2026-11-11 23:57 江苏
绘图利器亦是双刃剑。
在各大计算机视觉顶会截止日的前夕,许多科研人员都有过相似的经历:正文已经修改完毕,但第一张图表(Figure 1)仍停留在绘图软件中。微调箭头的走向、统一色系编码、或是替换一个能够精准表达核心直觉的示例,这些通宵达旦的调整往往决定了读者能否在数秒内抓住一篇论文的灵魂。
随着生成式人工智能(Generative AI)工具的普及,绘制架构图与动机图的门槛被大幅拉低。圆角边框、柔和马卡龙色调、细致的概念图标与流程卡片迅速在各大顶会预印本中流行开来。然而,这种由模型辅助甚至直接生成的学术配图,究竟是让研究更具解释力,还是制造了视觉杂乱?
针对这一问题,来自新加坡南洋理工大学的研究团队展开了一项系统性的实证回顾研究,全面探讨了生成式 AI 时代下科研论文中的动机图(Motivation Figure)与架构图(Framework Figure)设计。
背景与动机:视觉形式与科学本质的呼应
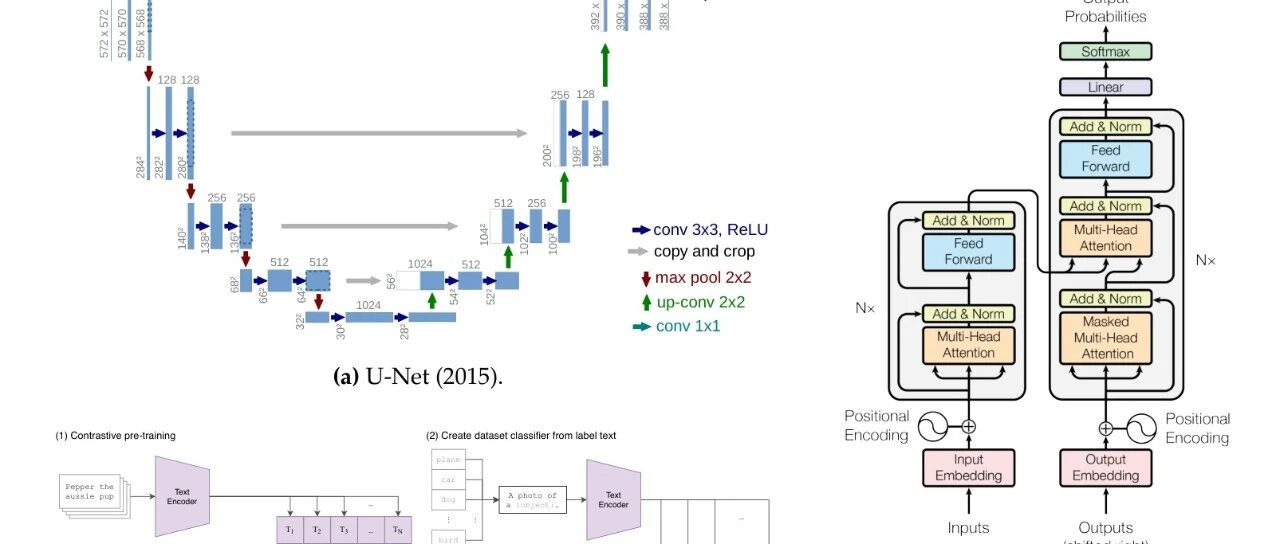
科学图表不仅是正文的装饰,更是科研想法的视觉化载体。正如经典的 U-Net 通过「U 形」拓扑结构展现多尺度下采样与跳跃连接,Transformer 通过左右分离的编码器-解码器架构传达自注意力与交叉注意力机制,CLIP 将对比预训练与零样本预测并列呈现,这些经典设计之所以成为里程碑,正是因为其构图与所承载的科学本质形成了严格的拓扑对应。
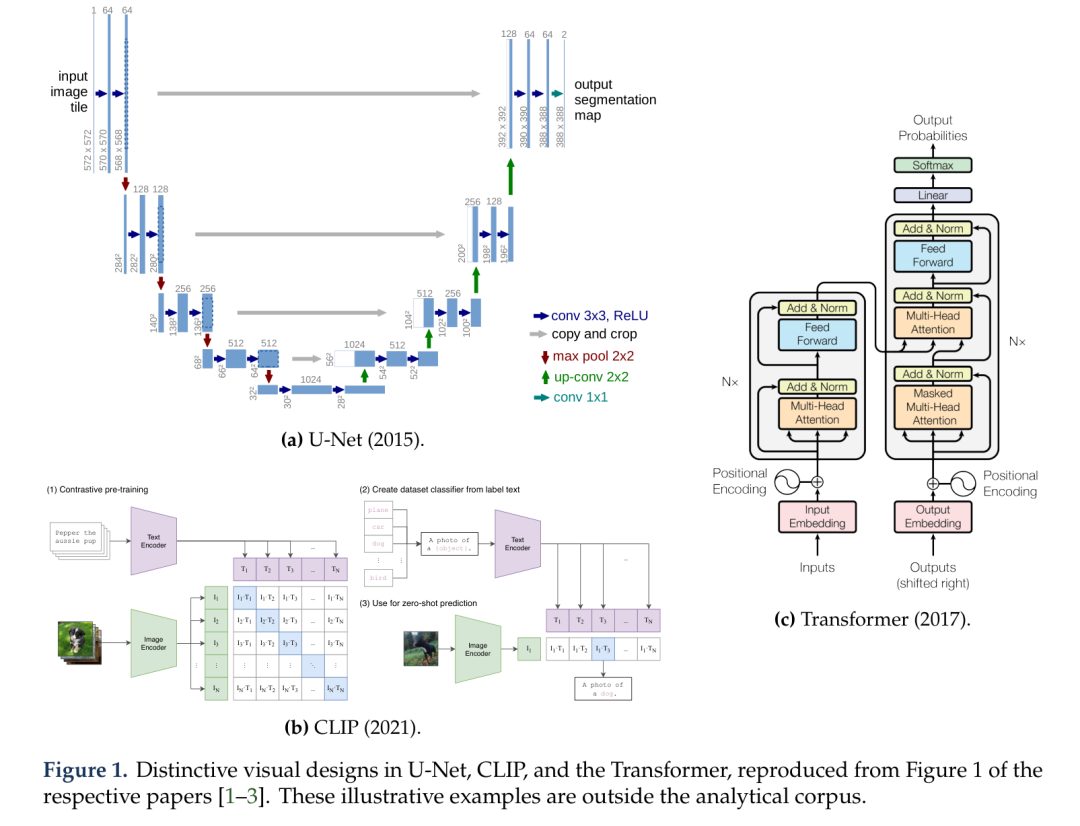
在生成式 AI 时代,大模型可以快速输出成套的流程图与示意图,但一个直观的矛盾随之而来:精美的外观是否等同于高效的学术传达?
在现实论文中,单纯堆砌文字标签与装饰性图标,虽然能消除歧义,却常常成倍增加读者的阅读负担;而过度追求极简,又可能隐去关键的数据流向。为了理清这背后的真实效应,需要将视觉外观、制作来源(人工抑或 AI 辅助)以及传达质量解耦,建立多维度的量化评估基准。
方法详解:十年演进语料库与闭环受限修改评估
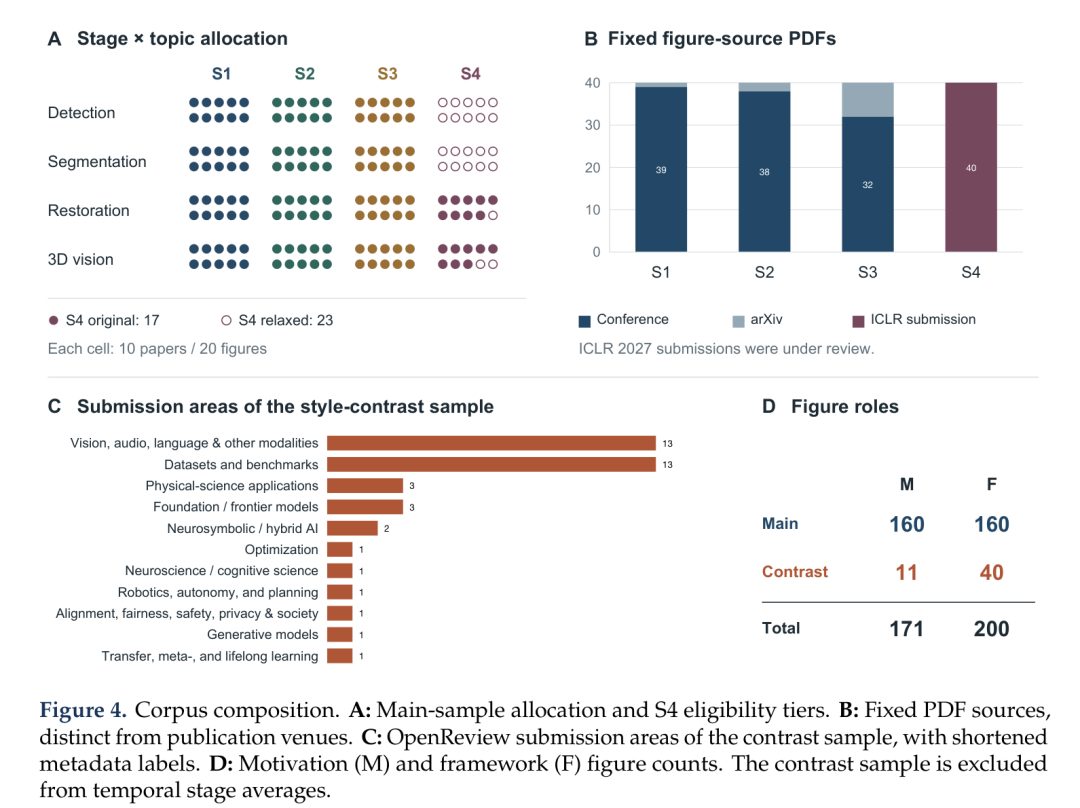
为系统评估图表质量,研究团队构建了跨越 10 年(2016 年至 2026 年)的学术图表语料库,共涵盖 200 篇论文、371 张动机图与框架图,并设计了六维度多模态评测标准与基于源信息约束的 AI 修改流水线。
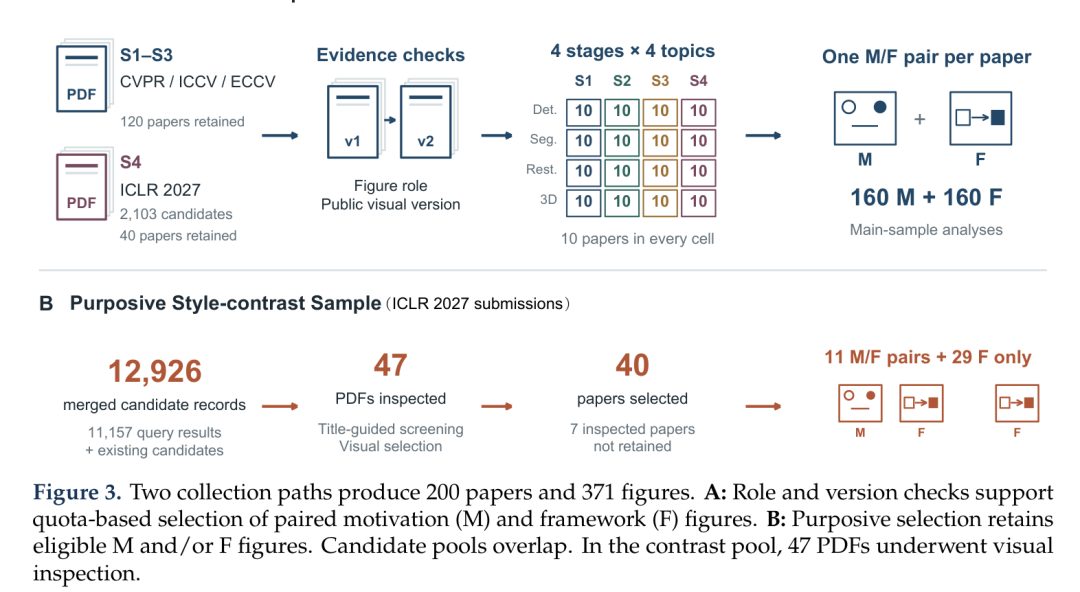
1. 语料库构建与时期划分
语料库由两个互补的样本路径组成:
主样本(Main Sample):共 160 篇论文(320 张成对的 M 图与 F 图),采用严格的配额抽样设计(4 个历史时期 4 个经典视觉主题 10 篇)。涵盖目标检测(Object Detection)、图像分割(Image Segmentation)、图像恢复(Image Restoration)与三维视觉(3D Vision)。
S1(Pre-ChatGPT 阶段):2016-01-01 至 2022-11-29(ChatGPT 发布前);
S2(ChatGPT 阶段):2022-11-30 至 2025-08-25;
S3(Gemini 2.5 Flash Image 阶段):2025-08-26 至 2026-04-20;
S4(GPT Image 2 阶段):2026-04-21 至 2026-10-20。
风格对比样本(Style-contrast Sample,
S4-AI-Style):包含 40 篇论文、51 张图表(11 对 M/F 图,29 张仅 F 图)。该子集专门针对展现出典型现代「AI 绘图风格」(嵌套边框、标签面板、淡色调、丰富图标及解释文字)的预印本进行定向筛选,用于分析特定排版范式的影响,独立于时间演进分析。
2. 冻结评估维度与评委协议
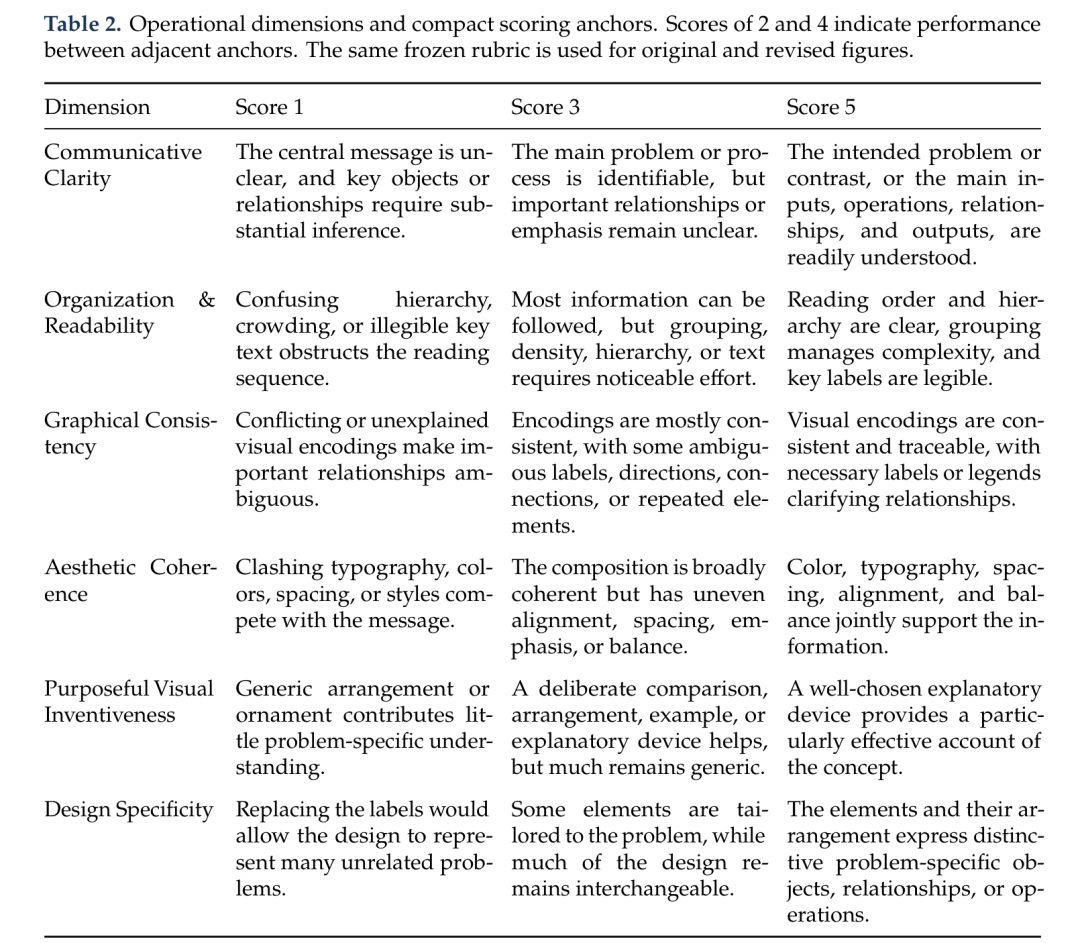
评估采用标准化的多模态大模型评委(由 gpt-6-astra 驱动),对每张匿名处理的图表执行 3 次独立重复评审(全图视角加上两幅覆盖 10% 重叠的切片视角),共包含六个 1–5 分的独立操作维度:
传达清晰度(Communicative Clarity, C):核心问题、运算流与输入输出关系是否易于理解;
组织与可读性(Organization & Readability, O):视觉层次、排版密度与文字易读性;
图形一致性(Graphical Consistency, G):颜色、符号、线条逻辑是否统一且具备可追溯性;
美学连贯性(Aesthetic Coherence, A):字体、色彩、留白与对齐的平衡协调程度;
目的性视觉创新(Purposeful Visual Inventiveness, I):视觉表现手法是否具有针对该科学概念的有效解释力,而非通用装饰;
设计特异性(Design Specificity, S):图表元素与科学问题的绑定程度(若抹去文本,该设计是否能被轻易套用至无关问题)。
3. 源约束修改与科学保真度审查
在修改实验中,研究团队为 371 张原图提取了其在原论文中的 Caption 及相关正文描述,并结合初评时发现的缺陷形成修改 Brief,利用 gpt-image-2.5 进行重绘。
为了杜绝生成模型产生的学术幻觉,所有修改均受到严格的物理与科学约束:
数据承载区强制保留:原始论文中的真实照片、分割掩码、热力图、性能曲线等像素级数据必须程序化原样贴回;
科学保真度审查(Fidelity Review):由独立会话的比对模型进行因果拓扑与语义校验。在 371 次尝试中,共有 369 张成功通过保真度审查,2 张被否决(例如图像分割论文 Make It Up 的框架图在修改后遗漏了局部原型更新分支,且凭空引入了一条无依据的反向箭头,直接被拦截退出评分池)。
实验与结果:清晰度上升与美学下滑的博弈
基于 369 对成功完成修改并打分的图表(整套流程消耗约 10 亿 tokens,评分完全一致率超过 85%),数据分析揭示了一系列反直觉且深刻的技术结论。
1. 论文配图随年代全面变差了吗?
回顾性分析显示,论文原图的评分并没有呈现随年份单调退化的趋势。
相反,在主样本中,S4 阶段的动机图在传达清晰度(C)和组织结构(O)上的均分均高于早期的 S1 阶段。然而,设计特异性(S)的提升并不必然带来目的性视觉创新(I)的同步增长。在全部原图中,有 58 张图的设计特异性达到满分 5 分,而其视觉创新得分却不超过 3 分,说明大量图表依然依赖通用的模块框图表达特定算法。
2. AI 辅助修改:显著提升清晰度,但损伤美学与排版
在通过保真度审查的 369 张修改图表中,各个维度的平均分变化展现出明显的结构性权衡(Trade-off):
传达清晰度(C):由 3.629 提升至 4.057,净增 +0.428(95% 置信区间: [+0.367, +0.492]),在 142 张图表上获得正向提升;
图形一致性(G):净增 +0.111(CI: [+0.056, +0.168]);
设计特异性(S):净增 +0.163(CI: [+0.114, +0.212]);
美学连贯性(A):由 3.591 跌落至 3.480,净降 -0.111(CI: [-0.170, -0.054]),79 张图表出现美学降级;
组织与可读性(O):由 3.973 微降至 3.951(-0.022);
目的性视觉创新(I):85.9%(317 张)的图表保持不变。
六维总均值最终仅微幅上升 +0.103(3.842 3.945)。单纯看综合总分,极易掩盖其内部「文字阐释增多带来清晰度跃升」与「视觉拥挤破坏整体美学」之间的激烈冲突。
3. 角色分水岭:为什么动机图大赚,架构图却碰壁?
按图表类型细分后,实验呈现出极大的不对称性:
动机图(Motivation Figure):主样本中的六维均值显著上升 +0.242,其中清晰度提升高达 +0.800,特异性提升 +0.306。
架构图(Framework Figure):主样本六维均值仅微增 +0.018,美学连贯性则大幅下挫 -0.164。而在具有浓厚 AI 风格的对比样本中,架构图修改后的六维均值甚至出现了 -0.100 的倒退。
这一现象的技术成因十分直观:动机图通常用于直观呈现前人缺陷与核心思想对比,原本结构较松散,大模型为其补充对比标签与指引标注后,能极大地改善信息传达;而架构图本身具有高度复杂的技术流向与模块层次,强行塞入解释性说明框和衍生卡片,极易打破原本严整的排版秩序,造成文字密度过载。
典型案例对比:加法容易,克制最难
论文精选的典型个案生动还原了这种设计层面的博弈。
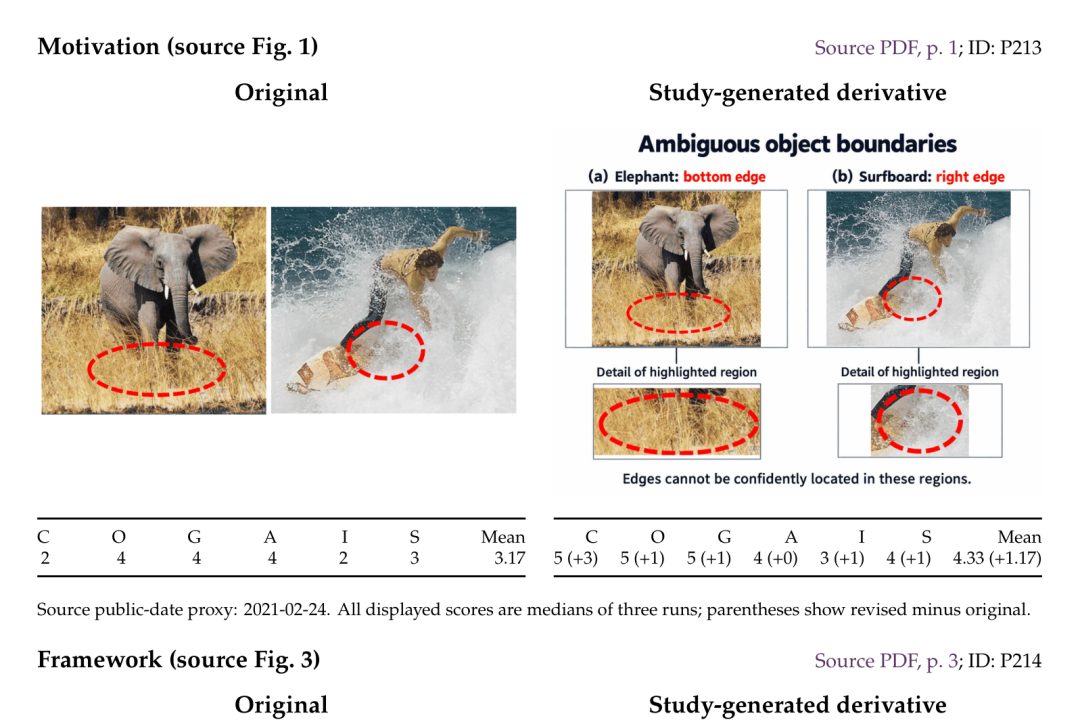
1. 极值案例:从极简对比到满分设计
在所有案例中,提升幅度最大的是过分割问题(Over-segmentation)的动机图(ID: 128_M)。其原图仅提供了几组候选框对比,缺乏直观引导,原均分仅为 2.67 分;修改后,模型明确标出了置信度碎片与整体目标选择的对比机理,清晰度由 2 跃升至 4,特异性升至 5,总均分达到 4.33 分(净增 +1.67)。
相反,基准测试论文 AccessWorld 的架构图(ID: 163_F)在原版中便展现出极高水准(原均分 4.83 分)。修改后仅显式标注了评估打分连线,六个维度全部达到 5 分满分。
2. 负面与平庸案例:冗余堆砌与割裂感
然而,更多的尝试暴露了 AI 辅助设计的典型瓶颈:
标题与排版重复(Complexity Experts, ID: 062_F):修改模型在原有模块上方额外套用了粗体大标题,反复重复既有的子图标签,导致组织性从 5 跌至 4,总分反而倒退;
局部放大破坏全局(Look Before You Restore, ID: 147_F):模型为了展示细节,将整体流程图缩减并置于放大的状态动作编码面板之上,导致局部细节的标题比总标题更突出,全局与局部的视觉权重倒置,排版组织性由 4 降至 3;
解释层与主图脱节(BKBAgent, ID: 167_M):在其原本已包含丰富文本与拓扑的动机图下方,硬性追加了 3 个相互连接的文字注解框与一条总结句,清晰度与组织性分毫未动,但美学和创新度双双由 4 分扣至 3 分。
写在最后:学术绘图的自主权与警惕
这项研究以详实的数据给正在将 AI 深度融入科研流程的学者们提了一个醒:生成式 AI 可以提供探索布局与生成元素的画板,但绝不能替代作者对科学叙事的组织裁决。
研究表明,盲目追求 AI 工具生成的「信息完备」,很容易演变成无节制的信息堆砌,牺牲科学图表本该具备的简洁美感与清晰层级。此外,当学术评审过程也开始越来越多地借助多模态大模型时,若研究人员专门为了迎合评测模型的视觉偏好(如偏好文字标注、偏好特定色块)而修改配图,可能进一步加剧学术配图的审美趋同与范式狭隘。
那些曾经通宵达旦、为了一条连线的位置和几个色块的明暗反复斟酌的夜晚,其本质是学者将复杂的数学拓扑与逻辑结构转化为人类直觉的思考过程。在绘图工具愈发强大的今天,决定一张图表传达深度的,始终是研究者自身对科学真理的深刻理解与克制表达。
论文标题: Do You Miss the Nights We Spent Crafting Figures? Rethinking Teaser and Framework Figures in the Age of Generative AI
项目主页: https://ntu-ai4x.github.io/Rethinking_Figures/index_en.html
机构: 南洋理工大学
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。