agent 一天编几百次 Rust,我试了 Relax:改完函数 X 秒看到结果,进程不重启
原创 张汉东 2026-11-12 19:23 美国
开发时尝试用 Relax 缩短反馈、保留状态,发布时仍用 rustc 构建并完整测试。
Rust 编译慢,这件事大家已经吐槽了很多年。常见的解法都是让编译更快:开增量编译,用 cargo check 代替完整构建,把链接器换成 mold 或 lld。这些我都用过,确实有用。但最近读完一个项目,又实际跑了几组实验,我的看法变了:解法也许不只在更快的编译器,还在于不等所有代码编完就开跑。
先看等待到底有多贵。Relax 的 README 举了一个大型 3D 游戏的例子:在 M4 MacBook 上,从干净检出到首帧,Relax 用了 11 秒;rustc 则需要先构建约 3 分钟。对人来说,这几分钟足够刷一轮手机,思路也断了。对 AI agent 来说,等待同样拖长反馈循环。仓库根目录 Cargo.toml 的注释里有一句很直白的话:
agents build release all the time
这句话出自 [profile.release] 上方的注释,原意是解释这个仓库为什么给 release 构建打开增量编译、关掉默认的 LTO:agent 一直在构建 release 版,改一个 crate 之后,增量编译能把重新构建从 30 秒缩到 11 秒(Mac 上 widgets 的例子);打包发布的命令则会关掉增量编译,保证发布的二进制是完整构建的。也就是说,它说的是 Makepad 团队自己的 agent 在这个仓库里的构建习惯,不是对一般 Rust 项目的统计。但它说明,「agent 反复等 release 构建」在这个团队里是实际存在、而且值得专门调构建配置的成本。
不过,这里要把账算清楚:等待本身不等于模型持续消耗 token。反复轮询、读取构建输出、分析错误和重新规划,才可能增加模型调用与上下文开销。本文会实际测墙钟时间和反馈日志大小,不把没有测过的 token 成本写成结论。
Relax 是 Makepad 团队用 Rust 写的一套 Rust 编译器加 JIT 运行时。它把「先编完再跑」拆开了:函数按需编译,程序运行时继续优化,改动可以进入仍在运行的程序。这篇文章会先介绍 Makepad,再讲 Relax 站在哪个位置,一个函数怎么变成机器码,热替换有哪些边界,以及实际测下来,哪些地方值得期待,哪些判断需要收回来。
版本与实验范围:源码分析固定在 Relax 提交
5aa7b49990ecdfb503b9af593f8a2d670ddb65e0,Makepad 的介绍对照 makepad/makepadwork分支提交d5bdbd1023d20ad8ead2f611beca0c78105f774d(同为 2026 年 11 月 12 日),实验日期为 2026 年 11 月 12 日。测试使用仓库真实的 JSON 解析器和自己编写的小型程序,不是完整业务应用。README 的数字与本文实测分别标明。
先认识 Makepad:Relax 从哪里来
讲 Relax 之前,先介绍它的出处。Makepad 的 README 把自己定义为「面向 Rust 的、AI 加速的应用与游戏开发环境」:一个高性能 UI 运行时,一门可以实时编辑的设计语言,加上一个快速的迭代循环。它面向原生和 Web:桌面直接构建,iOS、tvOS、Android 和 wasm 通过 cargo-makepad 工具链构建;2D 和 3D 渲染都走 GPU,还带一个可以在 Quest 等平台上做游戏的前向 3D 渲染器。README 还提到,它集成了一批 AI 后端,方便在应用里嵌入大模型或生成式模型,或者在本地硬件上运行它们。
Relax 不是一个独立项目。它的源码在 makepad/makepad work 分支的 libs/relax,单独的 makepad/relax 仓库只是这个分支的投影;面向用户的入口也是 makepad run,relax 二进制只是内部开发工具。后文提到的重启协议(platform/src/restart.rs)同样属于 Makepad。所以,理解 Makepad 想要什么样的开发循环,有助于理解它为什么要自己写一个 Rust 编译器。
保留模式的组件树,即时模式风格的绘制
GUI 框架通常分两派。保留模式(retained mode)维护一棵长期存在的组件树,程序修改树上的属性,框架负责重绘;即时模式(immediate mode)每一帧都由代码重新「画一遍」,界面就是绘制代码本身,状态通常放在程序里。Makepad 把两者结合在了一起,我读源码后的理解是:
- 结构和状态按保留模式组织。
界面用 Splash DSL 写在
script_mod!里,形成一棵长期存在的组件树;组件是保存自身状态的 Rust 结构体。事件处理时按 id 找到组件、改它的属性,例如self.ui.label(cx, ids!(status)).set_text(cx, "Pressed"),这是保留模式的写法。 - 绘制是即时模式风格。
每个组件实现
draw_walk,重绘时由代码当场决定画什么、画多少,再通过布局器排版发出绘制调用。虚拟列表PortalList是一个混合的例子:模板在 DSL 里声明,绘制时由代码遍历当前可见的条目,逐个取出、填数据、立即绘制;但取出的条目组件本身仍会被保留和复用(例如保留附近的条目,滚回来时不必重建),所以它不是纯即时模式的组件模型:
  let item = list.item(cx, item_id, id!(Item));
  item.label(cx, ids!(title)).set_text(cx, &format!("Item {item_id}"));
  item.draw_all(cx, &mut Scope::empty());
这段取自 Makepad 给 agent 的 Splash 参考文档。源码里也能看到同时提供两种接口的组件,例如富文本的 TextFlow 注释写着「this widget has a retained and an immediate mode api」,图表组件也带一套即时模式绘制接口。
- 即时模式风格,不等于每帧全部重画。
重绘以绘制列表为单位,没有被标记为需要重绘的部分沿用上一次的结果;
View可以通过new_batch或texture_caching启用绘制列表或纹理缓存,在满足复用条件时避免重新绘制。这些条件包括尺寸、裁剪区域和重绘标记,并不是开了就一定命中缓存。
这样组合的好处是:界面结构可以声明、查找和局部修改,长列表、富文本、图表这类数据驱动的内容,又可以用即时模式的方式按需绘制,只为当前需要的条目实例化并复用组件,不必为每条数据维护一个常驻组件。这是我读源码后的概括,不是 Makepad 的官方表述。
Splash:既给人写,也给模型写
Splash 是 Makepad 的脚本语言,也是它的 UI 描述语言:应用的界面写在 script_mod! 里,由运行时的脚本引擎求值,在启用相应机制时可以热修改;连仓库里列出各个可运行应用、供 Studio 启动的配置文件 makepad.splash 也用它写。它对 AI 友好,体现在三个地方:
- 仓库里有专门写给模型看的 Splash 规则。
根目录的
splash.md和docs/agents/splash.md不是教程式文档,而是一条条约束:容器必须写height: Fit(文档直说这是「最常见的失败方式」)、哪些组件可用、哪些组件会「静默失败」以及用什么替代,还有一节 GPU 安全规则,要求生成的着色器循环有字面量上界、每帧不分配内存,避免生成的代码把 GPU 卡死。AGENTS.md里也有一节「Splash and shader essentials」。 - 模型可以直接在对话里生成可交互的界面。
aichat示例的系统提示要求模型:需要可视化时,在 Markdown 回答里嵌入语言标记为
runsplash的代码块。Markdown 组件识别到这种代码块,会把它渲染成内联的真实交互界面,不是代码截图。系统提示还要求,做表单、待办、计算器这类应用时,状态、回调和业务逻辑也用 Splash 写在代码块里。这些代码块运行在沙箱里,开放了net.http_request、http_resource、parse_json等少量能力,可以做依赖 HTTP 的小应用。我用 Kimi 的 Anthropic 兼容接口实际跑了一次 aichat(改了请求地址和输出上限两处配置):模型生成的设置面板作为真实界面内联渲染了出来(生成的控件我没有点击测试);但在这个提交里,aichat 使用的 provider 会把文本增量攒到整个响应结束才交给界面,所以没有看到边生成边渲染。界面这一侧(Markdown、Splash)是按流式写的,README 里列出的「Streaming Splash」本文没能在 aichat 里复现。 - 在宿主能力范围内,不必重新编译 Rust。
在已有组件和宿主能力范围内,动态 Splash 内容及受支持的 DSL 热修改,无需重新编译 Rust 宿主。这正适合模型反复生成和调整界面。
.rs文件里script_mod!的热更新则需要启用相应机制,并且有约束,例如块的数量和 Rust 插值的数量要与原来一致。
这些规则本身也说明了现状:文档里列出的坑和「静默失败」的组件不少,模型生成的 Splash 仍然需要运行验证。
从 Splash 到 Relax
到这里可以看出 Relax 在 Makepad 里的位置。Splash 让界面和一部分逻辑可以边跑边改,但对于用 Rust 实现的组件、业务逻辑和渲染代码,传统 Cargo/rustc 路径仍需重新构建(可以是增量构建),再重启程序。Relax 将运行中替换延伸到这部分代码。可以这样理解:它想把「保存即生效」从 Splash 层延伸到 Rust 代码本身。这是我的概括,不是官方表述。下面就从这里展开。
它改变的是编译与运行的先后关系
先用一句话说清 Relax:它是用 Rust 实现的 Rust 编译器和 JIT 运行时,可以直接从源码运行一个 Cargo 包。它自己的 Rust 编译路径不经过 rustc、LLVM 和系统链接器,连 core、alloc、std 都从仓库携带的源码处理。
这里的「不经过 rustc」,说的是运行程序时的这条编译路径。构建 Relax 本身仍需要 Rust 工具链;涉及原生 C 依赖时,也不能把这句话扩大成整个工程永远不需要外部工具。
要看清它的位置,可以和几种常见解法放在一起:
方案 | 主要节省什么 | 开发循环还要处理什么 |
|---|---|---|
增量编译、 | 减少检查、编译或链接等待; | 改动后的运行通常仍需要构建和重启 |
rustc 的 Cranelift 后端 | 减少代码生成成本 | 单独替换后端,不会自动得到函数按需 JIT 和状态保留 |
hot-lib-reloader一类动态库热重载 | 避免重启整个宿主进程 | 通常要组织好库边界、ABI 和状态布局 |
Relax | 改变什么时候编、编哪些函数,并支持运行中替换代码 | 需要面对兼容性、运行性能和无法热替换的改动 |
动态库热重载也在尝试保留宿主状态,所以不能说只有 Relax 想绕开重启。它的不同之处,是自己掌握了从源码到运行时的整条路径,可以按函数管理编译和替换。
因此,评价 Relax 不能只问「谁编得快」。更值得问的是:从按下保存到看到结果,要多久?看到新结果的时候,程序之前的状态还在不在?
体量也值得交代。该版本 README 给出的核心规模是 438k 行 Rust、零 crates.io 依赖;贡献指南不允许给 Relax 引入第三方 crate,连 syn、quote 也不例外。这使它必须自己承担大量基础设施工作。对一支被编译时间卡住、又有真实应用需要迭代的团队来说,把编译链握在自己手里,是一种可以理解、但成本很高的选择。
拆开看:一个函数从 lazy stub 到机器码
概念上,一个尚未编译的函数可以先拥有一个懒编译入口,也就是 lazy stub。第一次调用触发编译,完成必要的类型处理、lowering、优化和发码,再把可执行入口发布到函数的 slot。
这不是说任何函数都必须等到第一次调用才可能有机器码。Relax 也有提前编译、后台工作和磁盘缓存;热启动时,已有代码可以在调用之前恢复。更准确的说法是:整个程序不必等所有可能用到的函数都完成代码生成,才允许开始运行。
从 relax run <package> 往下看,它先读取 crate 图,处理构建脚本和源码,建立名字、签名、布局、impl 等信息。运行中的程序由 Unit 等结构管理;需要编译的函数经过类型处理,lower 成 Relax 自己的 RIR,再进入优化器和后端。
RIR 使用可变的虚拟寄存器,设计上更接近 wasm locals,而不是把一切都表示成 SSA。分层编译则把「先跑起来」和「跑得快」拆开:程序可以先使用较低成本的执行层级,再让热点代码接受后台优化。后台结果必须匹配当前函数版本,过期结果不能覆盖新代码。
不过,读到这里,有一处不能照着宣传性的概括直接写:当前默认模式,并不是每个 crate 的所有检查都在程序开跑前完成。
先说类型检查。该提交的 typeck_bg.rs 写明,程序不会执行未通过类型检查的代码:应用自身的 crate 在进入 main 之前整体做完类型检查;依赖里的函数体在第一次构建前按需检查,还没用到的那部分放到后台检查。借用检查则不同:命令帮助和 jit.rs 说明,默认模式下运行不等借用检查器,结果在后台报告,所以函数可能在借用检查结论出来之前就已经运行;--check-first 才要求函数执行前先通过借用检查。热替换的补丁也一样,默认不会因为借用检查被同步拒绝,结论稍后报告。检查没有消失,但检查的时机与传统构建流程不同。本文的速度测试使用默认设置,没有开启 --check-first,因此不能把这些数字写成严格相同检查时序下的比较。
链接、重定位和入口安装由运行时处理:机器码进入运行时管理的可执行内存,再通过入口切换生效,不必调用外部链接器重新生成整个可执行文件。平台细节仍然存在,例如写入与执行权限管理,以及 AArch64 上的指令缓存同步。
README 的架构图适合帮助理解流程,实际找代码时还要看 crate 依赖。例如,下图只摘出与本文有关的依赖边,箭头表示「依赖」:
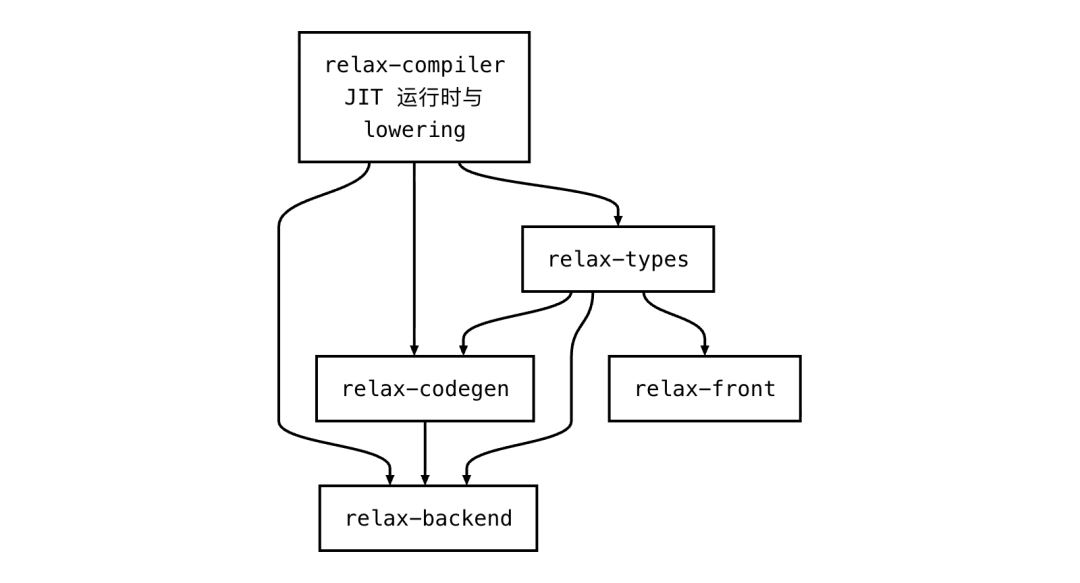
relax-types 直接依赖 codegen 和 backend;从语法树到 RIR 的 lowering 则放在 compiler 层。把概念流程误当成依赖顺序,容易找错代码。
让运行中替换代码靠得住:缓存、事务与旧代码的生命期
能边跑边换代码,听着很爽。但只要换错一次,你就会开始怀疑屏幕上的结果到底来自哪个版本。一旦起了这个疑心,热重载的价值就会打折。
缓存按内容识别输入
Relax 的缓存设计围绕输入内容的哈希展开,包括工具自身的构建身份、编译配置、函数实例、相关接口和函数体等信息。目标是让相同输入复用相同结果,而不是单靠文件时间戳猜测内容有没有变化。
它还记录编译依赖,例如哪些调用者内联了被修改的函数,以此缩小需要重建的范围。不过,「缓存设计为不会陈旧」与「任何实现路径都已经证明没有缓存错误」仍是两回事。本文测到了暖缓存复用,不把它扩大成对所有失效规则的证明。
热替换先检查,失败则保留旧版本
reload.rs 开头把一次热替换描述成事务:先解析和分类改动,准备受影响的代码,检查、编译,成功后发布补丁;失败则回退相应版本。
我用一个小程序实际试了这条路径。程序每 100 ms 输出 PID、持续递增的计数器,以及函数返回的版本号。要修改的函数很简单:
#[inline(never)]
fn revision() -> u64 { 1 }
程序运行时,把返回值依次改为 2、3、4。开启 verbose 和 reload trace 后,测得:
修改 | 保存完成到首次新输出 | 日志中的 patch 耗时 | 状态 |
|---|---|---|---|
1 → 2 | 1290.5 ms | 3.5 ms | PID 不变,计数器连续 |
2 → 3 | 223.9 ms | 1.2 ms | PID 不变,计数器连续 |
3 → 4 | 233.1 ms | 1.3 ms | PID 不变,计数器连续 |
第一次的文件监测等待 watch_ms 达到了 1216.7 ms。这个结果提醒我:补丁安装只需几毫秒,不等于从保存到结果只需几毫秒。 文件变化检测、准备工作和下一次应用输出,都在用户实际感受到的延迟里。本例还包含最多约一个 100 ms 输出周期的等待。
接着,我把返回值故意改成字符串,让它与 u64 不匹配。Relax 报出 E0308,日志明确提示 NOT applied,程序继续执行旧版本,版本号保持 4。这验证了本例的失败回滚行为,也比只看成功热替换更有说服力。
改了静态变量的类型和初始化表达式,要求重启
再往前走一步,我给静态变量使用的结构体增加一个字段:
struct State {
    count: AtomicU64,
    extra: u64,
}
同时给静态变量的初始化表达式补上 extra。这次 Relax 拒绝热替换,提示需要重启,并列出两项被保留到重启时才生效的改动:
held for a restart: main.rs:4:1: the initializer of `STATE` changed, and `STATE` already holds
  the value the old one made (an initializer runs once) -- restart the app
held for a restart: main.rs:3:1: struct `State` changed its layout, and `live_probe::STATE`
may hold values of it in the old one -- restart the app也就是说,本次保存同时触发了两项重启原因:STATE 的初始化表达式变了,可初始化只执行一次,它已经持有旧表达式算出的值;State 的布局变了,而 STATE 可能还持有旧布局的值。实验没有把这两项分开测,所以不能判断单独哪一项就足以要求重启。reload.rs 开头的说明表明,布局改动并非一律要求重启:字段改名可以直接生效,没有存活值的类型直接换新布局,尚未初始化的静态变量改初始化表达式也能直接生效。本例的两项改动都碰到了一个已经存在的值。
它没有立即自动重启。等待两秒,旧程序仍在输出,计数器继续增长。随后执行:
relax inspect 65126 session relaunch从发出指令到重启后的首条输出,约为 355.6 ms。计数器从 85 归零,但 PID 仍是 65126。
计数器归零是这个测试程序的预期结果,不是 Relax 的缺陷。session relaunch 的命令说明写的是:只有「自己支持重启」的程序才会带着状态和窗口位置重启。程序用 std::relax::restart_supported() 声明这项能力,但这个调用只是在运行时里设置一个标记;它不会自动快照全部内存,实际保留哪些状态,取决于应用或框架的保存和恢复逻辑:响应重启请求,交出要保留的状态,在新的一次运行里取回它。Makepad 应用通过 AppMain 的 restart_state / restore_state 做这件事,还可以在有未保存工作时推迟重启(见 platform/src/restart.rs)。我的测试程序既没有声明,也没有保存逻辑,所以重启后从零开始。
这说明两个边界:第一,当前版本遇到这类改动,会提示并等待主动 relaunch;第二,重启能不能保留状态,取决于程序有没有接入重启协议;PID 不变本身不能证明状态保留。 接入协议后状态能否完整恢复,以及窗口和网络连接的恢复,本次都没有测试。
还有一个工程细节也要照实记录:inspect 命令返回退出码 2,提示 link lost: connection closed by the peer。这很可能是进程重启时自然断开了控制连接;应用日志和计数器归零都表明重启已经发生。自动化如果只检查控制命令的退出码,会把一次成功的重启误判为失败。
[图片:热替换、失败拒绝和主动重启的日志摘录,可以在编辑器里插入]
图中是保存日志的只读网页截图,包含实际输出和采集时间戳,不是运行当时的终端抓拍。
旧代码的生命期与磁盘缓存是两笔账
README 把一条设计规则称为 “Code only grows”。关键含义是:可能仍被旧栈帧使用的已发布代码,不能因为新版本上线就被回收或改写;新代码发布后,后续调用再转向新入口。
这涉及代码生命期和运行时内存。磁盘缓存则是另一笔账,不能拿 target/makepad-run 的大小直接证明旧代码驻留的内存成本。
本次 JSON 校验实验使用独立缓存目录,三组 du -sk 结果分别是 47300、47292、47300 KiB,约 46.2 MiB。性能实验完成后的缓存约为 47.7 MiB。目录通过 MAKEPAD_RUN_CACHE_DIR 指定,没有使用默认的 target/makepad-run。
这些是本次小程序的磁盘占用;长时间反复热替换后的进程内存增长,本次没有测量。
实测启动:基于仓库 JSON 解析器的对比
测试机器是 Apple M1、16 GB 内存,系统为 macOS 27.0.1。rustc 版本为 1.98.0-nightly (f20a92ec0)。所有测试程序、脚本和隔离缓存都放在 Relax 仓库外,仓库源码未修改。
先构建工具:
cargo build --release --offline -p relax-runner --bin relax这一步实测用了 181.85 秒。它是构建 Relax 本身的成本,没有计入下面的应用启动时间。
测试程序调用仓库的 makepad-strict-json,解析一段包含对象、数组、字符串、整数和布尔值的 JSON,然后查询字段并重新序列化。输入是自己构造的,解析器则来自实际仓库。
先校验结果:运行 100 次后,rustc 和 Relax 都输出:
READY revision=1
VERIFY checksum=1246800
这说明本输入的程序输出和校验和一致,不等于所有 JSON 输入或所有 Rust 语义都已经验证一致。
怎么测
Cargo 一侧使用 --release --offline,该测试包配置为:
[profile.release]
incremental = true
lto = "off"
每组冷构建使用新的 CARGO_TARGET_DIR。构建完成后,测一次没有源码变化的重复构建,再改动 revision() 的函数体,测一次真正有修改的增量构建。
Relax 一侧从包目录执行:
MAKEPAD_RUN_CACHE_DIR=/path/to/fresh-cache \
  /path/to/relax/target/release/relax run --verbose json-workload
每组冷启动使用新缓存目录,紧接着用同一目录测热启动。没有清操作系统页缓存,也没有隔离桌面后台负载,所以这里的「冷」指编译产物或 Relax 缓存为空,不是整台机器完全冷启动。
Python 脚本用单调时钟测墙钟时间,并逐行记录应用输出到达的时间。最终构建和退出计时采用阻塞等待配合独立超时监控,避免带超时的进程轮询给短任务引入额外等待。首轮日志也保留在材料包里;下表采用修正计时后的三次复测。
测到了什么
测量项 | 三次中位数 | 三次范围 |
|---|---|---|
Cargo release 干净构建 | 0.722 s | 0.697–1.889 s |
Cargo 无修改再次构建 | 0.031 s | 0.030–0.032 s |
Cargo 修改函数体后增量构建 | 0.210 s | 0.207–0.228 s |
Relax 冷缓存启动到首条应用输出 | 0.548 s | 0.347–0.684 s |
Relax 热缓存启动到首条应用输出 | 0.051 s | 0.046–0.202 s |
这张表有一个必须贴着数字说明的区别:Cargo 三行只计构建,Relax 两行计启动到输出,不能直接相除得到端到端加速倍数。 而且首条输出是 READY,后面才执行校验工作。Relax 从启动到退出的冷、热中位数分别为 0.781 秒和 0.058 秒。
要比端到端,得把 Cargo 构建出的程序也跑到 READY。同一批复测里,每轮的顺序是:冷构建、无修改构建、再运行一次新构建出的程序做校验。程序在 main 一开头就打印 READY,但这三次从启动到 READY 用了 0.767、0.324、0.379 秒。新编译出的二进制在本机首次启动就要几百毫秒,后文空闲探测里新程序的启动也在 0.3 秒左右,原因本次没有查。
下表按轮次把冷构建和首次启动两段耗时相加,排除了中间用于其他测项的无修改构建,以及脚本在各步之间的间隔。这是组合估算,不是连续计时的端到端墙钟时间。
到首条输出 | 第 1 轮 | 第 2 轮 | 第 3 轮 | 中位数 |
|---|---|---|---|---|
Cargo:冷构建与首次启动的分段合计 | 2.656 s | 1.021 s | 1.101 s | 1.101 s |
Relax:冷缓存启动(连续计时) | 0.548 s | 0.347 s | 0.684 s | 0.548 s |
在这组分段比较里,这个小程序上按中位数 Relax 的用时约为 Cargo 的一半;第 1 轮 Cargo 的冷构建明显偏慢,拉大了那一轮的差距。热的一侧缺少对应数据:Relax 热缓存复跑到 READY 是 0.051 秒,但本次没有另测已经运行过的原生二进制再次启动,因此缺少与 Relax 暖缓存复跑严格对应的数据。这些都是一个小程序上的结果(主程序 30 行,连同依赖的 JSON 解析库不到 900 行),不能外推到 README 里那种几分钟的大型项目。
复测第二组的内部阶段日志,更能说明暖缓存省在哪里:
Relax 阶段 | 冷缓存 | 热缓存 |
|---|---|---|
加载与解析 | 182.2 ms | 22.0 ms |
名字解析 | 11.9 ms | 0.0 ms |
签名收集 | 48.8 ms | 0.0 ms |
应用检查 | 4.3 ms | 0.0 ms |
内部计时到调用 | 268 ms | 40 ms |
这些是 Relax 自己的阶段计时,与外部脚本的完整墙钟口径不同。它们说明,热启动主要省掉了前端结果的重复建立和已有代码的重复准备。
对这个小程序,我不能说 Relax 消除了几分钟等待:Cargo 干净构建的中位数只有 0.722 秒,但最慢一次达到了 1.889 秒。冷构建和热启动都有明显波动,不能只挑最快一次。更有价值的对比,是下面的运行性能,以及程序保持运行时的修改反馈。
运行性能:这个工作负载约慢 13%,接近 README 报告的部分结果
README 对运行性能的说法相当克制:优化后的代码仍比 rustc --release(针对本机 CPU)慢,最常 profile 的几个工作负载耗时为 rustc 的 1.14–1.26 倍,密集数值循环因为还没有向量化,耗时为 rustc 的 2.3 倍;更广泛的 18 个工作负载这周测得更慢,作者正在查原因,数字还在重测。因此,我把它们当作作者特定环境下的结果,不当成任何 Rust 程序都适用的保证。
自己的测试仍然使用同一个 JSON 输入。每批执行 100000 次解析、字段查询和序列化,每个进程执行 20 批;批次耗时由程序内部的 Instant 测量,避免把构建和启动混进运行时间。原生 CPU 版本通过 RUSTFLAGS="-C target-cpu=native" 构建;Relax 通过 MAKEPAD_RUN_O3_PROGRESS 输出后台优化进度,测量脚本在收到每批结果时记录该进度。
首次 Relax 进程还在生成和优化热点代码,没有纳入稳定态比较。我选取后两次进程各自最后 10 批,共 20 个样本。选中批次的 O3 待处理数均为零,缓存记录中包含 58 条 O3 代码,日志也没有报告存在无任务待处理却仍停在 O3 以下的热点函数。
执行方式 | 每批耗时中位数 | 样本范围 |
|---|---|---|
rustc | 123.879 ms | 123.325–129.625 ms |
rustc | 124.171 ms | 123.028–131.598 ms |
Relax 热缓存、优化稳定后 | 140.541 ms | 139.597–148.088 ms |
所有批次的校验和都是 1246800000。按这些中位数计算,Relax 耗时约为两种 rustc 构建的 1.13 倍。两种 rustc 配置之间的微小差异,不值得在这组样本里解释成谁更快。
这个结果接近 README 报告的部分结果,但不在 1.14–1.26 倍的区间内,也不能据此说 README 的数字偏保守:我的机器是 M1,不是 README 用的 M4 或 Zen 4,工作负载也不同。而且这只是一个工作负载,适用范围更窄:它测的是解析、查字段、分配和序列化的组合工作负载,不是完整业务应用,也不是纯粹单函数的后端发码对比。矩阵运算、图像处理和一帧渲染会怎样,需要另外测。
我对性能的判断因此是:这条 JSON 热路径上的开销可以接受,但拿它调发布版性能,仍然要用 rustc 构建再确认。
语义兼容性:文档列出的宏冲突,这次没有复现
独立实现 Rust,意味着 Relax 需要不断与 rustc 对齐。贡献指南的规则很直接:有分歧时,以 rustc 为准。
KNOWN_GAPS.md 第一条描述了一个同名宏问题:两个过程宏 crate 都导出名为 Who 的 derive,另一个 crate 可能调用到错误的实现。我按文档搭了四个 crate:
crate | 内容 |
|---|---|
a_mac | 定义 |
b_mac | 定义同名的 |
lib_b | 依赖 |
app | 依赖 |
两个过程宏只使用标准的 proc_macro,没有引入第三方 crate。
文档描述的差异是 rustc 输出 app=a b=b,Relax 输出 app=a b=a。但在本次提交上,实际结果是:
cargo run --release:  app=a b=b
relax run:           app=a b=b
我又用独立缓存,以默认运行行为和 --quiet 再跑了一遍,结果仍然一致。pmhost 跟踪日志显示两个宏分别注册,并在对应调用点执行,没有使用源匹配的原生快捷实现。
所以,这一段不能继续写成「我亲手证明它会悄悄展开错宏」。准确的结论是:文档给出的这个复现方式,在本次提交和环境中未重现。 代码里有一个迹象支持「文档已经落后于代码」:本提交的 front/src/macro_reg.rs 有一个 has_derive_collision,注释写的是「被不同依赖共用的裸名 derive 需要按调用点解析」,builtins.rs 在派生宏解析时会调用它。这段代码由 11 月 5 日的提交 9308c094(#1389)引入,而 KNOWN_GAPS 第 1 条直到本提交都还在。不过这只是迹象:我没有逐行确认它覆盖了文档描述的全部情形,也可能还需要其他触发条件;本次实验不足以宣布所有相关问题都解决了。
这反而强化了我对这类工具的使用原则:已知问题清单提供线索,最终还要把自己的输入交给两边运行,比较结果。文档中的风险和实测中的错误,不是同一个证据等级。
给 agent 算一笔小账:首次修改的延迟,与修改前等了多久有关
回到开头的 agent 场景。我没有团队每天构建次数的遥测,也没有真实 token 计费数据,所以没有填写「一天编几百次、节省多少 token」这种估算。
我能做的是让自动化脚本执行一个固定的小任务:在同一个持续运行程序里,把版本号依次改成 2、3、4,并确认新输出出现。
这是一组独立于前面诊断实验的测试。Cargo 使用该测试包的默认 release 配置,每次构建成功后停止旧程序、启动新程序;Relax 使用 --quiet,让程序一直运行。测量从源码保存完成到首次观察到新版本输出,包含相应的构建、控制和启动步骤。
首轮只跑了一次:
修改 | Cargo 构建并重启 | Relax 热替换 |
|---|---|---|
第一次 | 512.4 ms | 1377.4 ms |
第二次 | 656.9 ms | 225.2 ms |
第三次 | 494.4 ms | 217.0 ms |
三次反馈等待合计 | 1.664 s | 1.820 s |
合计不含初始启动、模型思考和修改之间主动安排的等待。注意,这个持续运行测试包没有采用前面 JSON 实验的 release 增量配置,两组实验不能混成一个口径。
乍一看,Relax 后两次明显更快,但首次热替换较慢,三次合计没有省时间。不过这个首次的 1.38 秒值得追问:脚本在程序第一次输出后只等 1 秒就做第一次修改。前面诊断实验也是这样,那次第一次修改的 watch_ms 是 1216.7 ms,之后几次都在 190 ms 左右。慢的究竟是「第一次修改」本身,还是和修改前等了多久有关?
于是我重跑了这组实验:从收到程序首条输出开始计,第一次修改前分别等 1 秒(复现首轮条件)和 10 秒,每种条件重复 3 次,Cargo 与 Relax 交替进行,每次 Relax 运行都用新的缓存目录,并打开 reload trace 记录 watch_ms。下表是三次重复的中位数:
条件 | 第一次 | 第二次 | 第三次 | 三次合计 |
|---|---|---|---|---|
Cargo,首条输出后等 1 秒 | 508.5 ms | 522.8 ms | 516.7 ms | 1.570 s |
Relax,首条输出后等 1 秒 | 1322.0 ms | 217.8 ms | 214.8 ms | 1.745 s |
Cargo,首条输出后等 10 秒 | 1207.4 ms | 480.9 ms | 511.3 ms | 2.169 s |
Relax,首条输出后等 10 秒 | 252.0 ms | 223.4 ms | 219.0 ms | 0.696 s |
「三次合计」取的是三次重复各自合计的中位数,不是三列中位数相加,也不含第一次修改前主动等待的 1 秒或 10 秒。
我从中读出三点:
- Relax 的慢首次,等 1 秒时三次都出现,等 10 秒时没有出现。
等 1 秒时,首次是 1288.8–1393.3 ms,
watch_ms是 1219.6–1293.5 ms;等 10 秒时,首次是 219.2–264.8 ms,watch_ms约 185–189 ms,和后续修改相当。本机本例的结果支持「首次修改的延迟与修改前的等待时间有关」,但只测了 1 秒和 10 秒两个条件,尚不能确定时间阈值,也不能确定具体机制(文件监视的建立、后台类型检查、分层优化都有可能),本次没有拆开测。 - 意外的是,Cargo 在等 10 秒时,第一次也变慢了
(1011.7–1260.9 ms)。主循环没有分别计时构建、停止旧进程和启动新进程,所以我另做了一组独立探测,每种条件 3 次:构建后空闲 1 秒再改再构建,增量构建是 156–189 ms;空闲 10 秒后是 851–1028 ms;新程序从启动到首条输出,两种条件下都在 285–327 ms。按这组探测,差异主要出现在构建这一步,但原因没有查明。随后验证复现脚本时,又出现了一个不能略去的结果:空闲 1 秒的第一轮,构建用了 1135.0 ms,启动到首条输出用了 715.9 ms;另外两轮构建分别为 285.6、193.5 ms。空闲 10 秒的三轮构建则为 976.0–1061.7 ms。也就是说,慢构建不只出现在等待 10 秒的条件下,不能把空闲时长认定为已经隔离出的原因。这次脚本验证的六条记录单独收入材料包,不并入上面的主循环表格。
- 第二、三次修改
:各组中位数 Relax 为 214.8–223.4 ms,Cargo 为 480.9–522.8 ms;全部单次样本 Relax 为 210.4–233.2 ms,Cargo 为 479.4–613.5 ms。初次独立探测的 1 秒等待组中,Cargo 修改后的构建不到 0.2 秒,新进程到首条输出约 0.3 秒;后续脚本验证并非每轮如此。这些都是独立测量,不是主表数字的直接分解。
所以首轮那句「三次合计没省时间」应限定到具体实验条件:在上述主循环复测中,首条输出后等 1 秒组仍然没有缩短合计等待。等 10 秒时,Relax 三次合计约 0.70 秒,Cargo 约 2.17 秒(均不含修改前主动等待的 10 秒);即使只看第二、三次修改,各组中位数 Relax 的用时也不到 Cargo 的一半。对 agent 来说,程序刚启动就改代码的那一次未必快;程序持续运行、反复修改时,差距才显出来。样本仍然很小,每种条件 3 次,而且只有一个小程序,不能外推到大型应用;在大型应用上,Cargo 的增量构建和链接会贵得多,Relax 的补丁准备也可能变重,两边都要另测。
它确实保留了状态。Cargo 每次新输出的计数器都是 0;Relax 的计数器一直递增。如果恢复程序状态需要登录、打开文件、加载场景或手动操作,这部分收益可能比编译时间更重要。但这些恢复成本没有在本次实验里测量,不能先替它加到收益上。
日志体积在首轮中做了记录:每次只保留一条确认结果的标准输出,以及构建和诊断信息,Cargo 为 568 字节,Relax 为 461 字节。两边包含的信息并不完全对称,Cargo 初次构建输出未计入,Relax 的启动诊断则计入。这只能算采样反馈体积,不能换算成模型的真实上下文量,更不能直接宣称节省了相同比例的 token。
现在适合什么,不适合什么
经过这几组测试,我对 Relax 的判断更具体了:它能在小程序里实现函数体热替换、保留状态、拒绝错误修改,遇到无法热替换的改动(本例同时改了一个已存在静态变量的类型布局和初始化表达式)也会说明需要重启的原因。但首次反馈、运行性能、检查时机和控制工具行为,都值得单独观察。
工程成熟度也要放在版本背景下看。该提交的贡献指南明确说没有 GitHub CI;仓库里的内部验证记录,不能直接等同于外部用户可依赖的公开 CI。relax 二进制的源码注释还把它称为内部开发工具,产品入口是 makepad run。与其根据「公开了几天」判断成熟度,不如把这些实际交付边界写清楚。
值得尝试 | 暂时不应据此作保证 |
|---|---|
开发内循环,希望修改后继续观察已有状态 | 所有修改都能热替换、所有状态都能保留 |
构建和状态恢复成本高,愿意先做兼容性验证的应用 | 任意项目都会比 Cargo 更快 |
研究 Rust 编译、JIT、缓存与热替换的人 | 与 rustc 在全部语言和库行为上完全一致 |
把 Relax 当作开发期的另一条执行路径 | 直接用其结果替代发布构建和完整测试 |
有几条实践细节也值得留下:
- Relax 本身使用 release 构建。
本机首次构建工具用了约 3 分钟,应与应用反馈时间分开核算。
- 运行时传包名。
从包目录执行
relax run json-workload,不要把包名和目录路径混用。 - 保持工具与标准库源码匹配。
运行时会读取对应 checkout 的 std;对比提交时,用
MAKEPAD_RUN_STD指向各自版本,并隔离缓存。 - 记录检查设置。
默认模式与
--check-first的检查时序不同,性能报告不能省略这项条件。 - 记录平台和测量范围。
本文只实际测试了 macOS arm64;不能把结果延伸到其他平台或未测应用。
如果痛点只是短小项目的构建慢,先用好增量编译、cargo check 和合适的链接器,往往更省事。如果真正昂贵的是「重启后把程序恢复到刚才的状态」,Relax 的价值才更值得认真测。
Rust 的等待,也许该换一种算法
读完源码再做实验,我仍然认同 Relax 的方向,但理由比一开始更克制了。
它把开发反馈拆成几件可以分别优化的事:按需生成代码、复用已有结果、后台优化热点,以及把支持的改动装入仍在运行的程序。JIT 和热重载并不是新概念,难的是把它们放进 Rust 的语言、类型、布局和运行时约束里。
本次实验得到的结论也有边界:JSON 工作负载稳定后约慢 13%;函数体热替换保留了计数器状态;错误修改被拒绝;同时改动一个已存在静态变量的类型布局和初始化表达式,两项都被报告为需要主动重启(实验没有分别隔离),而本例程序没有接入重启协议,重启后状态清零;文档里的同名宏错误没有复现;首条输出后等 1 秒就修改时,首次热替换要 1.3 秒左右,三次合计不比 Cargo 短;等 10 秒时,三次合计约 0.70 秒,Cargo 约 2.17 秒(不含修改前主动等待的时间),时间阈值和机制尚未确定;独立的 Cargo 构建探测在后续复验中也出现了等待 1 秒仍较慢的样本,说明观察到的批次差异不能直接归因于等待时长。
因此,我更愿意把使用方式写成一个有条件的分工:开发时尝试用 Relax 缩短反馈、保留状态,发布时仍用 rustc 构建并完整测试。 这不是说 Relax 上跑通就能少测,而是多了一条值得验证的开发路径。
最后的问题也应该改得具体一点:
在你自己的应用里,保存到新结果能快多少?哪些状态确实保住了?哪些改动仍然要重启?为此付出的运行开销和兼容性成本,是否值得?
这几笔账只能在自己的应用里算。我的小实验说明这条路值得继续试,也说明不能只挑它最快的几次结果。
参考
- relax[1]
参考链接
本文转载自微信公众号「觉学社」,查看原文。版权归原作者所有,如有侵权请联系删除。