NeurIPS 2026 Oral | MIT等提出ELD:从能量分布破解合成数据预训练质量预测
原创 CV君 2026-11-14 00:01 江苏
能量直方图重塑预训练数据
在计算机视觉领域,利用生成模型或程序化生成的合成数据扩展预训练规模已成为重要方向。然而,现有的数据筛选与评估标准(如基于特征一阶与二阶矩的 FID、LPIPS 变化度或特征空间召回率 Recall)往往只能部分解释下游表征质量的优劣——两个 FID 接近的合成数据集,在自监督下游任务中的微调与迁移表现可能相差悬殊。针对这一痛点,麻省理工学院(MIT)与慕尼黑工业大学(TUM)的研究团队在发表于 NeurIPS 2026(Oral)的论文中,提出了基于真实图像能量分布(Energy Distribution,即在归一化真实图像密度模型下的负对数概率分布)的全新审计与筛选范式。
为量化这一物理与统计特性,研究团队提出了能量层级分布距离(Energy-Level Distribution Distance,简称 ELD)及其分位数标定版本 pELD(Percentile ELD)。ELD 的核心思想在于:自然图像在概率密度曲面上并非聚集于单一的“典型似然度”,而是横跨由低能量/高似然的平滑稀疏场景到高能量/低似然的致密纹理细节所构成的宽泛分布。有效的合成预训练数据不应仅仅盲目追求平均似然度的最大化(即单一样本的高逼真度),而必须完整覆盖真实图像的能量能谱。研究表明,ELD 能有效暴露 FID 等特征指标无法察觉的结构性分布失配,不仅在线性探测与鲁棒性评估中展现出远超传统指标的预测精度,更可直接指导离线数据的重采样与混合比例优化。
背景与动机:特征矩无法约束概率能量分布
在自监督视觉表征学习中,从业者通常依赖模拟仿真、分形噪声或扩散生成模型来合成图片。现有评估体系多以表征空间距离为准绳:FID 假设 Inception 特征服从高斯分布并计算均值与协方差矩阵的瓦瑟斯坦距离,Recall 度量数据覆盖流形,LPIPS 衡量感知差异。然而,这类度量本质上是对特征低阶矩的压缩概括,完全忽略了样本在自然图像概率曲面上的真实坐标。
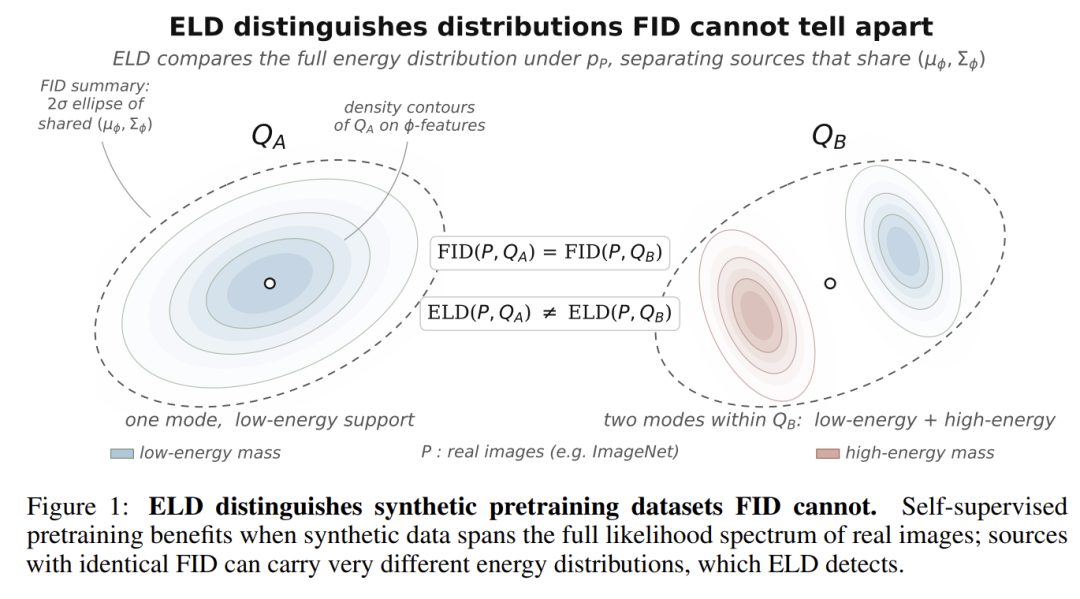
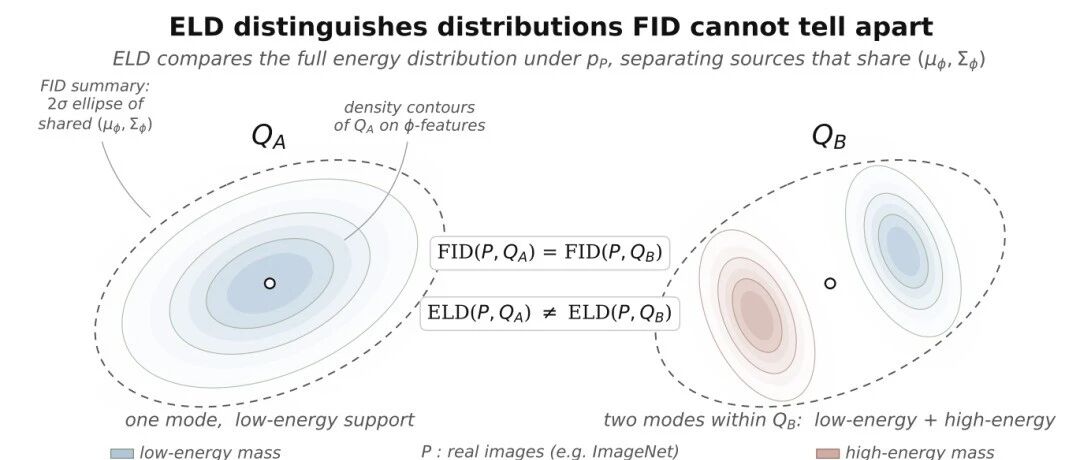
从理论机制来看,特征空间的矩统计量与图像在真实分布下的能量结构是严格解耦的。如上图所示,在特征空间中,数据集 与 拥有完全一致的一阶均值和二阶协方差椭圆,对任何固定的真实参考分布 而言,其 。然而将它们映射至归一化真实密度模型 的能量轴上时:
的支撑集高度集中在单一的低能量/高似然区域;
则同时包含低能量主体与高能量细节两种模式,能够覆盖更完整的真实能谱。
数学上,即使构建均值为 0、方差为 1 的特征分布,其样本在非线性密度模型(例如 )下的对数似然也可以呈现完全不同的单点退化分布或两点离散分布。盲目依靠特征指标或单纯最大化平均似然度,极易导致生成数据向少数最典型的高概率模态聚集,抹去自然界中真实存在的复杂高频变异,最终削弱特征学习的泛化潜能。
方法详解:ELD度量与三大能量失配机制
ELD 与 pELD 的数学定义
设真实图像分布为 ,其对应的已归一化连续真实图像密度模型为 。对于任意图像 ,其真实能量定义为负对数似然:
该值越小表示图像在真实模型下越具代表性(高似然),值越大则意味着越罕见或偏向低似然噪声。将真实数据集 与合成数据集 的样本分别输入该评分器,得到的推前测度 与 分别记录了二者在一维能量轴上的占有率分布。
研究给出的能量层级分布距离(ELD)定义为两组一维能量分布间的 Wasserstein-1 距离:
在一维空间中, 严格等价于两组经验累积分布函数(CDF)之间的绝对差分积分,可直接通过对标量能量值排序快速计算,不仅数学性质良好,且天然规避了 KL 散度在支撑集不匹配时发散的缺陷。
由于原始能量受具体密度估算器尺度的影响,研究团队进一步引入了分位数标定版本 pELD。设真实图像能量分布的 CDF 为 ,将任意样本的能量变换为其在真实能谱中的分位排名 。根据概率积分变换,真实分布的分位映射结果为标准均匀分布 。于是 pELD 定义为:
pELD 取值严格限定在 之间,且对能量评分函数的任意严格单调递增变换保持不变,有效剥离了绝对尺度的影响。论文选用的评分器 为 Guth 等人提出的基于双重得分匹配训练的 ImageNet 连续密度估计模型。
合成数据的三大能量失配机制
利用该度量对广泛的合成数据集进行能量审计后,研究梳理出三类典型的分布失配状态:
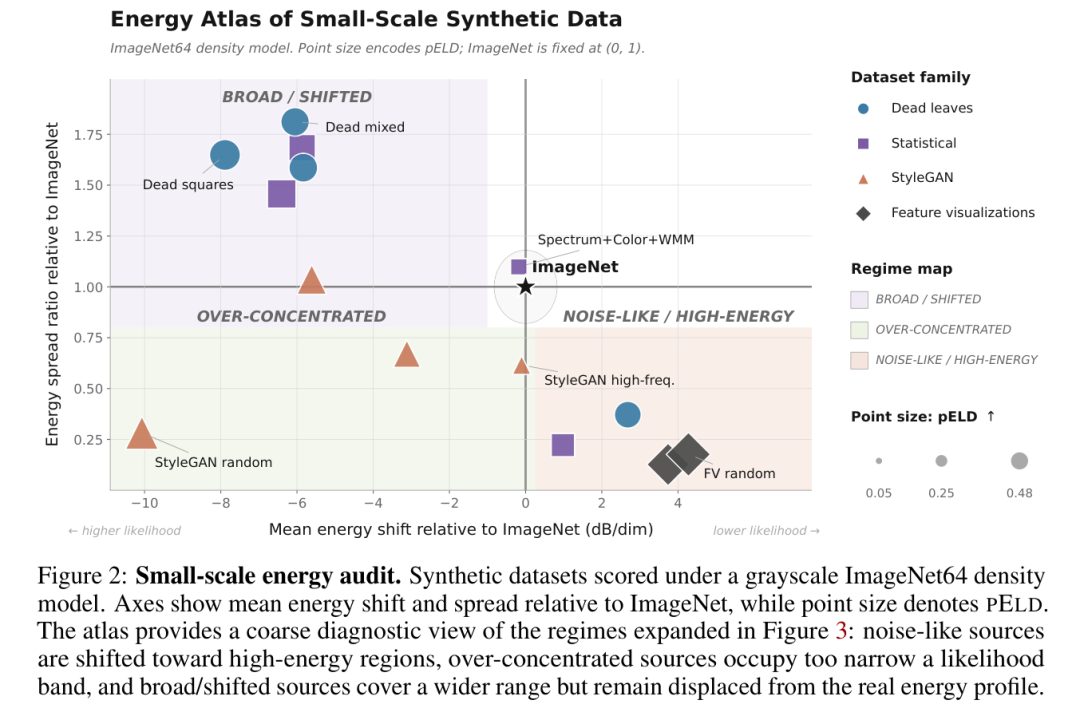
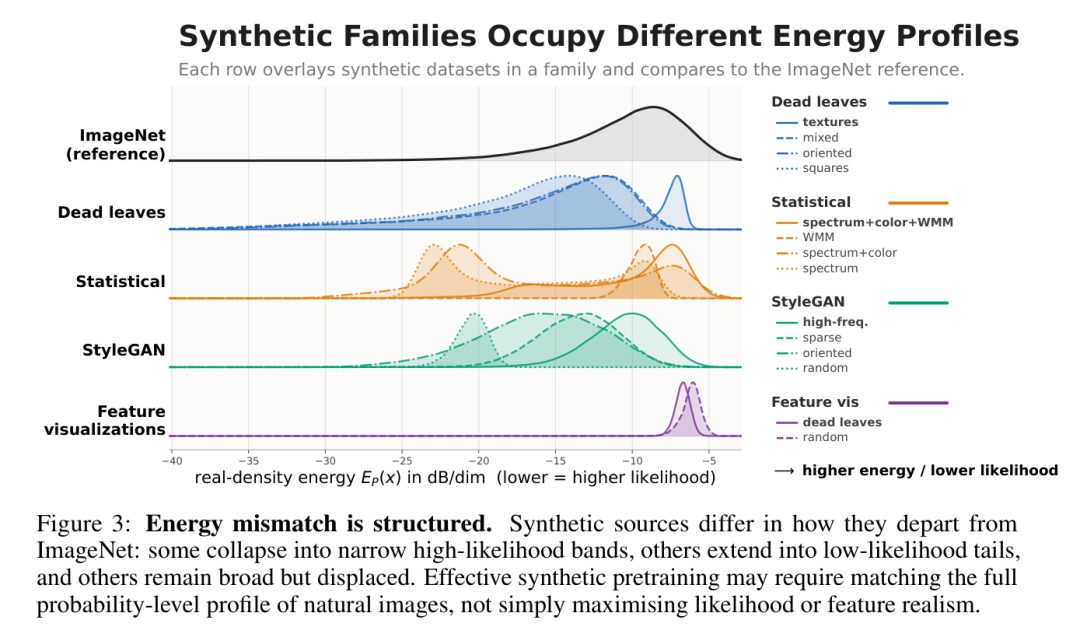
结合图 2 与图 3 的能量剖面图,具体分类如下:
噪声型(Noise-like / High-energy):如高斯噪声、Perlin 噪声及 FractalDB 等。其能量均值明显向右侧偏移( 显著大于 0),大量概率质量堆积在极低似然的长尾端,真实模型视其为极不可信的噪点模式。
过度聚集型(Over-concentrated):如高无分类器引导尺度(High CFG)的扩散模型生成样本。其能量展宽比 显著偏小,虽样本单体质量精美、似然度极高,但能量剖面坍缩在一个狭窄的高概率区间内,欠缺自然界必要的纹理异质性。
宽域但偏移型(Broad / Shifted):如 StyleGAN3 或特定程序纹理。尽管其能量分布具有一定的展宽,但整体形态或均值位置与自然图像的真实峰值发生显著脱节。
实验与结果:超越传统指标的下游性能预测力
研究团队设计了涵盖现代 ViT 与经典 CNN 两大维度的自监督预训练评测,重点考察 ELD 对下游表示泛化与鲁棒性的预测表现。
DINO / ViT-S 自监督基准
在以 ViT-S 为主干、DINO 为自监督学习算法的实验中,包含程序噪声、GAN、不同 CFG 参数的扩散模型及混合数据等 9 类代表性合成集。
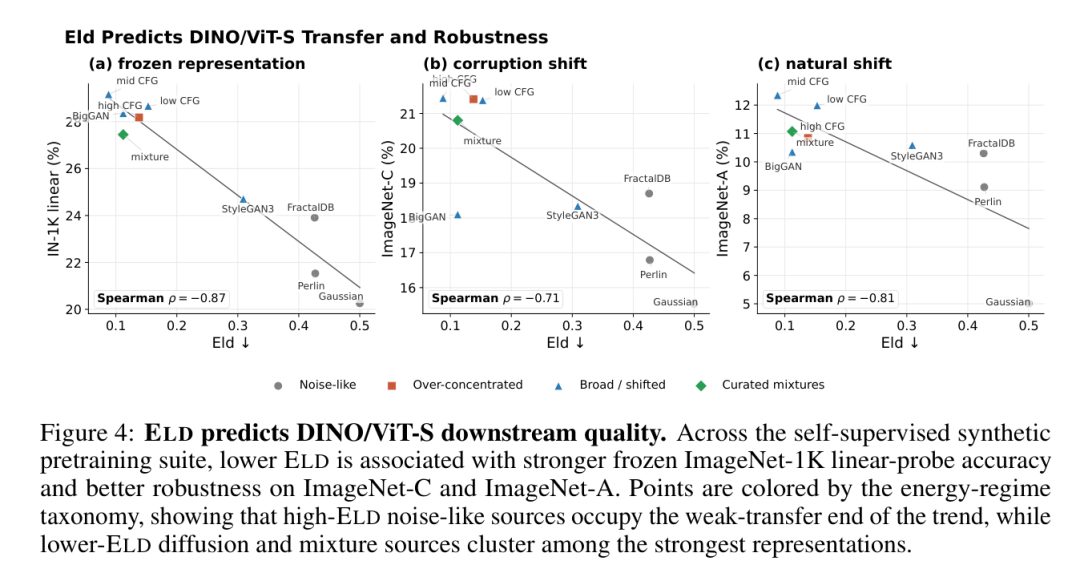
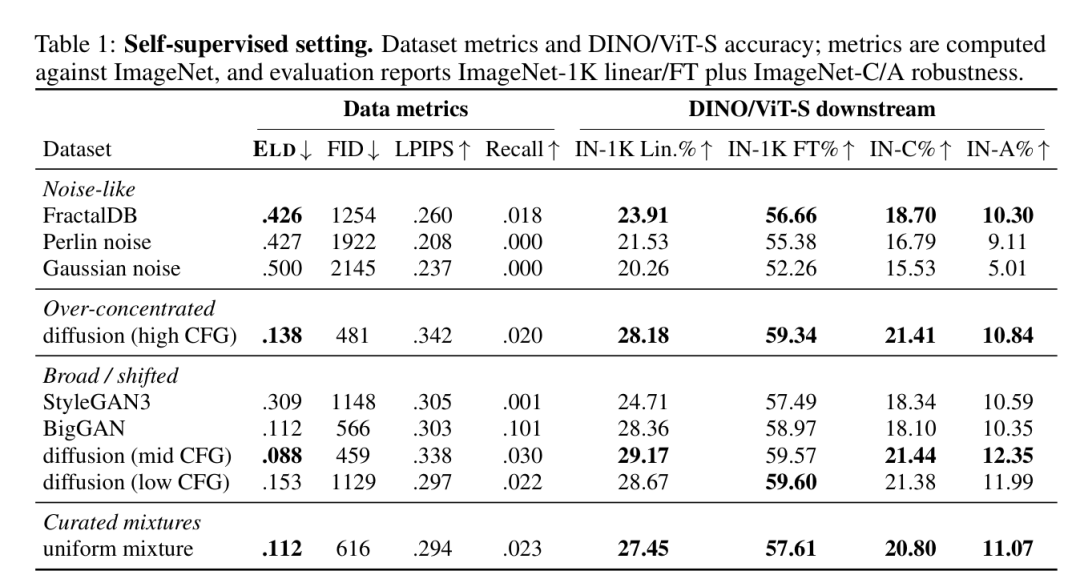
如图 4 与表 1 所示,ELD(此处均采用 pELD 报告)与下游多项核心性能呈现出强烈的负相关性:
冻结线性探测准确率:与 ImageNet-1K 线性评估准确率呈现极高的负相关(Spearman ,);
全模型微调与鲁棒性:ImageNet-1K 全参数微调准确率 ,在抵抗破坏性扰动的 ImageNet-C 上 ,在自然分布偏移的 ImageNet-A 上 。
在具体数值上,能量匹配最佳的中等引导尺度扩散模型(mid CFG)的 ELD 仅为 0.088,其线性探测精度达到最高的 29.17%,ImageNet-A 准确率达 12.35%;而噪声型数据(如 Gaussian Noise)的 ELD 高达 0.500,线性精度仅为 20.26%,在 ImageNet-A 上仅有 5.01%。
留一预测误差对比
为避免传统指标受某些极端噪声集的虚假相关性驱动,研究采用留一数据集交叉验证(Leave-one-dataset-out OLS 回归)来严格对比各指标的下游预测误差(MAE):
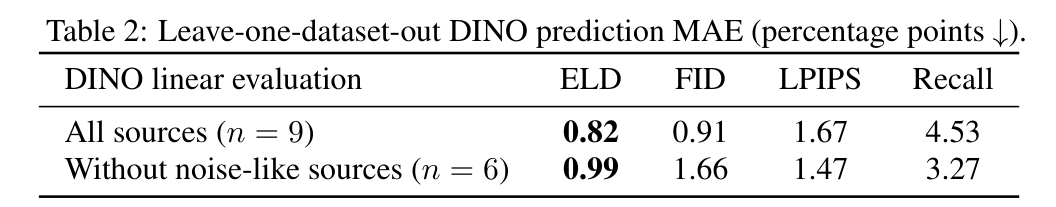
由表 2 可见:在纳入全部 9 组数据时,ELD 的预测 MAE 仅为 0.82 个百分点,优于 FID(0.91)、LPIPS(1.67)与 Recall(4.53)。更为关键的是,当剔除高斯、Perlin 和 FractalDB 等 3 组显而易见的噪声数据后(),FID 的 MAE 迅速恶化至 1.66,而 ELD 的 MAE 仍稳定保持在 0.99 个百分点,展现出扎实泛化的预测能力。
经典小规模 CNN 预训练(Learning-to-See)验证
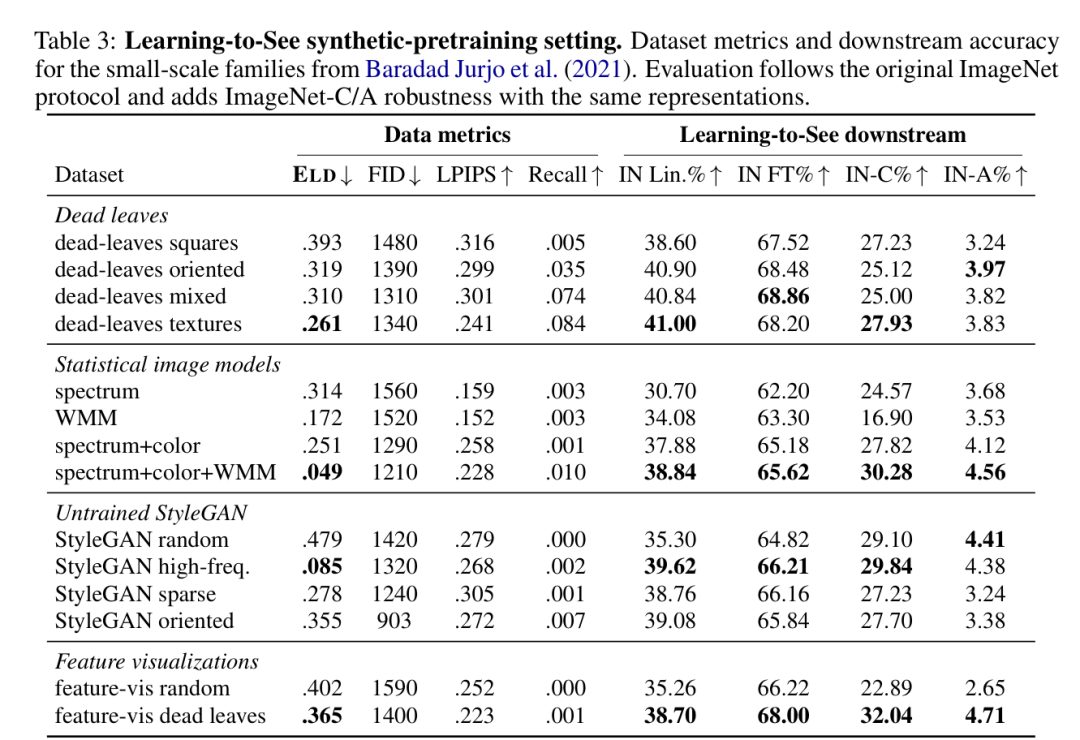
在 Baradad 等人经典 CNN 架构及对比学习任务的设置下,表 3 进一步证实了该结论的普适性:
在统计图像模型(Statistical image models)家族内,
spectrum+color+WMM拥有最低的 ELD(0.049),其下游线性探测(38.84%)、微调(65.62%)、ImageNet-C(30.28%)和 ImageNet-A(4.56%)均位列该家族第一;在未训练的 StyleGAN 家族中,高频变体(high-freq.)具有最低的 ELD(0.085),其线性迁移率达 39.62%,在家族内达成相关性 至 的严格反向单调性。
采样与神经评分器稳定性
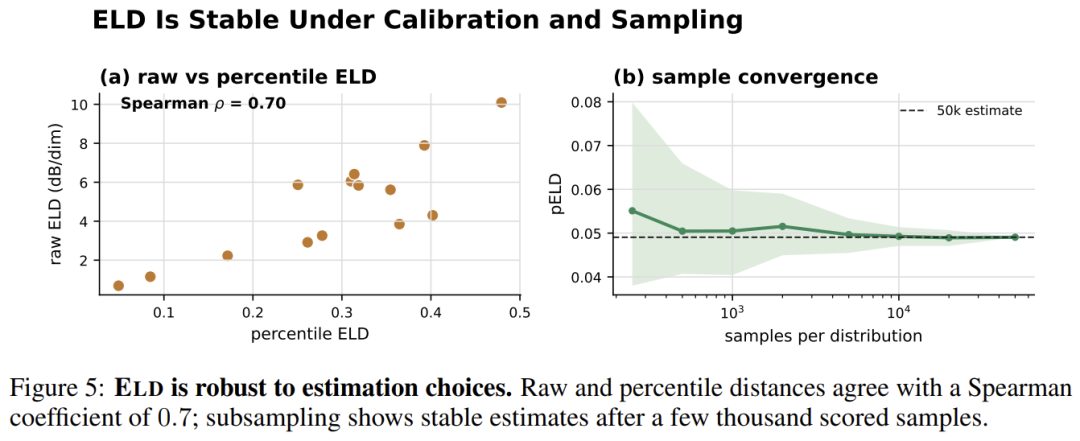
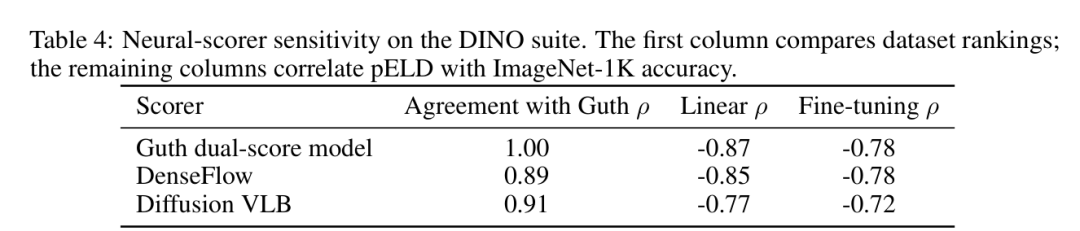
针对度量的工程鲁棒性,图 5 与表 4 的消融实验显示:
样本量收敛迅速:抽样只需数千张图像即可使 ELD 估计达到高度稳定;
跨神经评分器的一致性极强:换用 DenseFlow 或基于扩散变分下界(Diffusion VLB)的密度评分器时,与原 Guth 模型的排序一致性达 ,线性探测相关性均在 至 之间;
附录消融证明,基于 ResNet 特征或 DCT 低频系数的简易高斯模型与真实 pELD 的相关系数仅为 ,证实 ELD 所度量的并非简单的低阶频域统计差异或泛化表征异常值。
数据清洗实践:基于能量直方图的离线重采样
ELD 不仅是一种诊断度量,还提供了一套具有可操作性的数据重塑原则。既然真实图像的能量分位数在理论上服从标准均匀分布,那么在对庞大的合成数据池进行采样时,便不应盲目“筛选似然度最高的前 张样本”,而应依据其能量分位数将其划分为若干区间,实施能量直方图均衡化(ELD-guided Selection)抽样。
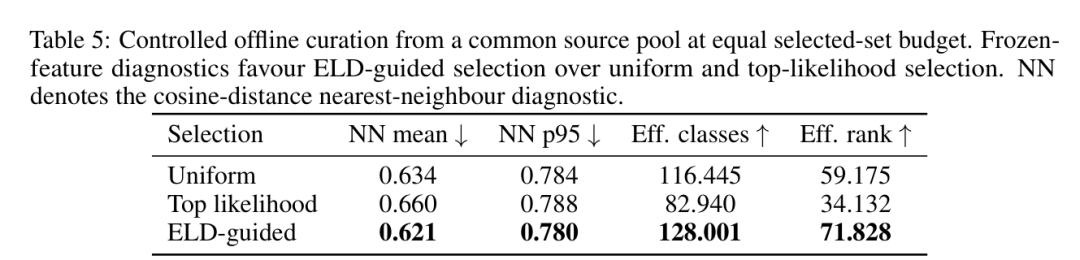
研究在覆盖 BigGAN、StyleGAN3 及三种扩散设置的候选数据池上进行了等量样本抽取的对比实验(表 5):
最高似然筛选(Top likelihood):单纯保留最低能量样本,导致有效类别数(Eff. classes)由随机均匀采样的 116.445 急剧跌落至 82.940,特征空间有效秩(Eff. rank)从 59.175 腰斩至 34.132,发生严重的表征坍缩;
ELD 引导筛选(ELD-guided):通过拉平能量分位数直方图,表征最近邻余弦距离(NN mean)降至最低的 0.621,有效类别数提升至 128.001,有效特征秩显著跃升至 71.828。
整个过程全程无需重新训练任何生成器,完全依靠离线缓存的能量标量即可完成高效配比优化。
写在最后
这项研究明确指出了一个被长期忽视的视角:合成图像在自监督预训练中的价值,不仅取决于单张样本的像素保真度或宏观的特征分布矩,更取决于其在真实数据概率曲面上所映射出的“能量分布轮廓”。真实世界的数据具有结构内在的多样性——既包含平滑简单的高概率图景,也包含繁复密集的低概率纹理。
通过将一维 Wasserstein 距离与归一化图像密度模型相结合,ELD 将以往模糊的“数据合成质量”转化为一个可量化、可预测且可直接指导采样的物理标尺。这对于从事生成式数据合成、跨模态多模态预训练数据清洗的研究者与工程师而言,无疑提供了崭新且实用的技术路线。
论文标题: Shaping Useful Noise: Energy Distributions Predict Visual Pretraining Quality
作者机构: 麻省理工学院、德国慕尼黑工业大学
代码仓库: https://github.com/chinglamchoi/shaping-useful-noise(已开源)
入选会议: NeurIPS 2026 Oral
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。