TPAMI 2026 华科&清华等发布强化学习扩散模型全景综述:从语言、多模态到具身与科学计算
原创 CV君 2026-11-15 23:26 江苏
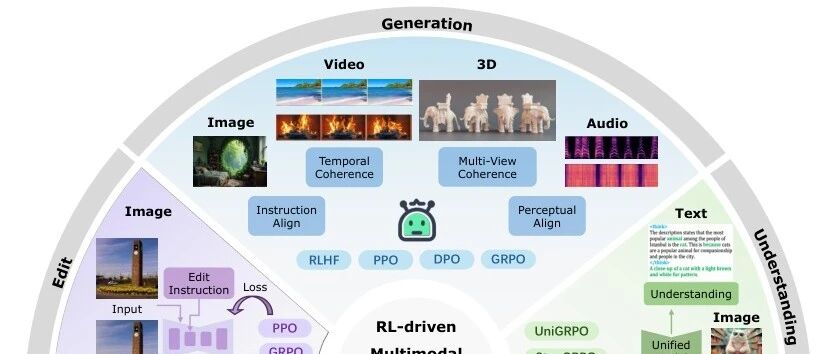
扩散模型的强化进阶之道。
在生成式人工智能的发展历程中,扩散模型(Diffusion Models, DMs)曾凭借其建模复杂连续数据分布的数学优雅性,迅速确立了在图像、视频及音频合成领域的核心地位。然而,传统扩散模型长期以来遵循的是一种纯粹数据驱动的“开环模仿学习”范式——通过预训练与监督微调(SFT)最小化均方误差(MSE)重建损失。这种依赖静态数据拟合的机制,使得模型在面对长程组合推理、多约束严格遵从、细粒度人类主观偏好以及自主路径规划等复杂任务时,暴露出不可忽视的性能瓶颈。
正如大语言模型在后训练阶段通过强化学习(Reinforcement Learning, RL)实现智能跃升一样,将强化学习与扩散模型深度融合(RL-driven DMs),正推动生成式系统从“开环静态模仿”向“闭环面向经验的目标决策”发生深刻范式转变。由华中科技大学、北京理工大学、清华大学、上海交通大学以及上海人工智能实验室等多家顶级研究机构联合推出的 26 页长篇综述 《Reinforcement Learning-driven Diffusion Models: Language, Vision, and Beyond》,已被计算机视觉与模式识别顶刊 IEEE TPAMI 接收。该综述对这一处于爆发期的交叉前沿进行了系统性的理论解构与前沿梳理。
本文将全面拆解该综述呈现的技术全景、核心数学桥梁、各模态关键突破及未来落地所面临的系统级瓶颈。
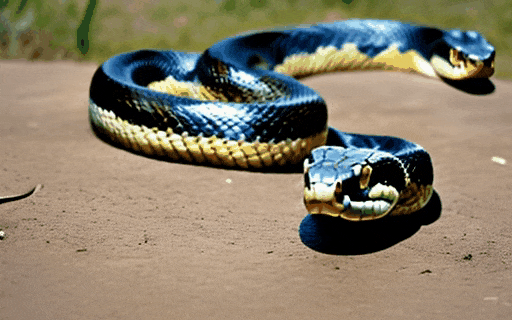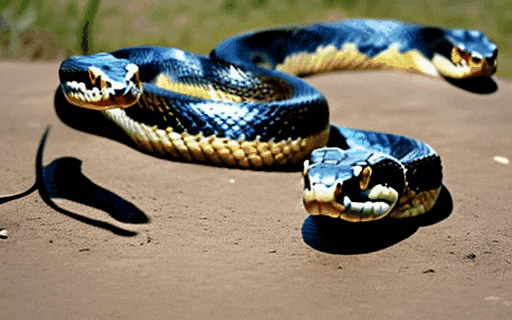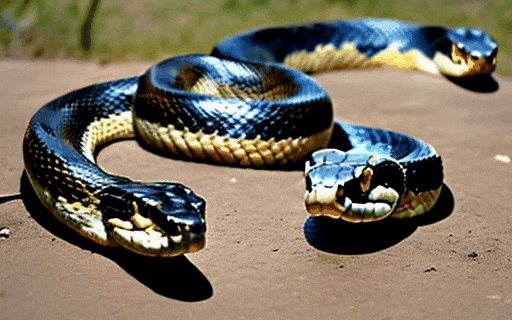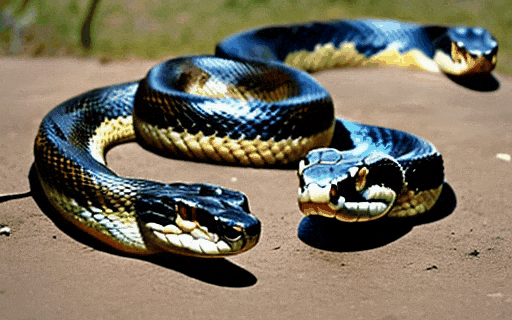
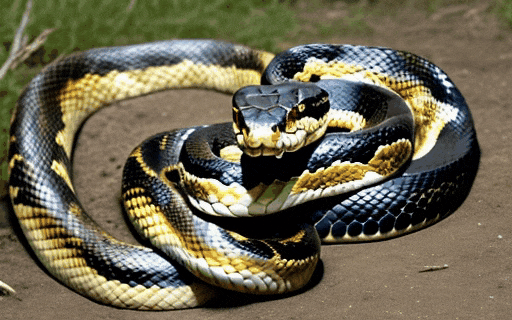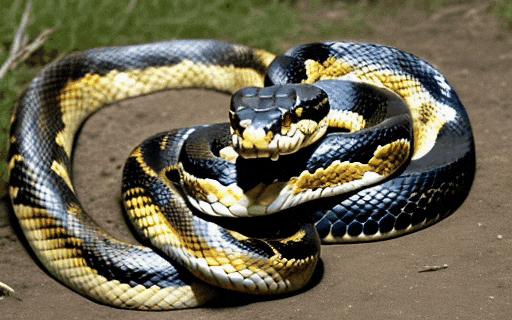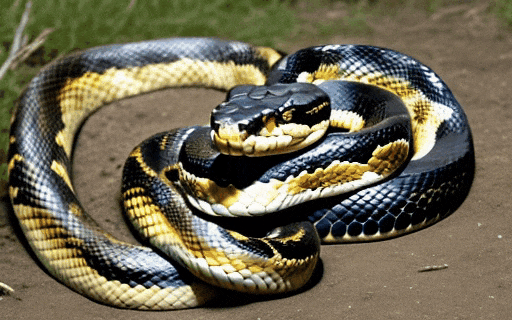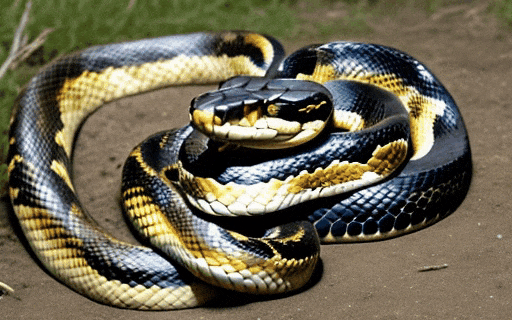
图注:VideoDPO 生成的样本动态演示(上为初始模型,下为经过偏好对齐后的模型)。
背景与动机:扩散模型为何走向强化学习?
发展纪元的演进:从预训练到 RL 后训练
论文开篇梳理了扩散模型自 2015 年至今的技术演变轨迹。从早期的 SMLD、DDPMs 到潜空间扩散模型(LDM)、扩散 Transformer(DiT)以及连续流匹配(Flow Matching),传统范式主要聚焦于网络架构革新与预训练规模扩展。
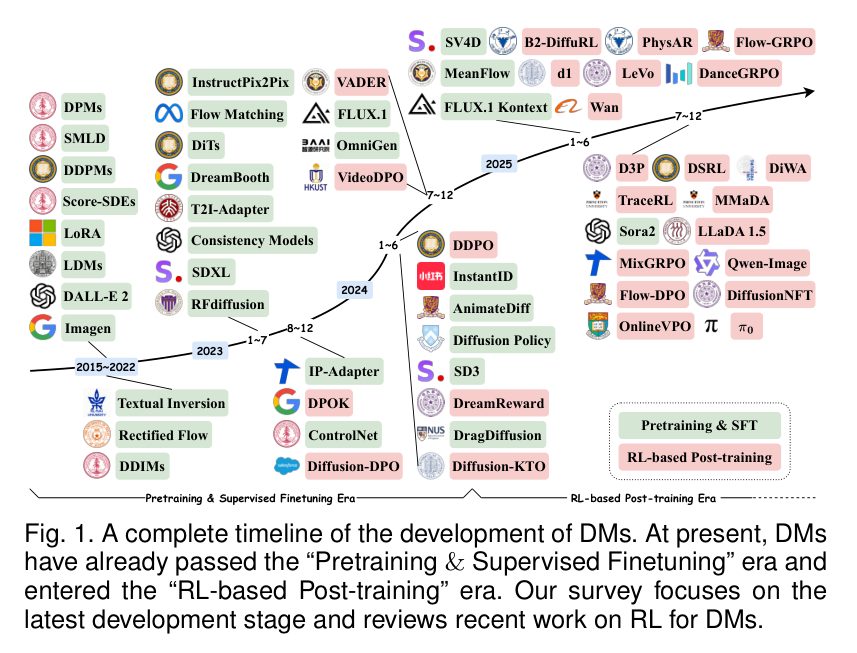
然而,单纯依靠数据似然极大化存在天然局限:
分布外探索受限:基于重建损失训练的模型,倾向于输出训练集中的平均样本,无法在奖励指引下主动探索并强化长尾的高质量生成路径。
非可微与主观目标难以直接反传:用户审美偏好、代码可执行性、物理守恒定律或机器人碰撞惩罚等信号,通常不具备直接对像素求导的闭式解析式。
推断期计算缺乏扩展性:传统扩散仅依靠去噪步数缩放,缺乏像语言模型那样的链式思考(Chain-of-Thought, CoT)与动态试错自修正机制。
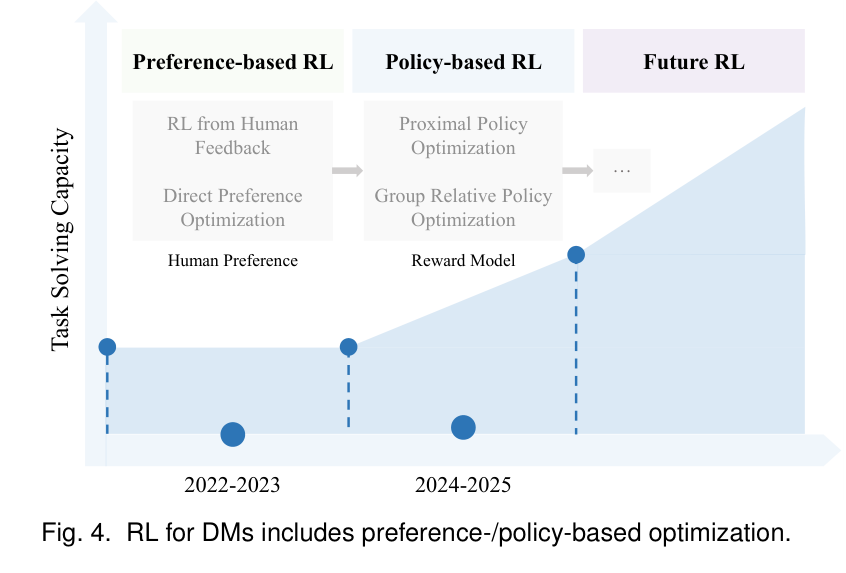
为此,社区逐步引入了基于人类反馈的强化学习(RL from Human Feedback, RLHF)、直接偏好优化(Direct Preference Optimization, DPO),并在近期加速迈向由可验证奖励(RL with Verifiable Rewards, RLVR)与组相对策略优化(Group Relative Policy Optimization, GRPO)驱动的全新纪元。
理论基石:扩散去噪链与马尔可夫决策过程的映射
理解 RL 驱动扩散模型的核心前提,在于厘清去噪动力学与马尔可夫决策过程(Markov Decision Process, MDP)在数学上的同构性。
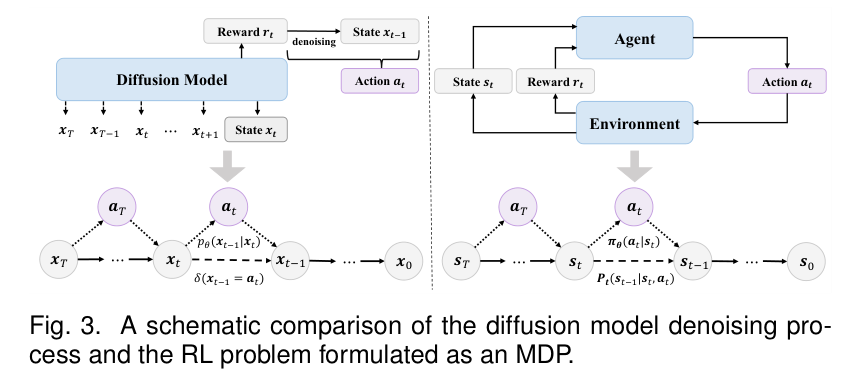
如图 3 所示,经典的有限步离散去噪过程可以直接映射为一个标准的 MDP 元组 :
状态空间(State Space )与动作空间(Action Space ):在离散或连续扩散中,状态 即为时间步 处的加噪潜变量;动作 则对应去噪网络单步预测的转移目标 或瞬时速度向量 。
转移概率(Transition Dynamics ):去噪转移遵循环境的确定性更新规则,即 。
策略分布(Policy ):策略网络直接等价于逆向去噪条件概率分布 。
奖励函数(Reward ):在多数生成任务中,中间状态往往缺乏监督信号,全局奖励在终止去噪步 时给出(),或通过 Tweedie 估计及过程奖励模型(Process Reward Model, PRM)向各中间时间步进行信用分配。
在优化方法上,社区主要分化出三大技术支线:
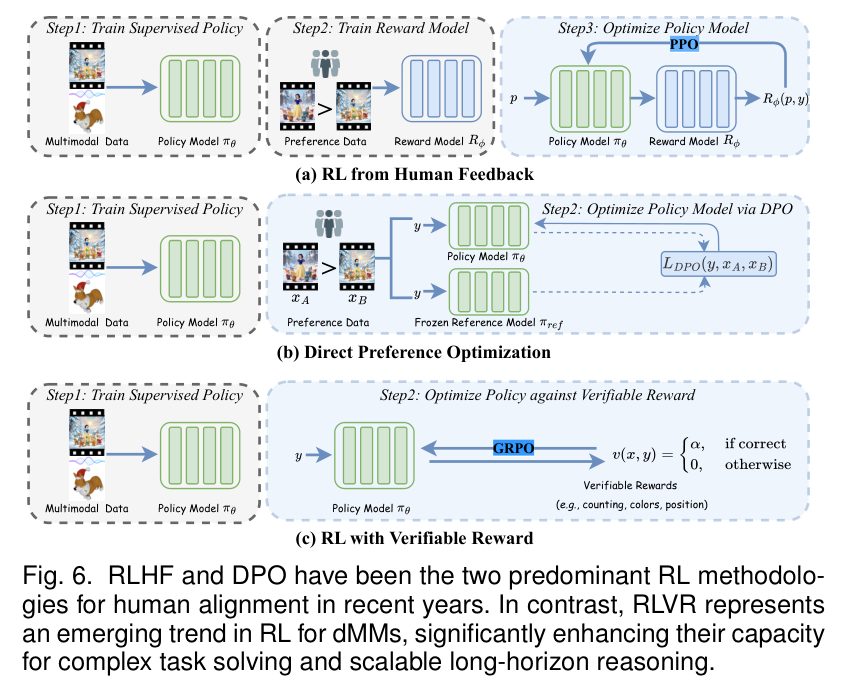
基于奖励的显式策略优化(RLHF / PPO / GRPO):利用判别式奖励模型或外部规则评估生成轨迹,利用策略梯度公式进行参数更新。其中 GRPO 通过采样同条件下的输出组,利用组内平均和标准差构建相对优势 ,彻底规避了额外训练参数庞大的 Critic 价值网络。
免奖励模型的直接偏好优化(DPO):基于 Bradley-Terry 模型闭式解析解,绕过独立奖励模型,直接利用正负成对样本对去噪隐变量的对数比率进行差分对比更新。
面向可验证奖励的强化学习(RLVR):利用外部编译器、几何约束、OCR 识别等明确逻辑作为奖励反馈,为扩散模型注入严谨的符号推理与物理一致性。
语言维度:离散扩散大语言模型(RL4dLLMs)
传统的自回归(Autoregressive, AR)语言模型遵循从左至右的因果解码。而离散扩散语言模型(Diffusion-based LLMs, dLLMs,如 LLaDA)则将文本生成建模为由全局掩码标记逐渐解掩码(Unmasking)的非因果并行重构过程。
正交分类维度:轨迹粒度与奖励密度
在 dLLM 中应用强化学习的关键难题在于:缺乏自回归模型的单向概率链式分解,如何为多步并行解掩码计算似然、控制梯度方差并实现有效信用分配?综述首次提出了由轨迹层级(Trajectory Level)与奖励密度(Reward Density)构成的二维正交技术图谱。
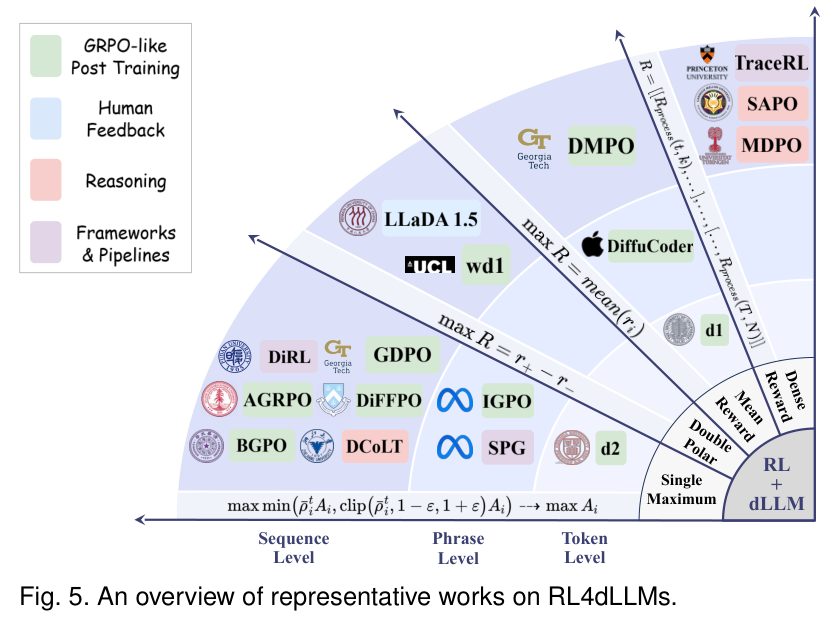
轨迹层级:
Token-level(如 d1、DiffuCoder、wd1):对每个被掩码位置的单词预测概率进行似然估计,计算细粒度策略梯度。
Phrase-level(如 IGPO、DCoLT):将连续的思考子句或语法短语作为原子动作进行补全与评估。
Sequence-level(如 ESPO、MAPG):把整个去噪序列视作一步宏观动作,使用证据下界(Evidence Lower Bound, ELBO)近似序列级似然。
奖励密度:从单极结果奖励(Outcome RM)、正负对立双极目标(Double-polar),延伸至多步加权平均奖励(Mean Reward)与逐步密集过程奖励(Dense PRM,如 SAPO)。
关键性能突破
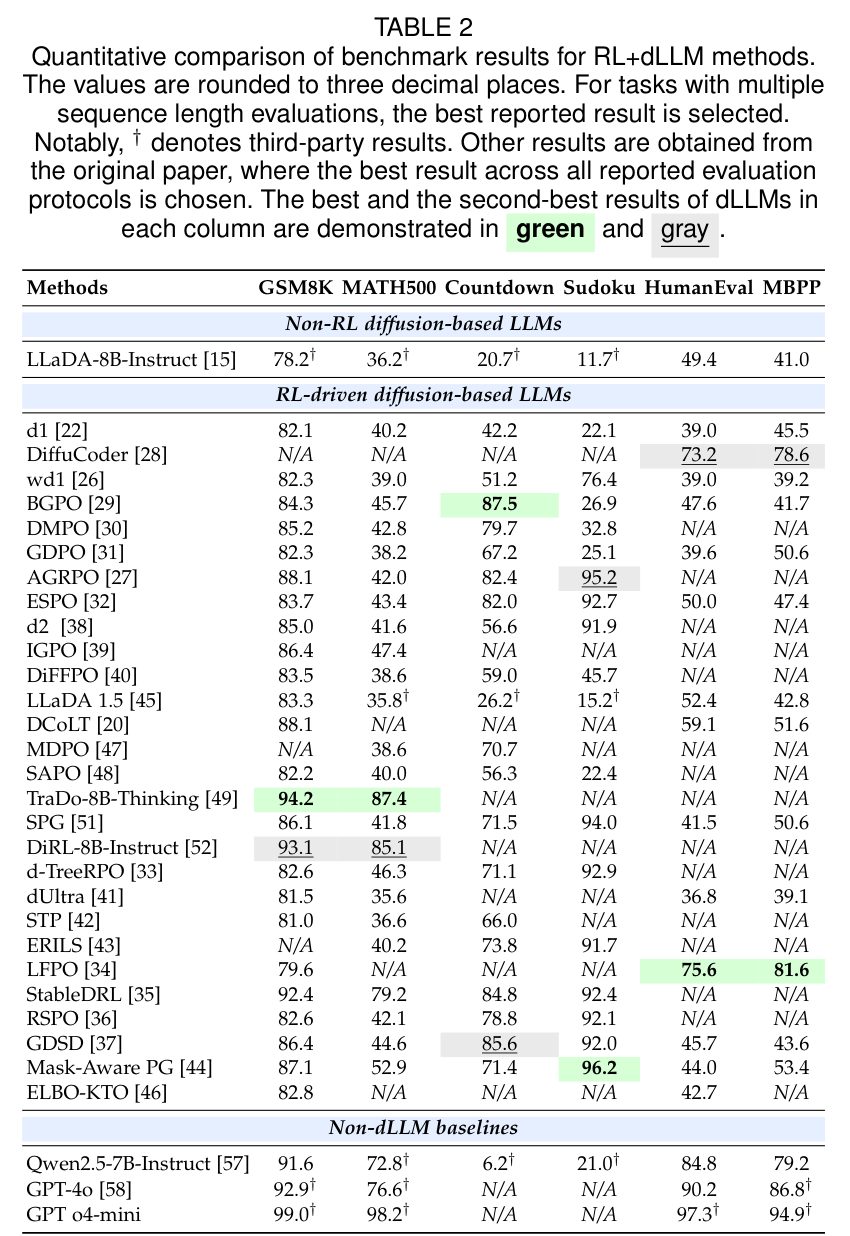
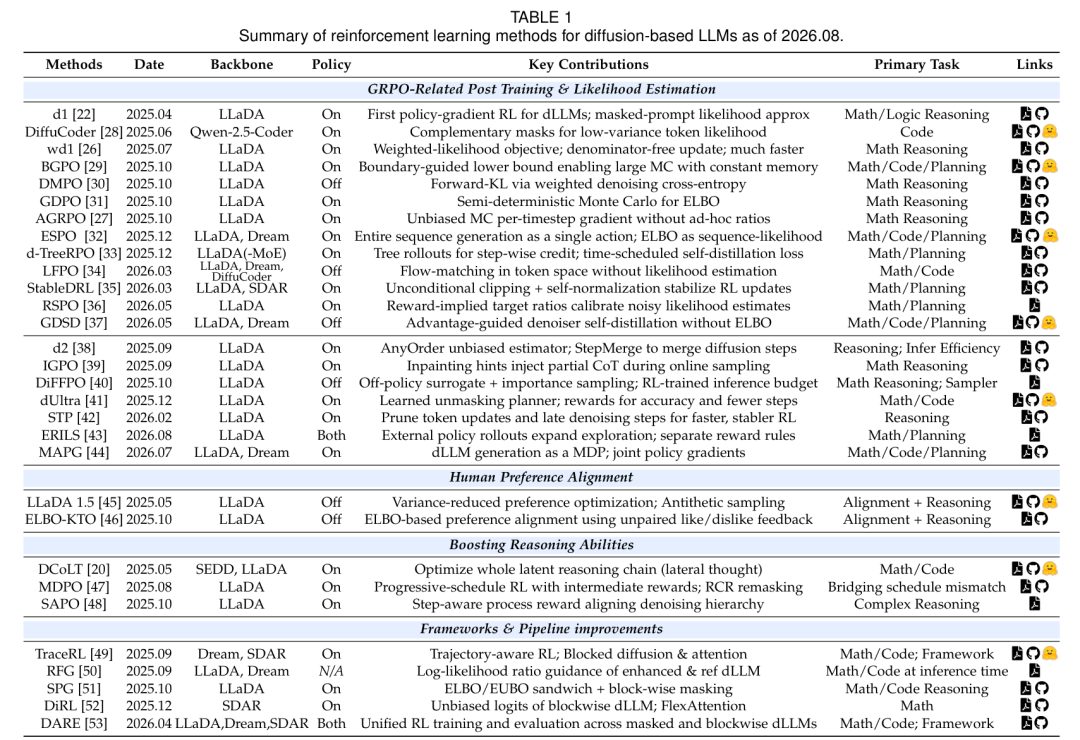
如表 2 汇总的基准测试数据显示,未经 RL 的基础模型(LLaDA-8B-Instruct)在复杂推理上表现薄弱,但在引入 RL 后训练后,推理与代码指标呈现跨越式提升:
数学与逻辑推理:在经典的 GSM8K 基准上,结合轨迹感知价值模型的 TraDo-8B-Thinking 达到 94.2%,采用无偏 GRPO 的 DiRL-8B-Instruct 达到 93.1%;在极高难度的 MATH500 上,TraDo-8B 斩获 87.4% 的高分。
规划与约束求解:在 24 点倒计时(Countdown)任务中,BGPO 达到了 87.5%;在数独求解(Sudoku)上,Mask-Aware PG 取得了 96.2%,远超未微调前 11.7% 的基础水平。
程序合成:在 HumanEval 与 MBPP 代码生成评测中,无似然流匹配策略 LFPO 分别斩获 75.6% 与 81.6% 的成绩。
视觉与多模态:从感知拟合到高维协同(RL4dMMs)
在图像、视频等高维连续感知空间,生成的核心痛点不仅在于画面质感,更在于精准遵循复杂的提示词组合以及维持物理连贯性。
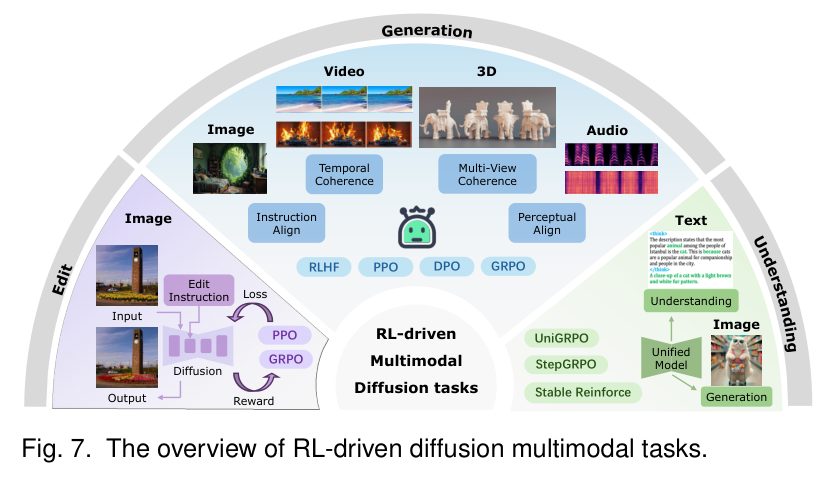
图像生成与编辑
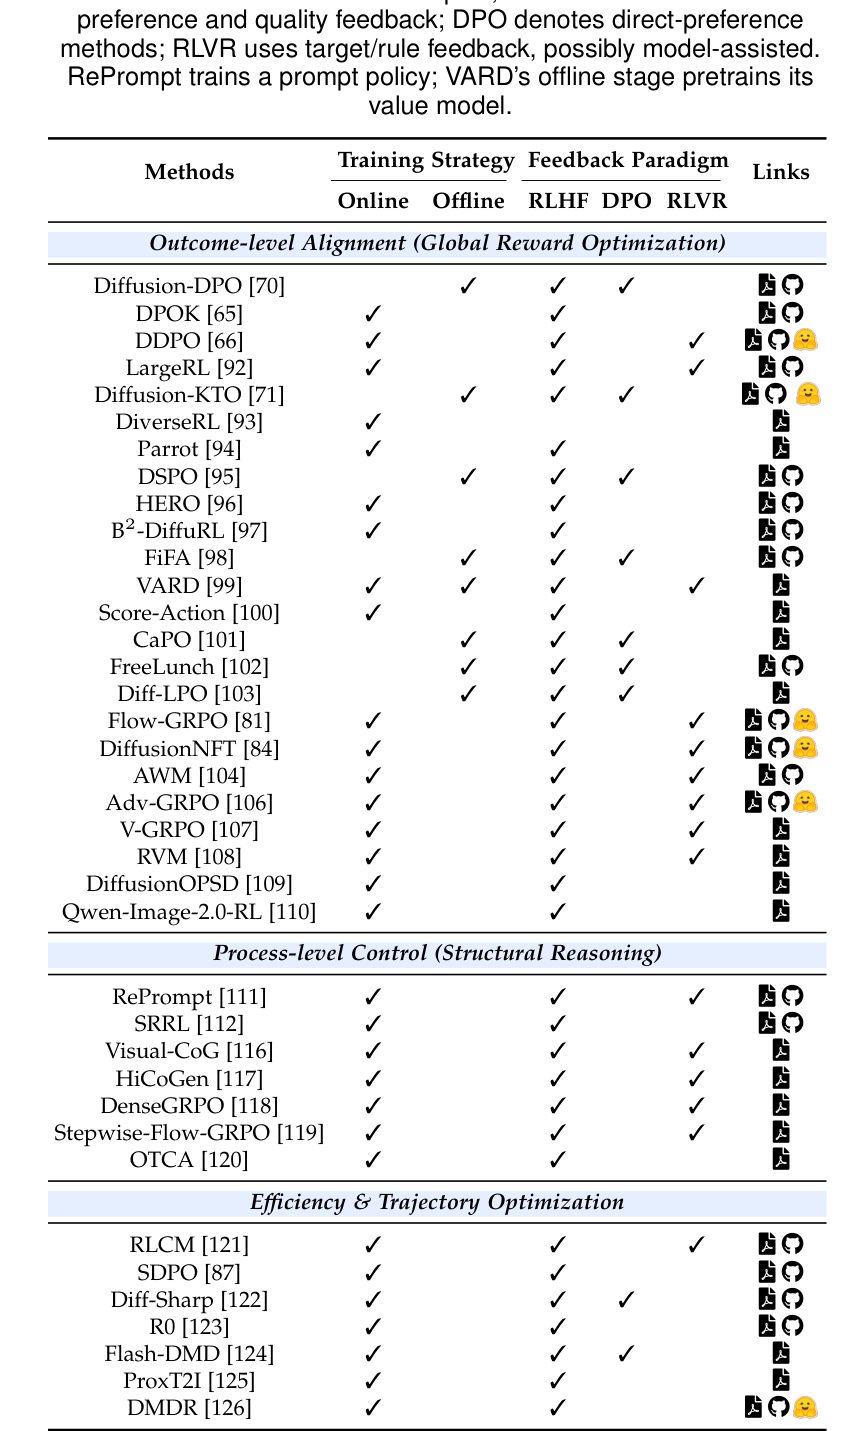
如表 3 所示,图像生成的优化范式已由早期全局结果对齐向动态过程控制演进:
全局结果对齐:Diffusion-DPO 将成对偏好直接注入去噪扩散;Flow-GRPO 与 DiffusionNFT 则直接对连续流匹配速度场进行强化。
过程级控制与思考:DenseGRPO 与 Stepwise-Flow-GRPO 引入中间 Tweedie 洁净估计,实现了时间步维度的信用拆解。
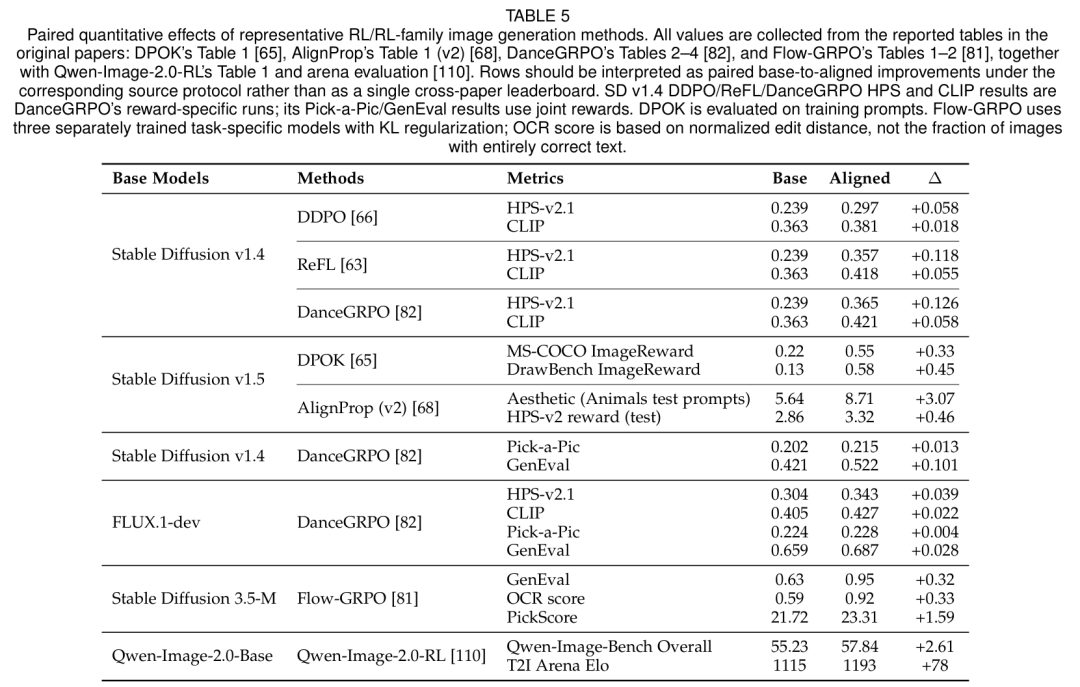
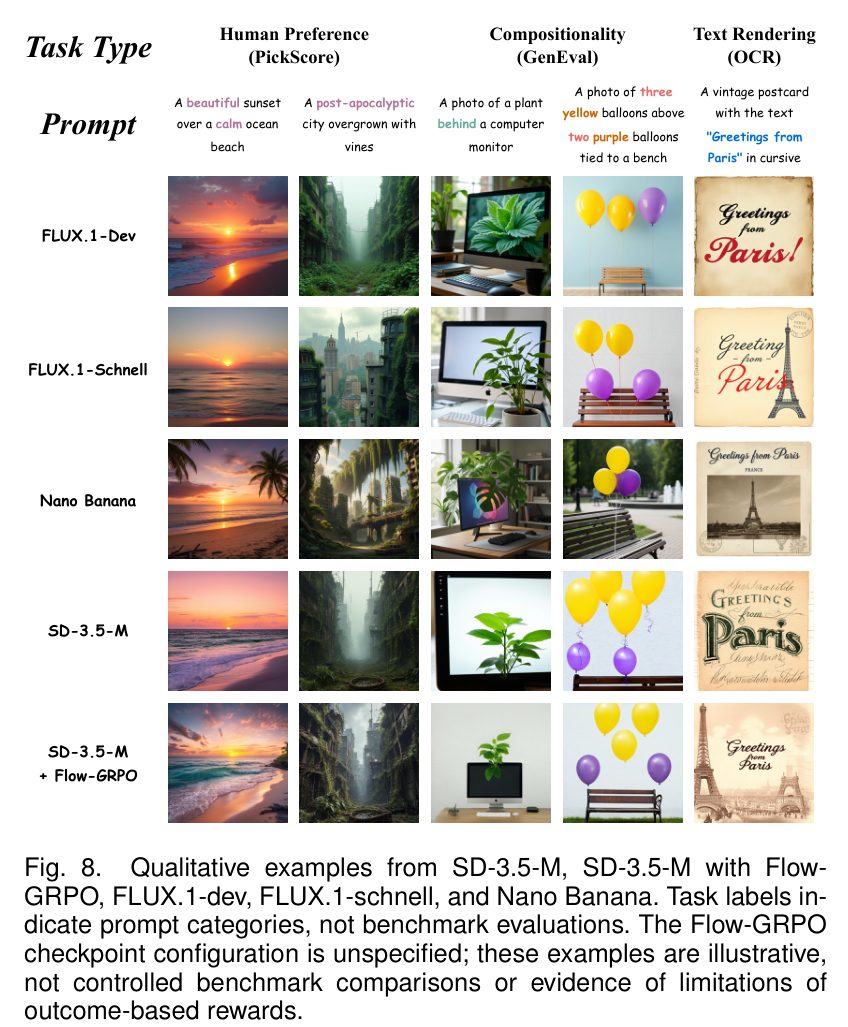
量化实效(表 5):在 Stable Diffusion 3.5-M 骨干上,引入 Flow-GRPO 后,组合推理评测 GenEval 由 0.63 大幅提升至 0.95,OCR 文本渲染准确率从 0.59 提升至 0.92。在工业级系统 Qwen-Image-2.0-RL 中,T2I Arena Elo 评分净增 78 分,达到 1193。
视频生成与物理一致性
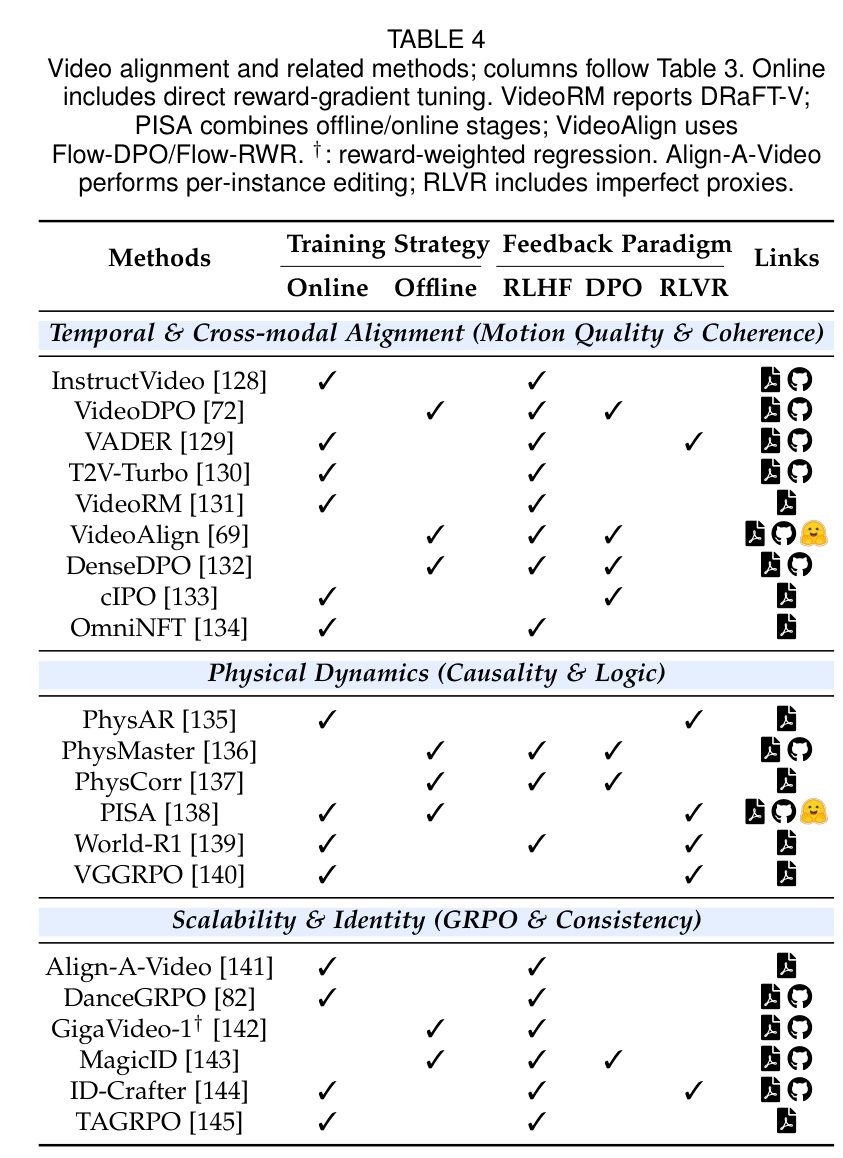
时序维度的引入带来了动作平滑度、闪烁伪影及物理规律违背等严峻挑战。
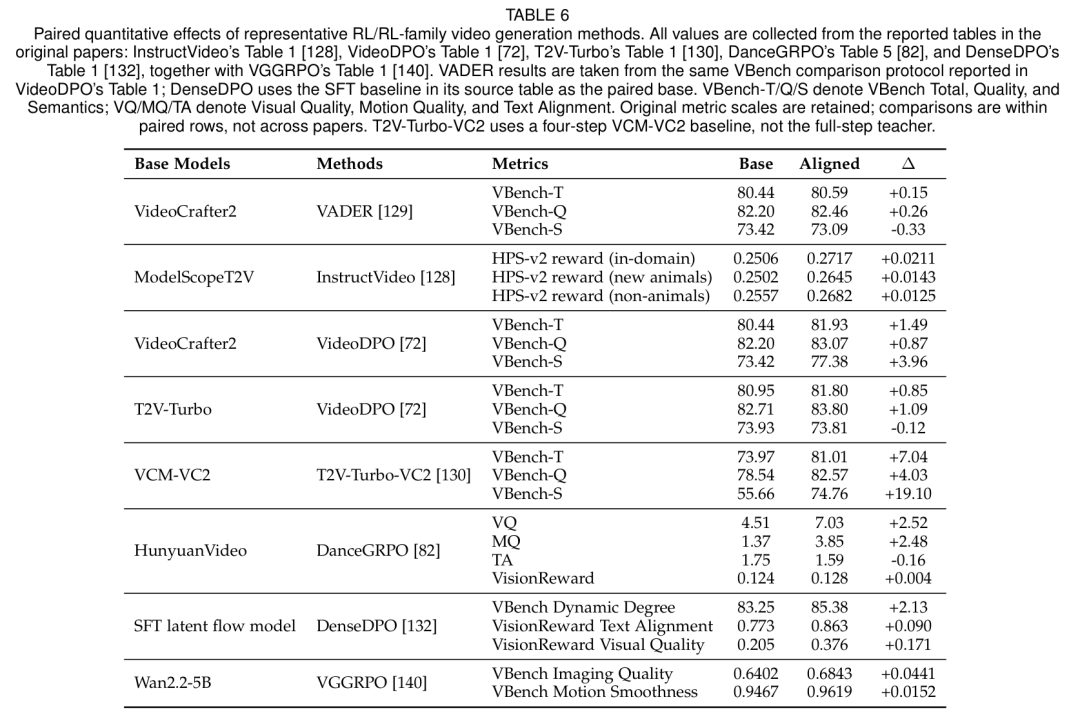
动力学与时间一致性:VideoDPO 通过构建动态平滑度和主体一致性偏好对,使 VideoCrafter2 的 VBench-T 综合评分由 80.44 提至 81.93;DanceGRPO 在 HunyuanVideo 上使动作质量(MQ)从 1.37 跃升为 3.85。
物理常识与几何约束:PhysMaster 与 VGGRPO 通过引入显式几何重投影与物理动力学反馈,有效遏制了视频生成中物体异常穿模与形变。
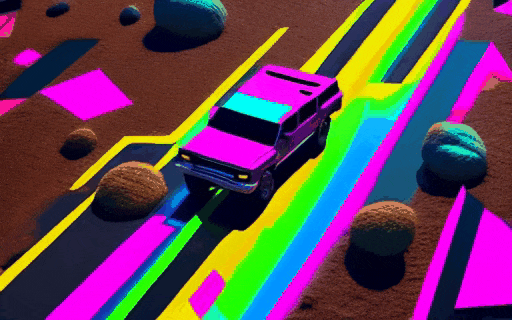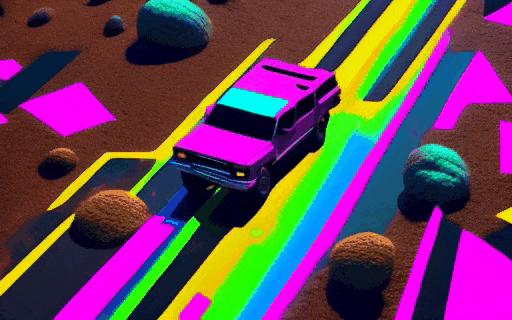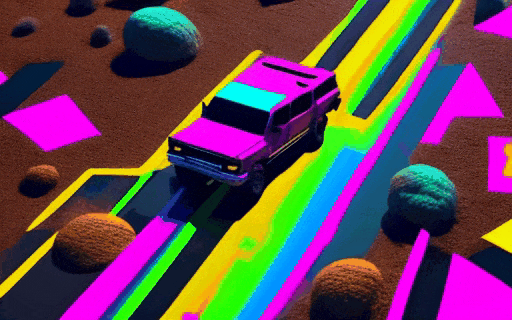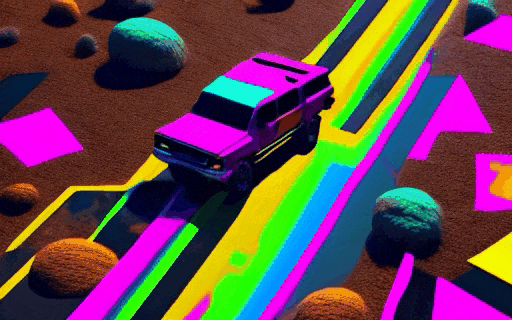
图注:VideoDPO 在复杂主体动态生成上的对齐对比(上为未对齐 baseline,下为对齐后结果)。
具身智能与机器人:策略优化与物理闭环(RL4dRobo)
在机器人领域,传统高斯或 MLP 参数化策略受限于单峰假设,在面对灵巧操作与复杂避障等多模态动作空间时极易崩溃。扩散策略(Diffusion Policy, DP)与视觉-语言-动作(Vision-Language-Action, VLA)模型的出现彻底打破了这一桎梏。
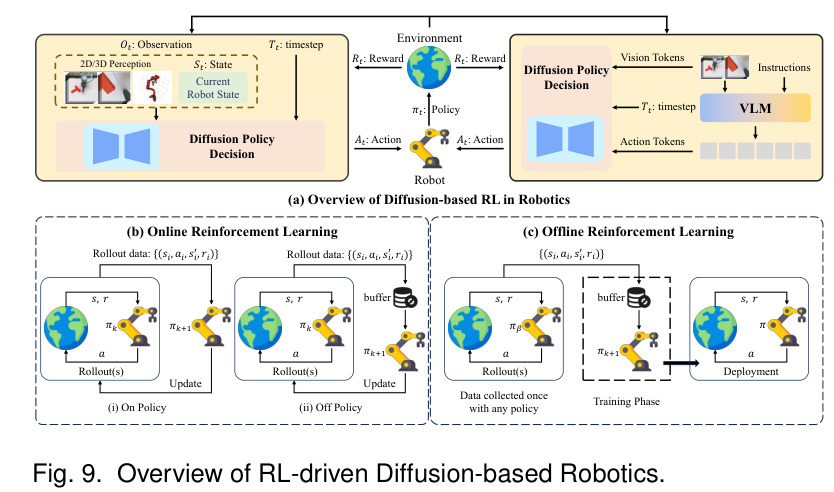
离线与在线 Diffusion RL
综述系统解构了扩散模型在离线(Offline RL)与在线(Online RL)机器人控制中的融合历程:
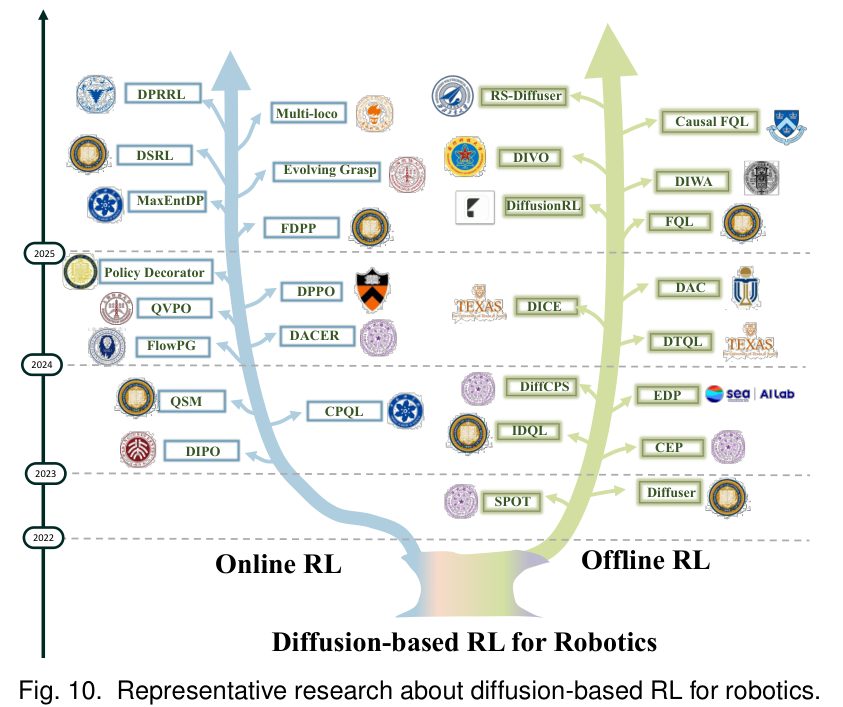
在线探索微调:如 DPPO 针对 Rollout 去噪轨迹进行 PPO 更新;D3P 动态分配去噪步数以权衡运算耗时与操作精度。
离线轨迹正则化与规划:Diffuser 开拓了以去噪轨迹替代传统动态规划的思路;DIVO、DTQL 则在离线价值评估下约束策略漂移。
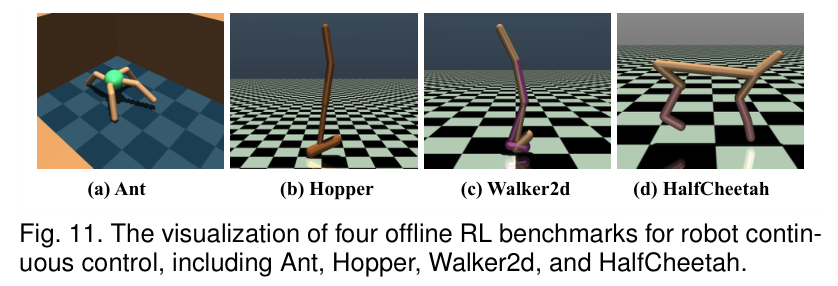
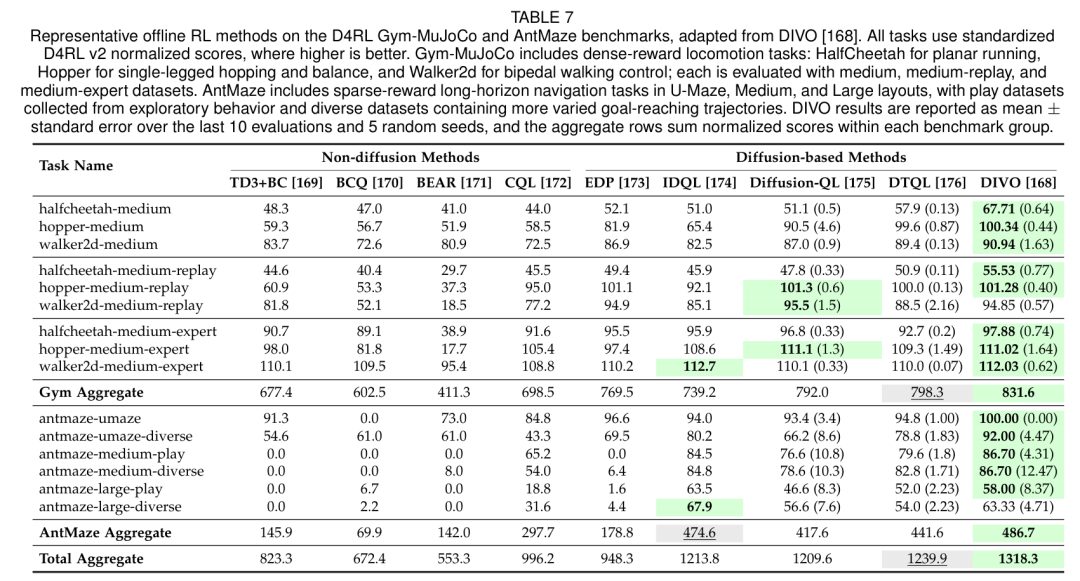
在 D4RL 连续控制基准(表 7)中,基于扩散的方法展现出对复杂多模态动作数据分布的捕获优势:
MuJoCo Gym 密集奖励任务:传统离线算法(如 TD3+BC 总分 677.4,CQL 总分 698.5)提升受阻,而扩散方法 Diffusion-QL 达到 792.0,DIVO 则推升至 831.6 的总分。
AntMaze 极度稀疏奖励长程导航:在极度依赖拼接长程探索轨迹的场景下,传统算法大幅掉点,而 DIVO 在 AntMaze 综合分上达到 486.7,全场景总分达 1318.3。
视觉-语言-动作(VLA)模型中的生成式动作专家
针对以 为代表的流匹配动作专家,RL 后训练摆脱了对高质量专家演示数据的强依赖。
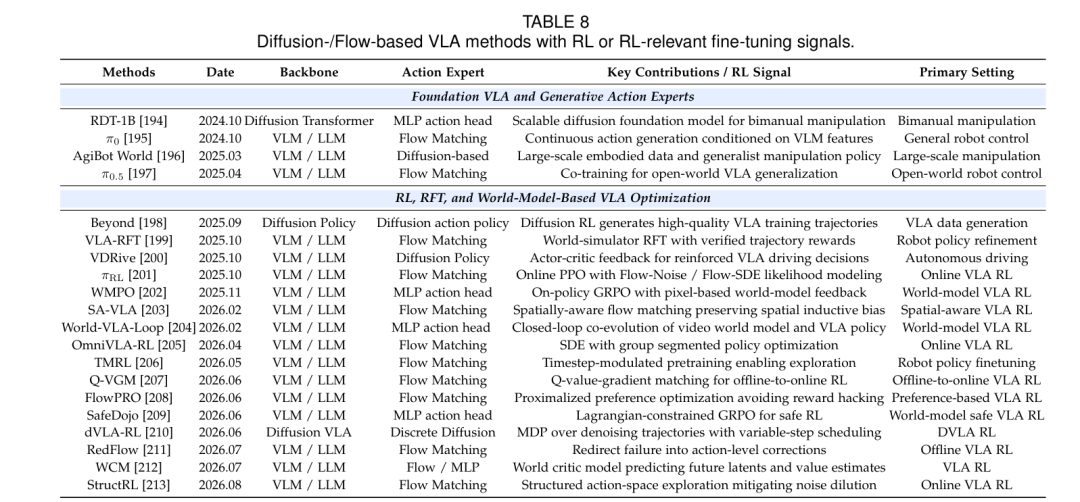
如表 8 所示, 确立了流匹配 VLA 的在线 PPO 机制,SafeDojo 利用世界模型实现了拉格朗日约束下的安全策略探索,VLA-RFT 与 World-VLA-Loop 则推动了仿真闭环中具身决策水平的自主进化。
科学计算探索:面向物理与分子先验(RL4dSci)
扩散模型在科学智能(AI for Science)领域的应用,正在从拟合观测数据演进为在第一性原理约束下进行定向生成。
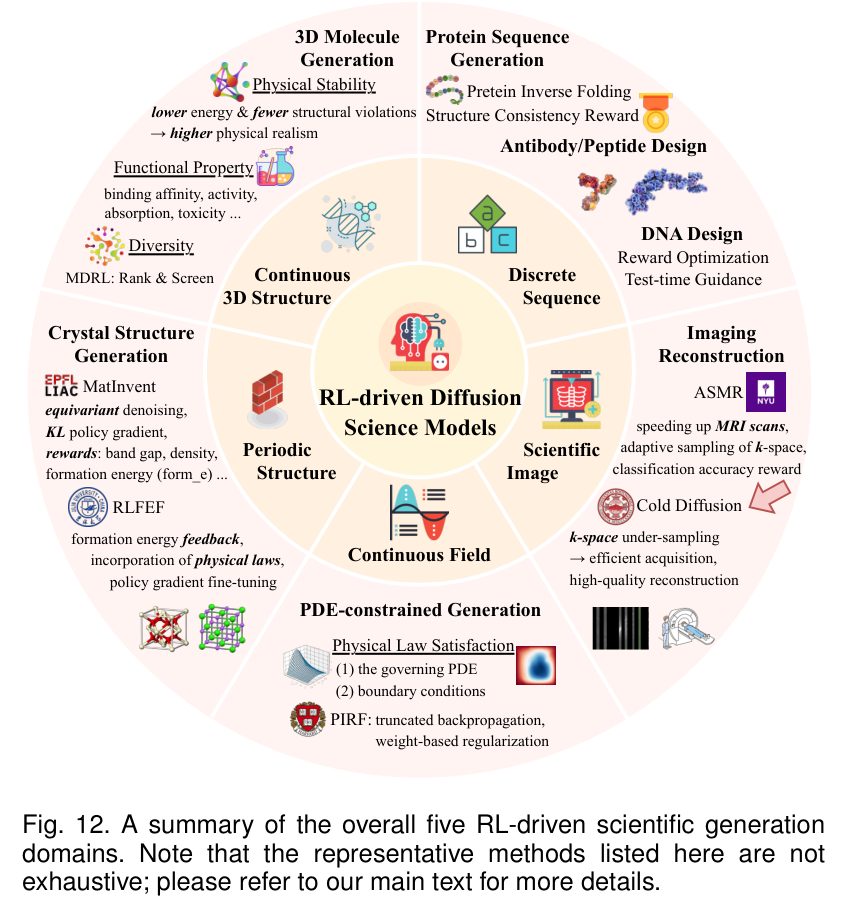
综述按数据模态归纳出五大前沿阵地:
离散分子序列(DNA/蛋白质):RL-DIF 与 DoMinO 通过结构折叠可信度(如 sc-TM)与结合亲和力,驱动离散流匹配模型合成具有特定功能的生物大分子。
连续 3D 药物构象:RLPF 引入分子动力学力场反馈,MDRL 与 FTDiff 结合对接得分(Docking Score)与类药性评估,实现在靶标口袋微环境内的三维配体生成。
周期性晶体材料:MatInvent 与 RLFEF 采用形成能(Formation Energy)作为奖励,在强化学习微调中保证晶体空间群对称性约束。
偏微分方程物理场(PDEs):PIRF 与 PCFT 将偏微分方程控制残差及边界条件转化为轨迹奖惩,使逆问题重建兼具数据逼真度与物理守恒性。
医学科学成像逆问题:ASMR 等算法通过学习 空间自适应下采样策略,提升高倍速欠采样磁共振成像(MRI)的重建质量。
瓶颈剖析与未来演进
该综述最后总结了当前制约 RL 扩散系统走向实际落地的三大底层瓶颈:
奖励设计的脆弱性与“奖励黑客”(Reward Hacking):判别式神经网络往往存在高频感知盲区,生成模型极易在梯度极大化过程中欺骗评分网络(如产生高饱和度、高对比度但失真的图像,或合成不符合热力学规律但计算打分虚高的分子)。
高维连续解空间的探索-利用失衡:扩散去噪链的状态空间极为庞大,纯粹的随机高斯噪声探索容易在低密度冗余区域空转,亟待发展结构化探索机制。
长程轨迹逆向反传的梯度方差爆炸:在离散时间步 步展开中,仅依赖终端奖励容易导致早期时间步的梯度估计信噪比过低,亟需高效的过程奖励模型(PRM)与一步闭环自蒸馏策略。
一点思考
当生成式 AI 全面跨越单纯的“数据拟合”阶段,强化学习不仅是其与真实世界对齐的工具,更是激发模型“思考”、自反思与自主规划能力的核心手段。在扩散模型中,去噪时间步的物理展开本质上构成了天然的隐式思维链。这篇 TPAMI 综述系统地将碎片化的各领域工作纳入统一理论框架,为构建更可控、更具稳健性的下一代生成智能体奠定了重要的理论基础。
论文标题: Reinforcement Learning-driven Diffusion Models: Language, Vision, and Beyond
项目链接: https://github.com/MAIR-Lab-HUST/Awesome-RL-for-Diffusion-Models
研究机构: 华中科技大学、北京理工大学、清华大学、香港科技大学(广州)、中国科学院大学、上海交通大学、复旦大学、上海人工智能实验室、北京大学、同济大学、武汉大学
录用期刊: IEEE Transactions on Pattern Analysis and Machine Intelligence (TPAMI)
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。