EMNLP 2026 | 美团技术团队学术论文精选
美团技术团队 2026-11-17 10:24 北京
精选了12篇主会论文(Long Paper)分享给大家,这些论文覆盖推理框架、策略优化、评估框架、强化学习、记忆框架、自适应训练框架、语义标签、数据合成框架、统计框架、奖励模型等技术领域和方向。
点亮👆“☆”星标,不错过推送内容~
全文速读
EMNLP 2026 是国际计算语言学协会(Association for Computational Linguistics, ACL)举办的自然语言处理经验方法会议,是自然语言处理与计算语言学领域的国际顶级学术会议之一。
2026年,美团技术团队共计 20 余篇论文被 EMNLP 2026 收录,我们从中精选了12篇主会论文(Long Paper)分享给大家,这些论文覆盖推理框架、策略优化、评估框架、强化学习、记忆框架、自适应训练框架、语义标签、数据合成框架、统计框架、奖励模型等技术领域和方向,希望能够对从事相关工作的同学以启发或者帮助。
🎈欢迎大家在评论区晒出自己的见解、思考,分享实践经验,一起交流学习。
10 月 24 日至 29 日,EMNLP 2026 在匈牙利布达佩斯举行,参会超 7000 人、覆盖 95 个国家和地区,美团技术团队深度参与。26 日晚,我们还举办了「与美团研究员共进晚餐」专场交流晚宴。晚宴邀请了专注于 Agentic Foundation Models、RSI、智能决策等多个方向的技术专家与同学展开深度交流,共同探讨前沿技术课题,以及技术如何走进真实物理世界。
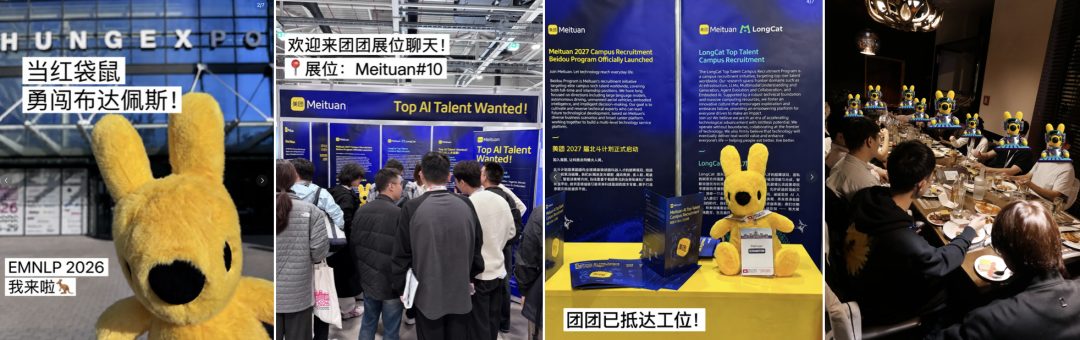
美团履约技术部Agent方向正在招聘实习生,感兴趣的小伙伴可以发简历到gaojiuchong@meituan.com。

论文标题:A Listen-Think-Speak Framework for Efficient Streaming Voice Interaction via Semantic Triggering and Incremental Reasoning
论文类型:Main Conference,Long Paper
论文下载:PDF
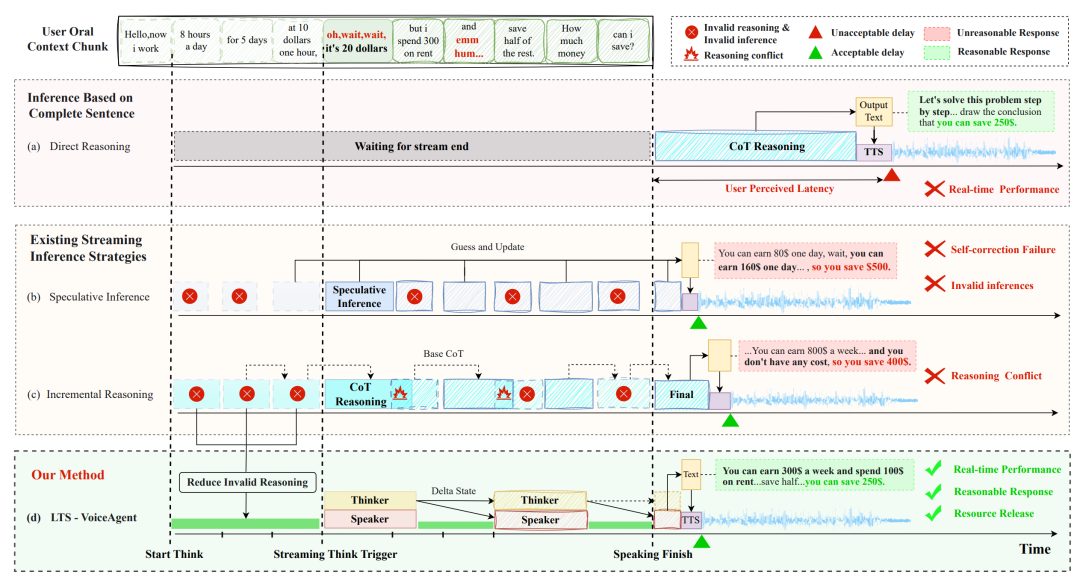
论文简介:实时语音智能体面临着两难困境:端到端模型往往缺乏深度推理能力,而级联流水线由于 ASR(语音识别)、LLM 推理和 TTS(语音合成)严格串行执行,导致延迟过高。现有的级联流式策略试图通过机械式分段(例如固定块大小、基于 VAD 的切分)或投机生成来降低这种延迟,但它们经常要么破坏语义单元的完整性,要么将计算资源浪费在必须回滚的预测上。
为了解决这些挑战,我们提出了 LTS-Agent,这是一个“听-想-说”(Listen-Think-Speak)框架,它显式地将流式场景下的“何时思考”与“如何增量推理”区分开来。LTS-Agent 引入了一个动态语义触发器(Dynamic Semantic Trigger),学习在语义饱和的前缀处被激活;以及一个双角色流式编排器(Dual-Role Stream Orchestrator),利用推理引擎的批处理能力来协调两个互补的角色:负责后台状态维护的“思考者(Thinker)”和负责前台投机求解的“说话者(Speaker)”。这种并行设计允许系统“边说边想”,在维护结构化推理状态的同时不阻塞即时响应。
此外,我们构建了一个“停顿与修复(Pause-and-Repair)”基准测试,在复杂的推理任务中注入迟疑和自我修正,以压力测试流式处理的鲁棒性。在 VERA、Spoken-MQA、BigBenchAudio 以及我们的基准测试上的实验表明,相比于串行级联基线和现有的流式策略,LTS-Agent 实现了更优的准确率-延迟-效率权衡。

论文标题:Silence the Judge: Reinforcement Learning with Self-Verifier via Latent Geometric Clustering
论文类型:Main Conference,Long Paper
论文下载:PDF
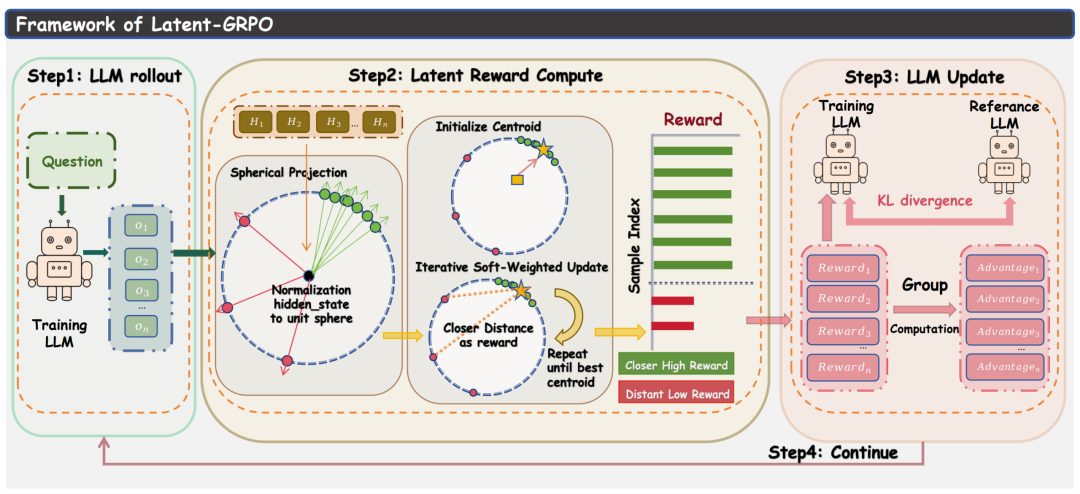
论文简介:群体相对策略优化(GRPO)显著增强了大语言模型的推理能力,但受限于稀疏的离散奖励信号和昂贵的外部验证器。为解决这些问题,我们提出Latent-GRPO框架,通过利用潜空间的几何特性来获取内在奖励,消除对外部验证的依赖。我们的实证分析揭示了一个重要的几何性质:正确推理轨迹的终端token表示在潜空间中展现出高的类内余弦相似度,形成紧密聚类,而错误轨迹则分散分布。
基于这一观察,我们引入迭代鲁棒质心估计(IRCE)算法。IRCE通过球面投影消除幅度波动,并通过迭代软加权聚合估计"真值质心",从而生成密集的连续奖励信号。在多种模型规模上的实验表明,Latent-GRPO在推理性能上与外部验证器相当,同时显著降低了训练延迟和内存开销。本工作证明了高效、可扩展的无需训练的奖励建模可以直接在潜空间内实现,为内在奖励驱动的强化学习提供了新的范式。

论文标题:One Instruction Is a Benchmark: End-to-End Instruction-Following Evaluation with FlexBench
论文类型:Main Conference,Long Paper
论文下载:PDF
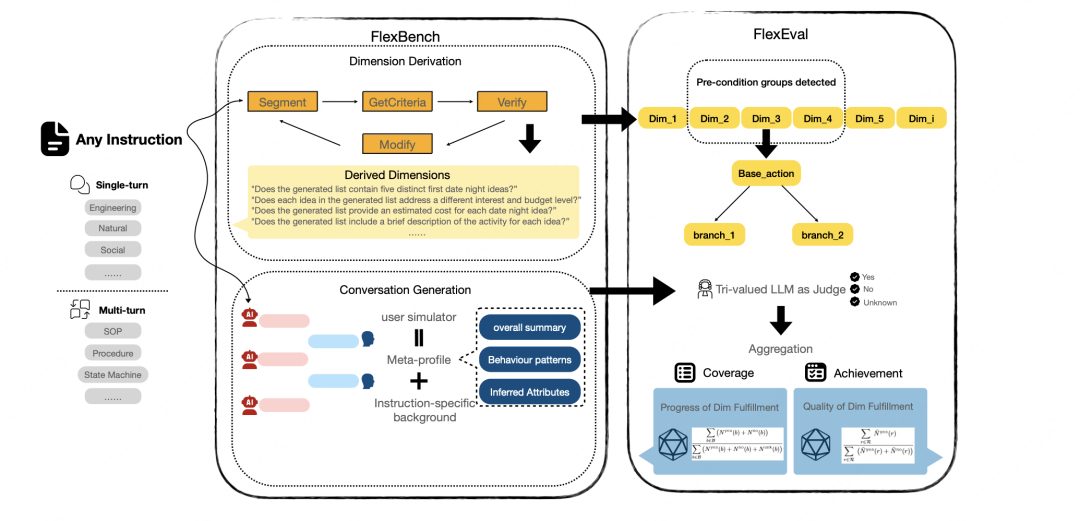
论文简介:大型语言模型在实际应用中日益依赖对用户提供指令的理解,这些指令往往篇幅较长、精确细致,且针对特定工作流程量身定制。在此类场景下,通用的排行榜综合表现往往难以有效反映模型忠实执行从业者拟部署的特定指令的能力。
为弥补这一空白,我们提出了FlexBench/FlexEval -- 一个指令条件化的评估框架,能够根据用户提供的目标指令动态生成专门的测试套件。给定目标指令后,FlexBench导出一组可验证的评估维度,并生成指令条件化的对话语料库。FlexEval随后将维度级评判汇总为两个互补指标:COVERAGE(覆盖率),衡量工作流进度;ACHIEVEMENT(达成度),衡量条件正确性。我们在涵盖多种场景类别和工作流拓扑的九条多轮目标指令上,对九个当代LLM进行了评估,共涉及3,888段生成的对话。结果表明,模型排名和失败模式在不同目标指令间差异显著,凸显了超越固定综合基准、采用指令条件化评估的必要性。
基础研发平台/计算和智能平台部/智能交互部
美团基础研发平台智能交互基础模型、Agent交互方向正在招人,感兴趣的小伙伴可发简历到邮箱:liulu47@meituan.com。

论文标题:SIRI: Self-Internalizing Reinforcement Learning with Intrinsic Skills for LLM Agent Training
论文类型:Main Conference,Long Paper
论文下载:PDF
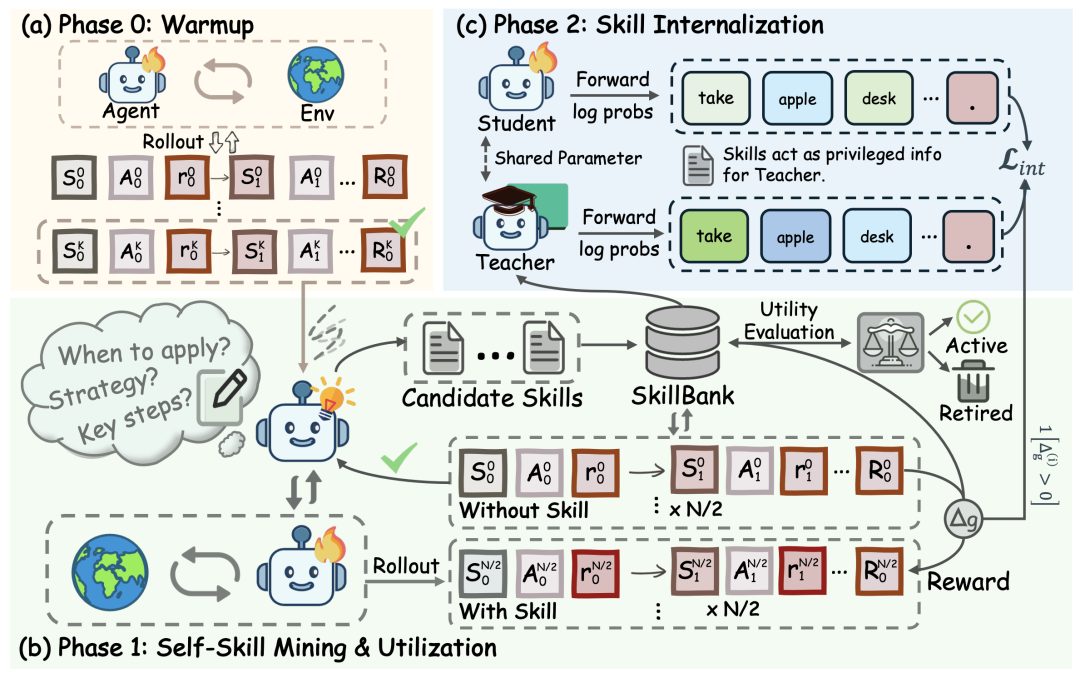
论文简介:智能体技能(Agent Skills)能够将成功经验压缩为可复用的策略知识,帮助智能体减少重复探索并完成长程交互任务。然而,现有方法通常依赖外部模型或独立模块生成技能,并在推理阶段持续检索和注入技能,不仅增加训练与部署复杂度,还会带来额外的上下文开销和推理延迟。一个关键问题是:智能体能否自主发现有效技能,并将其真正内化到模型参数中,从而在推理时不再依赖外部技能库?
为此,本文提出 SIRI(Self-Internalizing Reinforcement Learning with Intrinsic Skills),一个面向技能自主发现、验证与内化的三阶段强化学习框架。SIRI 首先通过 GiGPO 预热策略,获得基础交互能力并积累无技能辅助的成功轨迹;随后由模型从自身成功轨迹中提炼候选技能,并通过成对的 Skill-Augmented 与 Skill-Free Rollout 验证技能效用;最后结合轨迹级技能增益与动作级优势,仅将真正有益的技能引导动作蒸馏至无技能策略中。训练完成后,模型无需检索或注入任何技能,仅使用原始任务提示即可完成推理。
在 Qwen2.5-7B-Instruct 上,SIRI 将 GiGPO 在 ALFWorld 上的任务成功率由 90.8% 提升至 93.0%,在 WebShop 上由 72.8% 提升至 81.3%,分别提高 2.2 和 8.5 个百分点,并整体优于提示学习、标准强化学习和记忆增强方法。进一步实验表明,模型自主挖掘的技能经过在线验证与内化后,可以达到与闭源大模型生成技能相当的效果

论文标题:SCOPE: Signal-Calibrated On-Policy Distillation Enhancement with Dual-Path Adaptive Weighting
论文类型:Main Conference,Long Paper
论文下载:PDF
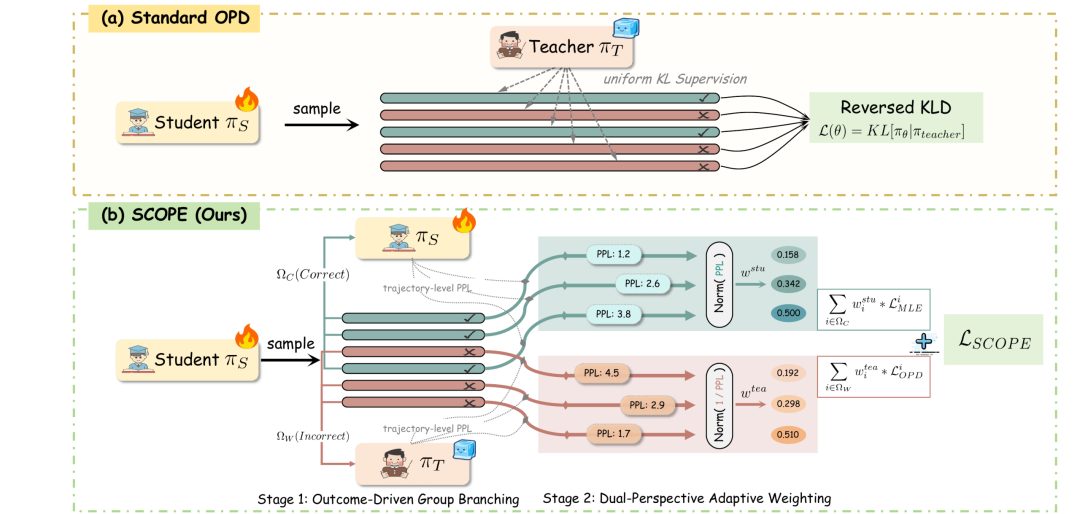
论文简介:在大语言模型的推理对齐中,在线策略蒸馏(On-Policy Distillation, OPD)通过引入教师模型的 token 级 KL 监督来缓解在线强化学习中结果级奖励的信用分配难题,但现有方法对所有策略采样轨迹无差别施加同等监督,忽略了信号质量的本质差异。
为此,我们提出 SCOPE(Signal-Calibrated On-Policy Distillation Enhancement)双路径自适应训练框架:以轨迹正确性为路由,将 rollout 分流至两条互补的监督路径——对错误轨迹,基于教师困惑度加权 KL 蒸馏,优先强化教师真正具备纠错能力的实例,同时抑制"自信犯错"的误导信号;对正确轨迹,基于学生困惑度加权 MLE,将强化重点集中在能力边界处低置信度样本上,避免对已掌握路径的过度强化。两条路径均采用组级归一化自适应校准权重分布,兼顾不同 prompt 间的难度差异。
在 MATH500、AIME24、AIME25、AMC23、Minerva、OlympiadBench 六个推理基准上,SCOPE 相较所有竞争基线取得 Avg@32 平均相对提升 11.42%、Pass@32 提升 7.30% 的一致性增益,验证了信号质量感知的自适应监督在 OPD 框架中的有效性。

论文标题: TRUST-SQL: Tool-Integrated Multi-Turn Reinforcement Learning for Text-to-SQL over Unknown Schemas
论文类型: Main Conference,Long Paper
论文下载: PDF
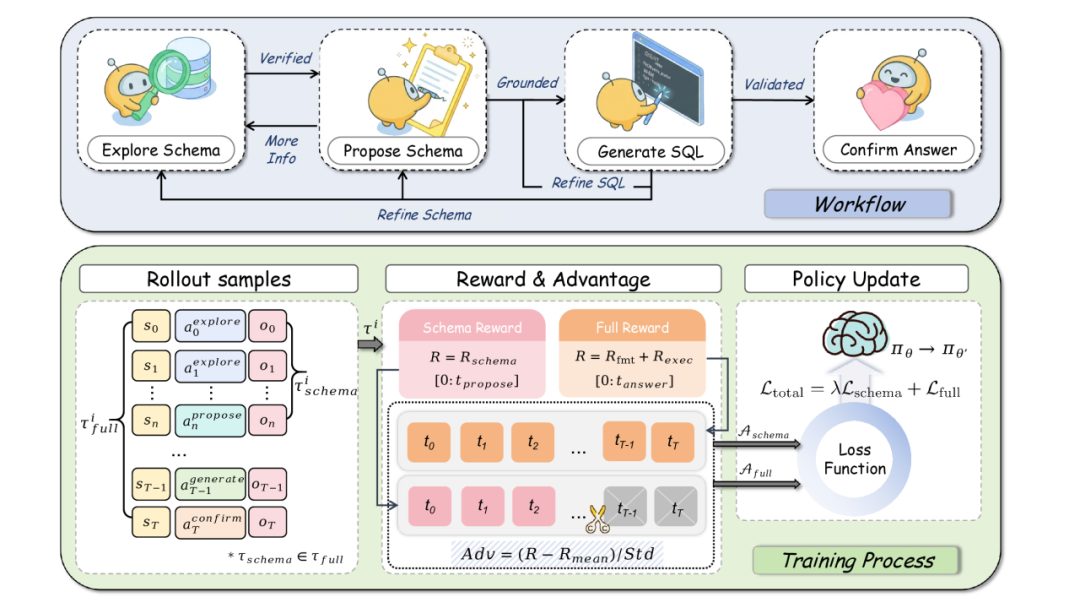
论文简介: 现有 Text-to-SQL 方法通常假设预载完整数据库结构(Schema),但在庞大且动态变化的企业库中易超出上下文窗口并引入噪声,结构缺失时模型又易虚构表或字段。
为使智能体在不预载结构下自主探明并核验信息以生成正确 SQL,本文提出面向未知结构的工具集成多轮强化学习框架 TRUST-SQL(Truthful Reasoning with Unknown Schema via Tools)。框架将任务建模为部分可观测马尔可夫决策过程,设计“探索—提议—生成—确认”(Explore–Propose–Generate–Confirm)四阶段协议,要求在 Propose 阶段显式确认已核验的表与字段,并支持据执行反馈回退修正;同时提出阶段感知群体相对策略优化(Phase-Aware GRPO),以 Propose 为界分别计算结构探索与完整轨迹的优势,结合 token 级掩码将结构奖励限定于对应阶段,缓解多轮信用分配难题。
在 BIRD-Dev、Spider-Test 及三个 Spider 鲁棒性基准上,不预载结构且贪心解码时,4B 和 8B 模型五项基准平均执行准确率较基础模型分别提升 30.6 和 16.6 个百分点;14B 模型在 BIRD-Dev 上达 68.1%(多数投票达 70.1%),无需预载全量结构即可在多数基准上达到或超越依赖结构预加载的强基线。
业务研发平台/搜索和推荐平台部
业务研发平台/搜索和推荐平台部 C 端 AI Agent 问小团算法团队正在招人(大模型后训练、Agent 方向),感兴趣的小伙伴可发简历到邮箱:zhaohejia03@meituan.com。

论文标题:UniMem: Complementary Episodic-to-Parametric Memory for Boundary-Agnostic Task Streams
论文类型:Main Conference,Long Paper
论文下载:PDF
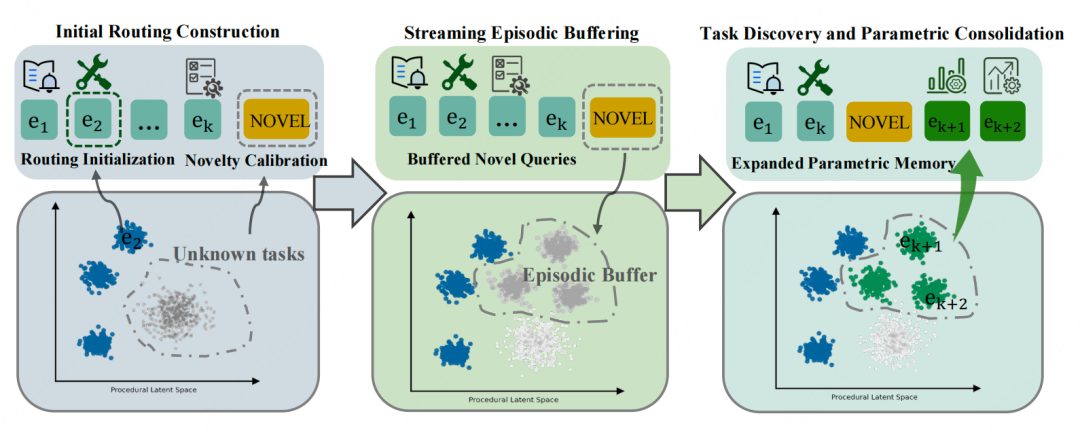
论文简介:大语言模型智能体需要在长期交互中积累并复用任务经验,但真实部署中的任务往往持续变化且没有明确边界,单独依赖外部检索记忆或参数化记忆都会面临稳定性与可塑性的矛盾:前者能够快速吸收新信息,却难以内化重复出现的执行模式且增加检索开销;后者执行稳定高效,却依赖预定义任务边界和固定参数容量。
为此,本文受互补学习系统理论启发,提出统一记忆框架UniMem,通过可学习的路由Token协调情景记忆与参数化记忆,并将任务识别与具体任务执行进行解耦。对于已知任务,模型激活对应的参数化记忆单元执行;对于新颖、稀疏或不确定的任务,则先存入情景缓冲区并通过检索增强方式处理。当缓冲区中出现重复且可靠的模式时,UniMem无需任务标签即可自动发现潜在任务结构,并为其动态扩展新的路由Token和参数化记忆模块,实现从短期情景记忆到长期参数记忆的逐步巩固。
实验表明,UniMem在多种长程流式任务和不同骨干模型上能够保持稳定的路由与任务执行性能,并在自主扩展记忆、控制参数增长的同时,整体优于外部记忆、参数高效微调和Token记忆等基线方法。

论文标题:TagPR: Tag-Guided Process Supervision for Personalization Reasoning in Large Language Models
论文类型:Main Conference,Long Paper
论文下载:PDF
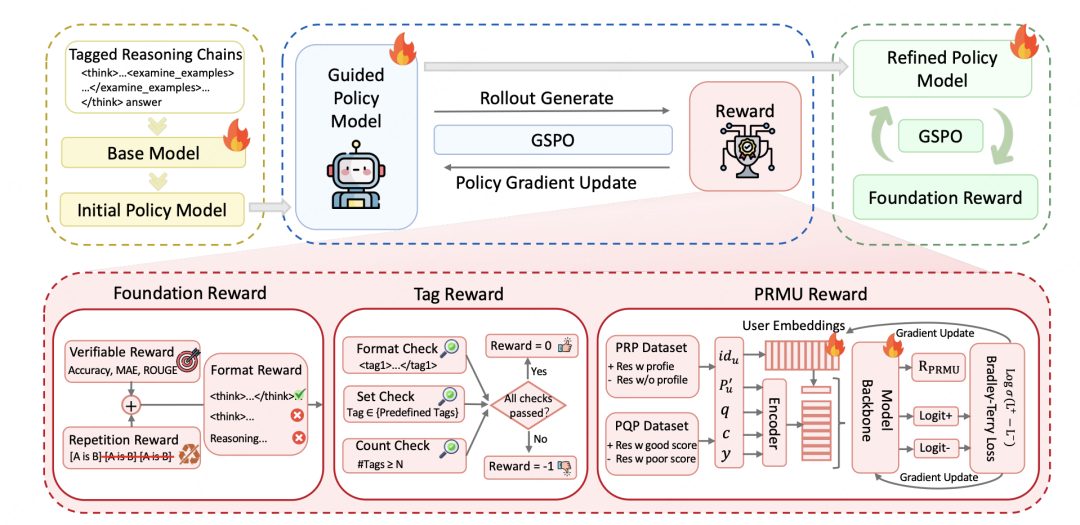
论文简介:现有大模型虽然具备较强的通用推理能力,但在个性化任务中容易沿用模型自身的通用逻辑,忽略用户历史中体现的独特偏好;只依赖结果奖励的强化学习也无法约束推理过程,模型可能“答案正确、过程错误”。
为此,本文提出 TagPR,在个性化推理链中引入语义标签,把分析输入、检查用户样例、识别偏好模式、比较对象和形成结论等过程显式拆解为可监督的步骤。TagPR 首先自动构造高质量的带标签推理数据进行监督微调(SFT),再通过多阶段强化学习进行优化;其复合奖励同时结合标签级过程监督,以及带用户嵌入的个性化奖励模型(PRMU),从而让模型的推理过程更贴合用户特定逻辑。
论文在 LaMP、LongLaMP、PGraphRAG 及自建数据集上进行了实验,在 LaMP 全部任务上相对基础模型平均提升 32.65%,并表现出更准确、可解释且具迁移能力的个性化推理效果。

论文标题:ToolForge: A Data Synthesis Pipeline for Multi-Hop, Multi-Turn, and Self-Reflective Tool-Use Data
论文类型:Main Conference,Long Paper
论文下载:PDF
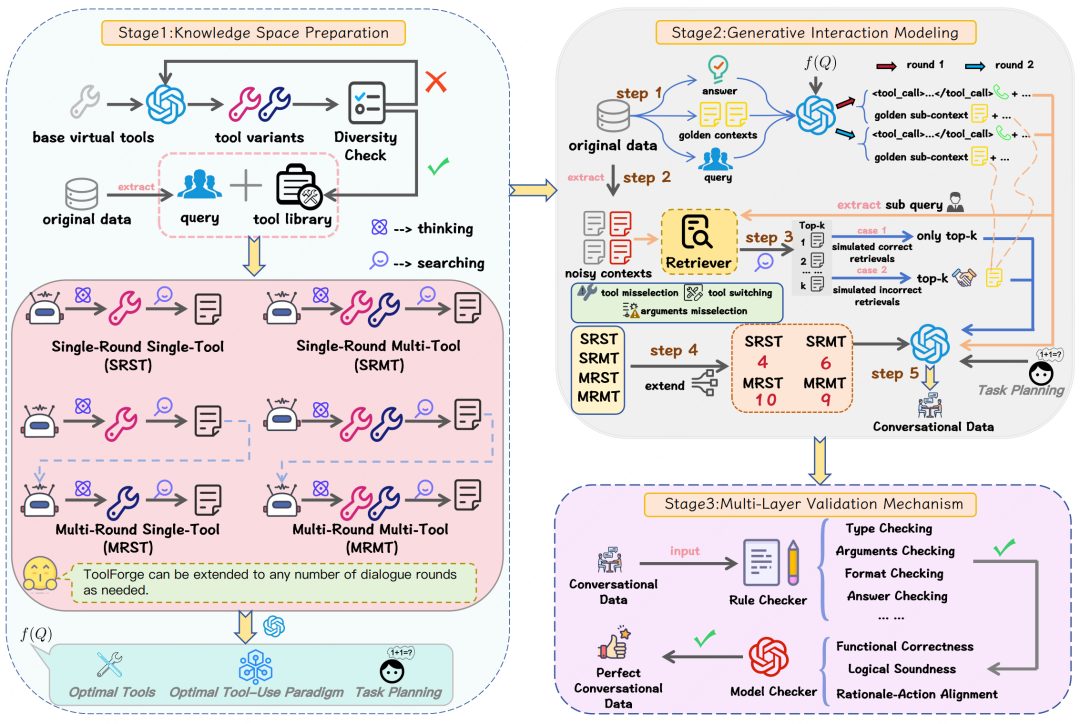
论文简介:面向工具使用的大模型训练,现有数据构建方法往往依赖大规模真实 API 调用,成本较高且难以覆盖多跳推理、多轮交互和错误反思等复杂场景。为此,本文提出 ToolForge,一套无需大规模在线工具执行的工具使用数据合成框架:以问答数据为种子,构建由 19 类基础虚拟工具及其自动扩展变体组成的可扩展工具空间,并通过单/多轮、单/多工具等交互范式,模拟正确检索、工具误选、参数误选及工具切换等场景,生成包含多跳证据整合与自我反思纠错过程的工具调用轨迹。为保障数据质量,ToolForge进一步设计多层验证机制,结合规则校验与模型语义评估过滤结构或推理不一致的样本,并通过MCTS挖掘困难负例验证其可靠性。
实验表明,仅使用4,250条ToolForge合成数据微调Qwen3-8B,即可在5个域外问答基准上相对TIR提升21.6%,并在BFCL、API-Bank等工具调用基准上展现出良好的泛化能力。
业务研发平台/点评技术部
业务研发平台/点评技术部AIGC识别与内容生态治理方向正在招人(大模型算法专家,坐标上海),感兴趣的小伙伴可发简历到邮箱:luyuanyuan04@meituan.com。

论文标题:RACE: Scalable Statistical Estimation of Functional Consistency in LLM Neurons
论文类型:Main Conference,Long Paper
论文下载:PDF
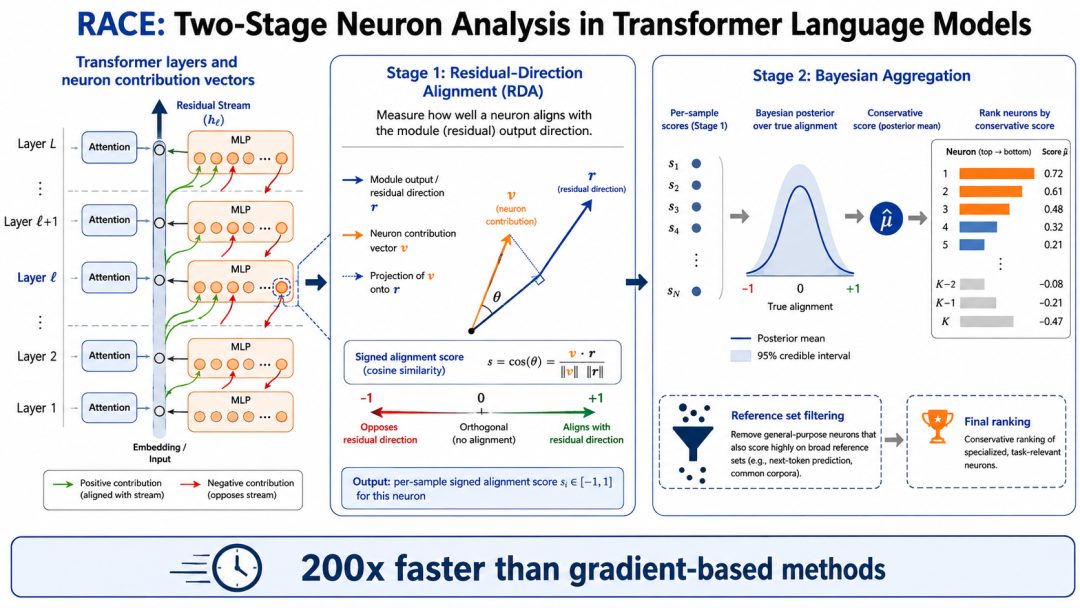
论文简介:在机制可解释性领域,跨整个域发现稳定的神经元行为仍然是一项挑战。现有方法通常依赖实例级的点估计或计算成本高昂的过程,这些方法要么掩盖了群体水平的变异性,要么限制了可扩展的跨域分析。
我们提出 RACE(Residual Alignment for Consistency Estimation, 残差对齐一致性估计),这是一种前向传播统计框架,用于评估 Transformer 神经元跨域的功能一致性。扰动实验表明,与基于梯度的点估计相比,RACE 具有更优的域特异性。同时,词元分布层面的结果验证了所选神经元与目标域之间的关联。此外,其计算开销比基于梯度的方法低两个数量级。

论文标题:Fast-Slow Thinking RM: Efficient Integration of Scalar and Generative Reward Models
论文类型:Main Conference,Long Paper
论文下载:PDF
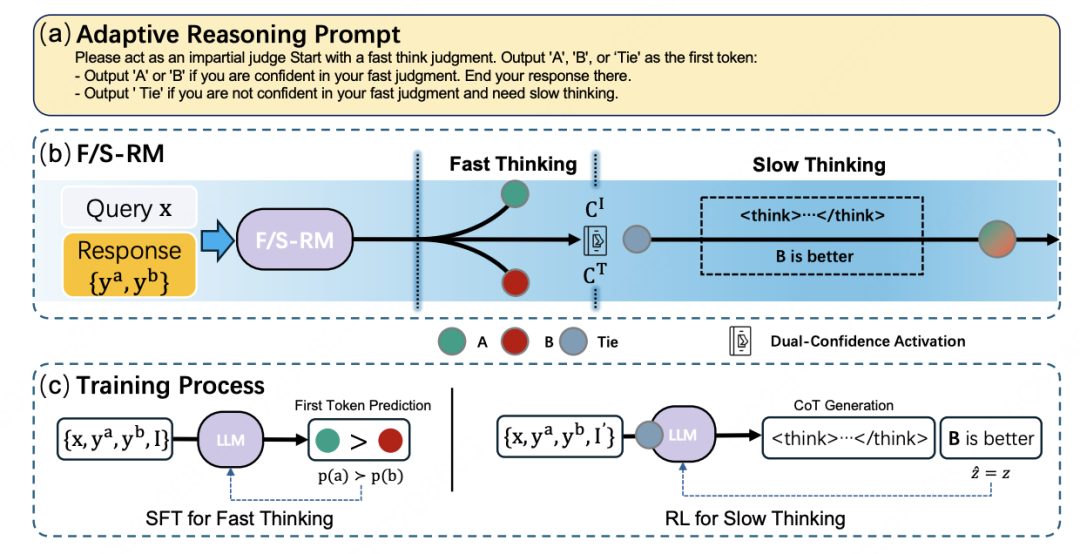
论文简介:在内容审核、客服评测等业务场景中,LLM-as-a-Judge 正逐渐成为一种重要的自动化判断范式。实际应用中,不同样本的判断难度差异很大:大量简单样本可以快速完成决策,而复杂、模糊或低置信度样本往往需要更充分的推理。如何让模型根据样本难度动态选择判断方式,在保证准确率的同时降低推理成本,是这类系统面临的重要问题。
针对这一问题,我们提出快慢思考奖励模型(Fast-Slow Thinking Reward Models, F/S-RM),一种受双加工理论启发的混合判断架构。F/S-RM在单一模型中统一“快思考”与“慢思考”两种模式:面对较简单、判断较明确的样本时,模型通过首个token直接完成快速成对判断;面对更复杂或置信度不足的样本时,则自动激活基于思维链的慢思考进行进一步推理。模型通过双置信度激活机制动态决定是否进入慢思考,从而形成类似“快速判断—疑难升级”的自适应决策流程。
在混合推理模式下,F/S-RM在多个奖励模型评测基准上取得84.3的平均得分,达到当前最优水平,同时将token消耗降低了22.5%。值得一提的是,近期受到广泛关注的 Jev 快速决策模型,在概率与置信度利用方面与 F/S-RM 具有相似的设计思路;F/S-RM 在同一模型内进一步整合了首 token 快速判断与 CoT 慢思考。
基础研发平台/计算和智能平台部/计算平台

论文标题: FG²-GDN: Enhancing Long-Context Gated Delta Networks with Doubly Fine-Grained Control
论文类型: Main Conference,Long Paper
论文下载: PDF
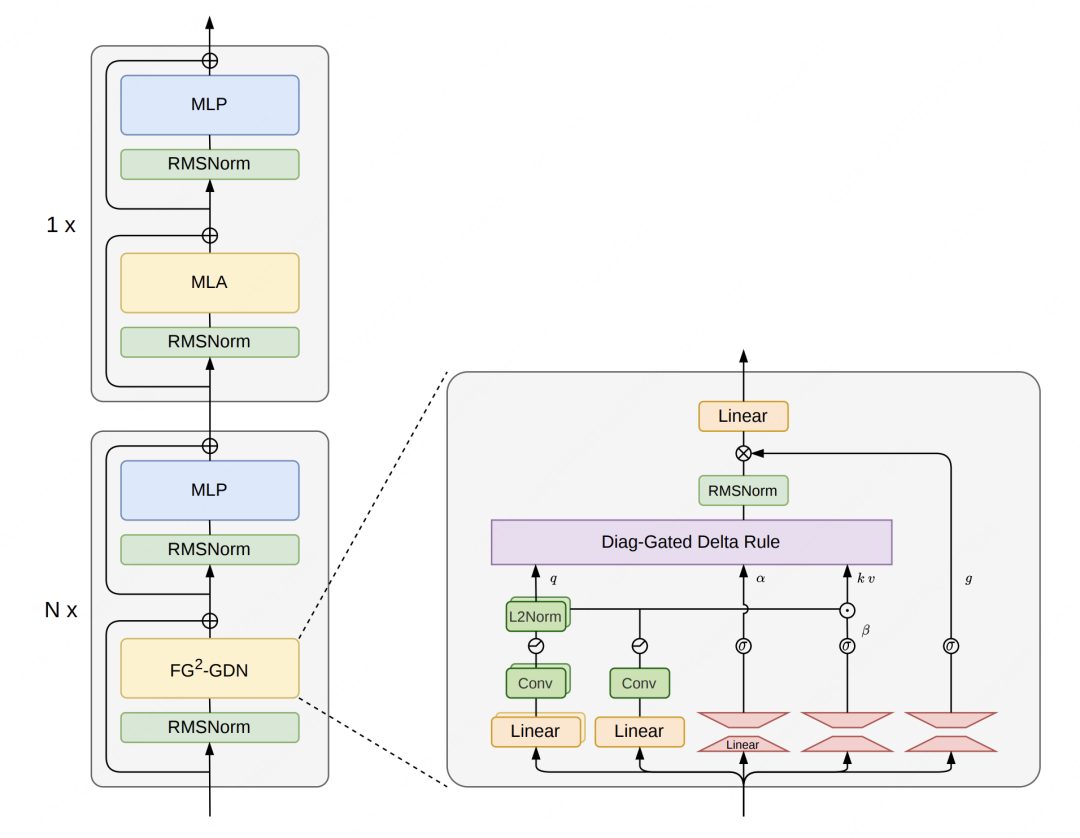
论文简介: 随着大语言模型应用向长文本理解和复杂交互场景拓展,如何兼顾长上下文建模能力与计算效率,成为模型架构设计的重要问题。线性注意力通过递归更新固定大小的记忆状态,为高效长上下文建模提供了新的路径。然而,现有 Kimi Delta Attention(KDA)虽然实现了逐通道的信息遗忘控制,记忆写入仍采用各通道共享的标量更新率,难以根据不同特征的需求灵活调整更新强度。
为此,我们提出双重细粒度门控 Delta 网络 FG²-GDN,将写入率从标量扩展为逐通道向量,使模型能够同时精细控制“保留多少旧信息”和“写入多少新信息”;进一步提出 FG²-GDN+,在逐通道写入的基础上分离键和值的缩放控制,增强记忆更新的灵活性。通过对称平方根缩放设计,该方法保留了 KDA 分块并行算法所需的更新结构,可直接复用其高效计算路径。实验在 340M 和 1.3B 两个模型规模上展开,覆盖语言建模、长上下文检索和真实长文本理解任务。
结果表明,在相同训练设置下,细粒度写入控制提升了语言建模的平均表现,进一步引入键值分离控制的 FG²-GDN+ 在 RULER 和 LongBench 上取得了优于 GDN、KDA 的整体结果,并在超出训练长度的上下文中保持了较好的检索能力。同时,该方法仅引入少量额外参数,预填充效率与 KDA 接近。该研究表明,在细粒度遗忘之外进一步细化写入控制,是提升线性注意力长上下文记忆能力的一条有效路径。
---------- END ----------

❤️❤️❤️ 如果这篇文章对你有帮助,欢迎大家帮忙点赞、评论,分享给更多的小伙伴。⬇️
本文转载自微信公众号「美团技术团队」,查看原文。版权归原作者所有,如有侵权请联系删除。