刚刚!首个SGLang中文教程项目来了!
原创 zero-to-sglang 2026-11-17 23:42 浙江
Datawhale开源
开源贡献:zero-to-sglang团队
Datawhale开源
开源贡献:zero-to-sglang团队
一、 开源初心
大模型进入应用深水区后,推理的成本、延迟和吞吐,逐渐成了决定用户体验与规模化落地的关键。
为了填平从「理论概念」到「工业级源码」之间的鸿沟,Datawhale 与 RadixArk 联合推出了 zero-to-sglang ,首个面向中文学习者、同时提供中英文双语内容的 LLM 推理工程实战教程。
我们希望带你沿着一条最符合工程师直觉的路线前进:先弄清推理底层在做什么,再亲手从零搭建一个 mini-sglang 把核心机制写进代码,接着对照真实的 SGLang 源码看懂前沿优化,最后学会用性能分析工具定位瓶颈,真正参与到 SGLang 社区的开源贡献中。
目前,课程 Part 0 至 Part IV 的全部中英文内容均已完结上线,B 站配套讲解视频也在持续更新中!
项目仓库:https://github.com/datawhalechina/zero-to-sglang中文在线阅读:https://zero-to-sglang.datawhale.cc/ch/配套学习视频:Bilibili 视频合集(https://www.bilibili.com/video/BV1Dg4w6tExD/)离线 PDF 下载:https://github.com/datawhalechina/zero-to-sglang/releases
二、 学习指南
我们将全套课程梳理为五个循序渐进的阶段(Part 0 — Part IV),带你一步步揭开大模型推理系统的黑盒。
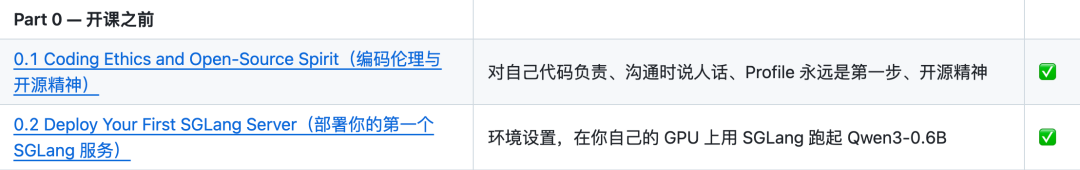
Part 0. 熟悉开源礼仪,跑通你的第一个推理服务
在真正写代码之前,我们先从编码伦理与开源社区精神聊起,学会如何对自己的代码负责、如何在开源社区中高效沟通。随后,教程将带你完成服务器与运行环境配置,在自己的 GPU 上用 SGLang 跑起 Qwen3-0.6B,亲手部署起第一个高可用推理服务。
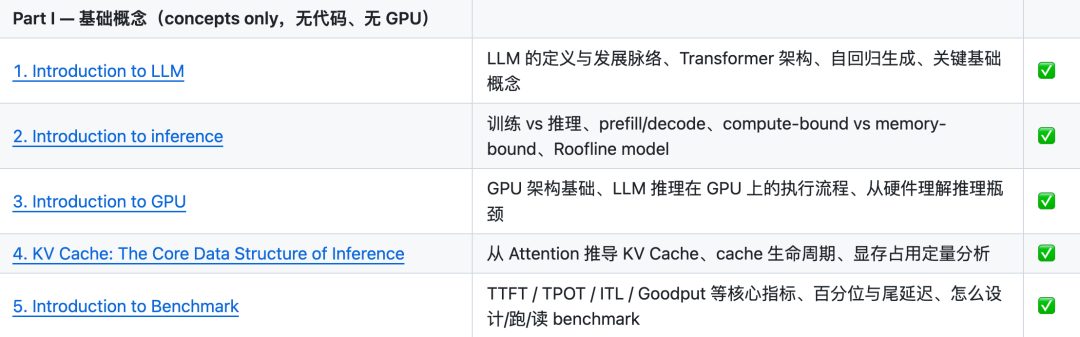
Part 1. 建立推理知识框架,算清计算与显存账本
这一阶段不需要准备 GPU。我们将从大模型结构与 GPU 硬件基础出发,彻底厘清 Prefill 与 Decode 两个阶段的特性差异,理解 KV Cache 的演进,以及计算峰值与显存带宽是如何卡住推理速度的。你还将学会读懂 TTFT(首 Token 延迟)、吞吐量等核心 Benchmark 指标,建立起分析推理性能的第一性原理。
Part 2. 从零手搓 mini-sglang,把核心机制落到代码
懂原理最好的证明就是把它写出来。在这一阶段(大部分代码可在 CPU 上调试),我们将沿着一个推理请求的完整生命周期,从最基础的前向计算与文本生成起步,一步步往里加入 KV Cache、HTTP 并发服务、连续批处理(Continuous Batching)、分页显存管理(PagedAttention)与前缀缓存(RadixAttention),并进一步探索多进程、张量并行(TP)和投机解码,亲手组装出一台五脏俱全的 mini-sglang 引擎。
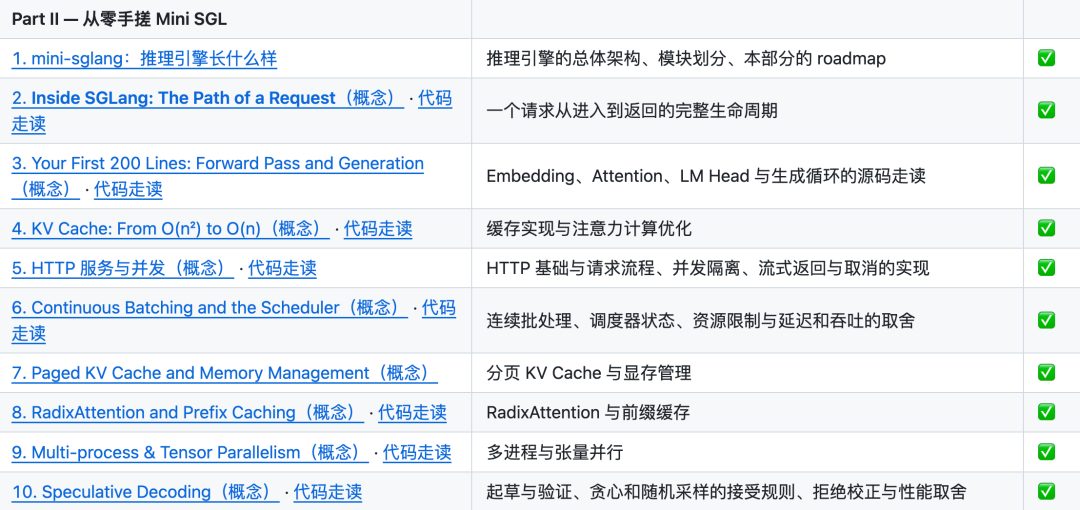
Part 3. 拆解真实 SGLang 源码,读懂工业级前沿优化
有了手搓 mini-sglang 的体感后,这一章带你正式切入真实的 SGLang 工业级源码库。我们将深入解读多种 Attention 后端、量化与低精度推理、分层缓存机制,以及 DP Attention、专家并行(EP)、流水线并行(PP)和 Prefill-Decode(PD)分离架构,帮你弄清这些最前沿的 AI Infra 优化到底在解决什么极端瓶颈、各自又做了哪些工程取舍。
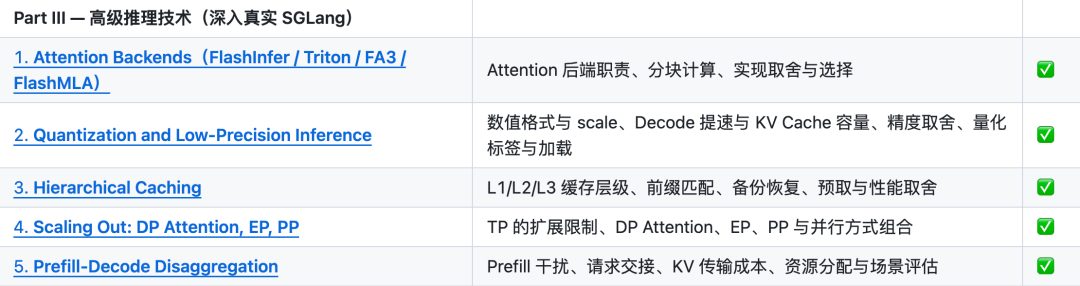
Part 4. 性能剖析与实战协作,完成你的第一次开源 PR
如何从“源码读者”变成“核心贡献者”?最后一章带你学习使用 Cookbook 部署生产级 SGLang,掌握通过 Profiling 与 Trace 分析精准定位性能瓶颈的方法。更重要的是,教程结合真实已合并的 PR 案例,手把手带你走通代码修改、本地验证、提交 PR、运行 CI 到回应 Maintainer Review 的完整协作闭环,助你迈出顶级开源社区贡献的第一步。
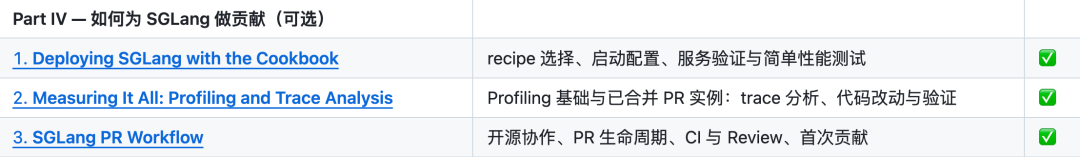
三、 写在最后
在探索大模型推理与 AI Infra 时,我们常会遇到这些卡点:
并发一高延迟就飙升,调参无数却分不清瓶颈在计算还是显存带宽 熟知 Continuous Batching、PD 分离等概念,却说不清代码里怎么实现调度 想啃 SGLang 等主流引擎源码,点进庞大的仓库瞬间迷失方向 向往参与顶级开源项目,却不知如何定位问题、测性能、交出第一个 PR
 开源贡献,点赞在看↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。