狂烧300亿Token、从零手搓108款3D大作!上海创智学院推出首个超长程3D游戏Agent竞技场来了:代码跑通≠好玩,人类盲测胜率差出2.6倍
原创 52CV 2026-11-19 21:28 江苏
狂烧300亿Token手搓108款3D游戏!代码跑通≠好玩,真人盲测胜率差出2.6倍
【导读】 给 Coding Agent 一个空文件夹,让它连续工作数小时、调用上千次工具,从零手搓大型 3D 网页游戏,人类真的爱玩吗?最新研究 3D GameDev Arena 带来 108 个商业级 3D 游戏任务的硬核实测,揭开超长程 Agent 开发最反直觉的 3 大真相。
卷完修 Bug,Coding Agent 又卷向了游戏开发。但过去的基准大多在“温室”里跑:不是单文件 2D 小游戏,就是预置好引擎模板、2D 素材和测试钩子,百步以内便草草收工。真实的 3D 开发截然不同——必须从空文件夹起步,自主搭架构、整合数十个 3D 模型、调物理与镜头。更重要的是:编译通过只是及格线,好不好玩得由玩家说了算。
为此,来自上海创智学院、上海交通大学和复旦大学的研究团队推出 3D GameDev Arena——首个面向超长程、从零构建的 3D 网页游戏 Agent 基准与盲测竞技场。
01 零模板硬刚:空文件夹手搓 108 款 3D 大作切片
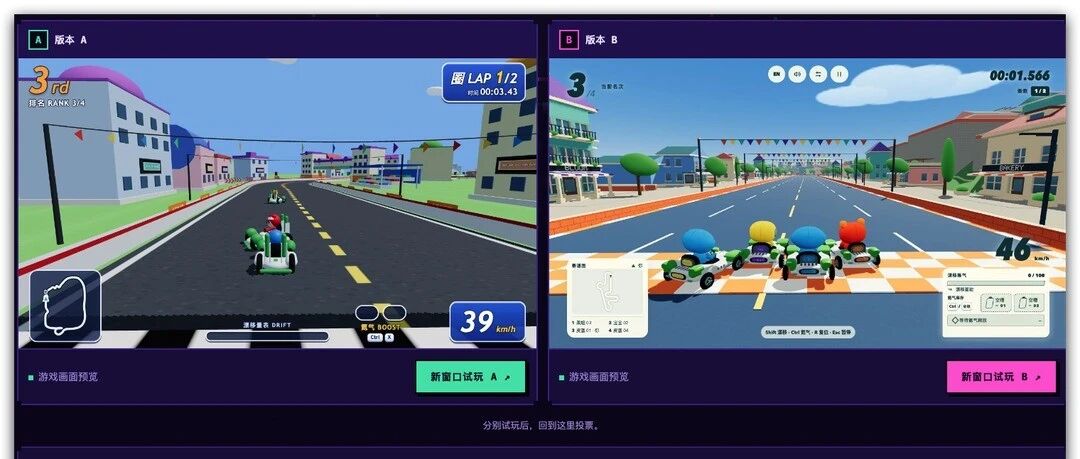
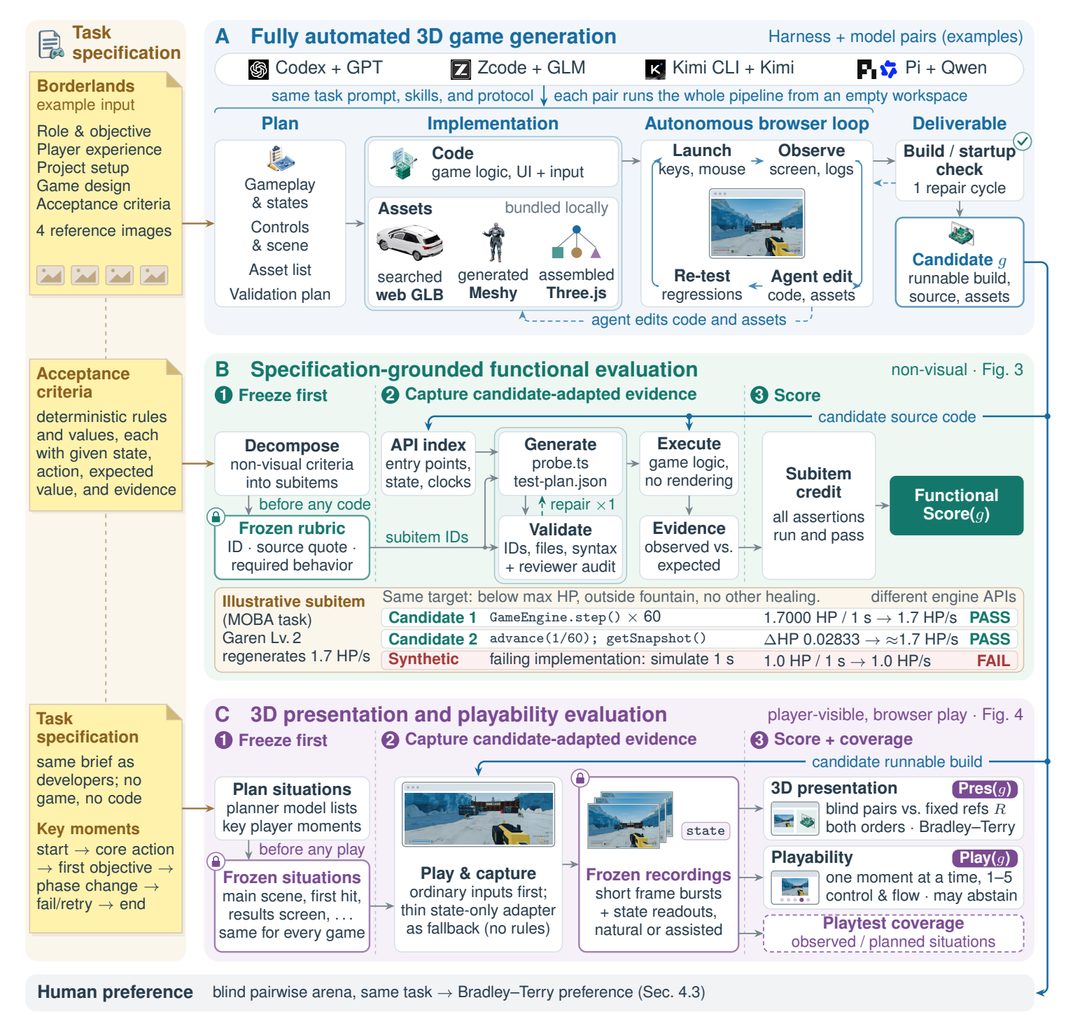
108 个任务、14 大品类:取材自 Steam 与主机畅销大作的“垂直切片”,含 57 个 Medium 和 51 个全 3D 商业/3A 级 Hard 任务(如《英雄联盟》1v1 推塔、《跑跑卡丁车》漂移集气赛、《怪物猎人》Boss 战)。
零模板、零素材、零测试钩子:Agent 仅拿到 2,500~5,100 字策划案和 UI 参考图,工作区全空,必须自行全网检索
.glb模型或调用 Meshy 实时生成 3D 资产。极限超长程工程:单次构建平均需 1,000 次调用、20 个 3D 资产,中位耗时 2.6~7.9 小时。最极限一局跑了 14,407 次调用、消耗 21.3 亿 Token、塞进 608 个资产!
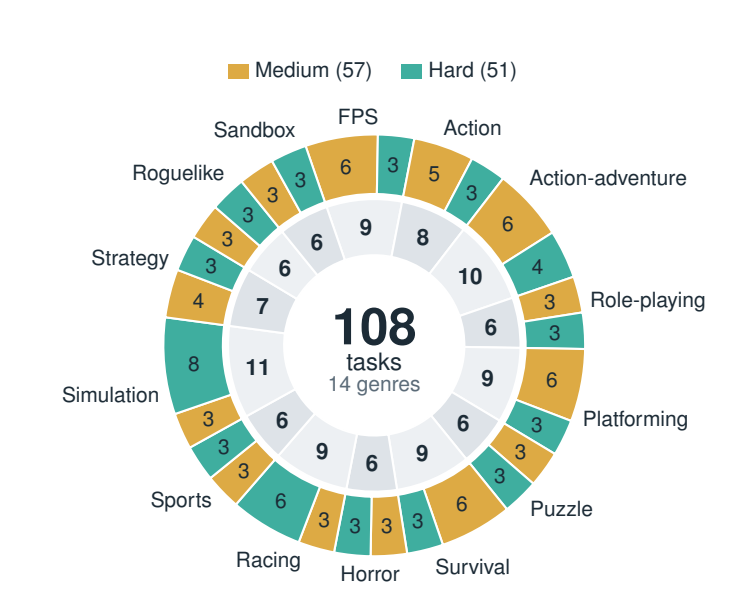
评测分三层:源码自适应的功能验收、浏览器实机录屏的 3D 视觉与可玩性打分,以及真人匿名盲测拟合的 Bradley-Terry(BT)人类偏好胜率。
02 巅峰对决:代码打平,真人胜率差出 2.6 倍
团队在最高推理强度下评测了四大原生配置:codex-gpt-6.1-sol、codex-gpt-6-astra、kimi-k3 和 zcode-glm-5.3。codex-gpt-6.1-sol和codex-gpt-6-astra在代码功能评分上和游戏可玩性上占据领先位置。
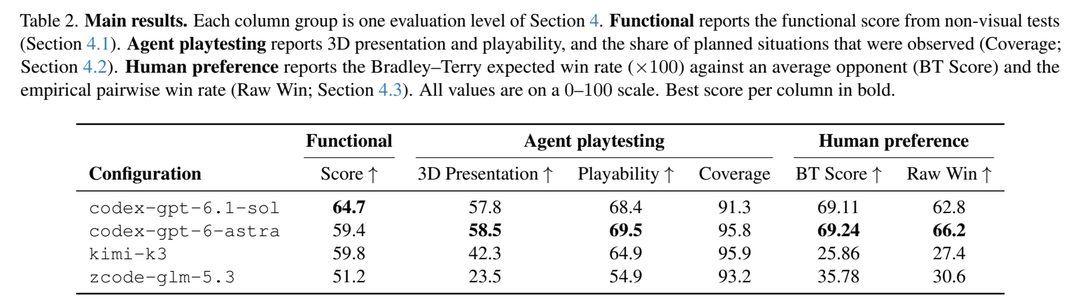
结果直接击碎了“代码跑通 = 好玩”的幻想:
远未攻克:功能分最高的
gpt-6.1-sol仅得 64.7/100,所有配置在试玩指标上均未突破 70 分。越贴近玩家差距越大:
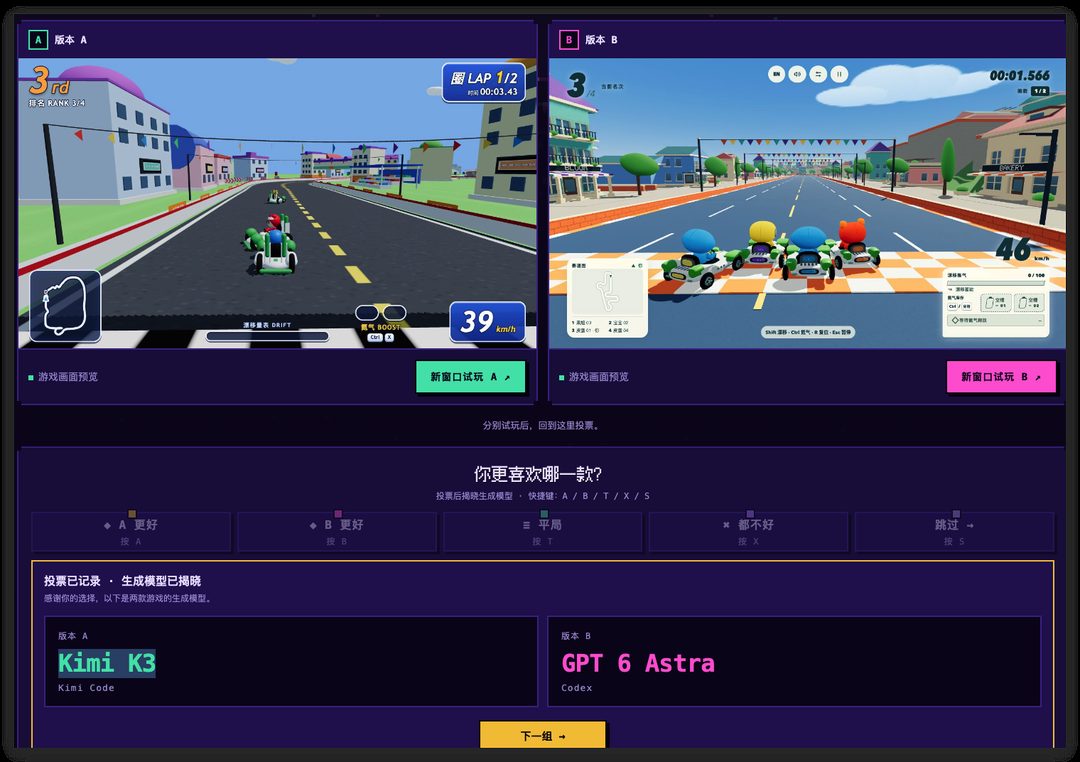
kimi-k3(59.8)与gpt-6-astra(59.4)功能分打平,但真人盲测 BT 胜率后者高达 69.24,是前者(25.86)的 2.6 倍以上!首尾差距在功能分上不足 15 分,在人类偏好上却拉大到 40 分以上。
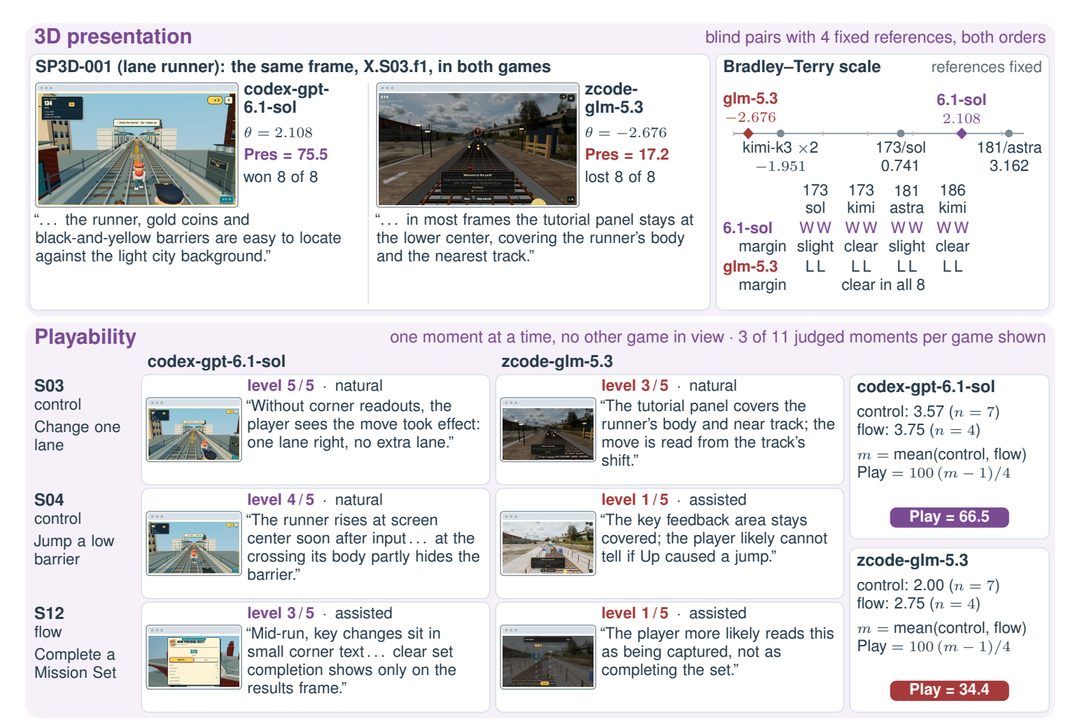
gpt-6.1-sol 视野清晰(8 战全胜);右图 glm-5.3 教程弹窗全程挡住角色与轨道(8 战全败)。03 深度复盘:3 个最反直觉的 Takeaway
Takeaway 1:调试“测什么”比“测多少次”更关键——实机试玩才赢下真玩家
kimi-k3 单局中位调试高达 159.5 次(全场最高),却把 63.5% 耗在静态类型检查与孤立单测(tsc+vitest)上——全程连一帧画面都不渲染,导致后台数值正确、前台却穿模遮挡。
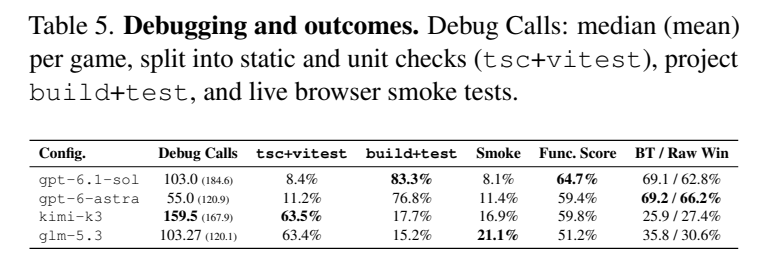
而最受玩家欢迎的 Codex 双雄,将约 90% 的调试预算砸在完整构建、集成测试与浏览器实机检查上。只有把游戏跑起来看画面,多烧的 Token 才能换来玩家好评。
Takeaway 2:好游戏代码极简,狂堆代码与 3D 模型反而“翻车”
人类最爱玩的两个 GPT 配置中位净代码量均不到 3,000 行;kimi-k3(7,572 行)与 glm-5.3(13,824 行)写了 3~6 倍的代码,臃肿文件反而让跨模块状态极易改崩。
3D 资产同样如此:kimi-k3 场均塞进 13 个下载模型 + 60 个几何体,3D 表现却落后头部 16 分以上——不同模型的缩放、朝向与中心点极难对齐;而把 AI 生成的 3D 模型接入实时交互逻辑仍是行业瓶颈(仅 gpt-6-astra 在极少数成品中跑通)。
Takeaway 3:连续跑数小时、上千次调用,Agent 根本不会“失忆”
很多人以为长程任务翻车是因为上下文压缩导致 Agent “忘了目标”。但四阶段(Q1~Q4)日志抽检推翻了这一猜测:所有配置全程目标保持率高达 96%~100%,大任务尾声也稳居 94% 以上。真正区分神作与烂作的,不是记忆力,而是有没有在运行中的游戏里亲眼验收。
结语
3D GameDev Arena 给 Coding Agent 指明了下一站:只盯着终端跑单测已经不够,学会写精简架构、对齐 3D 资产,并像人类一样打开画面“边玩边改”,AI 才能造出真正好玩的游戏。
论文标题:3D GameDev Arena: Benchmarking Coding Agents That Plan, Build, and Playtest extreme Long-Horizon Browser Games
作者:白碧哲、简吉亮、严禹清,陈涛,温颖
作者单位:上海创智学院,上海交通大学,复旦大学,西安交通大学。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。