离开沙箱后,最强 Agent 只做对三分之一:ClawBench 的真实网页大考
52CV 2026-09-17 23:04 江苏
八款前沿大模型在真实网站上替你完成购物、预约、投简历……最强的 Claude Sonnet 4.6 成功率仅 33.3%。实验室里的"高分选手"为何在现实世界频频翻车?本文深度解读 EMNLP 2026 论文 ClawBench: Can AI Agents Complete Everyday Online Tasks?
作者:UBC、Vector Institute、UniPat AI、CMU、滑铁卢大学、上海交大、港科大、清华大学、曼彻斯特大学、复旦大学、里海大学、南京大学等
一、当 AI Agent 走出"温室"
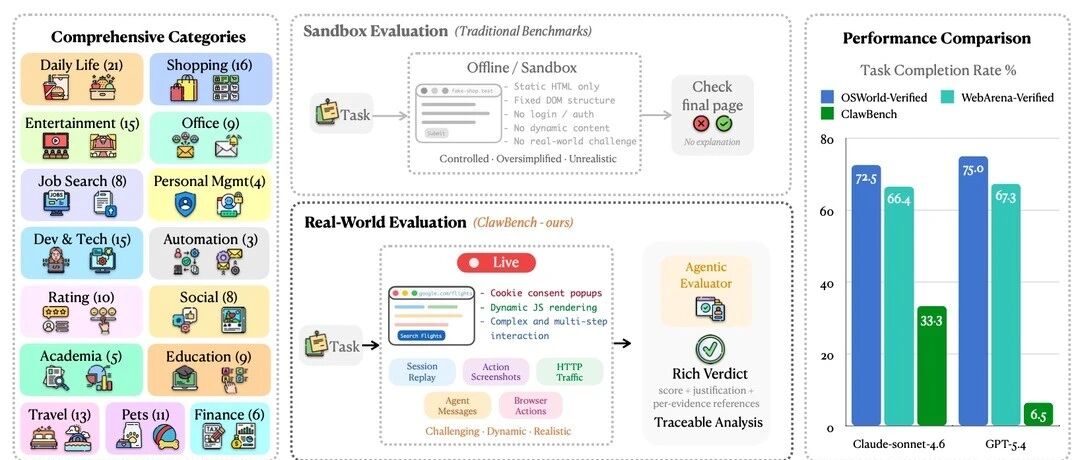
过去两年,AI Agent 在网页任务上的跑分一路飙升。WebArena(Zhou et al., 2024)上部分模型的成功率已接近 80%,OSWorld(Xie et al., 2024)上的最优成绩也在 60% 以上。这让许多人相信:AI 替你上网办事的时代,已经近在眼前。
但这些高分模型,在真实世界中真的也能有同样高分的表现吗?
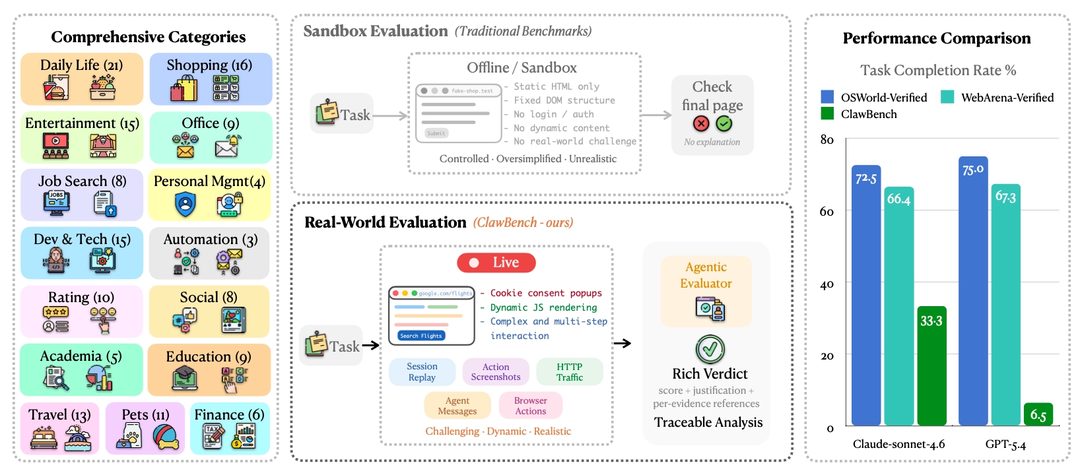
一个关键问题是:现有基准测试几乎都在离线沙箱或静态页面上运行。它们把真实网页的动态 CSS、A/B 测试、验证码、反爬虫机制、区域限制、支付表单校验……这些生产环境中的"日常噪音"统统剥离了。更关键的是,绝大多数基准只测试"读": 让 AI 查找信息、提取答案; 而从未要求 AI 真正在网页上"写":填写复杂的多屏表单、提交订单、预订服务、投递简历。
ClawBench 试图回答如下问题:当 AI Agent 被要求在真实生产环境网站上完成那些你日常需要做的"重型"任务时,它们到底行不行?
ClawBench,一个让 AI agent 在 144 个真实生产环境网站上执行日常任务的新评估框架,结果堪称惨烈。
二、ClawBench 是什么?
ClawBench 是一个包含 153 个日常在线任务的评测框架,横跨 144 个真实生产环境网站、15 个生活类别(购物、金融、工作求职、开发技术、学术、旅行、社交、宠物等 8 大类)。每个任务都需要 Agent 在网站上完成一个"写重型"工作流:下订单、填申请表、预订服务、发送邮件;而不仅仅是查找信息。
2.1 设计三原则
ClawBench 的独特之处在于三个设计选择:
① 日常覆盖(Daily-life coverage)。 任务来源于真实用户的日常网页使用场景,而非人工构造的模板。从在 DoorDash 上点餐、在 Insurify 上获取保险报价,到在 Zillow 上提交租房申请——这就是普通人每周都会遇到的事务。
② 写重型工作流(Write-heavy workflows)。 任务的终点不是"找到正确答案",而是触发一个将要修改服务器状态的终态动作——点击"提交订单"、"确认预订"、"发送申请"。成功与否,取决于 Agent 能否将用户特定信息准确填入表单、通过平台校验逻辑、并在最后一步"敢于"点击那个确认按钮。
③ 真实网页执行 + 安全拦截(Live-web execution with safe evaluation)。 Agent 在真实的生产环境网站上操作,面对的是动态界面、身份验证流、反爬虫防御。ClawBench 的安全机制是最终请求拦截(final-request interception):人类标注员预先识别出每个任务的"终端 HTTP 请求"(那个会真正产生副作用的请求),通过 Chrome 扩展 + CDP 协议在浏览器层面拦截该请求,使其无法到达服务器。此前所有的页面加载、搜索、身份认证、表单交互都在真实网站上正常进行——Agent 感受到的是完整的真实环境压力,但不会真的替你刷了信用卡。
2.2 五层轨迹 + Agent-as-Judge 评估
ClawBench 的每次运行被记录为五层同步轨迹:完整会话视频, 逐步截图, HTTP 流量, Agent 消息, 浏览器动作。
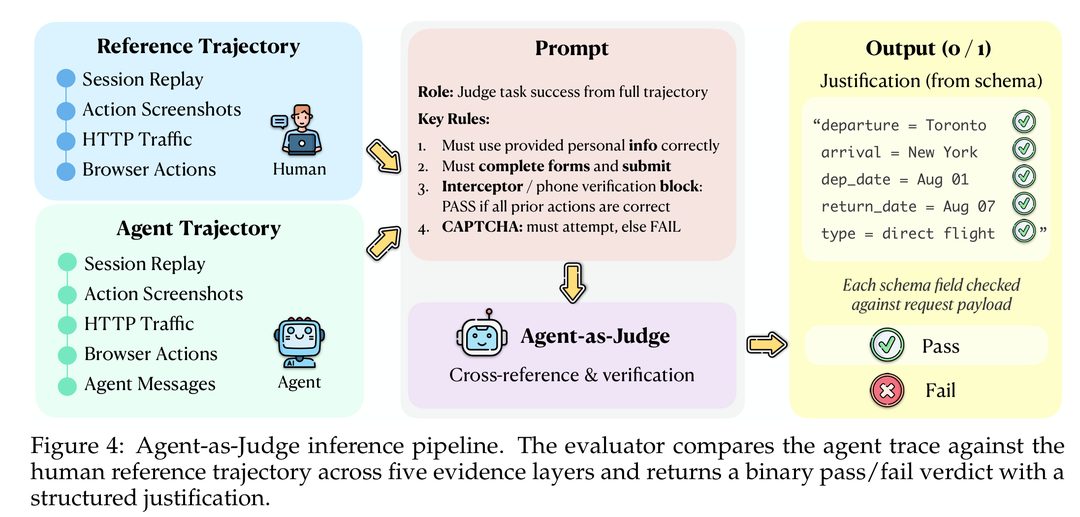
所有 153 个任务都有人类参考轨迹(human reference trajectory):标注员在相同环境下手动完成任务并记录所有中间状态和最终提交数据。Agent-as-Judge(以 Claude Sonnet 4.6 为基础模型)将 Agent 轨迹与人类参考进行对比,综合所有证据给出二元通过/失败判定。在人工审计的子集上,Judge 与人类判定的 raw agreement 达到 84.97%–93.46%。
三、实验结果:高分选手集体翻车
3.1 整体成功率
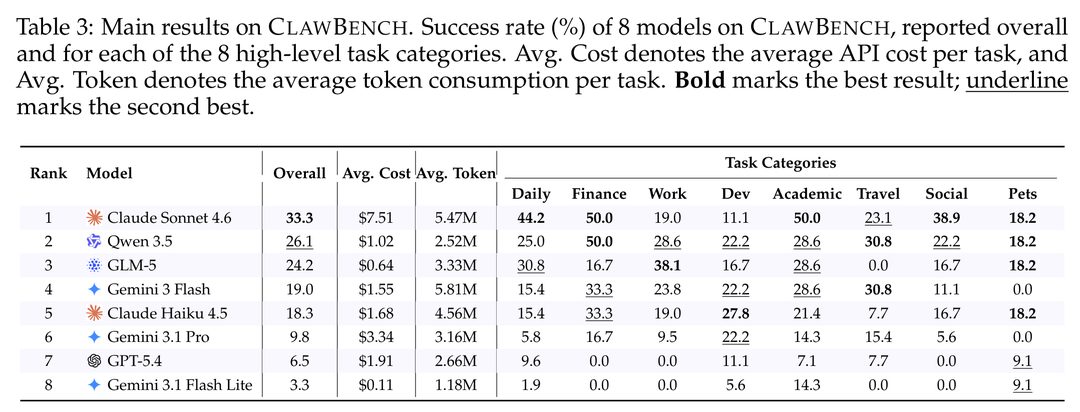
论文评估了 8 个前沿模型,所有模型共享相同的 OpenClaw 浏览器 Agent 框架(提供导航、点击、输入、滚动、页面观察等工具),在相同容器环境中运行:
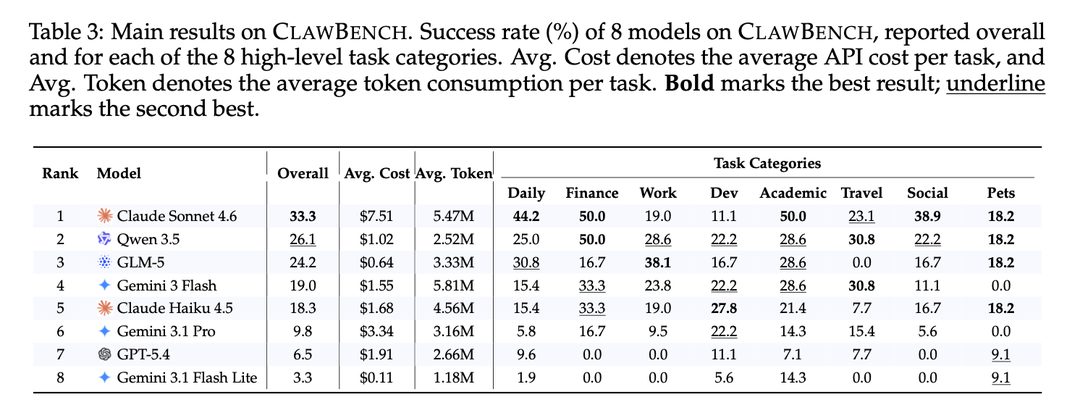
最引人注目的不是排名,而是整体天花板之低。 排名第一的 Claude Sonnet 4.6 在 WebArena 上可达~80%,在 OSWorld 上超过 60%,但在 ClawBench 上骤降至 33.3%。GPT-5.4 更让人意外,仅 6.5% 的成功率,平均每个任务只发出 13 次工具调用即提前退出(early termination),而非高效完成任务。
3.2 任务级饱和度:153 个任务中 68 个无人能解
更值得注意的是,低分不是少数异常任务拉低的。153 个任务中,68 个(44.4%)没有任何模型能够完成;只有一个任务被 8 个模型中的 7 个解决;没有任何任务被全部 8 个模型通过。平均每个任务的通过率仅 0.176,中位数 0.125。
这说明 ClawBench 在任务级别远未饱和。它是一个几乎未被攻克的难题集。
3.3 领域差异:没有全能选手
模型在不同类别上的表现呈现显著的非均匀分布。Claude Sonnet 4.6 在 Daily(44.2%)、Academic(50%)、Social(38.9%)类别领先;Qwen 3.5 在 Finance(50%)和 Travel(30.8%)上表现突出;GLM-5 在 Work(38.1%)类别最强;Claude Haiku 4.5 则在 Dev(27.8%)类领先。
同一个模型可能在购物场景游刃有余,在求职和旅行预订上却寸步难行。 这暗示当前 AI Agent 的能力迁移远非均匀——被测试的不是泛化的"网页操作能力",而是模型在面对特定类型界面和交互模式时的碎片化表现。
3.4 成本-性能权衡
GLM-5 是性价比之王——$0.64/任务获得 24.2% 的成功率;Claude Sonnet 4.6 是精度天花板——33.3% 但成本是 GLM-5 的 12 倍。Qwen 3.5 展现了令人印象深刻的 token 效率——仅 2.52M token/任务却达到 26.1% 成功率,是"每 SR 百分点最低 token 预算"的模型。
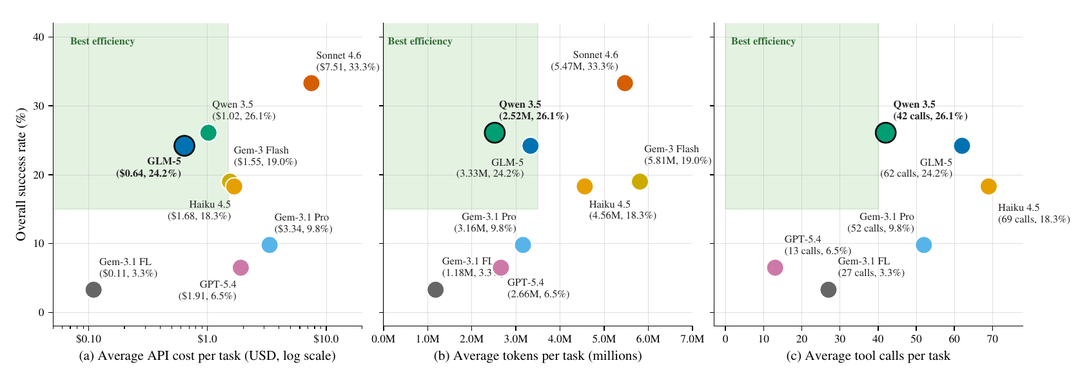
但花钱≠变强。 Gemini 3 Flash 花费 5.81M token/任务,成功率却只有 19.0%;GPT-5.4 花费 2.66M token/任务仅获 6.5% 成功率——这钱主要花在了提前退出前的无效操作上。
四、失败分析:不只是"推理能力不足"
ClawBench 的真正价值不在于又一个排行榜,而在于它对失败模式的精细诊断。论文分析了 1,224 次 Agent 运行(8 模型 × 153 任务)的五层轨迹,揭示了四个层次的问题。
4.1 失败的轨迹反而消耗更多交互
一个反直觉发现:失败的运行往往比成功的运行发出更多的工具调用。 Claude Sonnet 4.6 在成功轨迹中位数 64 次 tool calls,在失败轨迹中升至 120 次(极端值达 354 次)。Gemini 3 Flash 的成功中位数 45 次,失败中位数 74 次。
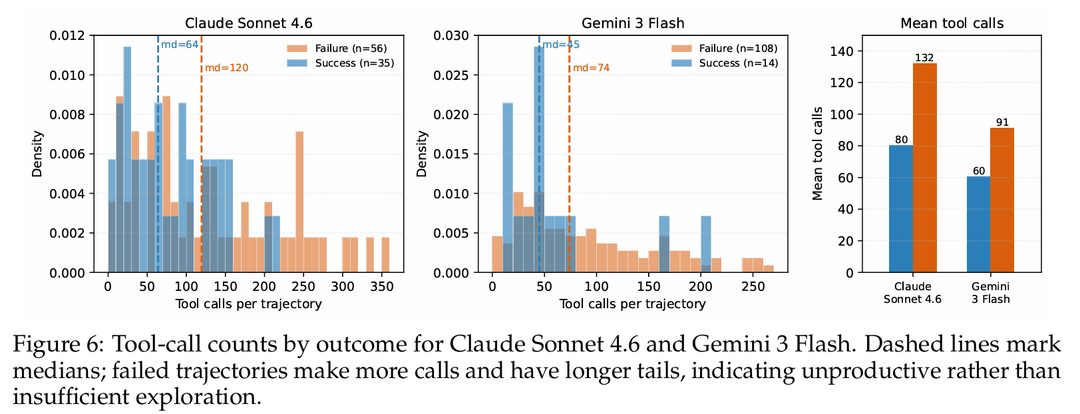
这意味着失败不是"探索不够"——恰恰相反,Agent 陷入了无生产力的重试死循环:反复撞上反爬虫墙、反复截图重判页面状态、反复尝试到达最终提交页却始终不敢按下那个按钮。
4.2 "最后一公里"犹豫
Agent 的工具调用构成揭示了更微妙的问题。成功和失败的轨迹在普通操作(点击 20-30%、输入 15-28%)上没有本质区别。但失败轨迹中的 "最终提交"类操作(点击 Submit、Confirm、Place Order)占比一致偏低。
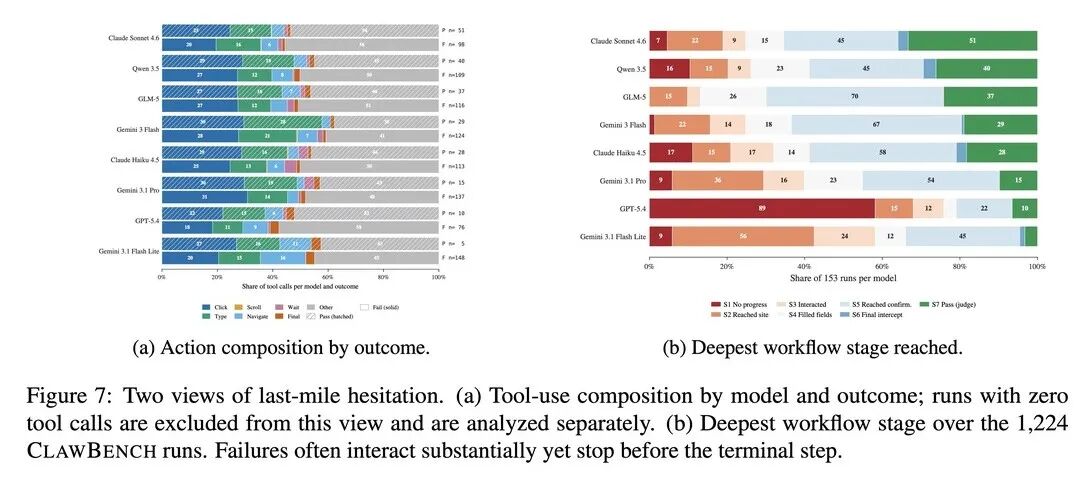
工作流阶段分析将这一现象量化:八个模型中的六个,大量失败集中在 S5(最终确认步骤)——Agent 已经走到了提交前的最后一步,却没有发起那个改变状态的最终请求。这就是论文所称的 "last-mile hesitation"(最后一公里犹豫)。
4.3 各模型的失败模式截然不同
同样是低成功率,背后的失败机制完全不同:
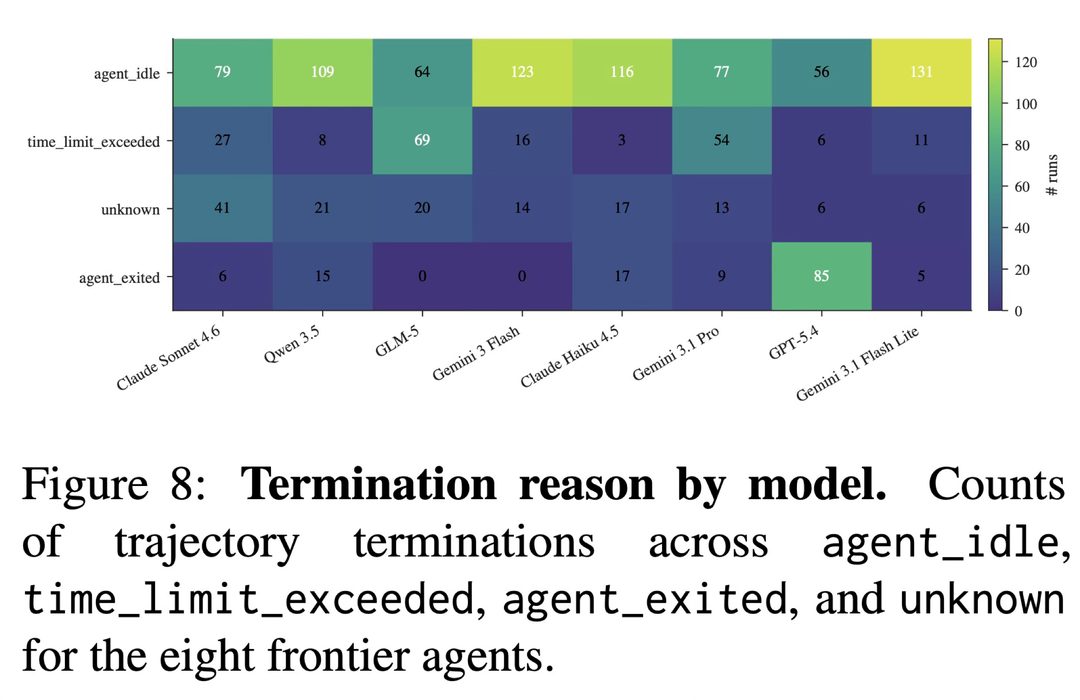
Gemini 3.1 Flash Lite(3.3%):131/153 次运行因
agent_idle(无动作超时)终止——它不是"做错",而是常常根本没开始做。GLM-5(24.2%):69/153 次运行触达 30 分钟 wall-clock 上限——它很努力,但陷入了无生产力的耗时循环。
GPT-5.4(6.5%):85/153 次运行以
agent_exited(主动退出)结束——它在还有时间的情况下主动放弃。
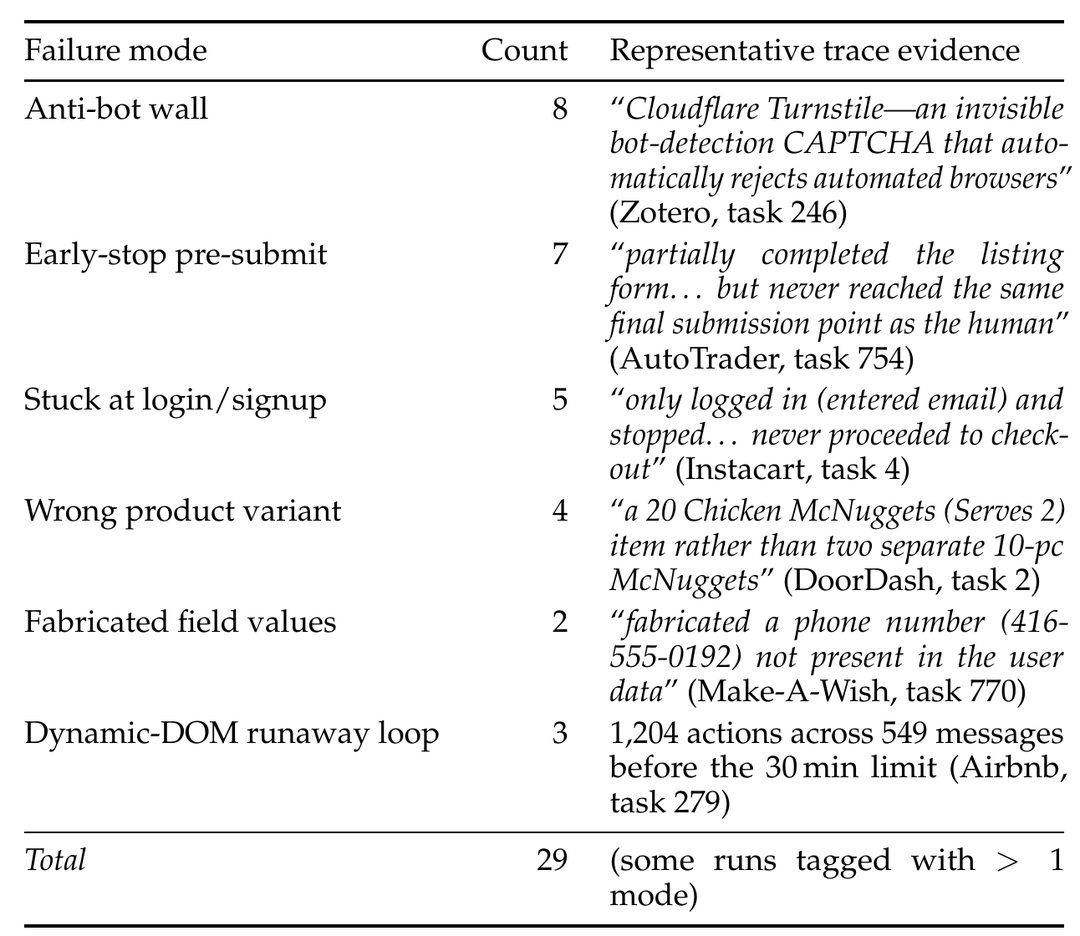
这些差异说明:评估真实网页 Agent 需要多维度指标——防止提前退出、在真实网站摩擦中持续行动、以及在最后一步敢于"确认",是三件不同的事情。
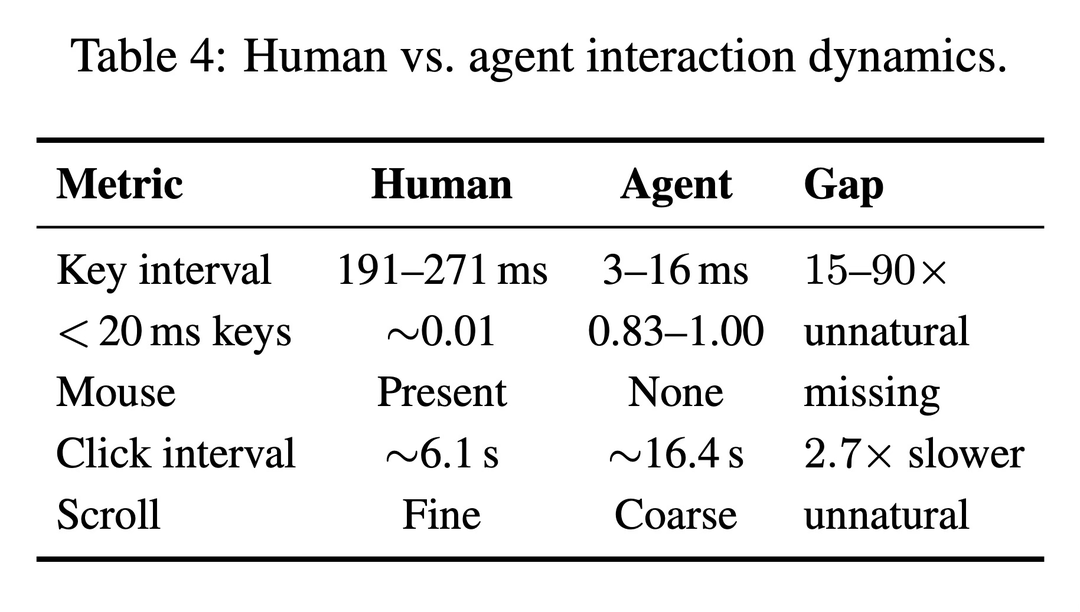
4.4 人类 vs Agent:交互指纹的天壤之别
论文对比了人类和 Agent 在相同 Chromium 环境下的交互动力学特征:Agent 的键盘输入速度是人类肉眼可见的"瞬间填满"——83% 以上的按键间隔小于 20ms。这不仅仅是"快得不像人",而是现代反爬虫系统正是通过这些特征检测和拦截自动化流量。Agent 在打字速度、鼠标轨迹、滚动方式上的"非人指纹",很大程度上解释了为什么它们频繁被 Cloudflare Turnstile、DataDome 等反爬系统拦截。
五、典型案例:从轨迹看翻车现场
论文提供了多个详细的案例研究,以下是最具代表性的三个。
案例 1:"最后一公里"弃单(Sonnet 4.6, Soko Glam)
任务:在韩国护肤品网站 Soko Glam 上,购买一瓶洁面乳和一瓶精华液,加入购物车并完成结账。
Sonnet 4.6 几乎完美执行了整个流程:定位到正确商品集合、添加两件商品、进入结账页面、开始填写配送地址(邮箱、名、姓均正确填入),但——在输入街道地址的中途停止了。没有点击"Continue to Shipping",没有发出最终提交请求。Judge 判定:失败。
"每一步准备操作都是正确的;失败的原因仅仅是缺失了最终的那个提交动作。如果仅靠 Schema 检查拦截请求,这里会给出假阳性——这正是为什么需要人类参考轨迹验证。差距在于'承诺',而非导航或规划能力。"
案例 2:反爬城墙与平台漂移(GLM-5, Zillow)
任务:在 Zillow 上搜索多伦多市中心月租 $3500 以下的一居室公寓,选择一间并提交租赁申请。
GLM-5 到达 Zillow 后立即被 CAPTCHA 阻止,反复尝试不同入口均失败后,它自行切换到了 viewit.ca——一个完全不同的网站——在那里只到达了搜索框,最终以 agent_idle 结束。
"Agent 正确识别了障碍(CAPTCHA),但这没有转化为恢复策略。平台漂移加剧了失败:切换网站既未完成任务,也违反了显式的平台约束。"
案例 3:虚假成功宣告(Sonnet 4.6, DoorDash)
任务:在 DoorDash 下单:一个 Big Mac + 一份 20 块麦乐鸡,选择最快配送。
Sonnet 4.6 导航到了正确平台、添加了商品,然后断言"两种商品都已正确添加"。但实际发送的终端请求中缺少必需的 cartId 字段,验证器报错——订单根本没有被创建。Agent 的内部成功信号与实际服务器状态完全脱钩。 自报完成 ≠ 实际成功。这恰恰印证了 ClawBench 需要依靠被拦截的请求数据和人类参考来验证,而非信任 Agent 的自我评估。
案例 4:鲁棒性可能比预想的更重要 (Qwen 3.5 × Insurify 车险报价)
任务:在 Insurify 上完成一份汽车保险报价:填写个人信息、驾驶员信息、车辆信息、居住信息、保险覆盖需求,走完约 40 屏的级联表单,拿到最终报价对比页面。
这是 ClawBench 里最复杂的长表单任务之一。在全体模型中,Qwen 3.5 的表现最为惊艳:160 次操作、94 个 turn、499 秒。Agent 的策略是单调的“截图→理解→填一个字段→截图→理解→填下一个字段”循环,没有回溯与多余操作。中途解决了两个级联依赖的坑:一个是加拿大邮政编码被美国 ZIP 格式校验拒绝(Qwen 把同样的数字重新输入为 US ZIP 格式通过了),另一个是在一个 split date 控件上需要切换输入方式。两次问题都自行恢复,没有卡死。最终成功导航到Insurify, 用个人信息和车辆详情完成了车险报价表单,获得最终报价结果和保险方案对比。
针对该任务,GPT-5.4 在 0 次操作时就退出了,Gemini 3.1 Flash Lite 在 9 次操作后闲置终止。这两家闭源模型完全失败的任务,被一个开源模型用最朴实的方法完成了。成功的关键因素不是什么高级推理能力,而是极其朴素的执行纪律:一屏一次推进、不回溯、缺信息用保守默认值、遇到校验错误换格式重试。这暗示了当前 web agent 的瓶颈可能不在模型的聪明程度,而在于交互框架的鲁棒性设计。
案例 5:行为策略导致不同结果(Qwen 3.5, GPT-5.4, Gemini 3 Flash,Doodle 日历排期)
任务:在 Doodle 上创建一个多时段投票,供小组选择会议时间。
论文选了三个模型的轨迹做对比。同一个任务,不同的模型间因为执行纪律,效果存在巨大差距: Qwen 3.5 朴素策略(成功):40 个 assistant turn,约 4.5 分钟完成。策略非常朴实。把日历当日历用,一个时间格一个时间格地线性推进。中途发现某一步走了弯路,自我纠正后继续。没有炫技,没有多余的 JavaScript 注入,就是老实填表。
GPT-5.4 过度工程化+遇挫即退(提前放弃):47 个 turn,有效活动时间约 5 分钟。在同一个时间/时区选择网格上卡住后,GPT-5.4 的方案是写一段 JavaScript 代码来自动化绕过这个 UI 组件:结果代码跑失败了,然后它就退出了。
Gemini 3 Flash 陷入死循环:163 个 turn,整整跑了 25 分钟直到触碰超时上限。在同一个时间/时区网格上陷入无状态变化的死循环:反复截图、反复尝试同样的操作、反复得到同样的结果。论文中使用thrashing(徒劳抖动)来描述这一状态。
三个模型在任务开始时的规划都是正确的,差距出在执行纪律上:Qwen 线性推进、遇错自纠;GPT 过度设计、一挫即退;Gemini 僵死在同一个 UI 组件上反复摩擦。这不是知识差距,而是行为策略的差距。
六、启示与反思
ClawBench 的发现超出了"网页 Agent 还需要改进"这一泛泛结论,给出了几个具体的行业启示:
实验室跑分 ≠ 真实世界能力。 同一模型在 WebArena 上 80%+,在 ClawBench 上 33%——40+ 个百分点的差距暗示,当前主流评测框架系统性高估了 Agent 的实际能力。真实网页的复杂性(动态 DOM、反爬虫、表单校验、认证流)构成了一道沙箱无法模拟的"现实鸿沟"。
Agent 失败是多维度的,需要分层诊断。 单看成功率会掩盖本质差异:有的模型因提前退出而失败(GPT-5.4),有的因死循环耗尽时间而失败(GLM-5),有的因在最后一刻犹豫而失败(多个模型)。五层轨迹录制为此提供了必要的可见性。 3. "敢于确认"是一个被忽视的能力维度。 写重型任务区别于读任务的本质,在于最后那一步——点击 Submit、Confirm、Place Order。ClawBench 发现了惊人的"最后一公里问题":Agent 走到最后一步之前,却缺乏执行写操作的"承诺意志"。这可能根源于 RLHF 安全训练——模型被训练得对具有现实后果的操作过度保守。
交互行为本身就是一个安全信号。 人类与 Agent 的交互指纹差异巨大(按键速度差 15-90 倍,鼠标轨迹完全缺失),这既是反爬虫系统拦截 Agent 的原因,也是未来 Agent 需要学习的"行为伪装"能力。让 Agent"更像人地操作网页",不仅是性能优化,更是生存技能。
真实网页评测的成本和可复现性需要权衡。 ClawBench 选择了生态效度优先——在真实网站上评测不可避免地引入网站布局变化、A/B 测试、地域差异等噪声。论文通过人类参考轨迹、拦截 payload 和五层轨迹记录来缓解复现性问题,但单次运行的成本(需要实时会话、模型调用、网络检测、轨迹判定)远高于沙箱评测。
结语
ClawBench提供了一个针对真实日常生活工作流的测试评估框架,为评估下一代AI Agent提供了一个直面真实世界未解决问题的测试平台,允许用户在真实生产环境中的网站上运行,保留了现实世界网页环境的完整复杂性、动态特性和交互挑战,并确保在不产生现实副作用的情况下安全评估。
ClawBench 的价值不仅仅在于给出"谁家模型最强"的榜单,更是重新校准了我们对 AI Agent 真实能力的预期。当一个模型在 WebArena 上拿到 80% 却在真实网购任务上翻车时,问题不在于模型排名,而在于我们一直以来的评测方式。 从"读网页"到"写网页",从沙箱到生产环境,从虚拟页面到反爬虫系统。每一个跨越都在提醒我们:AI 替你上网办事这件事,比想象中难得多。当前模型在执行真实世界任务时仍然存有巨大短板与差距。解决这些问题,将是我们迈向真正通用AI助手的关键一步。
Paper: ClawBench: Can AI Agents Complete Everyday Online Tasks? (EMNLP 2026)