ECCV 2026 最佳论文提名 | Meta现实实验室与英伟达联合提出LSRM:大尺度稀疏重建模型打破前向3D纹理模糊瓶颈
原创 CV君 2026-09-16 21:54 江苏
三维长上下文新范式
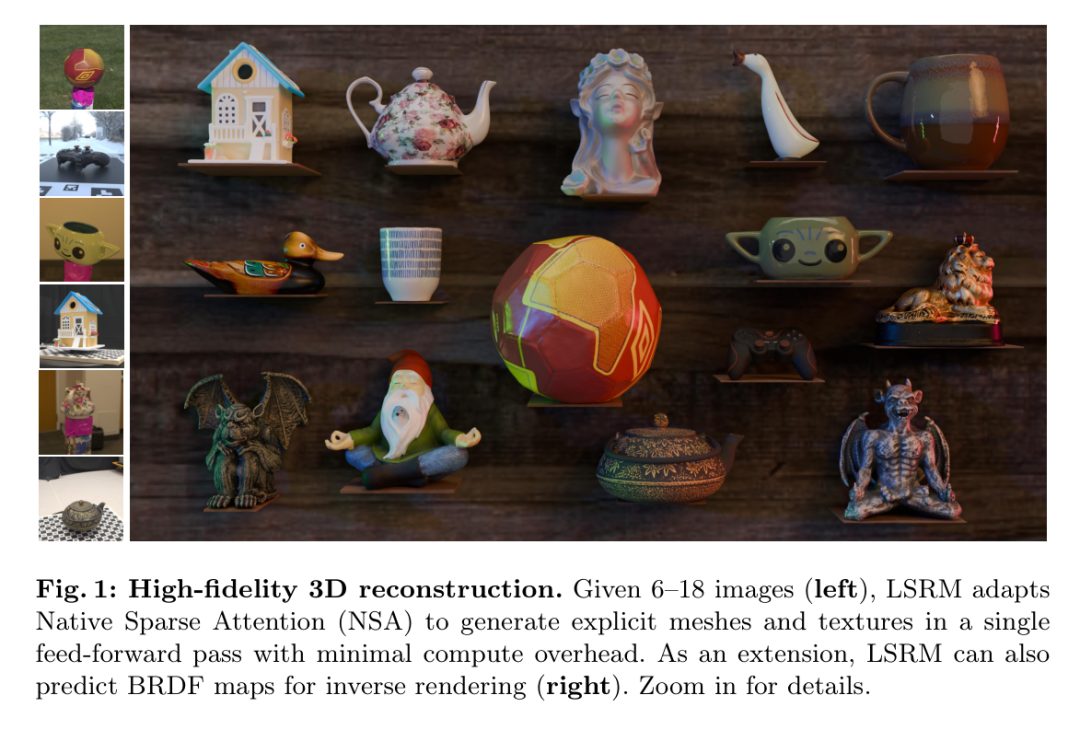
古人论画常叹“得其形易,传其神难”——过去几年的前向三维大模型亦面临同样的尴尬:仅需数秒虽能拟合几何轮廓,但一旦拉近镜头,商标涂抹、字符糊成色块、面容走样变形等顽疾便无所遁形,感知质量被传统耗时漫长的密集优化管线甩在身后。
由 Meta 现实实验室与英伟达联合推出的重磅力作 LSRM 彻底打破了这一僵局。研究团队直击前向重建的算力与显存瓶颈,针对三维任务重塑原生稀疏注意力(NSA),将活跃三维物体 Token 容量猛增 20 倍、图像 Token 提升逾 2 倍。
在权威 GSO 评测中,LSRM 斩获了高达 33.08 dB 的 PSNR(净增 2.43 dB),感知损失 LPIPS 更是骤降 48.1%,以单次前向的惊人速度实现了以往密集多视角优化方能企及的微米级锐利纹理与逆向渲染质量。
背景与动机
在基于物体的三维重建与逆向渲染任务中,基于优化的渲染管线(如 NVDiffrecMC、NeuralPBIR 等)依赖密集的视角采样,虽然外观细节精准,但针对单一物体通常需要耗费数十分钟至数小时进行梯度反传,且在高反光材质上容易优化崩溃。与之相对,前向模型将重建任务抽象为序列到序列的映射,几秒内即可输出显式三维表征。
但是,前向模型重建纹理的清晰度一直无法令人满意。根本原因在于序列上下文窗口的容量受限。三维体素网格的计算量和显存占用随空间分辨率呈三次方增长,单纯提升特征图与三维网格分辨率,会导致 GPU 显存迅速耗尽。为此,业界此前多采用三平面(Triplane)或六平面(Hexaplane)等紧凑压缩表达,或者在后处理阶段引入生成式纹理修复模型。然而,紧凑表达的特征容量上限锁死了精细纹理的表达空间,而后处理扩散模型往往难以保证多视角确定性与高频几何的一致性。
能否直接在全三维空间中大幅扩展活跃 Token 的上下文长度?自然语言处理中常借助稀疏注意力处理超长序列,例如原生稀疏注意力(Native Sparse Attention, NSA)通过硬件对齐的动态块选择大幅压缩了 KV-Cache。然而,直接将文本领域的稀疏注意力机制迁移至三维前向网络面临两大严峻挑战:
跨模态空间对应关系漂移:传统的 NSA 依赖键值压缩特征计算注意力得分以挑选重要的键值块(KV-Blocks)。但在深浅不一的 Transformer 层中,浅层网络尚未建立清晰的 2D 图像与 3D 空间的物理映射,注意力打分容易出现空间错位。
稀疏负载严重失衡:物体表面形状各异,导致各样本活跃的稀疏 Token 数量差异悬殊,在多卡并行训练时产生严重的掉队(Straggler)问题。
针对上述瓶颈,研究团队从模型架构、几何路由和序列并行三个维度对稀疏注意力进行了全面重构。
方法详解
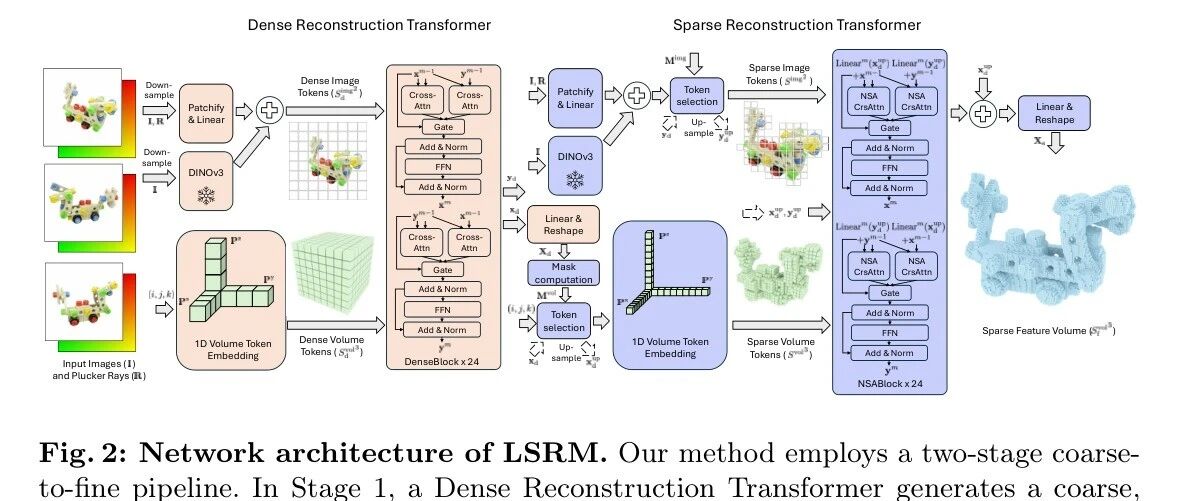
LSRM 采用了两阶段粗到细(Coarse-to-Fine)的网络架构,分为阶段一的低分辨率稠密重建模型与阶段二的高分辨率稀疏残差重建模型。
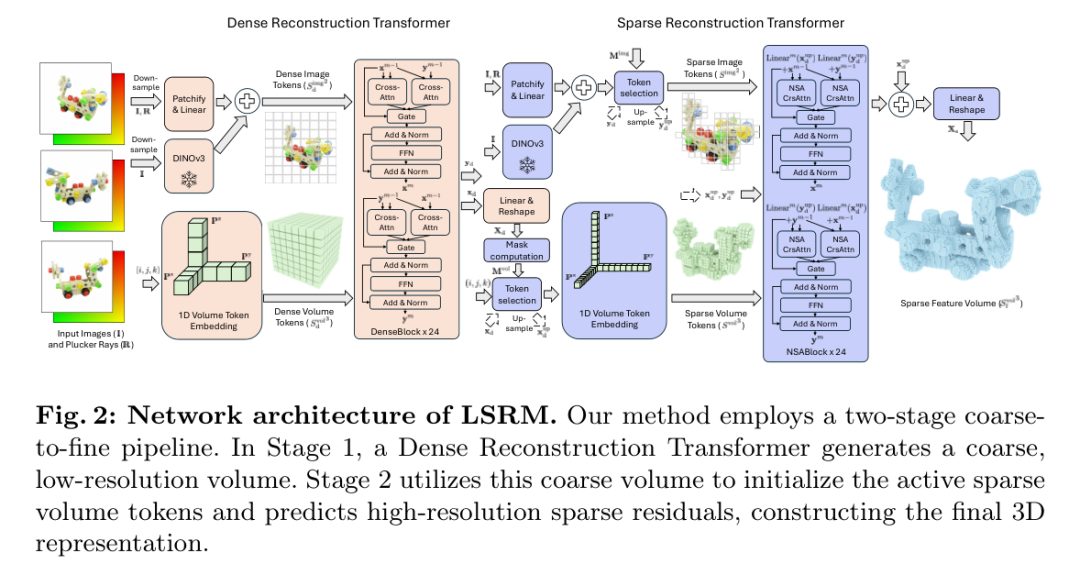
阶段一:粗尺度稠密重建基座
模型输入为 张分辨率为 的位姿图像,利用 Plücker 光线显式编码相机几何参数。
- 图像 Token 化:从图像中提取 的非重叠图像块(Patch),得到单视角分辨率为 的 Patch 序列。为了加速收敛并增强通用泛化性,模型结合了冻结的 DINOv3 视觉特征,其联合表征形式如下:
体素 Token 化与解耦分解:为了避免后续扩展至高分辨率网格时参数爆炸,体素 Token 并非直接分配三维密集可学习参数,而是沿空间三轴分解为三个独立的一维位置编码 , , (其中 )。空间坐标 处的 Token 初始嵌入为各轴的分量逐元素相加:
门控交叉注意力骨干与体绘制:稠密 Transformer 由 24 层 DenseBlock 构成,隐藏层维度为 1024。网络采用分组查询注意力(Grouped-Query Attention, GQA),配置 32 个查询头(Query Heads)与仅 2 个键值头(KV Heads)。不同于传统的单体自注意力,DenseBlock 采用门控机制将自注意力与交叉注意力解耦:
其中门控权重 通过线性层与 Sigmoid 激活动态生成。最终输出的体素 Token 经线性层上采样 4 倍,形成分辨率为 、通道数 的稠密特征体 。连续采样点 通过三线性插值查询特征向量 ,送入轻量 MLP 解码符号距离函数(SDF)与材质属性,通过 VolSDF 框架实现可微分体绘制。
阶段二:长上下文稀疏残差演进
在阶段二中,图像与体素分辨率大幅提高(如 )。
- 活跃 Token 稀疏筛选:图像部分仅保留前景掩码内的有效 Patch。体素部分则借助阶段一已收敛的粗网格特征体 ,在每个体素坐标内均匀采样 64 个点并评估 SDF 值 ,仅保留距离表面阈值 范围内或符号发生交变的体素生成活跃 Token:
空间块划分与键值压缩:为避免打乱空间几何邻近性,活跃 Token 被组织为二维 (图像)与三维 (体素)的空间块。每个块内的 Token 经过残差模块(ResBlock)和块内平均池化(AvgPool),生成供 NSA 使用的块级压缩键值对 与 。
- 稀疏残差学习机制:稀疏 Transformer 的权重完全从阶段一初始化,将注意力模块无缝替换为基于 Triton 内核实现的 NSACrossAttn。重要的是,网络并非从零回归细网格特征,而是预测细网格对粗网格升采样特征的残差量:输出的稀疏特征体 空间分辨率高达 。渲染时,光线行进命中表面掩码区域查询细网格特征 ,空旷区域查询基座特征 ,交界处采用线性过渡插值,兼顾了精细纹理恢复与低算力开销。
3D 感知空间块路由机制
在原始 NSA 中,注意力块的索引筛选完全取决于压缩键的注意力匹配分值。实验观察表明,由于浅层 Transformer 尚未建立鲁棒的跨模态几何投影对应,常规 Top-K 选择在早期网络层级极易选错空间块,导致错误的对应关系层层累积。
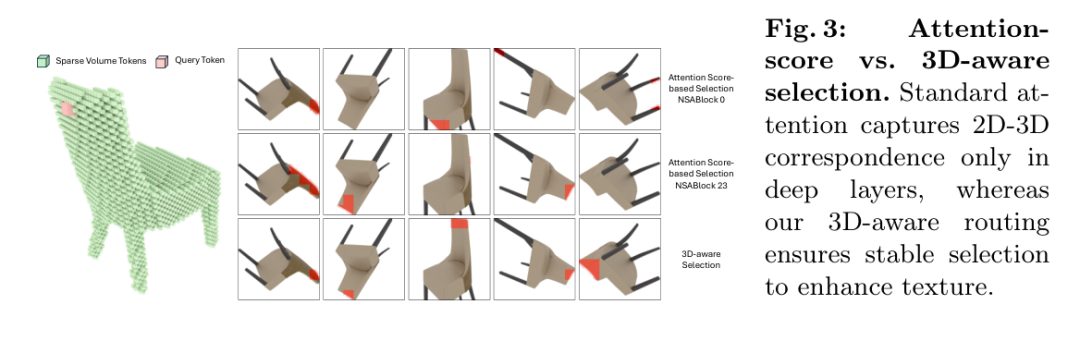
针对该问题,研究团队提出了基于显式几何距离的 3D 感知空间块路由(3D-Aware Block Routing):
显式空间坐标赋予:三维体素 Token 取体素几何中心 ;图像 Token 对应 Patch 则取阶段一粗模型体渲染中不透明度最高的空间表面点 。
图像与体素块的双向几何路由:对于任意查询点 ,先利用已知相机内外参投影视角筛选出二维投影中心最近的候选块,再计算空间点与候选块内三维点集的最短欧几里得距离,严格选取几何距离最近的活跃块。
如上图所示,这种基于显式几何距离的路由策略确保了从第 0 层开始就能建立精准可靠的 2D-3D 空间对应关系,解决了深层网络才能对齐特征的问题。
块感知序列并行与负载均衡
由于物体外观与几何形状不同,各实例产生的表面活跃 Token 数量高度波动,在多卡环境下容易产生严重的掉队现象(见下图训练耗时分布)。
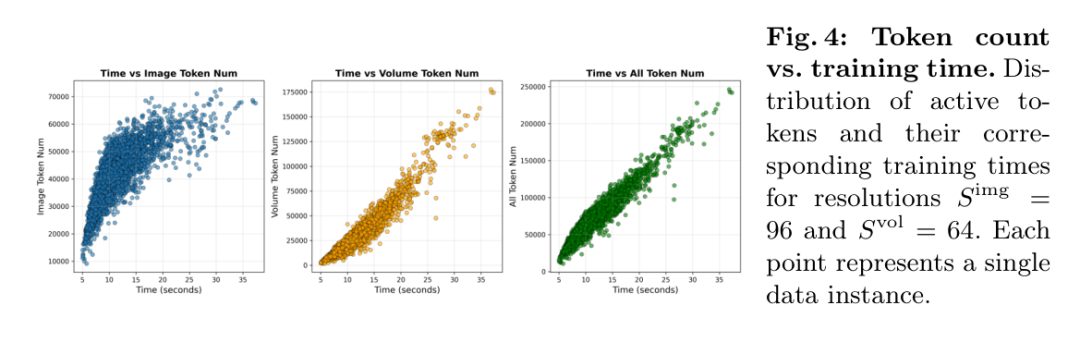
常规的截断采样丢弃过多活跃 Token 会破坏优化稳定性。为此,LSRM 引入了定制的块感知序列并行(Custom Block-Aware Sequence Parallelism):
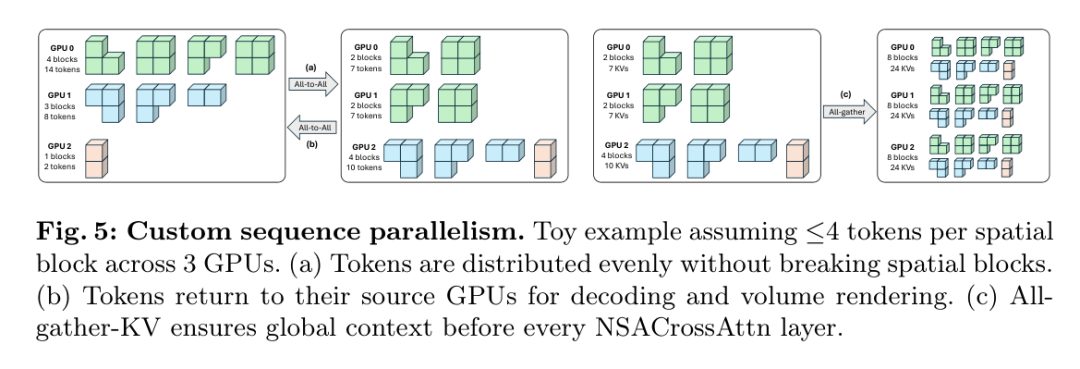
空间块整体切分:在序列划分时不拆散空间块(Block),将整个三维或二维块均匀分发至各 GPU(见子图 a)。局部窗口注意力和键值压缩全部在单卡本地闭环计算,不产生任何设备间通信。
All-gather-KV 全局上下文同步:由于模型采用了仅 2 个键值头的 GQA 架构,键值对( 及 ,)的数据体积非常小。在计算全局上下文的压缩与选择注意力前,系统执行轻量级的 All-gather 广播(见子图 c),查询向量 保持本地切分,以极低的通信延迟实现了跨卡全局动态交互。
实验与结果
LSRM 的基准训练在新视角合成(NVS)包含 60 万个三维模型的数据集上进行,后续微调适配逆向渲染。网络在 128 张 NVIDIA H100 GPU 上分三个阶段训练完成。在单卡 H100 推理时,处理 16 张最高分辨率输入视图的显存峰值占用约 40 GB,单物体平均重建时间约为 5 秒。
新视角合成质量评估
在 Google Scanned Objects(GSO)测试集上,模型接收 16 个视角的输入进行定量评测。
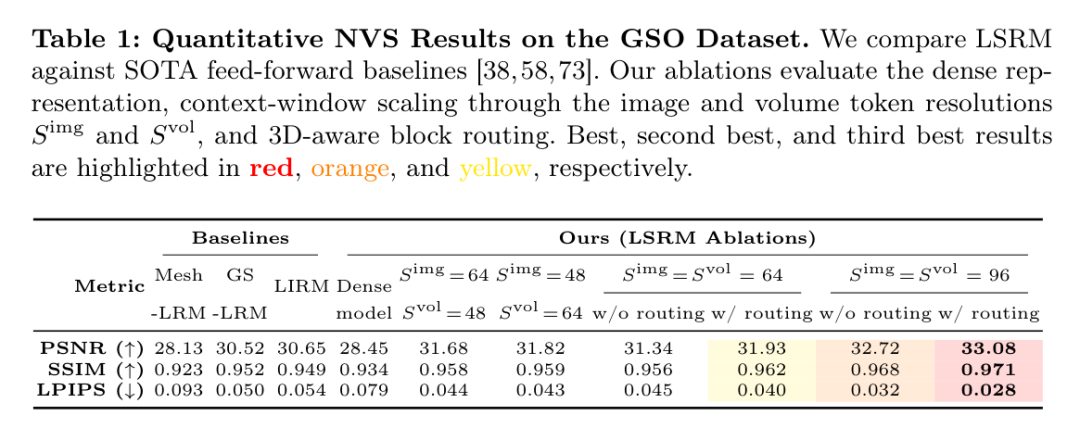
定量结果显示,完整版 LSRM(,带 3D 路由)取得了 33.08 dB 的 PSNR 以及 0.028 的 LPIPS。相比当前最佳前向基线 LIRM(30.65 dB,LPIPS 0.054),PSNR 净增 2.43 dB,感知损失降幅达到 48.1%。
消融实验进一步证实:单纯缩减体素分辨率从 64 至 48 会导致 PSNR 明显下滑至 31.68 dB;而加入 3D 感知路由后,不同分辨率下的 PSNR 与感知质量均得到稳定增益。
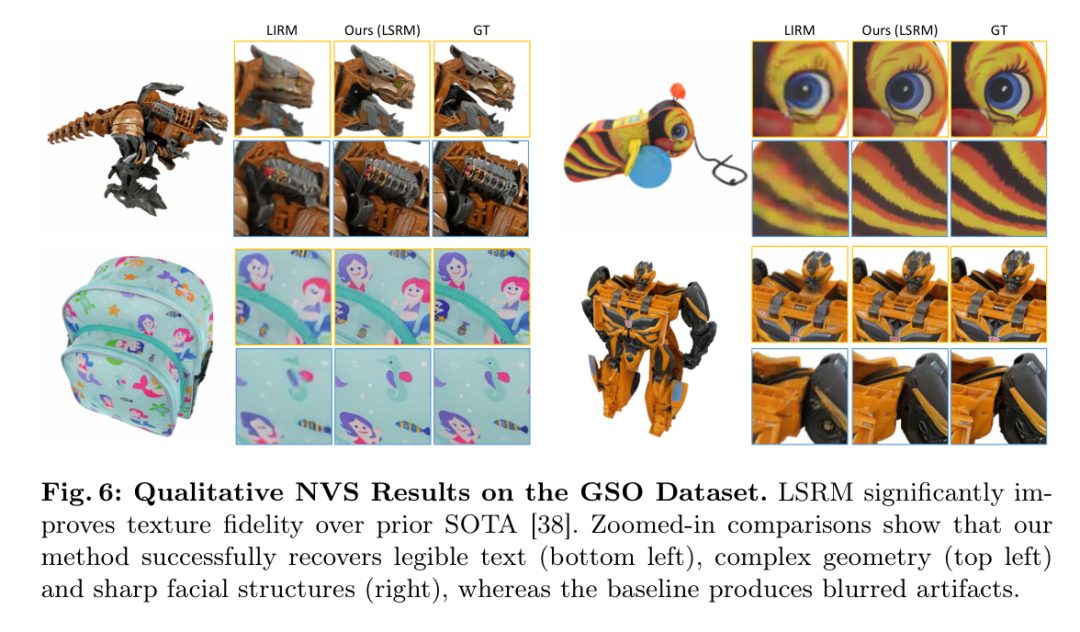
从定性对比中可以看出,LSRM 能够清晰还原过去前向模型无法辨识的高频细节:包括小黄蜂玩具细小的面部表情、变形金刚机械结构的锐利边缘,以及玩具包装盒上清晰可读的印刷体文字。
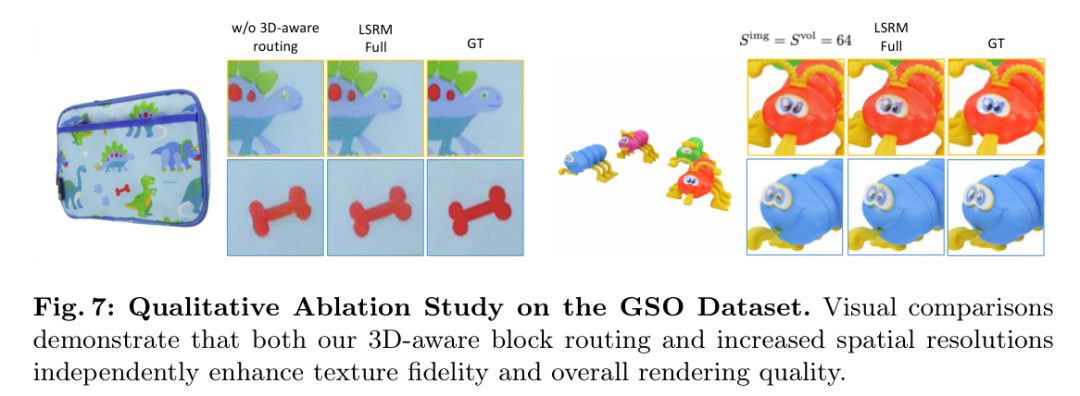
消融对比图同样说明,若移除 3D 感知空间路由,模型重建的玩偶面部结构和文字边缘会出现明显的模糊与几何变形。
逆向渲染(Inverse Rendering)评估
将 LSRM 拓展至逆向渲染任务,用于解耦预测空间双向反射分布函数(BRDF)参数(反照率 Albedo、粗糙度 Roughness、金属度 Metallic)。团队在 StanfordORB、DTC 与 OWL 三个代表性测试集上进行了对比。
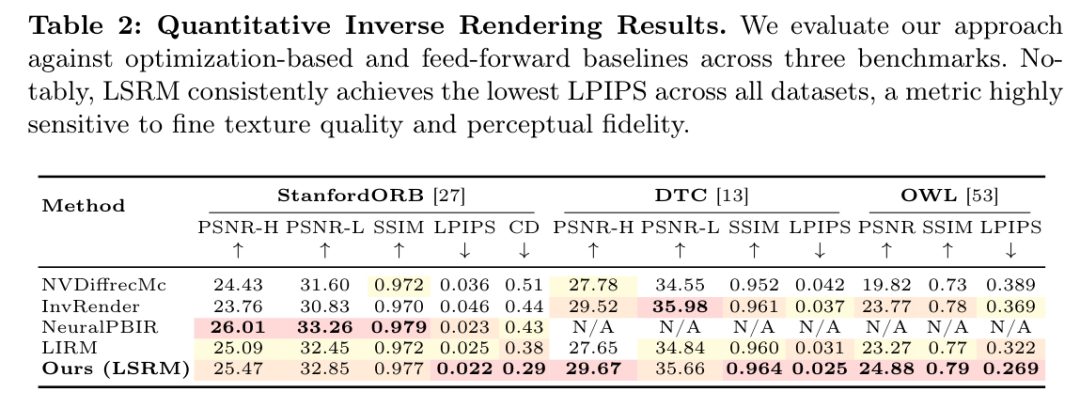
由于逆向渲染存在全局明暗与材质反射的固有二义性,逐像素 PSNR 难以完全体现高频材质几何精度。而在对高频纹理结构极为敏感的感知指标 LPIPS 上,LSRM 在三个数据集上均取得了最佳分数。特别是在真实的 StanfordORB 基准中,LSRM 的 LPIPS 达到 0.022,倒角距离(Chamfer Distance, CD)降至 0.29,在几何精度与纹理保真度上不仅全面领先现有的前向模型,甚至达到了比肩或超越密集视角优化方法(如 NeuralPBIR)的水准。
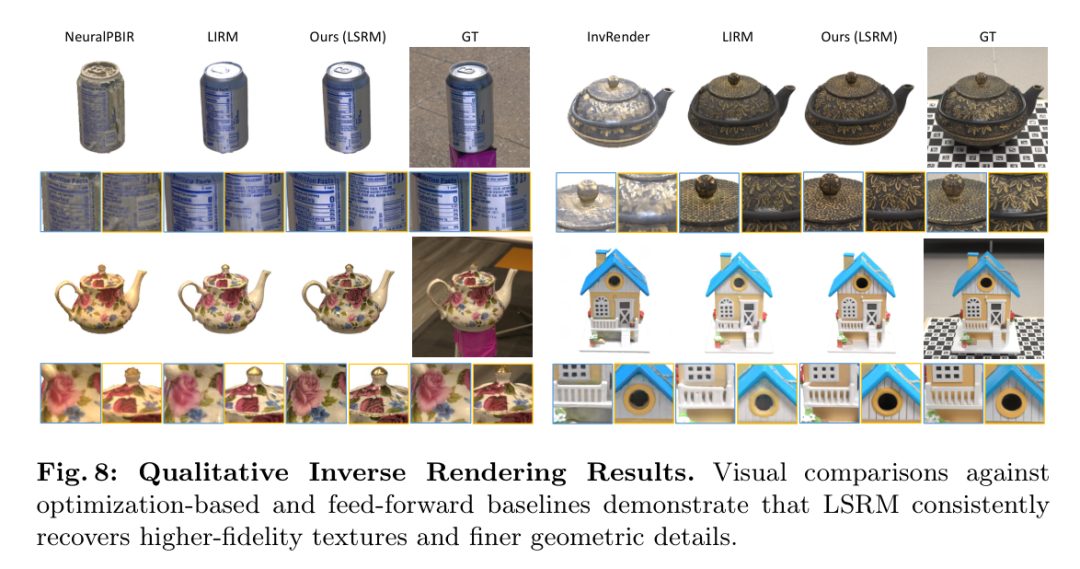
定性对比显示,易拉罐上的营养成分标签(“Nutrition Facts”)与热量标注(“Calories 0”)文字在 LSRM 输出的材质贴图上均保持了清晰可读,茶壶表面的金色叶脉印花以及鸟屋前方的微小栅栏几何均被精准重建。
稀疏少视角泛化性
虽然模型在训练期间固定采用 12 至 16 个输入视角,但在推理阶段直接减少输入图像数量时,LSRM 表现出了出色的视角泛化能力。
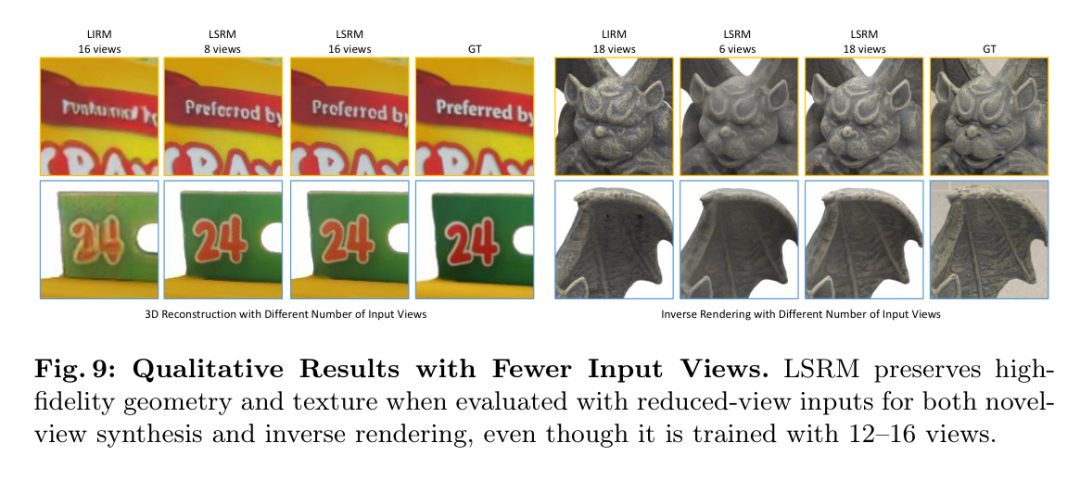
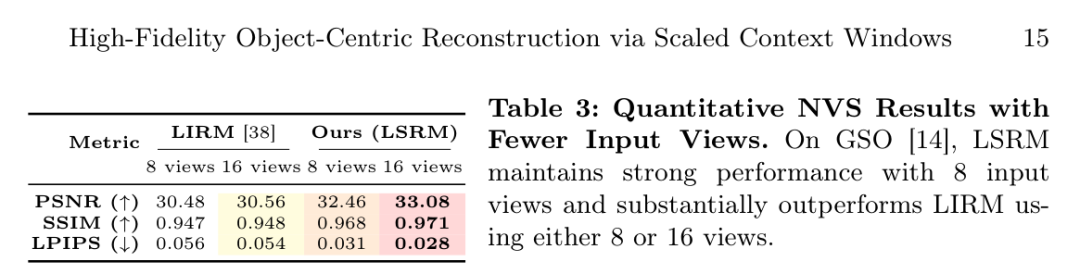
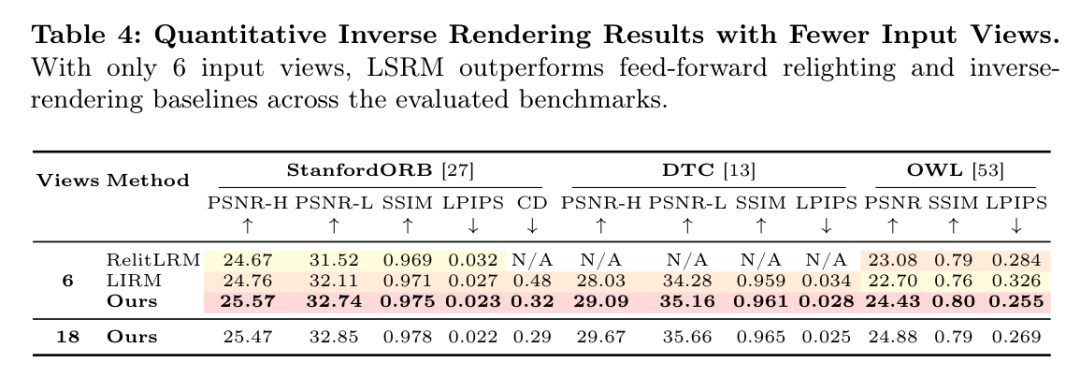
在 GSO 数据集上,当仅提供 8 个视角作为输入时,LSRM 的 PSNR 仍可达 32.46 dB,LPIPS 保持在 0.031,性能依然显著领先输入 16 个视角时的前代最佳前向模型 LIRM(30.56 dB,LPIPS 0.054)。在 6 视角输入的逆向渲染实验中,LSRM 在 StanfordORB 和 DTC 上同样全面领先于专门针对少视角设计的 RelitLRM 与 LIRM。
一点思考
长期以来,前向 3D 大模型在工业落地中最受诟病的一点便是“形似而神不似”——整体几何轮廓尚可,但一旦拉近观察,局部纹理便是一团模糊。LSRM 的研究表明,导致这一瓶颈的关键并非前向架构本身存在表达上限,而是过往三维表征受制于显存开销,无法将上下文窗口扩展到支撑高频细节所需的 Token 规模。
通过将原生稀疏注意力与显式几何投影、块感知并行调度有机结合,LSRM 探索出了一条在有限算力下扩展三维 Transformer 上下文的有效路径。虽然在金属度与粗糙度解耦的固有物理歧义上仍有进一步探索的空间,但该工作所确立的稀疏残差演进机制与几何块路由范式,对未来大场景重建与实时高保真三维资产生成具有重要的技术参考价值。
论文标题: LSRM: High-Fidelity Object-Centric Reconstruction via Scaled Context Windows
机构: Meta现实实验室、英伟达
代码仓库: https://github.com/facebookresearch/Large-Sparse-Reconstruction-Model