4K直出只是开始!商汤原生统一训练法公开,以生成构建视觉思维
原创 让你更懂AI的 2026-09-17 12:33 北京
原生统一再进一层
原生统一做到下一阶段,已经不只是让模型同时会看、会画,还要让这些能力真正彼此协同。
当图像模型开始处理多轮编辑、参考保持和复杂视觉指令,底层架构面对的考题也换了。
理解与生成已经可以进入同一套模型,接下来要验证的是一个更具体的问题:同一套视觉表征,能否继续撑住 4K、复杂创作,以及彼此牵制的训练目标?
问题在于,这些能力对模型的要求并不相同。高分辨率生成需要保住低层纹理和空间连续性,理解依赖高层语义,文字、美学与编辑又由不同的奖励信号驱动。
分辨率越高,图像块边界和局部几何的问题越难隐藏;任务越复杂,共同优化越容易稀释单项能力。原生统一的难点,也由能力共存转向统一之后如何继续扩展。
商汤科技的日日新 U 系列一直尝试把理解和生成统一在模型内部。传统系统往往用一套模块理解图片,再用另一套模块生成图片。
U 系列则去掉独立视觉编码器和 VAE,让理解、推理与像素生成直接在同一套模型中学习。商汤将这套架构称为 NEO-unify,SenseNova-U1.5 延续的正是这条路线。
SenseNova-U1.5 是一款 8B-MoT 原生统一多模态模型,原生图像生成最高扩展到 4K,同时覆盖双语文字渲染、信息图、多参考图生成与编辑等视觉任务。
除主模型外,官方还开放了 SFT 权重和 8-step 蒸馏 LoRA,后者支持以 8 个去噪步骤完成文生图推理。
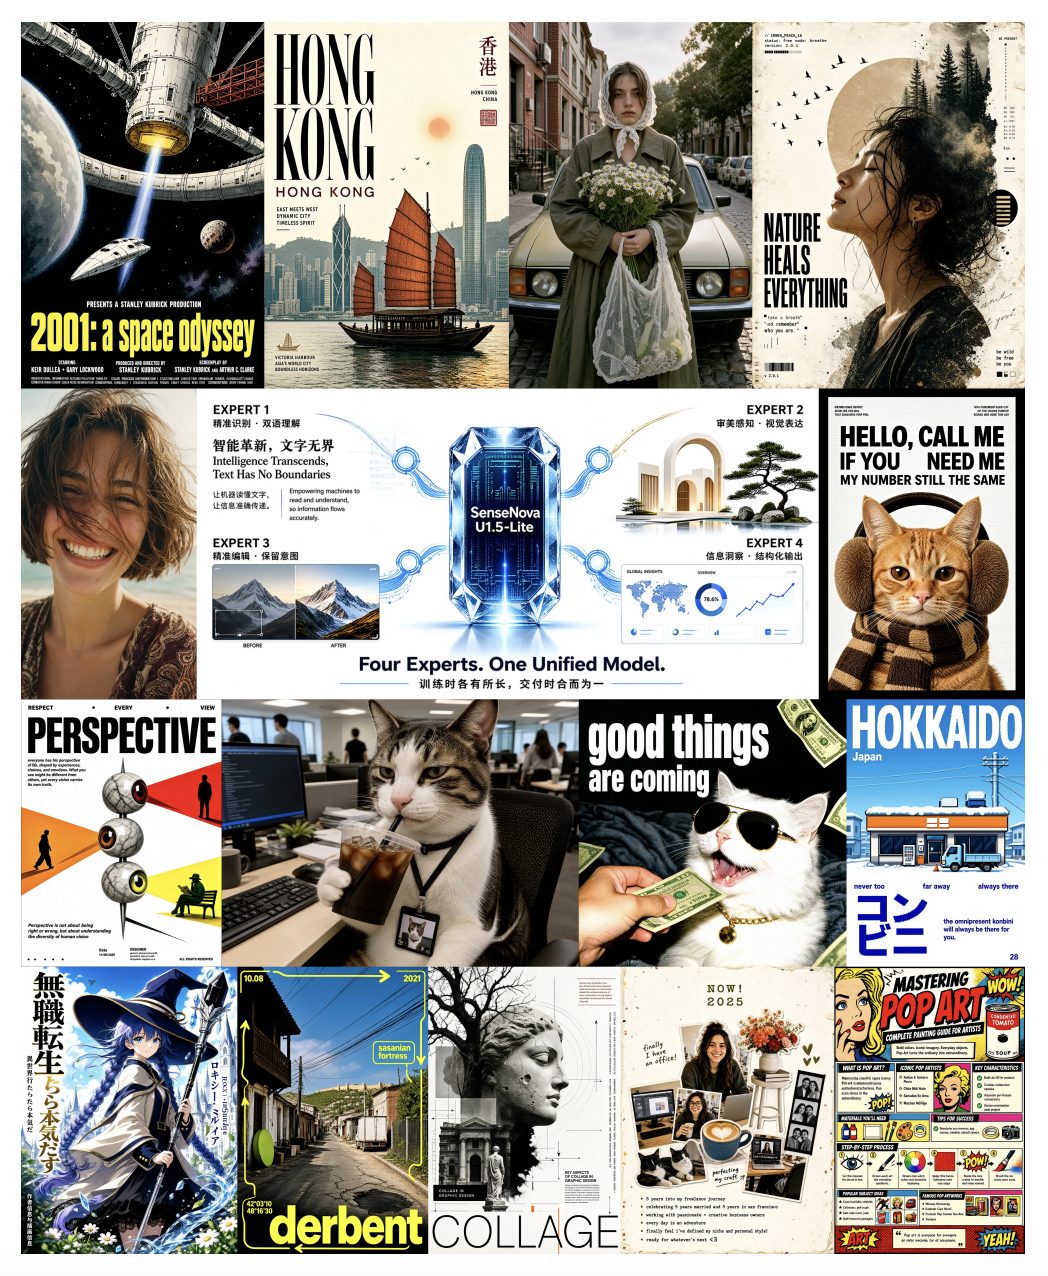
〓信息图与人物生成案例
模型权重开放后,开发者很快开始将它接入现有生态。Hugging Face 上已经出现多种微调和量化版本,官方主模型近一个月下载量接近 1 万次。ComfyUI 主分支也已合入 U1.5 支持。
社区对这款模型的关注,已经从效果展示延伸到部署、量化与实际工作流。
近日,SenseNova-U1.5 的完整技术报告正式公开,并登上 Hugging Face 论文日榜第 2。
报告地址:
https://arxiv.org/abs/2609.11929
HuggingFace模型地址:
https://huggingface.co/collections/sensenova/sensenova-u15
GitHub地址:
https://github.com/OpenSenseNova/SenseNova-U1
上一代 SenseNova U1 已经验证了原生统一的可行性,U1.5 的技术报告则完整展开了这套架构继续扩展时所做的调整。
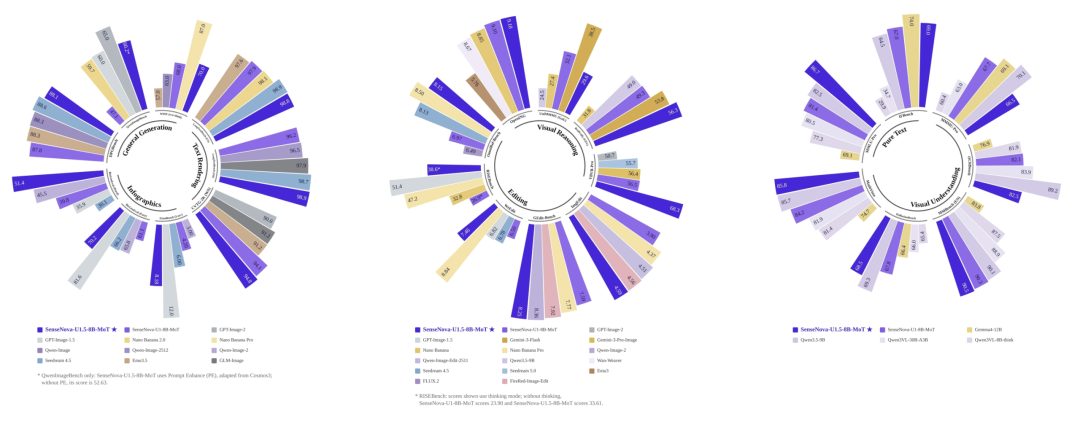
〓SenseNova-U1.5 多维能力表现
变化先从视觉接口开始。
重做视觉接口:原生统一走向4K
SenseNova U1 已经采用了非常紧凑的视觉表示,每个 32×32 像素区域只对应一个视觉 token。这样可以显著压低高分辨率图像对应的视觉 token 序列长度,但像素恢复阶段也留下了新的问题。
此前每个视觉 token 在输出端独立还原自己的 32×32 图像块。这套设计本身足够高效,但随着分辨率继续上升,图像块之间缺少最后一步空间信息交换,接缝、纹理不连续和局部几何偏差会越来越明显。
U1.5 要在保留紧凑视觉 token 的同时继续扩展到 4K,关键就在于像素恢复之前重新建立相邻区域之间的空间联系。
U1.5 保留 32×32 的视觉 token,重新设计了解码端。视觉 token 会先还原成二维特征场,相邻区域通过 3×3 卷积交换信息,再经过多级 Pixel Shuffle 逐步恢复成 RGB 图像。
像素真正确定之前,颜色、纹理和几何关系已经能够在邻近区域之间联合建模。
与此同时,模型把分辨率本身纳入去噪条件。U1.5 将分辨率感知的噪声条件扩展到 4096×4096,让模型在生成过程中同时感知当前去噪阶段和目标分辨率对应的噪声统计。
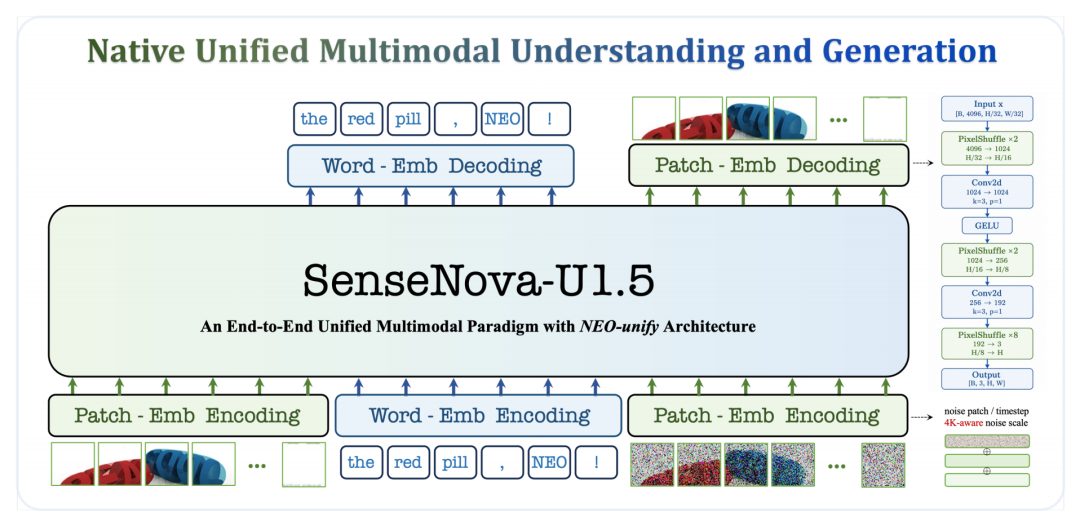
〓SenseNova-U1.5 原生统一架构
架构统一,也不要求理解和生成采用完全相同的计算方式。
U1.5 延续原生 Mixture-of-Transformers(MoT)设计,干净图像、文本和带噪视觉状态进入统一序列,通过共享自注意力直接交互。理解与生成则分别保留注意力投影、归一化和前馈网络等任务专属参数。
共享一套视觉表示,理解与生成仍保留各自所需的计算模块。
训练目标也被放进同一套框架。
语言侧用自回归目标学习理解与推理,图像侧直接在 RGB 像素空间进行流匹配(Flow Matching),再加入 LPIPS 感知约束,对整体结构和局部纹理继续校正。三类监督最终进入同一个联合目标。
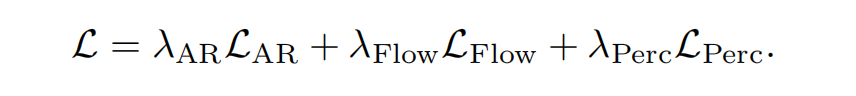
真实创作进入训练:四个专家最终合一
U1.5 的生成数据新增约 5900 万组图文对,来自 78 个来源。其中高分辨率样本占了相当大的比例,约 88.2% 的有效训练量超过 1024²,64.4% 超过 2048²,同时加强中英文文字密集图像、复杂版式和稀有视觉概念。
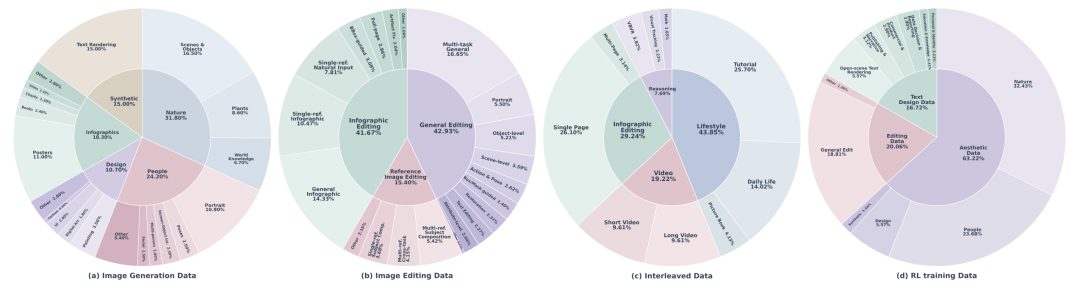
〓SenseNova-U1.5 训练数据构成
数据构造同时加强了质量筛选、分布重平衡和图文对齐,并针对训练中覆盖不足的能力补充定向合成数据。图像质量、文字正确性、布局质量和视觉多样性都被纳入统一筛选流程。
训练流程也专门留出了原生 4K 阶段。生成分支先从 256²—1024² 起步,再扩展到 512²—4096²,随后加入图像编辑与图文交错任务。
进入统一中期训练后,理解、文生图、编辑、图文交错四类数据以 30%、40%、20%、10% 的比例共同训练,最大序列长度提升到 32768。
统一中期训练中,理解与生成损失的权重设为 0.1 : 1.0。这一设置在保留预训练理解能力的同时,把更多优化力度放到更难的生成目标上,并在随后的统一 SFT 阶段继续保持。
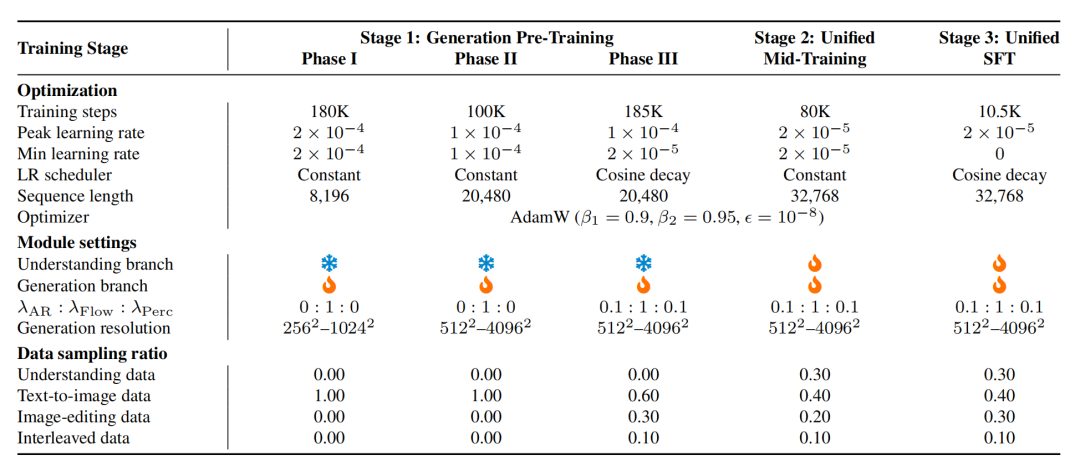
〓生成预训练与统一训练流程
编辑侧的数据规模约 3800 万组,覆盖通用编辑、信息图编辑、参考图驱动编辑和空间控制编辑。多参考样本最高可包含 10 张参考图,区域控制则进一步加入边界框与视觉标记。
对于多目标、多约束指令,训练数据会显式拆出编辑对象、目标区域、属性变化、空间和语义约束,以及哪些内容必须保持不变。
针对这类复杂编辑,数据构造还加入了结构化提示增强和显式推理样本,把编辑意图与约束进一步整理清楚,减少复杂指令中的歧义。
模型既要执行目标修改,也要利用参考图中的主体、风格等信息,并明确哪些内容需要保持不变。
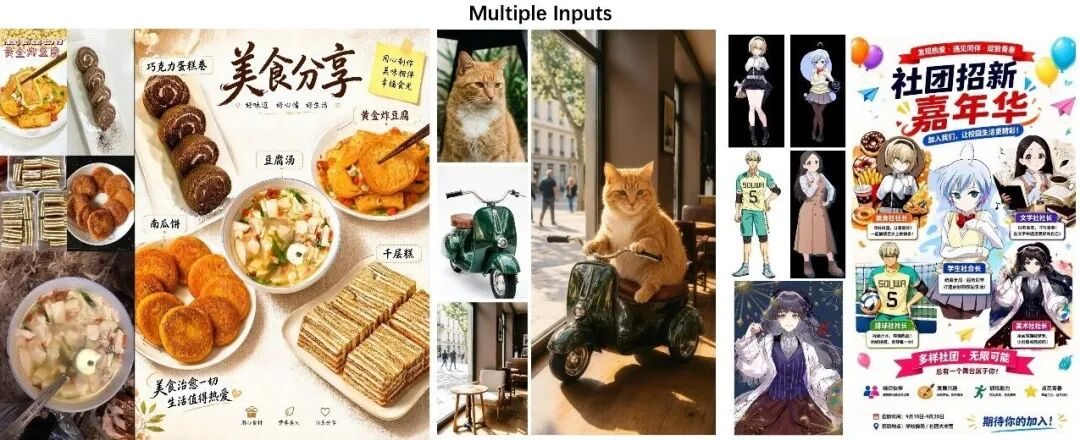
〓多参考主体与场景融合案例
图文交错数据又增加了另一种训练形态。教程、生活场景、信息图、视频序列以及推理样本,被组织成文字与图像持续交替的多模态轨迹。
其中约 44% 来自生活与教程场景,29% 为信息图,19% 来自视频序列,还有约 8% 带有显式的中间推理。图片由此反复出现在一个连续任务中。
任务越接近真实创作,不同目标之间的冲突也越难忽略。只追求画面美感,文字可能受损。编辑动作过强,又容易破坏原图。信息图还同时依赖文字准确、布局组织和整体视觉质量。
U1.5 因此将后训练改成先专业化、再统一(specialize-then-unify)。美学、OCR、信息图和编辑分别训练四个专家模型,再把各自练出的能力重新汇回一个统一模型。报告将其列为 U1.5 的主要后训练升级。
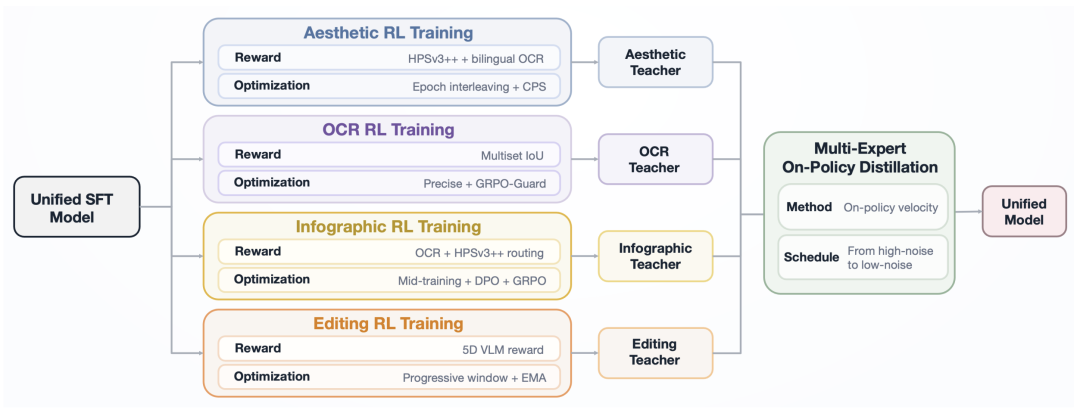
〓多专家强化学习与在线策略蒸馏流程
四个专家面对的优化目标不同,训练方式也随之分开。
美学专家围绕视觉偏好和图文对齐优化,并穿插文字任务,避免美学强化损伤文字可读性。
OCR 专家直接借助 PaddleOCR 检查生成文字,并配合 Precise 采样和 GRPO-Guard,在稀疏的高 OCR 奖励下稳定训练。
信息图专家先强化文字,再通过 DPO 改善整体视觉效果,最后将文字与美学样本分别交给对应的奖励函数。
编辑专家处理的是另一类冲突:模型既要把目标区域改对,又不能破坏原图其他部分。训练时同时检查指令是否完成、目标区域质量、整体视觉质量、文字编辑质量,以及未编辑区域是否保持原样,最终奖励由其中表现最差的一项决定。
某一维度表现再好,也无法抵消另一维度的严重失误。未编辑区域一旦被破坏,最终奖励就会被这一项直接压低。
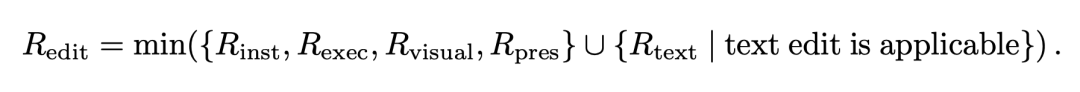
编辑训练还会逐渐把优化窗口从早期去噪阶段移向后期。前面先确定语义和结构是否改对,后面再收紧纹理、细节和局部融合。
这里用到的是多专家在线策略蒸馏。学生模型先沿着自己的生成分布产生轨迹,再根据当前任务路由到对应的冻结专家。
二者在同一个学生生成状态、时间步和条件下,比较各自预测的速度场,让蒸馏监督直接落在学生模型实际会到达的状态上。
这样可以减少传统知识蒸馏中教师轨迹与学生实际生成分布之间的偏差,同时把四个专家的能力重新收进一个统一模型。
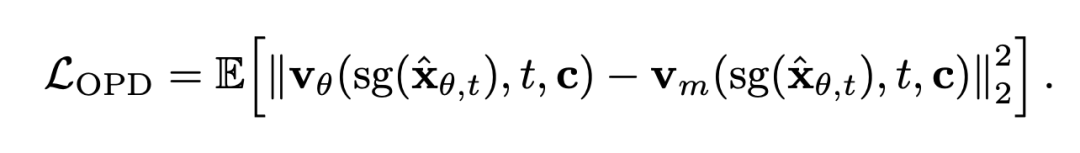
蒸馏监督还会从高噪声状态逐渐移动到低噪声状态。训练前期更多关注整体结构和构图,随后逐渐把监督收紧到文字、纹理和细节。
训练阶段允许能力专业化,推理阶段再回到一个统一模型。
能力边界实测:生成开始进入视觉思维
U1.5 在通用生成上的提升,首先体现在复杂指令和组合约束的稳定性上。
Qwen-Image-Bench 中,U1.5 配合提示词增强(PE)后,英文和中文子集总分分别达到 60.22、60.13,均位列报告所列开源模型第一。GenEval 则以 0.92 拿下开源最佳。
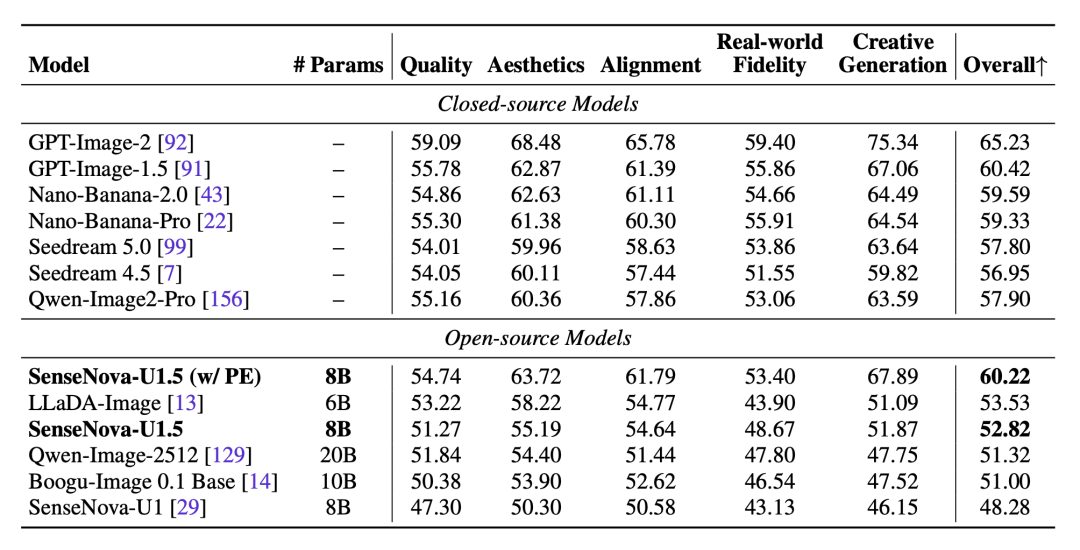
〓英文图像生成综合评测
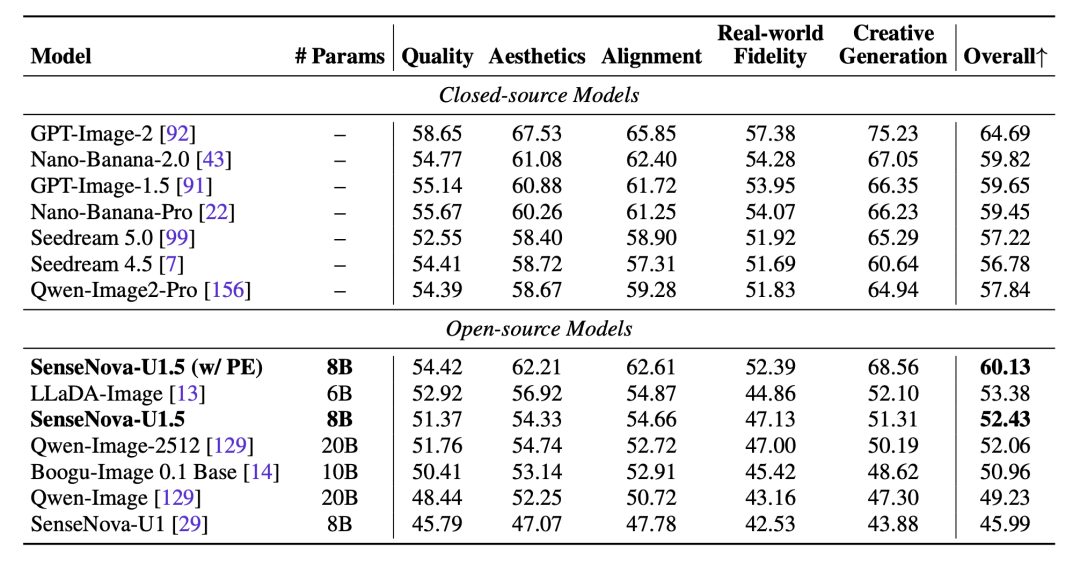
〓中文图像生成综合评测
文字和信息图对细粒度视觉控制的要求更高。CVTG-2K 上,U1.5 综合分达到 0.948;LongText-Bench 的中英文成绩分别达到 0.988、0.989。
在同时要求文字、布局、图表语义和领域知识的信息图任务中,U1.5 在 IGenBench 上不加 PE 已经取得报告所列开源模型最佳表现,加入 PE 后 Q-ACC 又从 0.62 提升到 0.76;BizGenEval 上同样明显超过上一代。
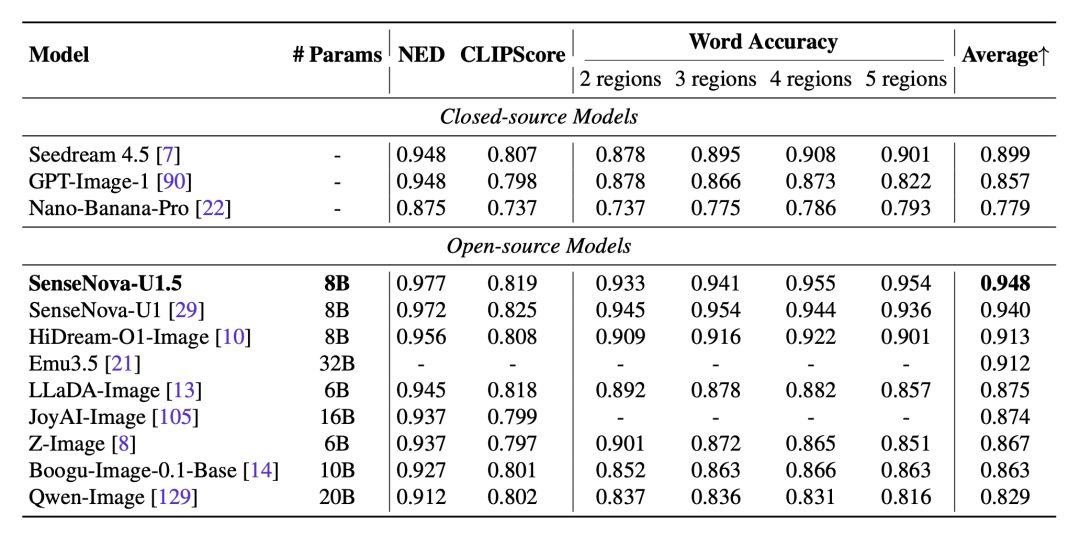
〓多区域文字生成评测
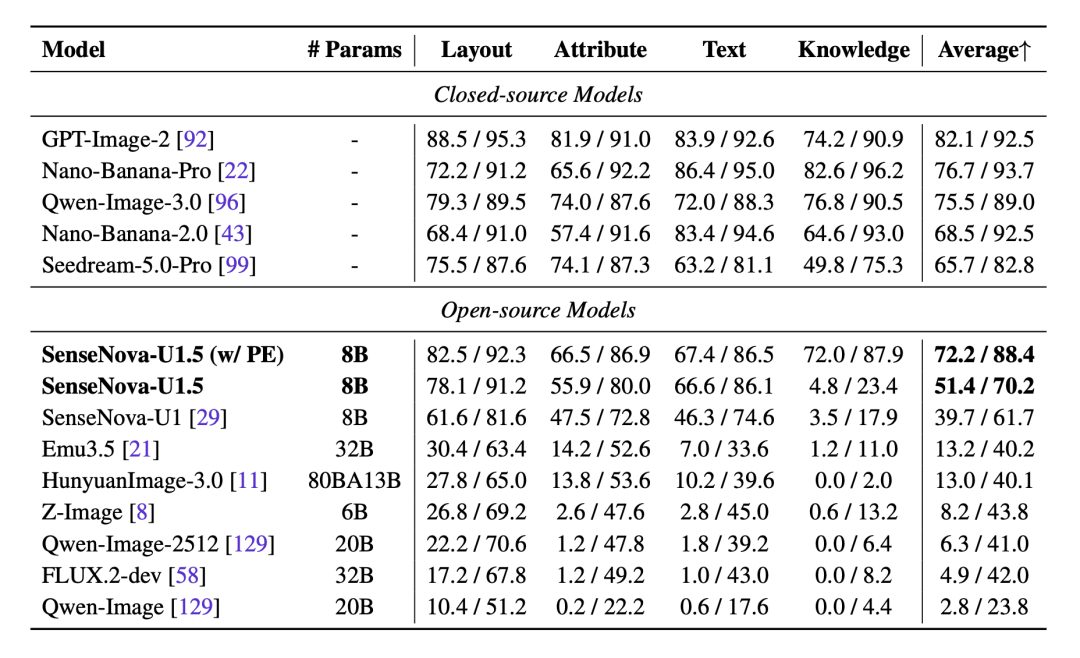
〓商业视觉内容生成评测
编辑任务还要求模型在完成目标修改的同时,尽可能保持未编辑区域不变。U1.5 在 ImgEdit 上拿到 4.59 的综合分,是表中所有参评模型最高。多参考评测中,主体、背景、风格和姿态保持等指标也处于开源模型前列。
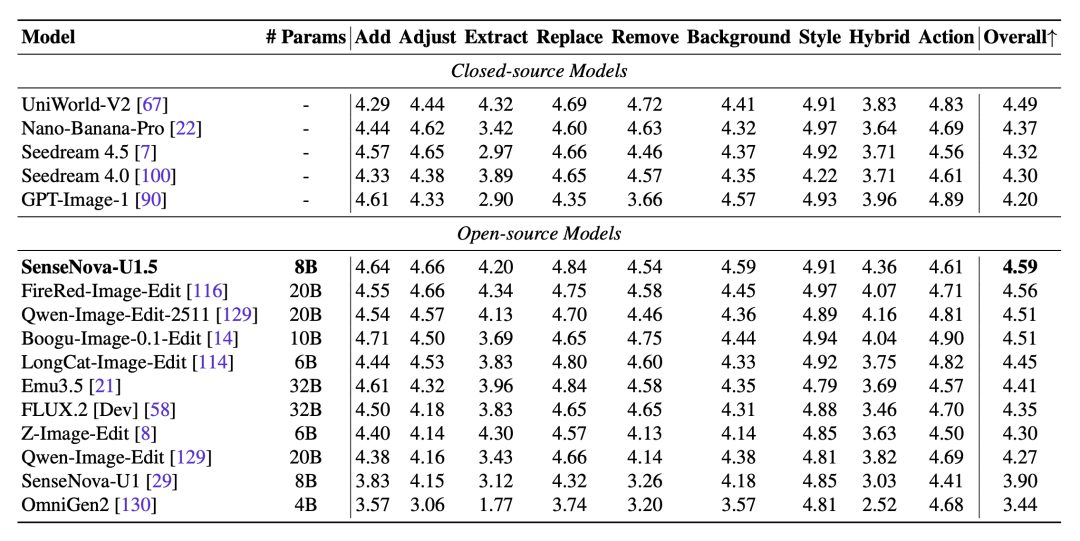
〓通用图像编辑评测
生成与编辑能力进一步扩展后,U1.5 在多数多模态理解评测上依然保持或超过上一代水平。
语言侧,MMLU-Pro、C-Eval 分别达到 86.67、90.41,指令遵循 IFEval 达到 93.35。
随后几组实验把重点转向理解、推理与生成之间的双向作用。
在 WISE 上,U1.5 直接生成时得分为 0.70,加入显式思维链(CoT)后提升到 0.81。
RISEBench 中,CoT 也将总分从 33.6 提升到 38.6,时间、因果和逻辑类编辑收益明显。
空间类编辑则从 49.0 降至 42.0,说明对于能够直接根据图像空间关系完成的编辑,显式 CoT 并不一定带来稳定收益。
U1.5 的生成数据并没有大量依赖固定的结构化模板,但面对长指令、复杂组合和高度结构化的视觉要求时,仍然表现出较强的泛化能力。
研究团队据此认为,多模态理解和推理中形成的结构知识与规划能力,可以进一步迁移到视觉创作。
反过来,生成也开始参与后续的理解与推理。
OpenING 上,U1.5 配合 CoT 得到 9.18。在 VBVR-Pro 上,图文交错生成总分达到 68.2,高于报告中的 Nano-Banana-Pro 56.4 和 GPT-Image-2 50.7,域外平均成绩仍达到 68.9。
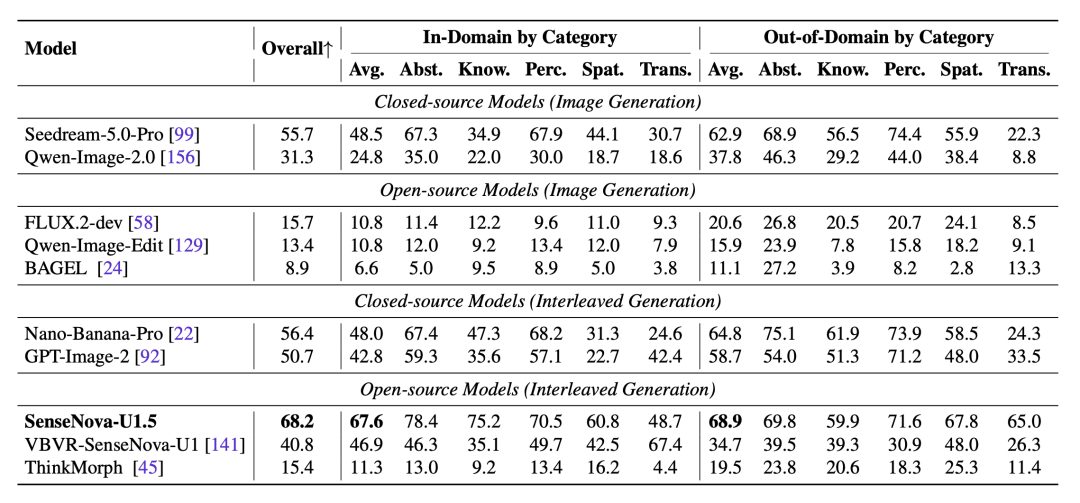
〓图文交错生成与视觉推理评测
RealUnify-GEU 上,U1.5 的平均成绩达到 56.3,上一代 U1-SFT 为 47.5。在 Uni-MMMU-GaU 上则与上一代保持竞争。
报告据此指出,生成在 U1.5 中已经不只承担最终输出,也可以作为支持后续理解和推理的中间表征。
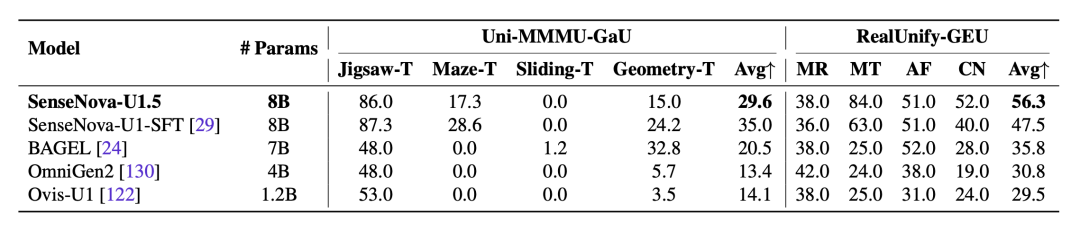
〓生成辅助与生成增强理解评测
结语
商汤 SenseNova-U1.5 对原生统一的推进,已经从共享架构延伸到了训练与能力协同。
4K、文字渲染、信息图和多参考编辑是最直观的结果,背后对应着两处更关键的变化:空间联合重建让紧凑视觉表示继续扩展到高分辨率,四个专家再通过在线策略蒸馏重新汇回统一模型。
实验结果还显示,这种统一开始体现在能力之间的双向作用上。理解与推理中形成的结构知识和规划能力可以进入视觉生成。反过来,生成也开始作为中间表征参与后续理解与推理。
相比上一代主要验证原生统一架构本身能否成立,U1.5 进一步回答了统一之后如何继续扩展,以及理解、生成与推理能否真正相互利用。
4K 是最直观的一层,图文交错和生成增强理解则让这种双向联系开始出现在更复杂的视觉任务中。
商汤还计划进一步开放监督微调、强化学习和在线策略蒸馏的训练代码。届时,空间联合重建、多专家 OPD,以及生成增强理解等关键设计,也将获得更完整的社区复现条件。
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧
·