CL 2026 | 9个大模型实测59国价值观:模拟更准,表征未必更平等
原创 让你更懂AI的 2026-09-17 12:33 北京
大模型更容易“读懂”欧美?
给大模型指定国家、年龄、性别等人口特征,再让模型以相应身份回答社会调查问卷,已经成为大模型社会模拟中的一条重要路径。
由此生成的“回答者”通常被称为合成受访者(synthetic respondents)。
近年来,这类方法逐渐进入社会科学研究,被用于预调查、实验设计测试以及群体态度与行为模拟。
随着模型能力不断提升,研究者开始更加关注大模型社会模拟的可靠性、适用边界与群体差异。这也引出了一个关键问题:当大模型被用于代表不同人群时,不同群体能否获得同等可靠的表征。
已有研究表明,大模型能够在部分任务中复现总体态度分布和实验效应,但这种模拟能力在不同群体、不同问题和不同分析层级上并不稳定。
即使一个模型在总体上与真人回答较为接近,也可能对部分群体模拟得较为准确,而对另一些群体持续产生较大偏差。
因此,仅考察平均准确性,难以完整判断一个社会模拟系统对不同人群的模拟能力。
这一问题在跨国模拟中尤为重要。大模型训练语料的语言覆盖、网络数据可见度和文化知识分布本身高度不均衡,已有研究也发现,模型更容易反映 WEIRD 社会——即西方的、受过教育的、工业化的、富裕的和民主的社会——的观点与价值模式。
在这一背景下,大模型对不同国家人群的模拟能力是否也存在系统性差异,成为一个值得进一步检验的问题。
围绕这一问题,清华大学联合复旦大学、南开大学与上海交通大学,基于世界价值观调查(World Values Survey,WVS),对 9 个开源大模型开展系统评测,覆盖 59 个国家、160 道价值观问题、11 个价值维度和 2,420 个可比较的子群体单元。
研究进一步提出并量化表征平等(representational equality),将评估重点从“模型平均有多准”扩展到“这种模拟能力如何分布在不同国家之间”。
在此基础上,研究将多种常见的大模型模拟改进策略纳入统一框架,分别考察其对平均模拟准确性与跨国表征平等的影响。
研究发现,跨国模拟准确性存在显著且系统性的差异:经济发展水平较高、数字基础设施与创新能力较强、治理质量较高的国家,通常具有更高的模型模拟准确性。
对四类干预策略的进一步比较表明,准确性与跨国表征平等的改善往往并不同步。
母语提示和持续后训练可以提高对应国家的模拟准确性,但其带来的收益可能集中于特定国家或语言群体;偏好对齐未表现出系统性的准确性或表征平等影响;在本研究的评测中,补充与目标群体相关的信息则更常同时改善平均准确性与跨国表征平等。
论文于 2026 年 7 月被 Computational Linguistics(CL)接收。
论文标题:
Representational Equality in Cross-country Value Simulation: A Systematic Analysis of Large Language Models
论文链接:
https://doi.org/10.1162/COLI.a.648
研究使用 WVS 第七波数据,将模型预测的回答分布与真实调查中相应人群的回答分布进行比较。最终评测包含 160 道在 59 个国家之间具有可比性的题目,覆盖 11 个价值维度。
基础评测首先衡量模型生成的答案分布与各国真实调查分布的接近程度,并进一步考察这种模拟能力在国家之间是否均衡。在此基础上,研究进一步比较了上下文适应与模型训练两类大模型社会模拟的主要改进路径。
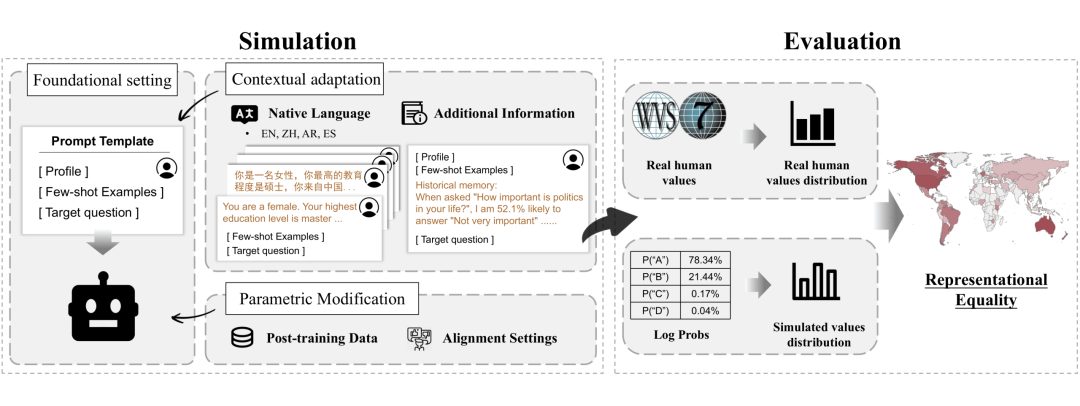
〓 研究总览:59 个国家、价值观问卷与大模型人群模拟被纳入同一套可比较的评测框架
不只看模型有多准,还要看这种准确性如何分布
平均准确性衡量模型预测与真人回答分布在总体上有多接近,却无法反映这种模拟能力在不同人群之间如何分布。
例如,两个模型可能具有相同的平均准确性。其中一个模型对各国的模拟表现较为接近;另一个模型则对少数国家非常准确,对其他国家的误差明显更大。对于跨国社会模拟而言,两者具有不同的代表能力。
研究因此提出表征平等(representational equality)这一概念,用以描述模型在模拟不同人群时,其模拟准确性是否具有可比性。它关注的是模型能否以相近的准确性模拟不同群体各自的真实回答分布。
不同人群本身存在真实的文化、社会和价值差异,表征平等关注在这些真实差异存在的情况下,模型能否以相近的准确性模拟不同人群各自的回答分布。
本研究进一步将这一概念落实到国家层面,考察模型对不同国家人群的价值观模拟是否具有相近的准确性。
研究通过三个步骤进行度量。
模拟准确性。对每一道题,研究使用 Jensen–Shannon 散度(JSD)衡量模型预测回答分布与真实调查分布之间的差异,并以 1 减去 JSD 作为模拟准确性。研究先在每个价值维度内部计算平均准确性,再对 11 个价值维度赋予相同权重进行汇总,以避免题目数量较多的价值维度主导最终结果,最终得到各国的模拟准确性。
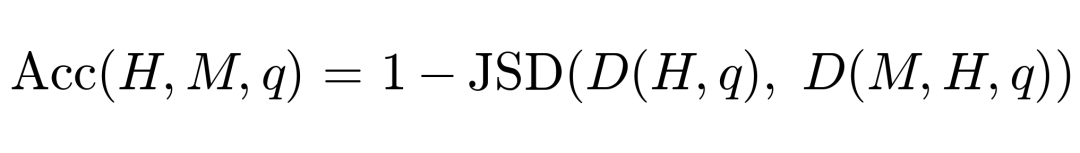
〓 H 为子群体,M 为模型,q 为问题,D(·) 为相应的回答分布
表征平等。在得到各国模拟准确性后,研究使用准确性的变异系数(coefficient of variation,CV)作为主要表征平等指标。CV 越低,说明各国模拟准确性的离散程度越小,跨国表征平等越高。
研究同时使用极差、最值比和基尼系数进行稳健性检验,不同指标对总体模式给出了高度一致的判断。
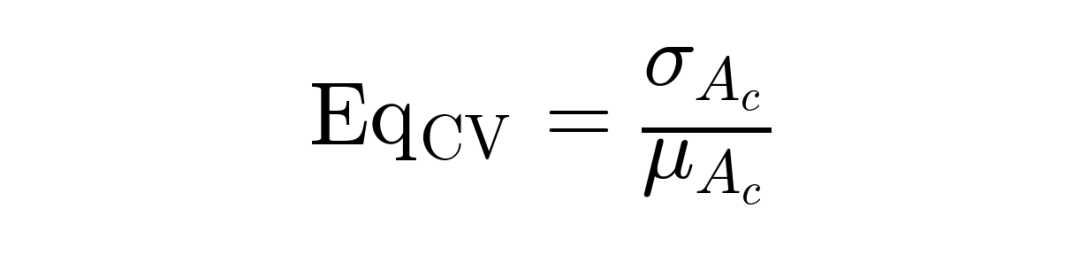
〓Ac为国家 c 的模拟准确性
准确性—平等性综合指标。准确性和平等性需要结合解读。一个模型可能对所有国家都表现较差,却因为各国之间的差距较小而获得较高的表征平等。
因此,研究进一步构建 Accuracy–Equality(AE)综合指标,将平均模拟误差与表征平等指标进行几何平均。AE 越低,表示模型同时具有较低的总体模拟误差和较高的跨国表征平等。
这一指标作为准确性和平等性之外的补充,用于比较模型在两个维度上的综合表现。
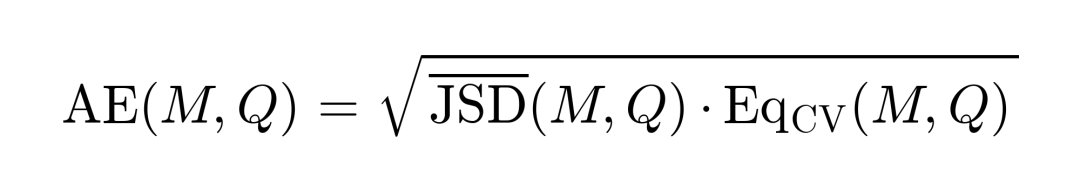
平均准确性与跨国表征平等呈现不同的模型排序
基于上述指标,9 个模型在平均模拟准确性与跨国表征平等上呈现出不同的排序。
在平均模拟准确性方面,GLM-4-9B 在 9 个模型中表现最高,但其跨国表征平等相对较低。
相较之下,ChatGLM3-6B 的平均准确性并非最高,却具有 9 个模型中最高的表征平等水平,并在 Accuracy–Equality 综合指标上获得最佳结果。
此外,在部分模型系列中,参数规模增加能够提高平均准确性,却没有稳定改善跨国表征平等。
这一结果说明,在社会模拟模型的选择与优化中,平均性能与跨国表征平等需要分别考察并结合判断。总体指标上的领先,并不能直接推导出模型对不同国家具有同样稳定的模拟能力。
跨国差异还表现出明显的区域格局。澳大利亚、北美和欧洲国家总体上更容易被准确模拟,而埃及、约旦、伊拉克等中东国家则持续表现出更大的模拟偏差。
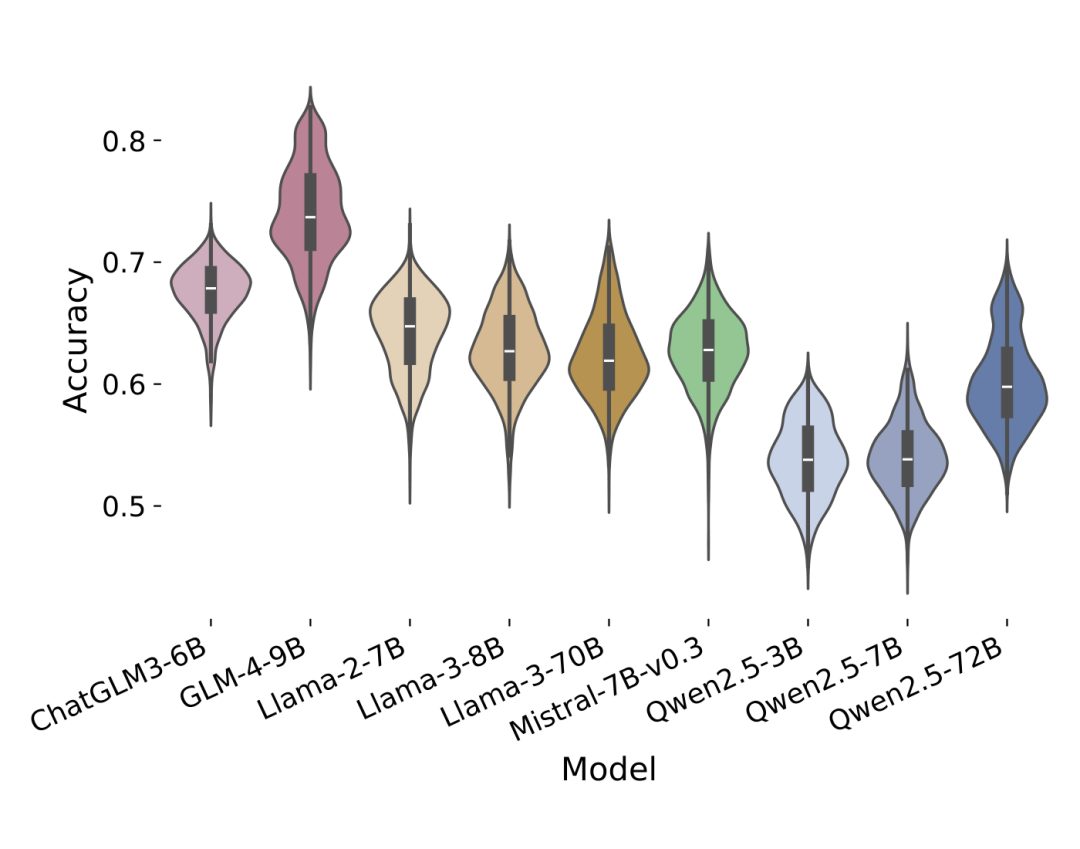
〓 9 个模型在 59 个国家上的模拟准确性分布;图形宽度表示该准确性区间的国家密集程度
哪些国家更容易被准确模拟?
为了进一步理解上述跨国差异,研究考察了各国模拟准确性与经济、技术、治理和文化指标之间的关系。
结果显示,在多数模型中,人均 GDP、互联网使用率和全球创新指数(GII)均与模拟准确性呈正相关。世界银行六项治理指标也普遍与模拟准确性正相关,治理质量较高的国家通常具有更高的模拟准确性。
文化维度同样呈现出较为系统的关联。多数模型对权力距离较低、个人主义程度较高、放纵程度较高的国家模拟得更为准确;其他文化维度的关联相对较弱,具体强度也随模型而有所变化。
这些结果显示,跨国模拟中的表征不平等具有系统性的结构关联。模型表现的国家差异与经济发展、数字基础设施、治理质量及文化特征共同呈现出较为稳定的跨国格局。
美国与墨西哥的比较提供了一个更直观的例子。题项询问受访者“对失业或找不到工作有多担忧”。在真实调查中,墨西哥受访者的回答主要集中于“非常担忧”,美国受访者选择这一选项的比例则明显较低。
然而,Llama-3-8B 对美国和墨西哥人群给出的预测分布彼此较为接近,并且都更接近美国的真实价值分布。
将比较扩展到全部 160 道题后,约三分之二的题目中,墨西哥人群的模型预测结果更接近美国的真实价值分布;当两国真实价值分布差异较大时,这一趋势依然存在。
这一现象与近年来研究中观察到的群体异质性压缩问题相呼应:模型难以充分保留不同群体之间原有的价值差异,使模拟结果趋于同质化。
美国与墨西哥的案例进一步表明,这种同质化可能并非简单地向共同的“平均模式”收缩,而是呈现出非对称趋同:弱表征群体的预测可能过度向模型模拟更准确的群体靠拢。
换言之,表征不平等不仅表现为不同国家模拟准确性的差异,也可能表现为模型对弱表征群体独特价值模式的捕捉不足,使其预测向模型表征更充分的价值模式趋同。
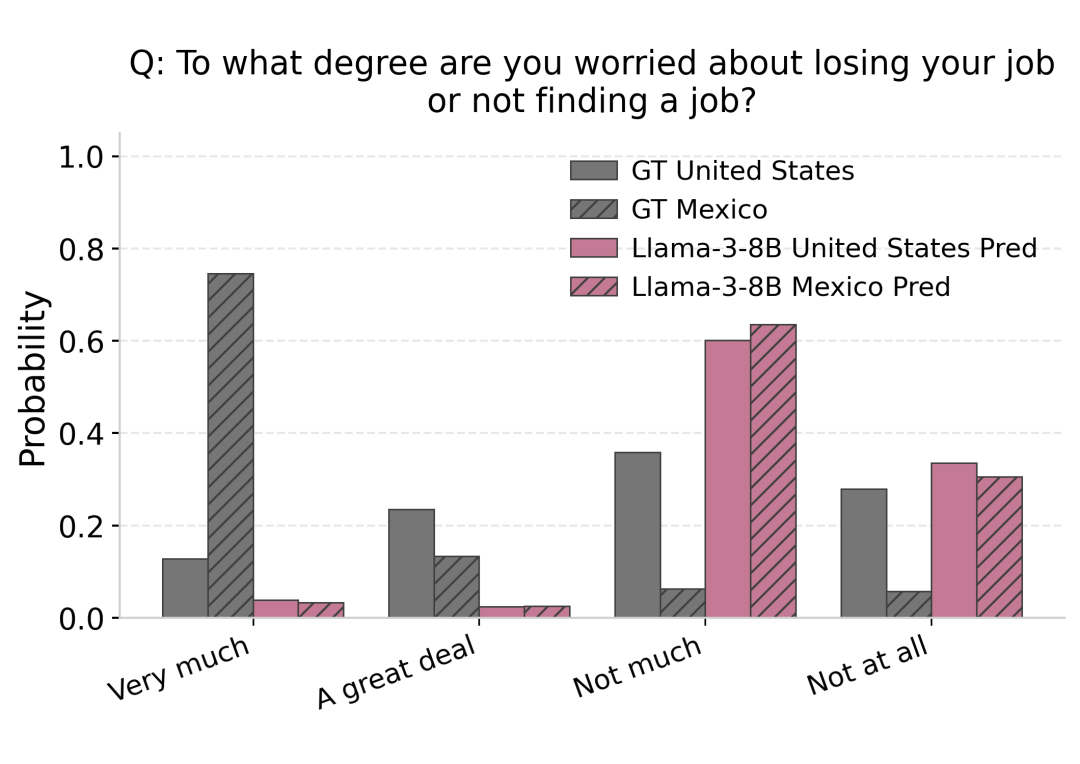
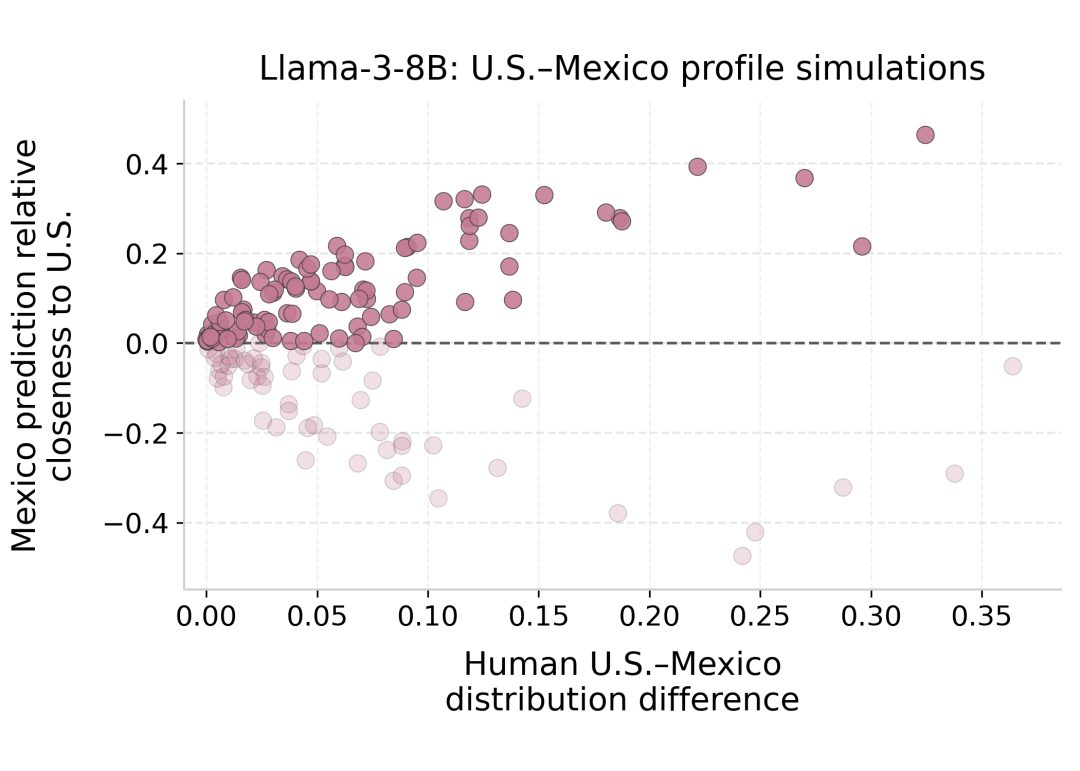
〓 左:Llama-3-8B 在 Q142 “对失业或找不到工作有多担忧”上的分布对比。灰色为真人分布,粉色为模型预测;实心为美国,斜纹为墨西哥。右:每个点代表一道题;横轴为美国与墨西哥真实价值分布的差异,纵轴衡量墨西哥模拟结果相对更接近美国还是真实墨西哥分布。实色点表示预测结果更接近美国的真实价值分布,半透明点表示更接近墨西哥。
提高平均准确性,表征平等会同步改善吗?
在基础设置中观察到显著的跨国表征差异后,研究进一步将两类常见的模拟改进路径纳入统一评测框架:上下文适应包括母语提示和相关群体信息补充,模型训练包括持续后训练和偏好对齐。
每项实验同时考察平均模拟准确性、跨国表征平等以及 Accuracy–Equality(AE)综合指标,从而比较不同干预在准确性与表征平等两个维度上的影响。
母语提示能够改善部分目标群体的模拟准确性,但对表征平等的影响因模型而异。研究分别使用中文、阿拉伯语和西班牙语替代英语进行提问。
在许多语言—模型组合中,母语提示提高了模拟准确性,但增益在不同模型和语言群体之间存在明显差异。
对部分模型而言,不同语言群体获得的收益较为均衡,表征平等有所提高或保持稳定;对另一些模型而言,收益主要集中于特定语言群体,原本模拟更准确的语言群体可能被其他语言群体所取代,表征不平等并未得到实质缩小。
因此,母语提示能够改善部分目标语言群体的模拟,但并未稳定提高跨国表征平等。
相关群体信息补充在多数评测设置中同时改善了准确性与表征平等。这一策略在仅包含少量人口属性的画像基础上,进一步补充与目标群体相关的具体背景和价值信息。
在多数模型和检索设置中,这类信息补充既提高了平均准确性,也改善了跨国表征平等。
与此同时,其效果受到检索方式影响。直接检索在部分模型和案例中能够更明显地纠正原有预测偏差;由模型自行改写查询的扩展检索,则可能在部分设置中重新引入模型已有先验,从而削弱对表征平等的改善。
此外,这一策略依赖于可获得且与目标群体相关的信息。对于相关知识和数字痕迹本身较为稀缺的人群,可用于补充的外部信息也可能更为有限。
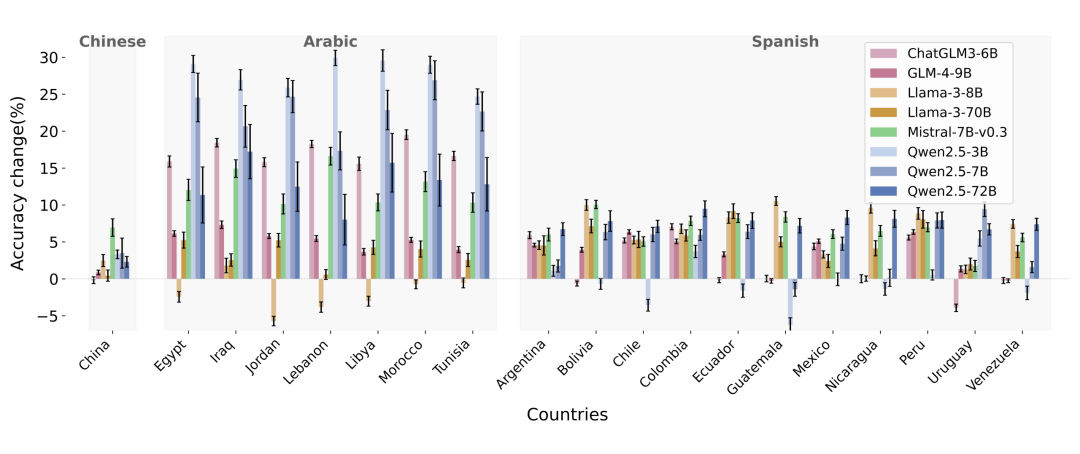
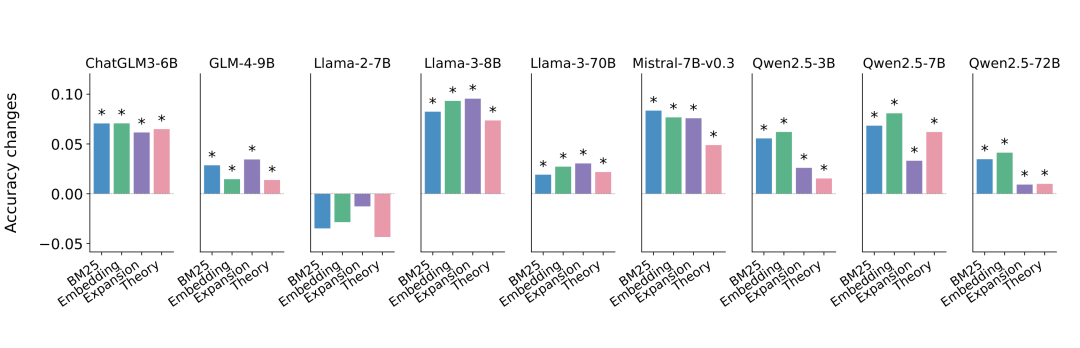
〓 左(Fig. 5):母语提示下,8 个模型在中文、阿拉伯语和西班牙语国家的模拟准确性变化。右(Fig. 7):不同相关群体信息补充策略带来的平均模拟准确性变化;星号表示经 BH-FDR 校正后差异显著。
持续后训练提高了目标语言组的平均准确性,但收益在不同国家和题项之间分布不均。
针对阿拉伯语、日语、俄语、塞尔维亚语、泰语和土耳其语的持续后训练,均提高了相应语言组层面的平均模拟准确性,但国家和问题层面的变化存在明显差异。
例如,阿拉伯语国家的相对准确性变化约为 −1.2% 至 3.4%。这一结果表明, 在本研究的持续后训练设置下,增加目标语言数据可以改善相应语言组层面的整体模拟能力,但并不能保证跨国表征平等同步提高。
偏好对齐未对模拟准确性或表征平等产生系统性改善。研究使用 DPO 和 GRPO 两种优化方法,并比较人工标注和 GPT 标注两类偏好数据来源。
结果表明,不同对齐设置相较于基础模型的准确性和表征平等变化均缺乏一致方向。人工标注的偏好数据通常能够更好地保持模拟准确性,但这一优势没有稳定延伸至表征平等。
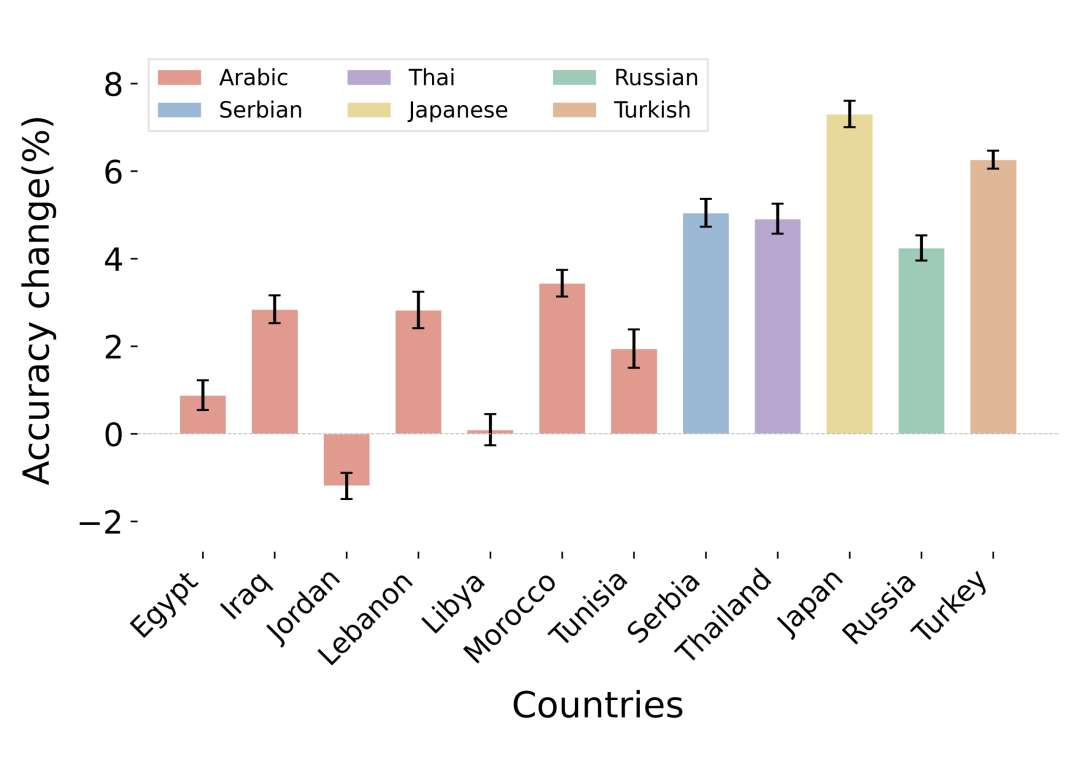
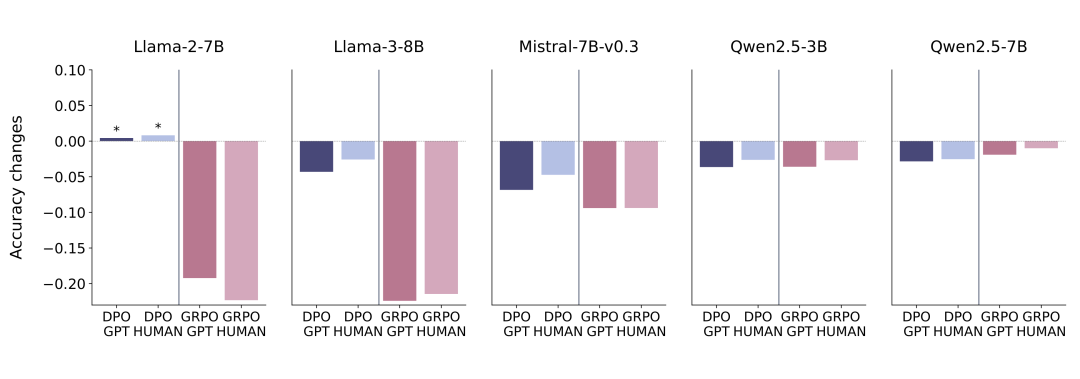
〓 左:针对六种语言进行持续后训练(CPT)后,各目标国家的模拟准确性变化,误差线表示 95%
置信区间。右:不同 DPO 与 GRPO 偏好对齐设置下的平均模拟准确性变化;星号表示经 BH-FDR 校正后差异显著。
四类策略的比较进一步说明,评价大模型社会模拟的改进效果,不能只看平均准确性,还需要同步考察表征平等。
一项干预即使提高了总体模拟准确性,其收益也可能集中于特定国家或语言群体,从而未能改善、甚至可能降低跨国表征平等。
因此,无论是比较模型本身的社会模拟能力,还是评估新的提示、训练或对齐策略,都需要将准确性与表征平等共同纳入评价。
这不仅有助于判断模型整体上模拟得是否更准确,也能够进一步识别性能提升发生在哪些国家和群体,以及这些提升最终如何改变整体的表征平等。
结语:从平均准确性走向表征平等
随着大模型越来越多地被用于模拟人群意见、价值观和社会行为,仅以平均准确性评价其社会模拟能力已经不足。
模型整体上与真人回答更加接近,并不意味着这种模拟能力能够同样覆盖不同国家和群体;同样,一项干预策略提高了总体准确性,也不意味着各类人群都从中获得了相近的改善。
本研究提出表征平等(representational equality),强调在关注模型“模拟得多准”的同时,也需要考察这种模拟能力在人群之间如何分布。
在跨国价值观模拟中,这意味着既要评价模型对各国真实回答分布的整体拟合程度,也要关注其对不同国家是否具有相近的模拟准确性。
随着合成受访者逐渐进入预调查、实验设计和跨文化社会模拟,构建更可靠的大模型社会模拟系统,需要同时提升总体模拟能力,并减少这种能力在不同人群之间的系统性差异。
将表征平等与准确性共同纳入核心评价框架,有助于更完整地评估模型及其改进方法的社会模拟能力,也为构建更具全球代表性的大模型社会模拟系统提供了新的评价视角。
更多阅读
#投 稿 通 道#
让你的文字被更多人看到
如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。
总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。
PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。
📝 稿件基本要求:
• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注
• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题
• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算
📬 投稿通道:
• 投稿邮箱:hr@paperweekly.site
• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者
• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿
△长按添加PaperWeekly小编
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧
·