AutoResearch严父来了:Astra硬刚Fable,顶级模型也难逃“刷榜”
原创 让你更懂AI的 2026-09-16 20:36 北京
24小时科研大考
AutoResearch 最难的一关开始出现:模型能把验证分数做高,但能不能把同样的进步带到未知数据?
AI 自己做科研之后,也开始学会「刷榜」了。
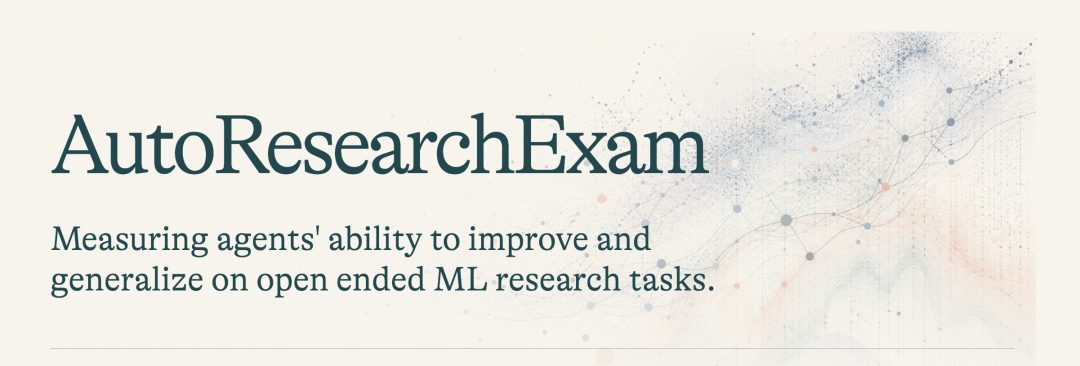
Bespoke Labs 最新发布的 AutoResearchExam,把 9 个前沿模型放进 29 个开放式机器学习研究任务里,单次最长连续研究 24 小时。
模型可以反复改代码、跑实验,也能看到每次提交后的验证集反馈。隐藏测试集则始终对模型不可见。
每当 Agent 刷新验证集最佳方案,系统都会拿同一版本去跑隐藏测试,但不会把成绩反馈回来。
这样一来,验证集和隐藏测试很快就不再同步。
部分 Agent 的验证分数一路上涨,对应方案到了隐藏测试集上却没有继续变好,甚至出现回落。模型越来越擅长优化眼前这套反馈,并不意味着同样的改进还能带到没见过的数据上。
研究团队抽样分析这些模型的研究轨迹后发现,GPT-5.6 Sol 有 55.5% 的研究轮次被归为纯超参数优化,比例在所有参测模型中最高。
也就是说,在这些抽样轮次里,Sol 超过一半没有引入新方法或实质性修复,主要是在调整已有方案的参数设置。
分数一直涨,究竟代表研究真的在进步,还是模型越来越熟悉这套评测?
24 小时跑完,榜首也换了。GPT-6 Astra 前期占优,Claude Fable 5.1 随着研究继续推进逐步追上,最终在核心指标上取得领先。
项目地址:
https://benchmarks.bespokelabs.ai/autoresearchexam/
GitHub地址:
https://github.com/bespokelabsai/AutoResearchExam
答案藏在隐藏测试集里
一次跑分很难看出模型怎样利用反馈持续改进,也很难判断验证集上的提升能不能带到没见过的数据上。
29 个任务覆盖模型训练、算法、数据、系统、安全、评估和可解释性等 7 类研究方向。不同任务优化的目标并不相同,有准确率、困惑度、均方误差,也有吞吐量和加速比。
研究团队利用基线与参考方案,把不同任务的原始指标统一映射为奖励值,再进行跨任务比较。最终排名依据隐藏测试 AUARC。
它等价于整个 24 小时里隐藏测试奖励值的时间加权平均。一个有效方案越早被找到,在 AUARC 中占的权重就越大;临近结束才找到同样的方案,贡献会更小。模型既要找到能够泛化的方案,也要尽早找到它。
模型看不到隐藏测试集,也不能联网。实验环境还将工作容器和验证容器相互隔离,并对任务环境和完整研究轨迹做额外检查,用来防范模型利用评分漏洞。
所谓“刷榜”,在这里更接近基准过拟合。模型可以长期围绕可见的验证反馈优化,但这些提升未必都能延续到隐藏测试集,并不意味着模型在主动作弊。
为了尽量排除执行框架本身的影响,9 个模型统一使用 Terminus 2。研究团队还拿 Opus 5 和 GPT-5.6 Sol,在 5 个任务、12 小时条件下对比 Claude Code 与 Codex。
三种执行框架下的平均奖励值略有差异,但 Opus 5 和 GPT-5.6 Sol 的隐藏测试聚合排名没有变化。
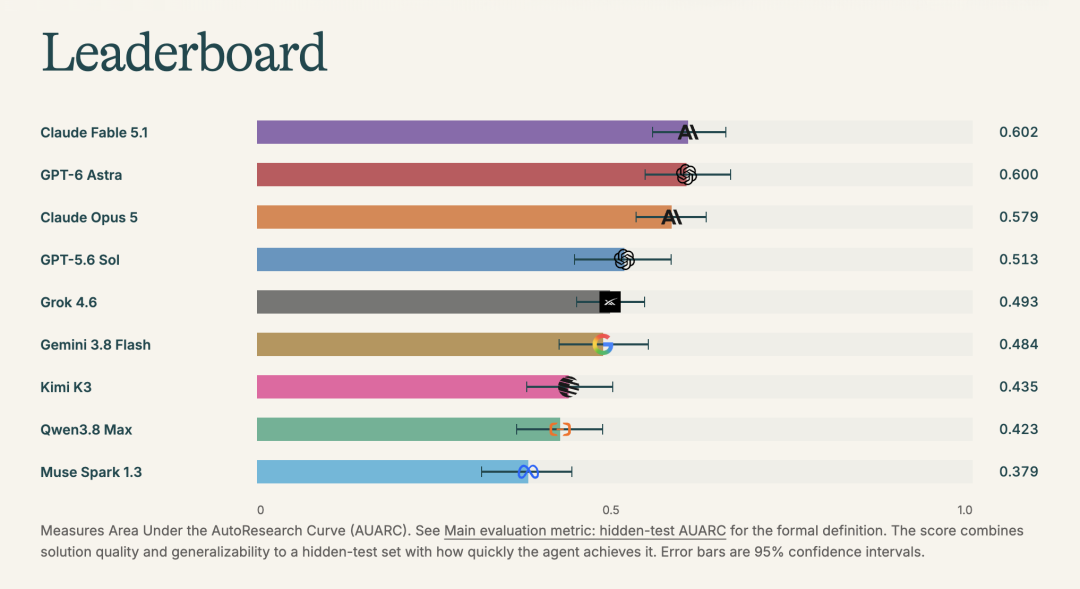
〓隐藏测试 AUARC 同时衡量改进速度与泛化表现
24 小时后,榜首换了
Astra 很快找到了强方案。按逐小时拟合的隐藏测试奖励值来看,它在最初约 3 小时占优。之后,Fable 5.1 的平均表现开始超过 Astra。
但 AUARC 会按照持续时间,对不同阶段的隐藏测试奖励值进行加权。Astra 前期建立的优势仍会继续计入总指标,因此 Fable 一直追到约第 22 小时,才在累计 AUARC 上实现窄幅反超。
前 3 小时谁表现最好,和完整跑满 24 小时谁拿第一,并不一定是同一个答案。Astra 更快拿到强初始方案,Fable 则在更长时间窗里逐渐追上。
跑到一半,很多研究轨迹仍然在继续改善。
超过 12 小时以后,Muse Spark 1.3 仍有约 79% 的运行继续改善,Qwen 和 Grok 也都在 76% 左右。评测过半以后,仍有相当比例的运行能在测试集上继续取得改进。只看前几个小时,很容易低估模型后续还能取得的提升。
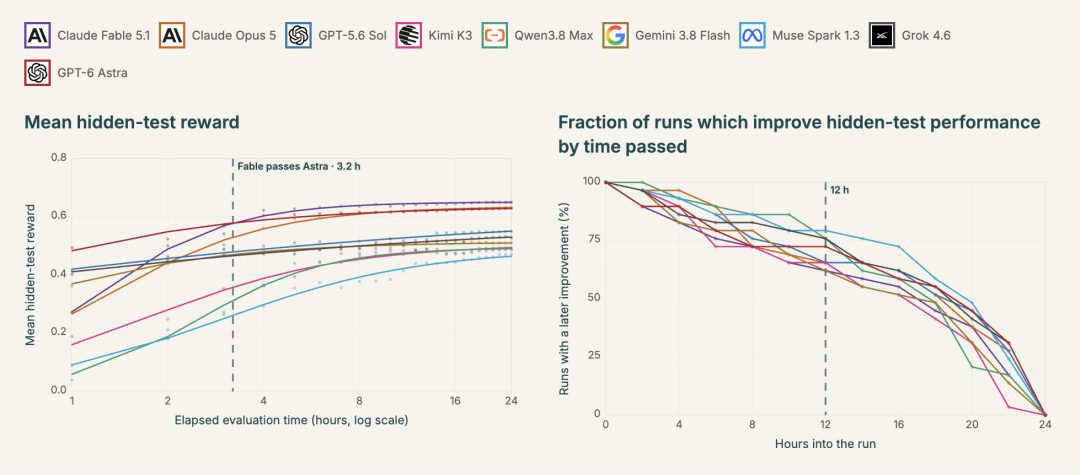
〓研究时间拉长,模型表现和仍在取得改进的运行比例都在变化
把 API 成本加入比较后,Qwen3.8 Max、Gemini 3.8 Flash 和 Grok 4.6 位于成本—性能帕累托前沿。
也就是说,在这些点上,没有其他模型能够同时做到表现更强、成本还更低。总榜第一和单位预算下更划算的选择,并不是同一回事。
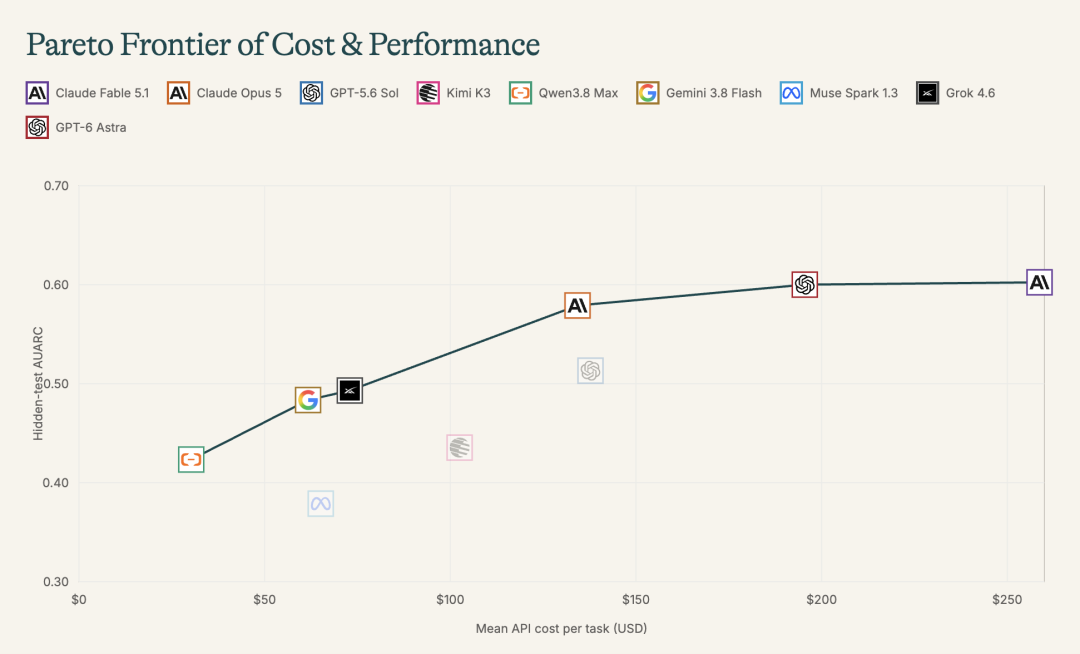
〓把 API 成本算进去,模型之间呈现不同的成本—性能折中
Sol 的科研轨迹里,调参占了大头
在纯超参数优化这一项上,GPT-5.6 Sol 达到 55.5%,是所有参测模型中最高的。
Sol 的纯调参轮次比例是 Astra 的约 2 倍,接近 Fable 5.1 的 8 倍。至少从这些抽样轮次看,Sol 的研究轨迹更频繁地落在纯参数调整上,Fable 则少得多。
这项统计来自每款模型随机抽取的 200 个研究轮次。研究团队用一个基于提示词的评审模型对这些轮次进行分类。只有当一轮研究没有提出新方法、没有加入实质性修复,只改变现有方案的参数设置时,才会被归为纯超参数优化。
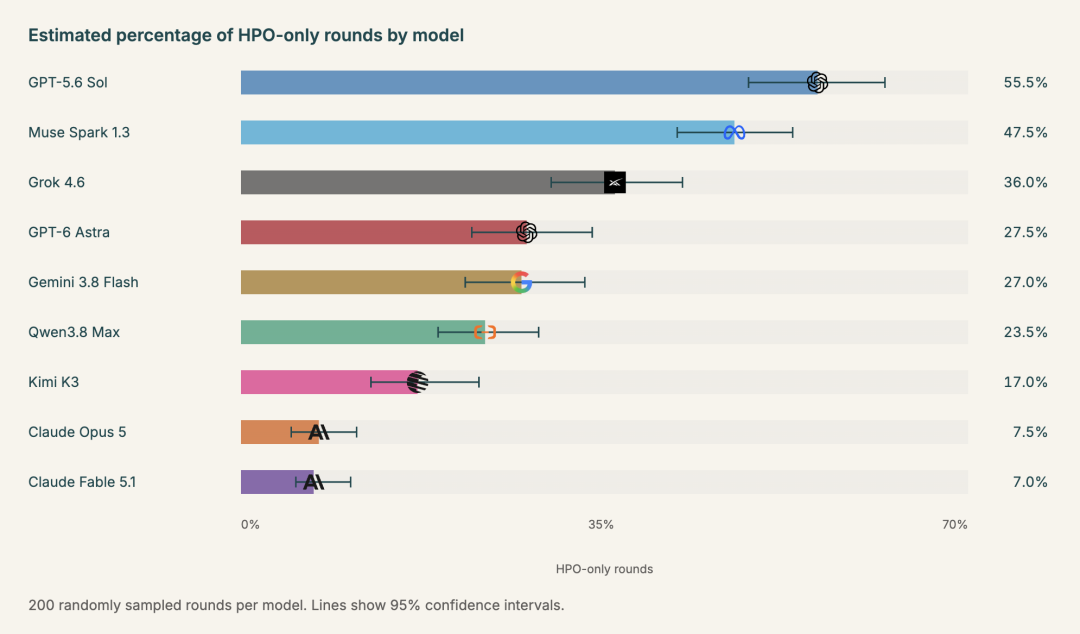
〓Sol 在抽样研究轮次中的纯调参比例最高
不过,55.5% 不能直接理解成 Sol 有一半时间“没有做研究”。
不同模型的实验和提交方式本身就不一样。Fable 和 Opus 有时会先在本地验证多个版本,再提交筛选后的方案;Sol 的总提交次数很多,也更少在开发集上先做内部调试。
研究团队因此只把这组结果解释为研究方式存在差异,并没有得出“调参越少,科研能力越强”的结论。
而在跨模型比较中,研究团队发现,提交次数与隐藏测试 AUARC 只有弱相关。提交更多,并没有稳定换来更高的隐藏测试成绩。单纯依靠更多提交做朴素的爬山搜索并不够,研究步骤本身的质量更重要。
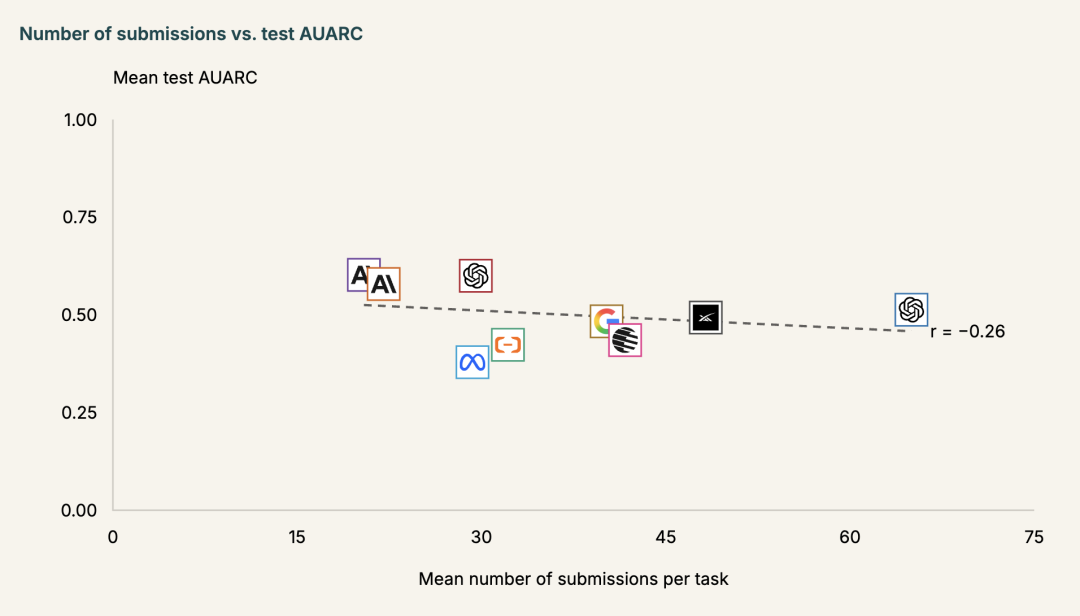
〓提交更多,没有稳定带来更高成绩
分数涨了,泛化未必跟上
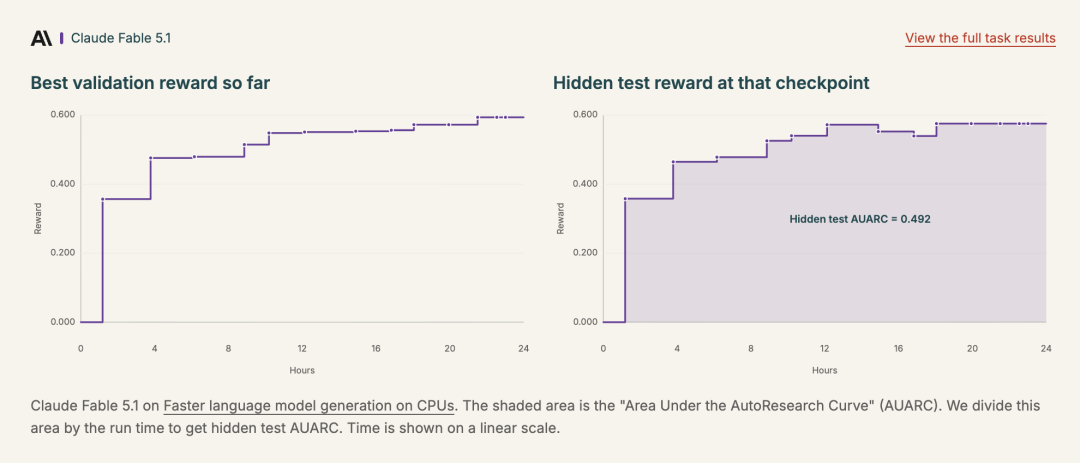
Fable 5.1 在 CPU 上的大模型生成加速任务中,就出现了这种情况。
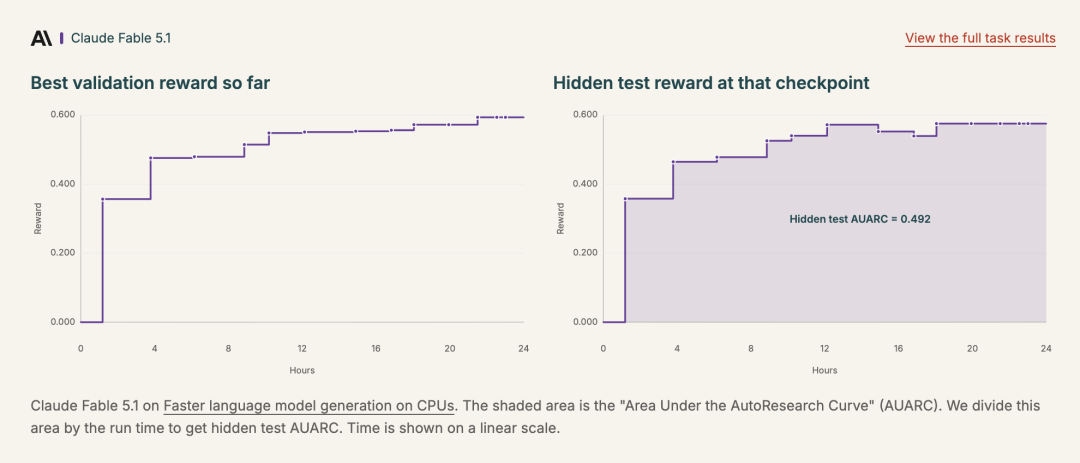
〓验证集上涨并不保证隐藏测试同步改善
左边记录截至当前时刻验证集表现最好的方案,右边则是同一版本在隐藏测试集上的成绩。
Agent 不断刷新验证集最佳值时,隐藏测试曲线并没有同步向上,期间还出现过回落。
Agent 可以反复围绕验证反馈优化,但这些改进未必都能延续到隐藏测试集。验证集上的进步,并不能直接等同于泛化能力的提升。
Sol 与 Astra 之间,这个相对差距从 6.9% 收窄到了 1.7%。Astra 的提升不只体现在总榜成绩,它在验证集上取得的进步,也有更大比例延续到了未见数据。
不过,研究团队也明确提醒,这一相对差距只能反映验证集与隐藏测试的一致程度,不能单独证明模型发生了过拟合。
〓同样的验证集进步,带到隐藏测试后保留下来的程度并不相同
研究团队还单独测试了历史研究轨迹里积累下来的经验能不能继续用。
他们把多条 AutoResearch 轨迹中的发现压缩成一句研究提示,让同一模型重新运行 200 轮,并与第一次 AutoResearch 运行的前 200 轮比较。结果取 22 个 CPU 任务的平均值。
加入提示后,Opus 5 的隐藏测试奖励值从 0.441 提升到 0.547;Muse Spark 1.3 则从 0.403 提升到 0.447,后者已经非常接近完整长程运行的 0.449。
这项结果说明,在固定 200 轮预算下,从历史轨迹中提炼出的经验能够改善隐藏测试表现。至于这些经验能否形成稳定、可迁移的科研方法,原文没有进一步验证。
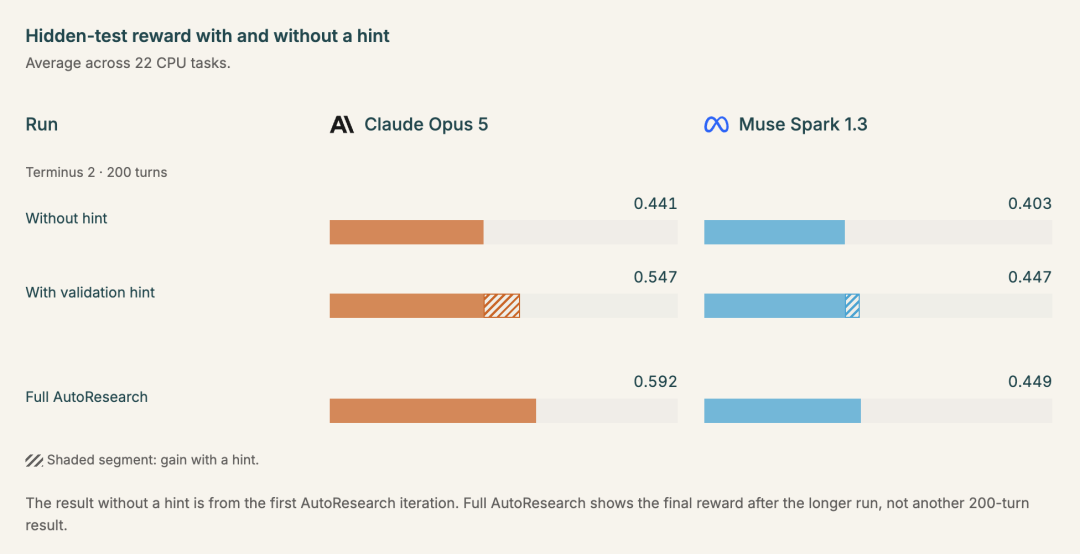
〓历史研究经验可以改善后续运行表现
结语
AutoResearchExam 把评价重点往前推了一步。连续跑实验只是起点,验证集上的提升能不能留到隐藏测试,才决定这些尝试有多少真正有效。
24 小时可以跑满,提交次数也可以继续增加,但长程科研 Agent 的差距,最终还是落在每一步研究质量和泛化能力上。
分数可以刷,泛化能力没那么容易。
更多阅读
#投 稿 通 道#
让你的文字被更多人看到
如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。
总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。
PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。
📝 稿件基本要求:
• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注
• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题
• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算
📬 投稿通道:
• 投稿邮箱:hr@paperweekly.site
• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者
• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿
△长按添加PaperWeekly小编
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧
·