EMNLP 2026 | 浙大LongDS发布v1.1,GPT-6 Astra领跑长程数据分析Lite榜
原创 让你更懂AI的 2026-09-16 20:36 北京
摘要
一项数据分析任务经历了几十轮后,筛选条件改过,指标定义换过,中间还做过几次临时假设检验。面对新的分析请求时,Agent 能否找到当前需要的状态,继续正确完成计算?
浙江大学、蚂蚁集团及联合实验室提出 LongDS-Bench,将这项多轮长程数据分析能力纳入系统评测。
LongDS 从真实 Kaggle 分析工作流构建了 68 个任务、2,225 轮交互,覆盖六个领域,论文已被 EMNLP 2026 主会录用。
此次发布的 LongDS v1.1 进一步细化任务规范,并推出包含 24 个完整任务、777 轮交互的 Lite 子集。在最新的 v1.1-Lite 榜单上,GPT-6 Astra 以 78.17 分暂列第一,Claude Fable 5.1 以 76.53 分紧随其后。
作者简介:徐柯伟,浙江大学软件学院硕士研究生,主要关注大语言模型智能体与模型行为引导,重点研究 Agent 能力评测、数据分析智能体、智能体自进化,在 ACL、ICLR、EMNLP 等会议发表多篇论文。
论文标题:
LongDS-Bench: On the Failure of Long-Horizon Agentic Data Analysis
主页地址:
https://zjunlp.github.io/DataMind/
代码地址:
https://github.com/zjunlp/DataMind/tree/main/longds
数据地址:
https://huggingface.co/datasets/zjunlp/LongDS
什么是 LongDS?
LongDS 是一个面向长程、多轮数据分析任务的 Agent 评测基准,用于评估 Agent 能否在长程连续分析中,始终用对当前需要的数据、指标和中间结果。
任务来自真实 Kaggle 分析工作流,包含 68 个任务、2,225 轮交互,覆盖商业、社区、教育、地学、社会公益和体育六个领域。
每项任务平均约有 32.7 轮交互,每轮都会提出新的分析请求,后续计算需要结合此前建立的分析状态完成。
重点考察长程分析状态的维护与演化,包括沿用已有规则、修改默认定义、尝试临时假设,以及找回和组合历史版本。
真实现状:数据分析做得越久,越需要用对之前的结果
让 Agent 读一份表格、算出平均值、找出排名靠前的对象,是常见的数据分析用法。
但一次分析通常不会停在这里,用户看完结果,可能还要缩小样本范围、调整指标权重,比较几种假设,再按早先的定义检查一遍结论。
随着分析推进,计算的依据也会变化,同一句“重新计算排名”在不同轮次可能要用不同的数据子集、计算公式和中间表,Agent 要分清哪些修改以后都要沿用,哪些只用于这一次比较,以及哪些旧结果后面还会用到。
一段代码即使运行成功,也可能使用了错误版本的数据或指标,这时通常不会有报错,但是看似正常的结果,已经偏离了用户的意图。而如果用户继续追问,Agent 又沿用这些中间结果,错误就会影响后面的计算。
要让 Agent 完成持续的长程数据任务,就需要检验它能否在多轮请求中一直用对分析依据。
LongDS 将这些依据统称为分析状态,包括数据范围、指标定义、假设和可复用的中间表等,并考察 Agent 能否随着对话推进,长期保存并使用正确的分析状态。
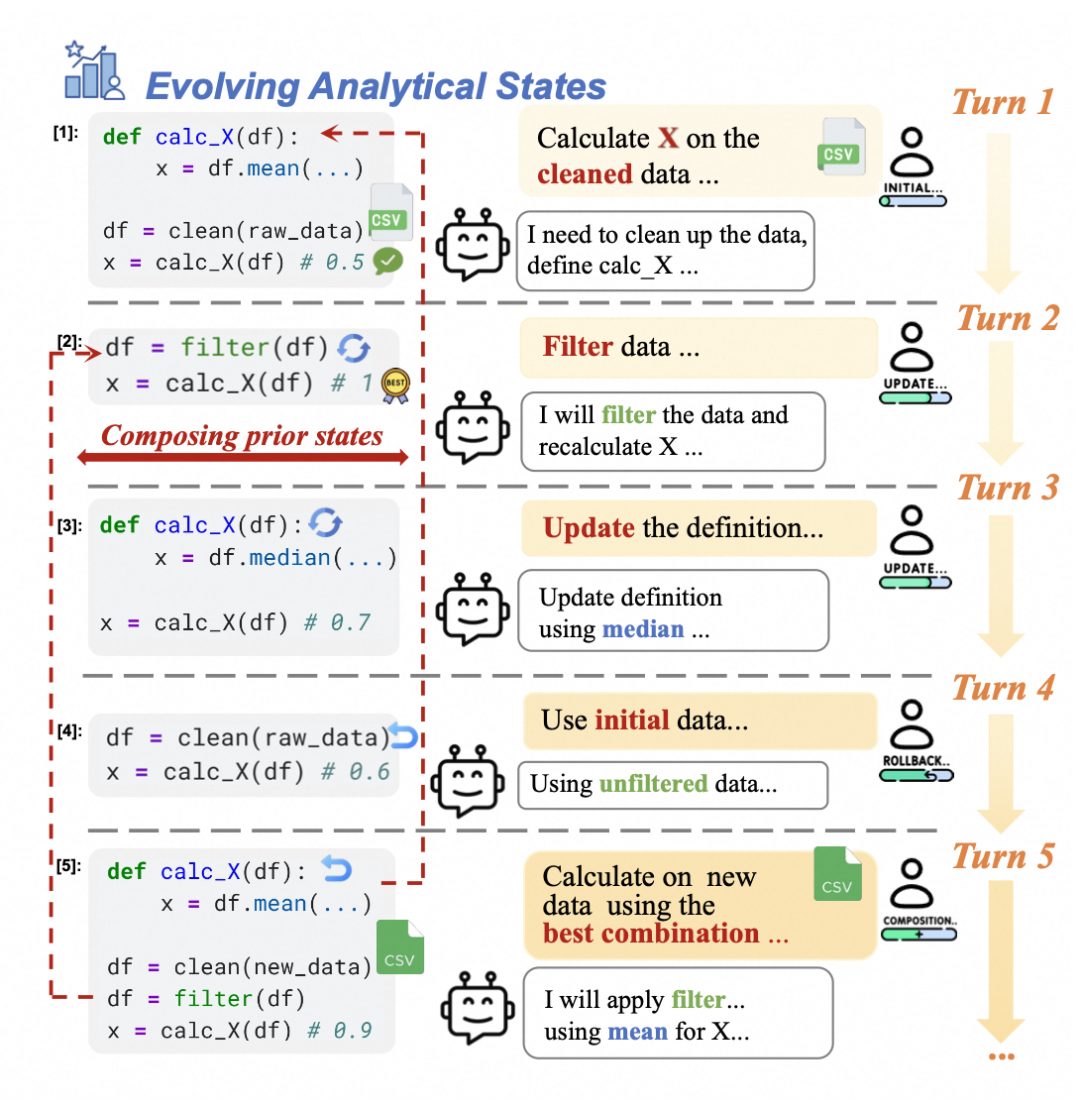
〓 图1. 分析状态随多轮请求演化,Agent 需要处理数据筛选、指标更新、历史回退,并组合此前建立的状态。
LongDS 与其他数据分析基准有什么区别
工具调用次数多、输入文本长、用户交互轮次多,都可以让 Agent 的任务变长,而 LongDS 重点考察后续请求如何使用前面留下的分析状态。
目前已有的数据分析基准通常会给出完整目标,Agent 可以据此开展工作;其他的一些交互式基准则通过多轮对话澄清需求,或逐步提供分析指导,以完成初始任务。
而 LongDS 的每一轮都有新的分析请求和独立的参考答案,回答后续问题时,Agent 还需要继承、修改或恢复此前建立的状态。
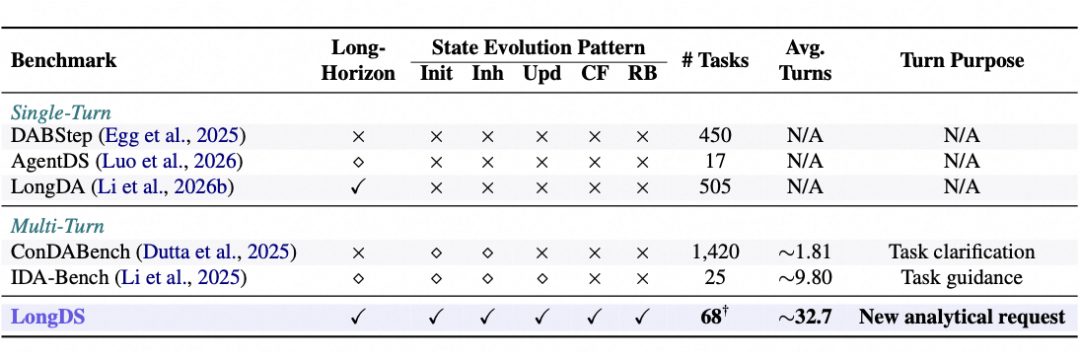
〓 图2. LongDS 与已有数据分析基准的比较,涵盖长程任务、状态演化行为、任务数量、平均交互轮次和每轮交互的目的。
其中的难处在于分析过程中可能留下多个有效版本,最新的版本未必适合当前问题。
如果用户要求沿用新的指标定义,同时恢复早先的数据范围,Agent 就需要弄清每次修改在什么时候有效、影响哪些计算,才能把这些状态正确组合起来。
LongDS 将分析过程中的状态行为归纳为以下六种模式。表中的用户活跃度作为示例,用于说明各类操作的语义。
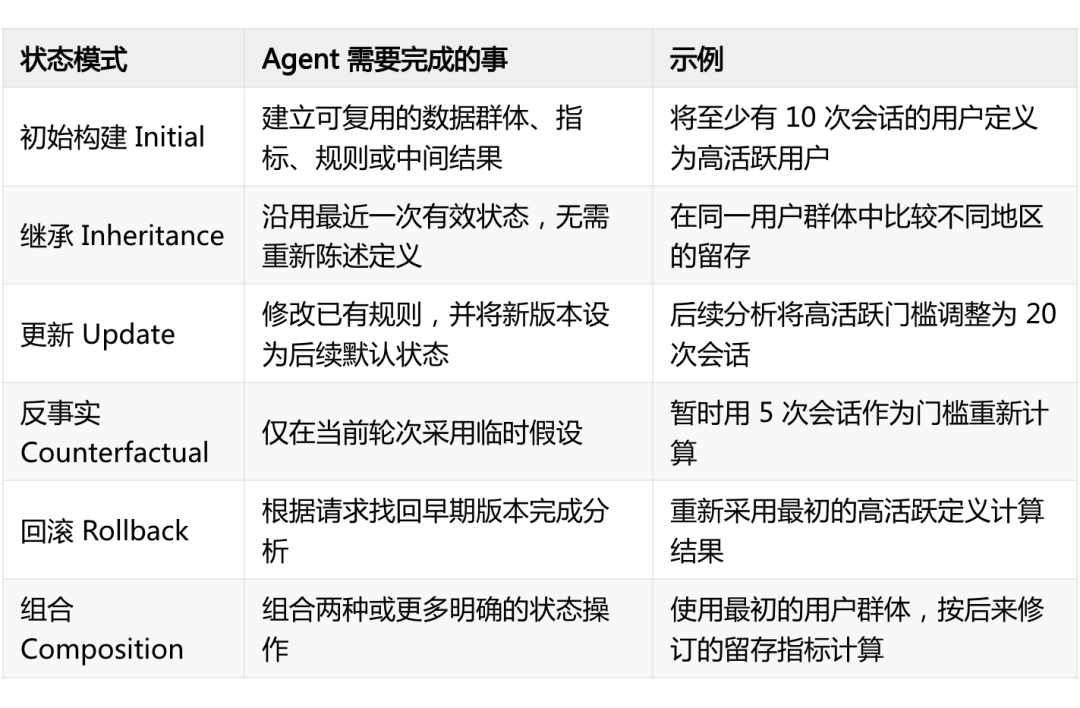
后续轮次默认继承此前有效的状态,因此论文没有将状态继承单独作为标注类别计数。
同一轮还可能同时涉及更新、回退等多种行为,遇到“沿用之前的结果”这样的请求时,Agent 还得确定具体用哪一版,保留哪些部分,又改动哪些部分。
LongDS 如何把真实分析变成长程评测
LongDS 完整版包含 68 个任务、2,225 轮交互,覆盖商业、社区、教育、地学、社会公益和体育六个领域,平均每项任务约有 32.7 轮交互,每轮平均直接依赖约 2.85 个历史轮次,最远依赖距离平均约为 11.3 轮。
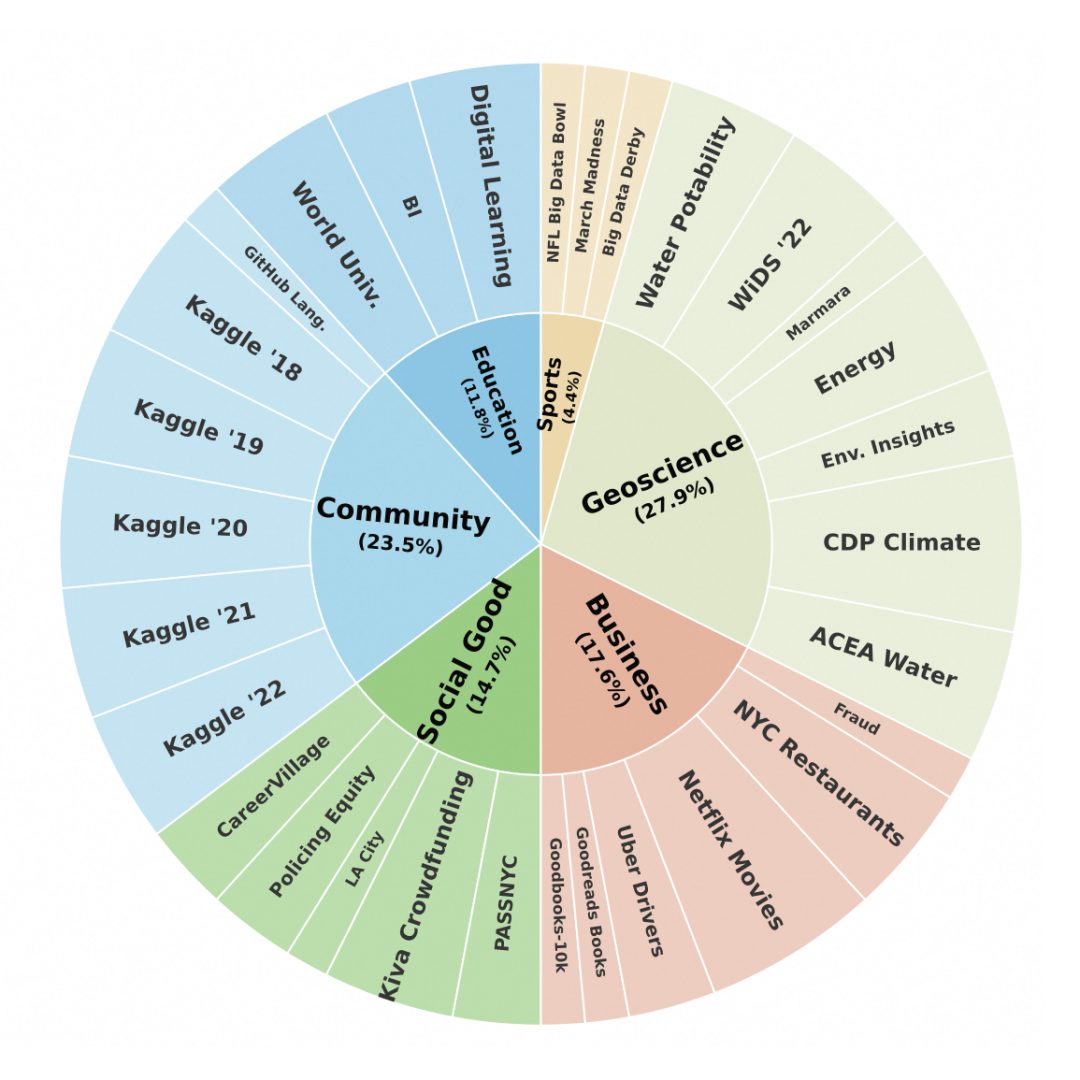
〓 图3 LongDS 完整版的任务分布,内圈展示六个领域及其任务占比,外圈展示对应的数据来源。
4.1 从可执行 Notebook 到可核验的多轮任务
研究团队收集了来自 64 个 Kaggle 竞赛或公开数据集的 256 份 Notebook,通过检查数据是否可用、代码能否执行、分析是否足够深入等一系列筛选之后,最后保留了 77 份可执行 Notebook。
接着挑选三个 Notebook,保留原始分析主线,将相关代码单元组织为分析片段,识别其中可被后续轮次复用的数据范围、指标与中间结果后,人工构建三个多轮长程种子任务。
基于这三个示例和任务设计原则,抽取出任务构建 skill,再通过 Codex 辅助构建其余初始任务。每轮都配有用户请求、可执行的参考代码、参考答案,以及状态和依赖标注。
初始任务随后经历专家审查、Agent 辅助验证,以及最终一致性检查。接着团队重新执行参考代码,核对依赖是否必要、问题是否有歧义、参考答案是否可靠,并删除无法修复的任务。
对于部分重复描述早期规则的请求,还会在保证答案可确定的前提下去掉冗余提示,保留跨轮次追踪状态的要求。
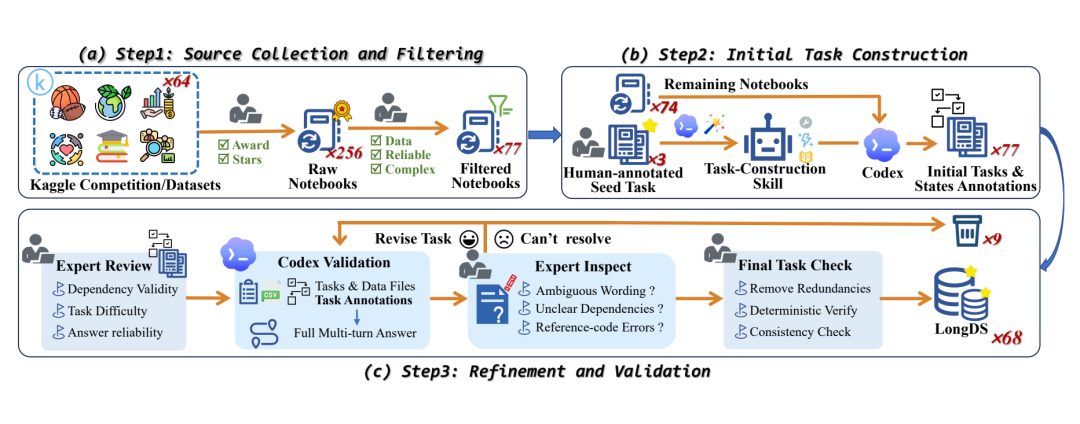
〓 图4. LongDS 从真实 Notebook 构建多轮任务,再通过人工审核、执行验证和一致性检查筛选任务。
评测使用 DeepSeek-V4-Pro 为每一轮回答分别打分,根据回答与参考答案在语义和数值上是否一致,给出 0 或 1 分;汇总时先计算每项任务的逐轮正确率,再对所有任务等权平均。
4.2 Task 示例:一项 36 轮 Netflix 分析,如何同时保留多个状态
论文中的 Netflix 市场机会分析展示了不同轮次怎样用到此前的结果。
第 1 轮,Agent 清洗节目目录和搜索热度数据,建立后续要用的分析表;第 2 轮,它按指定的时间窗口和国家归属规则计算市场机会分数;到第 3 轮,用户要求解释排名靠前的市场为什么得到这些分数,Agent 就需要沿用第 2 轮选出的候选市场和权重。
到了第 18 轮,用户想把长电影的时长门槛从 110 分钟临时放宽到 100 分钟,看看哪些市场还能留在前五,Agent 就需要在此前的长电影分析基础上重新计算。
由于这次调整只用于临时比较,原来的默认分数需要保留,后续分析仍按原有规则继续。
第 24 轮需要用到更早的结果,Agent 要根据第 23 轮的当前分数选出前八个市场,取回第 21 轮引入导演惩罚前的分数,再与第 12 轮的基线比较。
选市场、取分数和做比较各自要用不同轮次的结果,整个过程还要保持当前有效的分数不变。
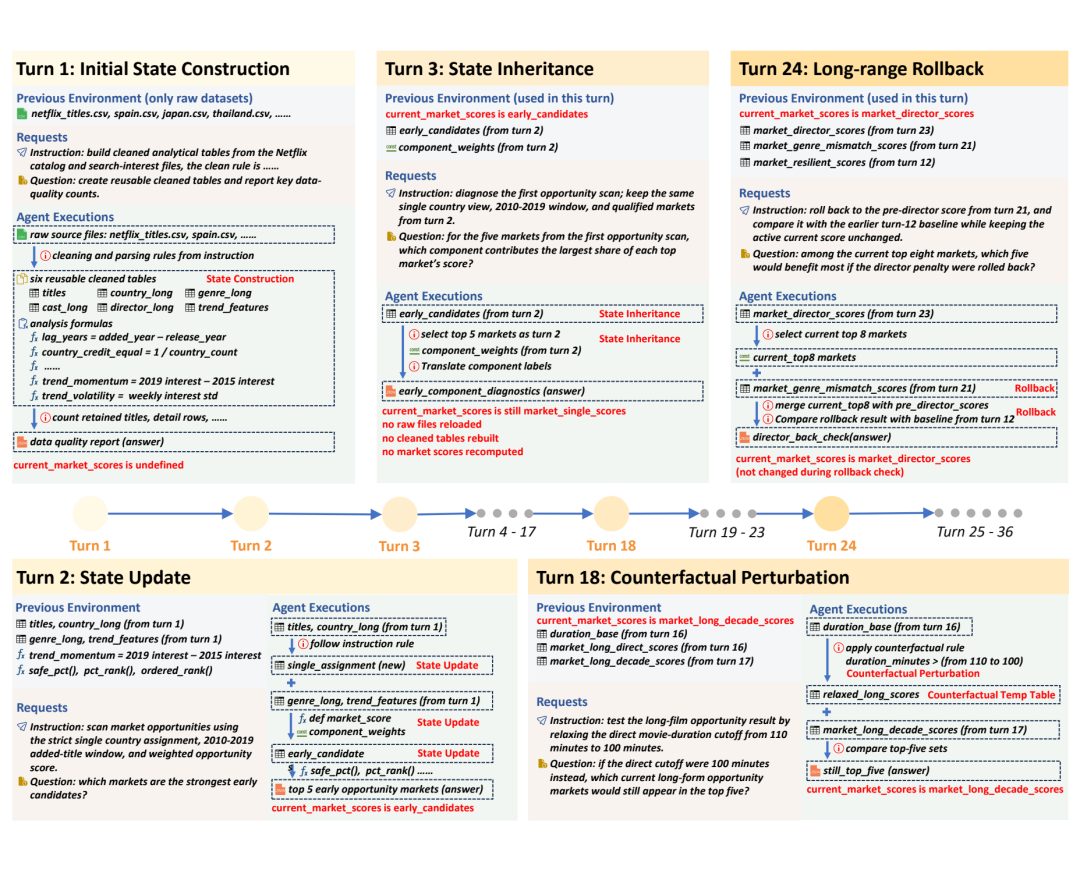
〓 图5. 36 轮 Netflix 分析中的代表性状态变化,Agent 需要分清临时假设、历史版本与当前默认状态,并按请求使用它们。
v1.1 更新了什么,Lite 又保留了什么
随着论文被 EMNLP 2026 主会录用,团队发布了 LongDS v1.1 和 v1.1-Lite。
团队在 v1.1 中重新核查了整个基准,修订可能引起歧义的任务表述,修正部分参考答案中的错误,并明确并列结果的处理规则和输出要求。
这些修订保留了原有的分析逻辑与跨轮次状态依赖,便于更准确地评估 Agent 是否使用了正确的分析状态。
为方便开发者反复测试模型,团队从 v1.1 完整版中选出 24 个任务组成 Lite 子集,优先选择能够区分不同 Agent 表现的任务。这些任务覆盖全部六个领域和多种状态演化行为。
Lite 保留了所选任务的全部内容和轮次,总计 777 轮,平均每项任务仍有约 32 轮。开发者要跑的任务少了,每项任务中的长程对话和状态依赖仍然完整,可以用更少的时间和成本检验 Agent 的长程状态管理能力。
运行方式上,LongDS 除 DSGym 外还提供 Codex、Claude Code、Kimi Code 和 Qoder 四种原生运行器,均支持本地与 Docker 评测。
在 Docker 模式下,每项任务使用独立容器,运行器通过原生会话续接,让任务的所有轮次在同一个 Agent 对话中连续完成。
LongDS-v1.1:GPT-6 Astra 与 Claude Fable 5.1 表现如何
截至 2026 年 9 月 7 日,官网 v1.1-Lite 榜单如下,图中评测记录日期均为 9 月 5 日。
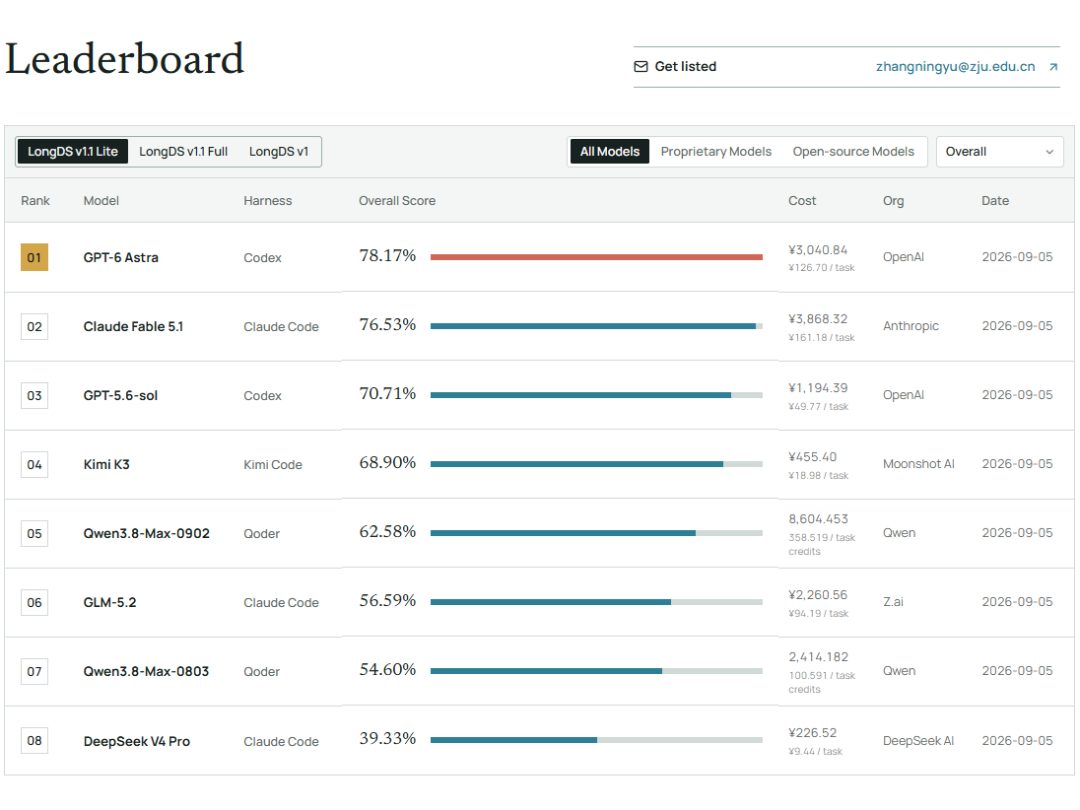
〓 图6. LongDS v1.1-Lite 榜单(https://zjunlp.github.io/DataMind/#leaderboard)
GPT-6 Astra 暂居榜首,比 Claude Fable 5.1 高 1.64 个百分点,比同样使用 Codex 的 GPT-5.6-sol 高 7.46 个百分点。前两名的表现比较接近,其他模型在这组长程分析任务上的得分则相差较多。
LongDS-v1:论文原版实验结果
论文原版实验使用 DSGym 评测了五个模型,其中 Gemini-3.1-Pro 得分最高,为 48.45,GPT-5.4 和 Claude-4.6-Sonnet 分别为 43.50 和 41.56。
新版 Lite 榜单的模型、任务版本、任务集合和运行框架都发生了变化,两组分数需要放在各自的设置下解读。
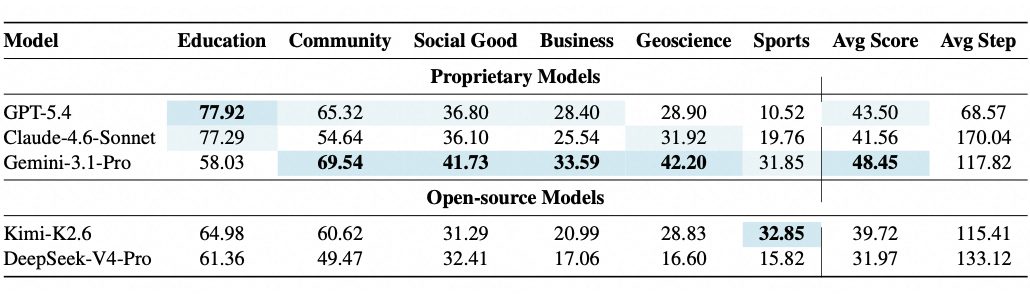
〓 图7 五个模型在 LongDS 原版基准上的实验结果,均使用 DSGym 评测,表中列出了六个领域的得分、任务平均分和平均交互步数。
从原版实验看,错误怎样在长程分析中积累
为了了解 Agent 在什么地方容易出错,论文原版实验还做了进一步分析。以下结果均来自原版基准及当时评测的模型。
8.1 越到任务后段,越难维持正确分析
研究团队按相对进度对齐不同长度的任务,发现从任务最初 10% 到最后 10% 的进度区间,整体正确率下降约 46.8 个百分点。
历史依赖越复杂,模型也越容易答错,直接依赖的历史轮次增加、需要追溯的距离变长,都对应着更低的正确率。按状态行为比较,回退到旧状态的请求也比初始构建更难。
因此,只看当前这一步的计算难度还不足以解释模型的表现,因为分析做得越久,Agent 越需要从积累的历史中找准依据,判断早先的修改到了这一轮是否仍然适用。
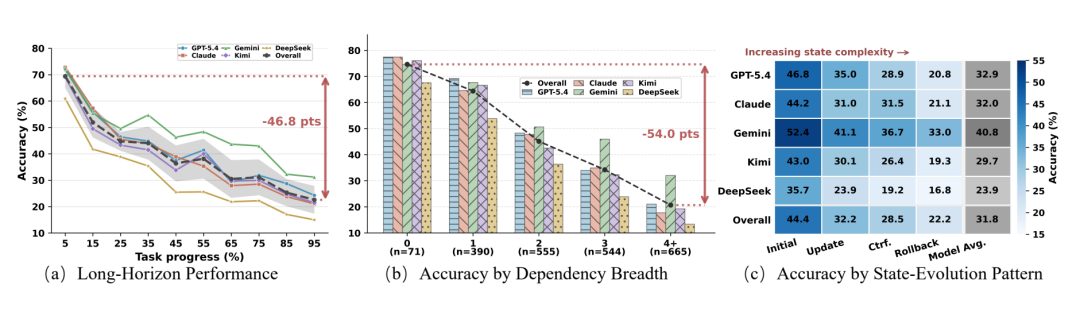
〓 图8 原版实验中的性能退化。三个子图分别展示任务进度、直接依赖数量和状态演化类型与正确率的关系。
8.2 错误的中间状态会影响后续多个回答
团队分析了抽样任务中的 3,207 个错误轮次,将上下文记忆错误、状态管理错误和级联错误归入长程错误,三类合计占各模型被分析错误的 52% 至 69%,其中级联错误占比最大。
发生级联错误时,当前轮的运算逻辑可能没有问题,出错的是更早生成、又被这一轮沿用的中间状态。Agent 沿用它继续计算,就会得到另一个错误答案,因此只检查本轮代码,未必找得到最初错在哪里。
状态管理错误包括选错版本、更新错对象或恢复不合适的历史状态,而单纯记不起历史信息的上下文记忆错误相对更少。要减少这类问题,就需要在保存信息之外进一步检查当前该用哪个版本,以及留下的中间结果是否正确。
8.3 清空环境有时帮助恢复,也可能丢掉正确积累
已有状态会影响后续计算,那么清空环境、重新构建会怎样?论文用 GPT-5.4 做了一个诊断实验,在指定轮次清空代码环境中的变量和中间结果,保留对话历史,再比较重置后各轮的正确率。
在原本表现较弱的任务上,重置带来了小幅改善;在表现较好的任务上,正确率却明显下降。原因在于已有状态出错时,重新构建有机会减少错误传播;状态本来正确时,清空环境又会删掉后续分析需要的结果。
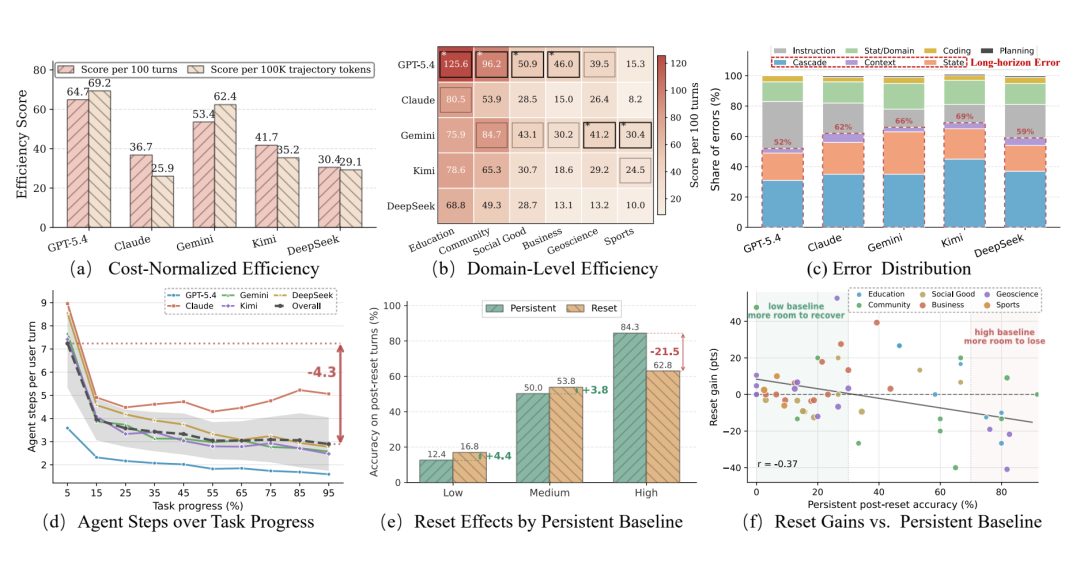
〓 图9. 原版实验对交互效率、错误类型、逐轮行为和环境重置的分析。重置实验使用 GPT-5.4,比较相同后续轮次上的表现。
论文还观察到,交互步骤更多的模型并不总能得到更高的正确率。如果一直沿用错误状态,增加推理或工具调用预算,也可能只是在反复计算错误的结果。
这些实验也提示了一些可以尝试的改进方向,例如为分析对象记下来源轮次和有效版本,将临时分支与默认状态分开保存,检查关键中间表,并在发现状态冲突后只重算受影响的部分。
如何运行评测并提交榜单
想测试自己的模型或 Agent 框架,可以按团队建议从 v1.1-Lite 开始。跑完 24 个完整任务,整理好版本、配置、成绩和执行轨迹,就可以提交新版榜单。
9.1 下载数据并选择运行器
先获取项目代码,进入其中的 longds/ 目录,通过 Hugging Face CLI 下载数据。
hf download zjunlp/LongDS --repo-type dataset --local-dir dataset这条命令会下载整个数据集仓库。只打算评测 Lite,可以按数据集页面的定向下载说明获取所选任务及其对应数据。已经下载过 v1 的用户可以复用原始数据,只更新任务文件。
接着,选择 Codex、Claude Code、Kimi Code、Qoder 或 DSGym 运行器,按对应安装指南准备环境,配置模型访问方式。四种原生 CLI 运行器都支持本地和 Docker 模式。
下面以 Codex 的 Docker 评测为例,所有命令均在 longds/ 目录下运行。
9.2 先检查一轮,再运行完整 Lite
准备好 Python 环境、Codex 配置和 Docker 镜像后,还需要设置评审模型的 JUDGE_API_KEY 和 JUDGE_BASE_URL。当前 CLI 运行器默认使用 deepseek-v4-pro 判分,具体步骤见Codex 完整示例:
https://github.com/zjunlp/DataMind/tree/main/longds#example-run-v11-lite-with-codex
先跑一个任务的一轮,检查模型调用、数据执行和自动评分是否正常。
python runners/codex/run_codex_longds.py \
  --use-docker --task-limit 1 --turn-limit 1 --judge
随后移除任务数和轮数限制,运行完整 Lite。
python runners/codex/run_codex_longds.py \
  --use-docker --run-parallel 4 --judge
这条命令会并发运行 4 个任务,每项任务内部仍按轮次顺序执行,并延续同一个 Agent 会话。评测会消耗模型调用额度,可以根据资源调整并行数。要评测 v1.1 完整版,添加 --split full 即可。
9.3 检查任务覆盖,保留轨迹后提交
运行结束后,程序会在 summary.json 中汇总本次实验,其中 task_avg_score 乘以 100 即为百分制任务平均分。
每项任务的回答、逐轮分数和执行轨迹都会保存在实验目录中,开发者可以通过 GitHub Issue 提交结果,也可以通过邮箱联系团队。
提交时附上基准版本与子集、模型与 Agent 框架、运行设置、任务覆盖、分数和执行轨迹。欢迎大家参与评测!👏
更多阅读
#投 稿 通 道#
让你的文字被更多人看到
如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。
总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。
PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。
📝 稿件基本要求:
• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注
• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题
• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算
📬 投稿通道:
• 投稿邮箱:hr@paperweekly.site
• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者
• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿
△长按添加PaperWeekly小编
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧
·