AI会做题,却未必能自进化!字节Seed三项新基准探索RSI闭环
原创 让你更懂AI的 2026-09-15 19:17 北京
从自我改进走向递归式进化
让 AI 自己训练、复盘、改代码,只完成了自我改进的一部分。更难的是:谁来决定改什么,凭什么判断改好了,以及这次改进能否帮助下一轮改进?
如果任务、答案和评分标准都由人准备好,AI 可以沿着反馈不断优化。
但当目标变成「成为一个更好的研究者」,下一份训练数据从哪里来,下一项测试该测什么,又由谁判断努力是否用对了地方?
AI 会执行改进流程,与 AI 能持续推动自己的改进,是两个不同的问题。后者正是递归式自我改进(Recursive Self-Improvement,RSI)需要面对的挑战。
字节跳动 Seed、TokenWave 等机构的研究者,在 Self-Developing Agents 项目 Blog 中把讨论焦点放在了这里:从依赖外部标准的「半闭环」,走向能够形成目标、检验经验并积累能力的更完整闭环。
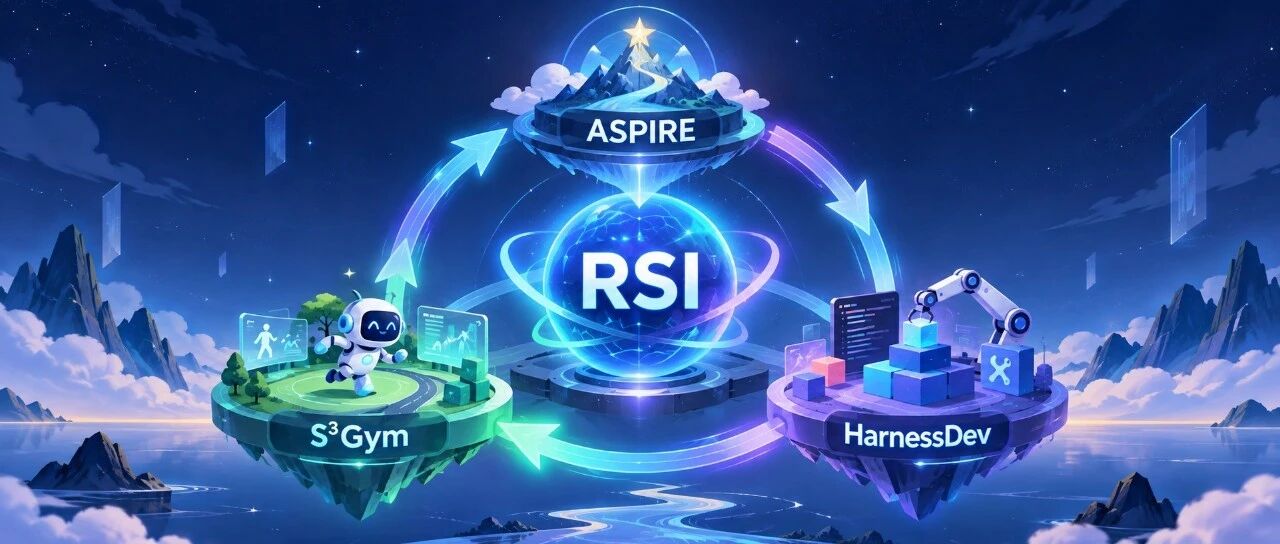
围绕这些问题,团队提出了 ASPIRE、S³Gym 和 HarnessDev 三项评测基准。
RSI 要闭环,不能把最难的判断一直留给人
项目 Blog 用「Golden Verifier」概括一种关键假设:系统已有足够可靠的判定机制,能够告诉模型哪些改动值得追求。
在这个前提下,Agent 可以不断生成数据、训练模型、修改策略。作者所说的「半闭环」,针对的是目标与验证仍主要由外部提供的情形,而不是说这些优化没有价值。
ASPIRE 论文给出了一个具体区分:「提高某套数学测试的分数」,与「提高数学推理能力」,并不是同一个起点。
前者已经确定了题型、难度和成功标准;后者还需要判断短板在哪里、哪些练习值得做,以及练习上的进步能否迁移到真正关心的能力。
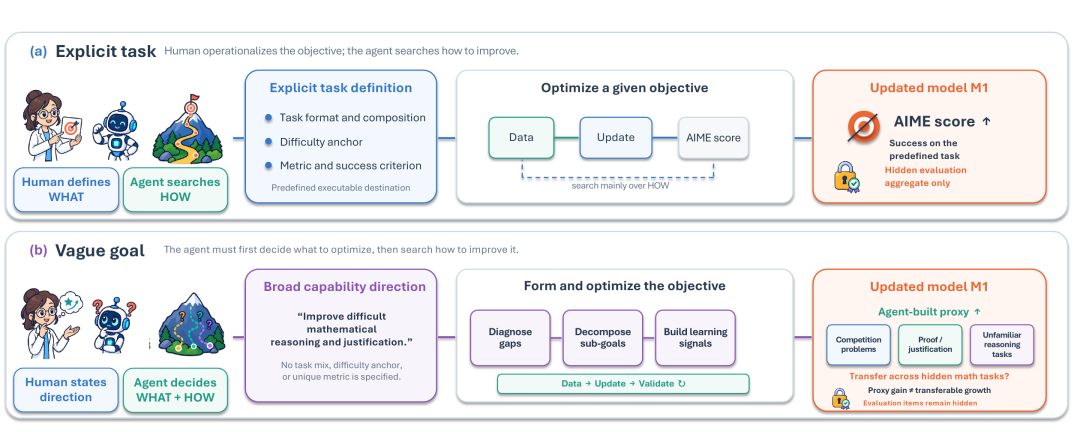
〓图1. 上半图中,人已经把能力需求转成明确任务;下半图中,Agent 还要自己决定优化什么。两种设置都需要外部评测检查结果,差别在于哪些判断交给了 Agent。
沿着这个区分,闭环可以理解为:从宽泛目标出发,发现问题;通过尝试获得经验,检验哪些经验有效;把有效改动保留下来,再用更新后的能力开始下一轮。
「递归」的要求在最后一步。一次修改即使让当前任务做得更好,也还需要检验:它有没有帮助系统更好地发现问题、设计测试和实施后续改进?
如果每遇到新的能力短板,都要人重新指定任务、重建评分标准,改进过程仍依赖外部不断补上关键判断。
闭环也不等于让 AI 自己说了算。Agent 可以构造学习信号,但这些信号是否可信,仍要接受独立于其自我判断的检查。
否则,一次错误判断就可能被当成经验保存,并影响后续行动。三项基准保留隐藏评测、程序验证器或开发结束后的测试,正是为了区分 Agent 认为的进步与评测实际观察到的变化。
由此,三项工作形成了同一条研究主线:ASPIRE 检查目标能否选对,S³Gym 检查经验能否学会,HarnessDev 检查系统改进能否留下来。
它们分别测试闭环所需的环节,尚不是一个已经实现完整 RSI 的端到端系统。
ASPIRE:方向选偏了,训练跑通也没有用
论文地址:
https://arxiv.org/abs/2608.31111
项目地址:
https://self-developing-agents.github.io/
ASPIRE 把原本由人完成的目标拆解,交给 Agent。它只提供自然语言描述的能力方向,由 Agent 选择数据、更新方法和验证方式。
最终检查使用 520 道专家原创题,覆盖六类能力目标;题目、答案和逐题反馈始终隐藏。
在允许有限汇总反馈的实验中,5 个配置与 6 个目标组成 30 个实验格,每格运行一次。28 格产出了已评分版本,21 格产出了符合预定记录与完成要求的候选版本;经过选择与回滚,只有 1 格保留了高于初始模型的分数。
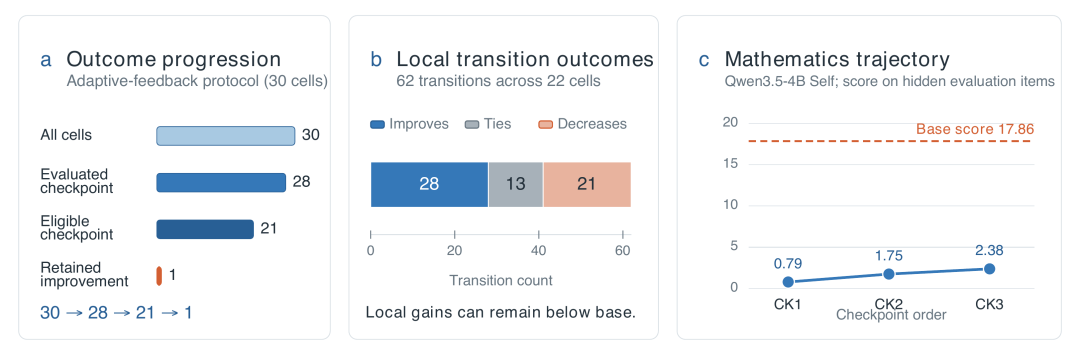
〓图2. 训练流程可以完成,收益却未必留下。左侧为 30 个实验格的筛选结果;中间为相邻版本的分数变化;右侧 Qwen3.5-4B 自我训练案例从 0.79 升到 2.38 分,仍低于初始模型的 17.86 分。
失败并不只发生在训练之后。在另一组只评最终版本的实验中,有 Agent 使用答案标签为单个数字的数据训练模型。
研究者检查到,相关模型的 279 个评测输出全部是单个数字,5 个版本中有 4 个得分为 0。
这类案例暴露了目标形成的困难:Agent 找到了能够执行的训练任务,却没有充分验证它是否服务于原来的能力需求。
对 RSI 而言,选择学习材料、构造验证方式,本身就是需要改进的能力,不能总被当成已经解决的前提。
这里的「1/30」不能当成通用自进化成功率。实验反复查询同一固定评测切片的汇总分,保留的高分版本也未经过独立确认集检验。它说明的是特定协议下目标选择、学习与保留收益的困难。
S³Gym:经历过、总结过,不代表下一次做得更好
论文地址:
https://arxiv.org/abs/2608.31100
项目地址:
https://self-developing-agents.github.io/
目标确定后,下一步是把经历转成可用的经验。
S³Gym 在七个文字游戏中检查这个过程:Agent 自己探索并判断行动效果,但探索时看不到程序验证器给出的真实步骤奖励和最终分。
研究者随后用更严格的条件和另一组随机种子测试它,测试轨迹不会回流为学习材料。
这样,写下一段复盘并不算完成学习;经验必须改善之后的行动。研究比较了保留原始历史、保存跨局摘要和更新模型参数三条路径。
在植物大战僵尸中,从原始历史换成摘要记忆,Gemini 2.5 Flash 的累计正向收益 AUC+ 从 24.4 提升到 238.5,Gemini 2.5 Pro 却从 60.4 降到 11.9。AUC+ 汇总曲线中高于初始分数的部分,不是最终游戏得分。
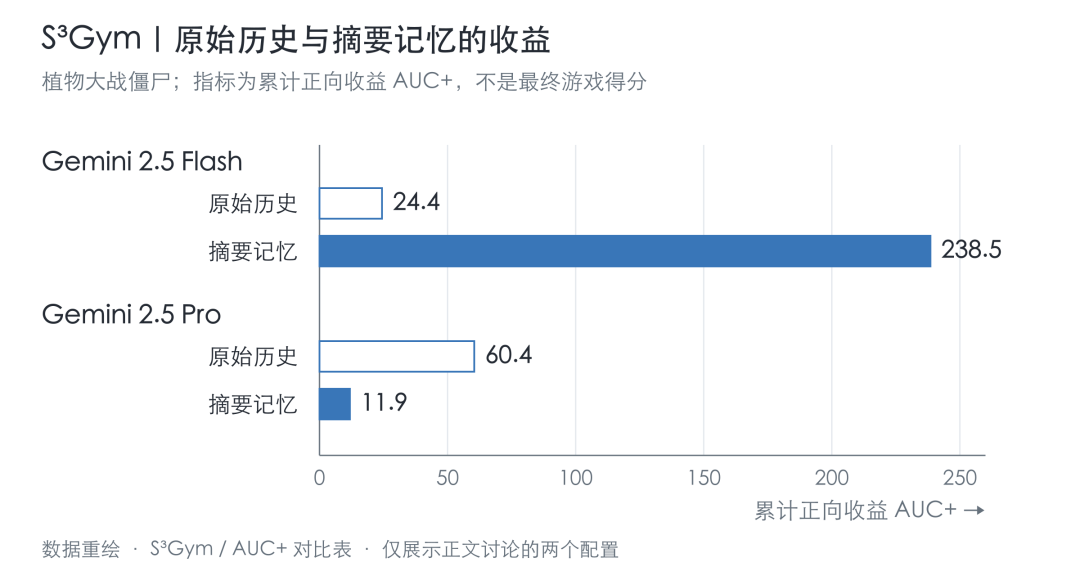
〓图3. 同一游戏、同一指标下,摘要记忆在两个模型上带来相反方向的变化。AUC+ 越高表示累计正向收益越大,数字保留一位小数。依据 [S³Gym,AUC+ 对比表](https://arxiv.org/abs/2608.31100)重绘,仅展示正文讨论的两个配置,非全模型排名。
把经验写进参数,同样可能带来进步或退步。在一条 Qwen3-8B 训练轨迹中,信任博弈从初始 0 分达到最高 30 分,19 个训练后版本有 18 个高于初始模型。
植物大战僵尸却从 23 分降到 6 分,所有后续版本都停留在那里;扫雷、数字消除和俄罗斯方块全程没有测到收益。
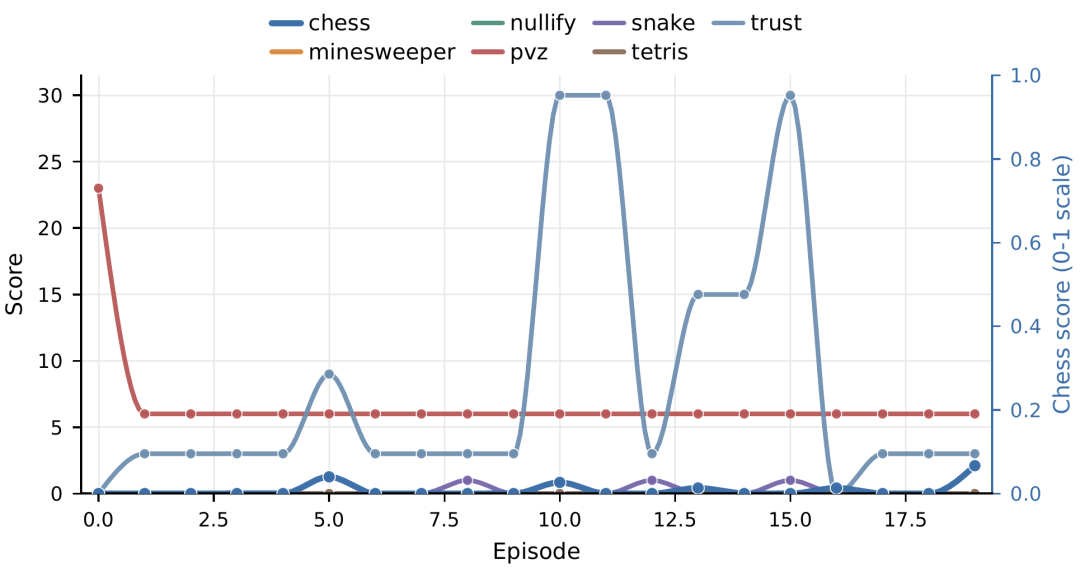
〓图4. 同一条训练轨迹在不同游戏上呈现收益、停滞和退步。横轴对应原始模型及 19 个训练后版本;30 分为信任博弈峰值。不同游戏量纲不同,Chess 使用右轴,应各自与初始分数比较。
这些结果把闭环中的「学习」变成了可以核对的问题:保存下来的内容,究竟有没有帮助下一次决策?
论文的轨迹分析提示,可概括成策略的经验与依赖精确状态的经验,可能需要不同处理方式;但实验没有单独检验摘要长度,也没有确定参数训练退步的唯一原因。
HarnessDev:一次局部改进,能否成为下一次的能力?
论文地址:
https://arxiv.org/abs/2609.01437
项目地址:
https://self-developing-agents.github.io/
RSI 还需要回答,经验如何进入长期使用的系统。
HarnessDev 让模型创建并持续修改自己的执行系统,评测对象是能够跨任务复用的程序,而不只是某次任务的答案。创建阶段覆盖四个领域、五个基准、2,207 个去重任务;演化阶段则追踪修改后的系统表现。
研究中已经有可用系统被创建出来。但本文更关心随后的检验:开发反馈支持一次修改,是否足以说明它值得保留?
每个正式版本冻结后再评测,模型权重保持不变,使系统改动的效果能够被单独观察。
在固定 Gemini 执行的两条轨迹中,Qwen 3.7 Max 创建系统的可见反馈分从 62.1 升到 63.2,隐藏任务分却从 49.52 降到 48.41。
DeepSeek V4 Pro 的可见反馈分从 47.3 升到 53.8,隐藏任务分从 43.02 降到 40.63。
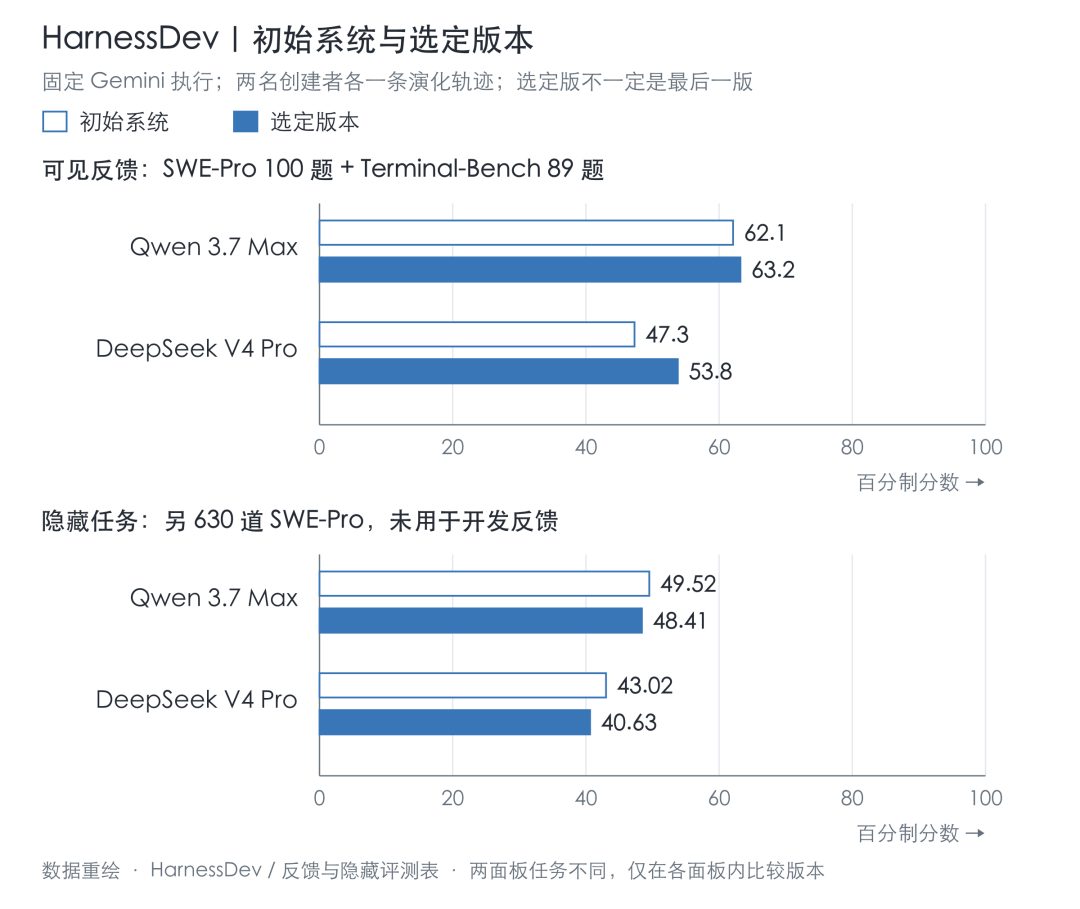
〓图5. 可见反馈提高,未参与开发的隐藏任务却下降。上半图为 SWE-Pro 100 题与 Terminal-Bench 89 题百分制分数的等权平均;下半图为另 630 道 SWE-Pro。两面板任务不同,只在各自内部比较初始与选定版本。每个创建者一条轨迹,选定版未必最后生成。依据 [HarnessDev,反馈与隐藏评测对比表](https://arxiv.org/abs/2609.01437)重绘。
运行记录还能把一些失败定位到具体改动:Qwen 的消息清理逻辑破坏了合法的工具返回序列;DeepSeek 的上下文压缩改动破坏了工具消息配对,随后回滚了大量修改。
因此,局部问题的修补能否成为可复用能力,需要下一组任务来检验。
这里的演化实验集中在代码任务,事后隐藏评测只覆盖 SWE-Pro,各配置只有一条轨迹;研究也未进一步验证让新系统充当下一轮开发环境的递归过程。这些结果揭示了闭环中的风险,并没有证明长期系统演化已经可靠。
要形成闭环,还需要让改进经得起下一轮检验
把三项工作放在一起,接下来的研究任务就更具体了:自主提出的学习目标,能否对应真实的能力短板;从交互中留下的经验,能否改善后续决策;被写进系统的改动,能否迁移到新任务,并支持进一步开发。
三项实验还没有共同回答最后一个问题:当这几个环节真正接起来,系统能否连续多轮可靠地进步?
要回答它,需要让上一轮保留的模型、记忆或执行系统进入下一轮,再检查收益是否持续、错误是否累积,以及系统能否及时纠正自己的判断。这是沿着现有证据需要继续做的实验,不是当前结果已经给出的结论。
项目还用前线部署工程师(Forward-Deployed Engineer,FDE)的工作作类比:识别实际问题、交付方案,再把经过验证的方法用于后续项目。
研究关注的是这种从局部工作中积累可复用能力的过程,而非声称已经能够替代完整岗位。
FDE 是一个真实岗位。评测(Evaluation)在这里是研究相关工作能力的代理指标(proxy),而不是对这份工作的重新定义。受控测试让目标、经验和系统改动能够被逐项检查;真正的工作还涉及组织需求、数据、协作和交付约束。
AI 是否能自进化,最终需要看这些改动有没有改善后续的工作与学习。让它开始一次尝试,只是起点;让它知道哪些尝试值得带入下一轮,才是这组三项基准共同追问的问题。
更多阅读
#投 稿 通 道#
让你的文字被更多人看到
如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。
总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。
PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。
📝 稿件基本要求:
• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注
• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题
• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算
📬 投稿通道:
• 投稿邮箱:hr@paperweekly.site
• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者
• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿
△长按添加PaperWeekly小编
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧
·