Agentic native的具身端侧推理引擎,最新实测来了!
原创 Datawhale 2026-09-17 22:01 浙江
Datawhale开源
开源项目:APXInf,发布:无问芯穹
把一个视觉语言大模型部署到机器人本体上,是不少具身开发团队面临的工程难题。
模型在云端或仿真环境里跑通了,到了端侧,还要面对算力、内存和功耗的限制,以及机器人对响应时延的要求。算子适配、张量布局、内存分配和数值对齐,都需要逐项处理。对缺少推理系统专家的团队来说,这些工作往往拖慢了自研模型从 Demo 走向实际部署的进度。
缩短这段部署过程,模型的进步才能更快转化为机器人在真实任务中的能力。
为解决这些部署难题,无问芯穹主导,联合清华大学、上海交通大学推出了 APXInf。这是一款面向具身模型、为机器人量产部署打造的开源高性能具身端侧推理引擎,重点服务小批次、多视角、对响应时延要求严格的端侧推理场景,截止目前已经适配2款主流具身模型和3款芯片,并且在Jetson AGX Thor 上达到了目前行业 SOTA 的性能水平。
它在底层围绕具体模型和硬件优化执行路径,也把 Agent 参与模型适配和性能优化的流程纳入项目本身的设计。模型适配、性能优化与部署验证中的专家经验,被整理成 Coding Agent 可以执行的 Workflow 与 Skills。我们更愿意从这个角度理解它的定位:一个 Agentic native 的具身端侧推理引擎。
带着这个判断,我们在官方已适配的 RTX 4090 上测了一趟 π0.5 的实际表现;又意外发现 APXInf 在 DGX Spark 上也能跑,而官方当时尚未适配这款硬件,我们便按 APXInf 自带的开发工作流指南把 Qwen3-VL 迁到 Spark 上,完成了迁移开发和使用测试。
开源地址:https://github.com/RLinf/APXInf-robo
01
APXInf:面向具身部署的 Agentic native 推理引擎
模型部署到机器人上,首先要解决的就是响应速度问题。
机器人本体上的小批次(如Batch=1)推理,关注的是一次观测输入后,模型能否在规定时间内返回动作。多视角图像处理、模型前向计算与动作生成共享有限的计算和内存资源,除了吞吐量,还要关注响应时延及其波动。
APXInf 针对每个模型,将内存分配和算子执行安排在明确的静态路径中。计算流程通过 CUDA Graph 捕获后,可以利用预先分配的缓冲区重复执行;自动调优选出的 kernel 也会在机器内保留,减少每次推理的重复开销。
使用时,开发者可通过熟悉的 Python 接口调用模型。性能敏感的计算交给底层 APXInf 底层的高性能算子库,Rust 则帮助管理内存和资源,确保运行安全稳定。这样,用模型的人可以保留原来的使用习惯,也不影响性能的提升和运行的稳定性。
在模型结构和硬件变化的场景,往往静态路径也需要调整。APXInf 从框架设计之初,就顺应时代趋势将自身定位为一个 Agentic native 具身端侧引擎,所以把 Coding Agent 的开发适配纳入模型接入、前后处理、本体适配和部署验证完整开发流程,充分适应 agent 时代。
具体入口是 skills/model-port-workflow/ ,它关联模型移植、模型层架构、执行路径集成和新增算子的工程文档。其中三个环节尤其值得展开。
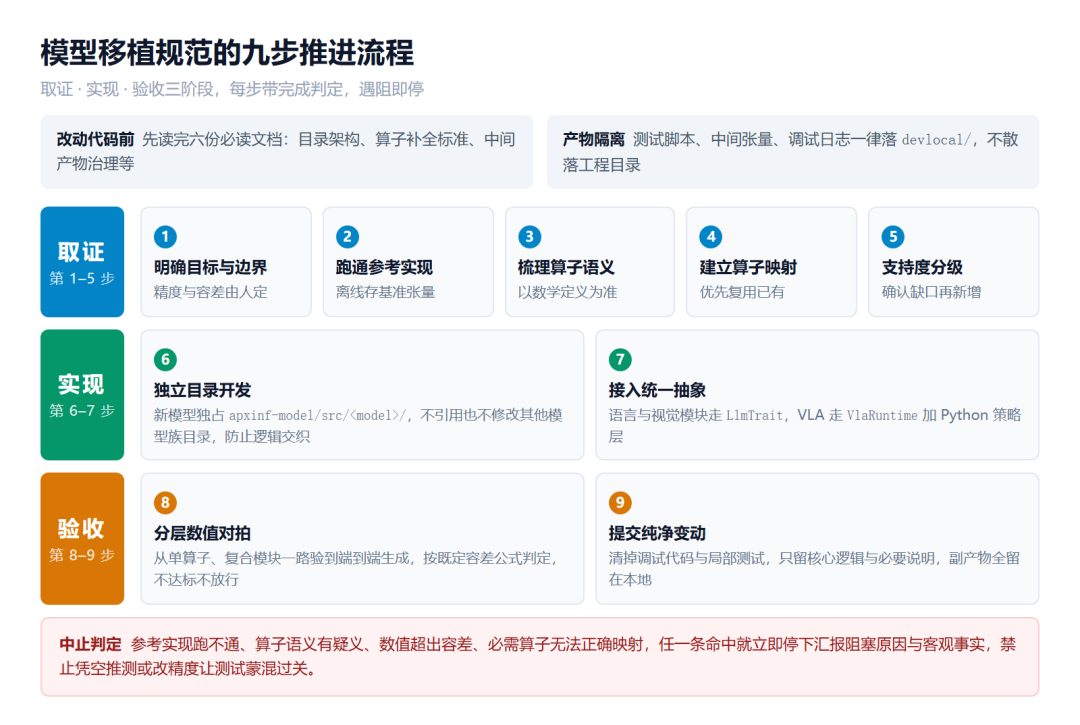
1. 先跑通原模型,建立对照
移植前,先确定模型与参考代码的版本,并固定所用权重。在此基础上,约定目标设备、推理精度及测试输入,明确允许的误差范围。随后在隔离环境运行参考实现,保存输入输出和必要的中间张量,供后续对照。
中间张量有助于定位偏差最早出现的位置,避免仅凭最终输出通顺就认定实现正确。
换一种实现方式,计算结果也要对得上。因此,改写前后要使用相同的输入、权重和随机条件,再按事先约定的误差范围逐项比较。编译通过、输出看着正常,还不能算完成。
2. 先找现有算子,再补缺失能力
一个算子存在于仓库里,并不意味着模型实际调用了它。启用高性能路径,还需要目标架构的编译支持、匹配的数据类型与内存布局,以及正确的调用条件。
流程要求先检查已有实现,优先复用;遇到数据布局不匹配的问题,就在接入时做适配。缺少高性能实现时,可以先用正确但较慢的版本验证,确认能力确实缺失后再补开发。
代码的修改范围也划得很清楚。模型层负责模型结构、权重映射和执行顺序,通过统一的安全接口调用底层算子,不直接操作 CUDA 或跨语言接口。Agent 修改模型时有明确边界,工程师也更容易判断哪些地方需要重新测试。
3. 验证结果,检查性能
验证从改动过的算子开始,逐步扩大到完整模型,并通过实际使用的 API 检查调用结果。约定的设备和精度组合都要覆盖,启用 CUDA Graph 后也需要重新核对输出。性能测试则记录时延和内存占用,结合数据搬运开销查找瓶颈。
结果必须先正确。速度要达到什么水平,也应在开始前说清楚。如果功能跑通了,性能还没达到目标,就如实记录瓶颈和下一步优化,不能把“能跑”当成“已经做好”。
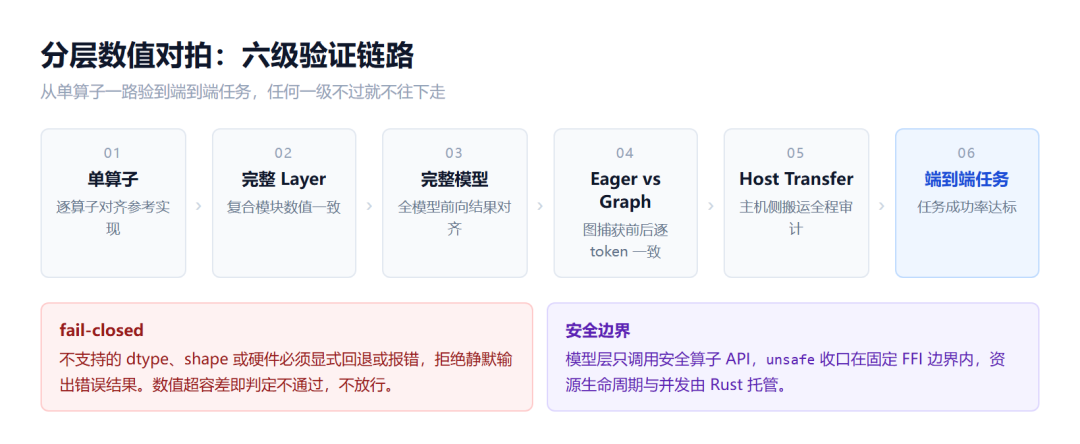
临时脚本、张量与日志放入被 Git 忽略的 devlocal/ ,提交中保留需要持续维护的代码、测试和文档,便于审阅与后续回归。
02
一手实测,让 Agent 参与模型适配与性能优化
对具身开发者来说,一个推理引擎好不好用,既要看已支持模型的运行表现,也要看接入其他模型和硬件是否方便。我们先看官方公布的 π0.5 测试结果,再结合 Qwen3-VL 的适配实践,看看 APXInf 在这两方面的表现。
已适配模型:π0.5 的官方测试表现
以机器人领域主流的 π0.5 为例,APXInf 仓库内直接提供了 Python Policy 封装(build_robot_policy ),并自带兼容 OpenPI 的服务接口。开发者不需要手动处理底层的显存预分配或 CUDA Graph 捕获,传入多视角相机原始画面即可获取控制动作。
根据官方在 APXInf-robo 仓库公布的基准测试,π0.5 在 RTX 4090 上的单步推理延迟为 31.38 ms(BF16,对应 31.9 Hz)与 25.99 ms(INT8,对应 38.5 Hz);在车载边缘平台 Jetson AGX Thor 上,FP8 延迟为 41.16 ms(对应 24.3 Hz)。
同时在官方公布的 LIBERO-10 评测中,Thor 上的任务成功率为 92.2%(FP8)和 92.8%(BF16),与参考实现的 92.4% 基本持平,提速过程中保持了原有的任务完成表现。
我们在 RTX 4090 上也复测了一轮 π0.5,结果与官方公布的差不多。
扩展适配:让 Agent 参与 Qwen3-VL 的接入与优化
已有模型之外,换一个模型或设备,适配过程会怎样?我们从 RTX 4090 上的 Qwen3-VL 适配排查开始,随后将工作扩展到搭载 GB10 的 DGX Spark,以 APXInf 的移植流程为指导,让 Coding Agent 参与排查与优化。工作基于 APXInf 仓库的 commit 7126992 展开,后续验证对齐至 26a4c9c ,主要经历了四轮改动。
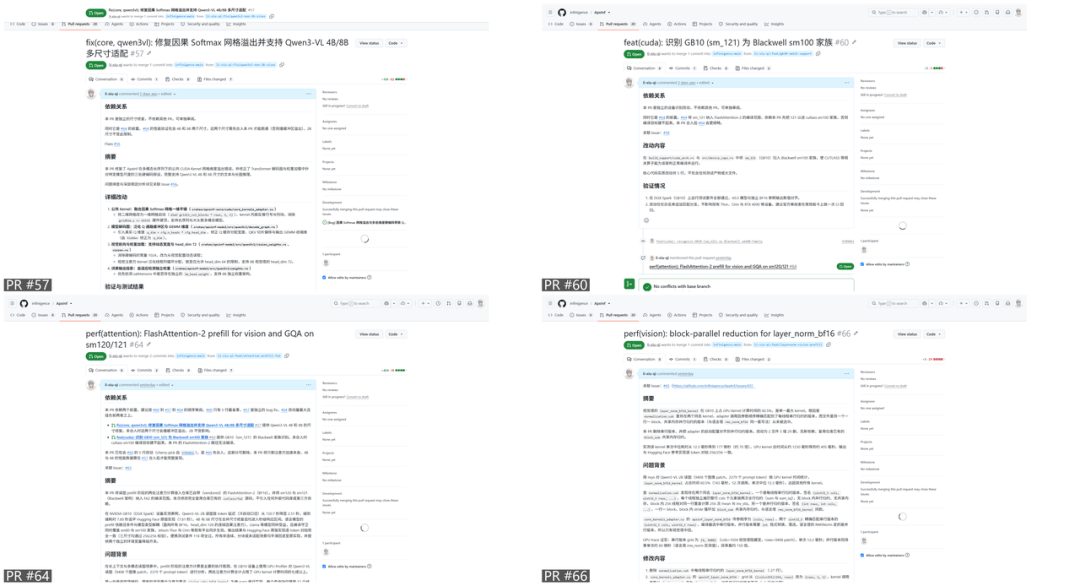
先解决模型尺寸问题。原有实现中的维度硬编码和因果 Softmax 网格限制,导致 4B、8B 模型运行异常。通过对照参考实现,按实际配置推导维度并修复网格限制后,多尺寸路径得以跑通,对应 PR #57。
再补齐新硬件支持。当时的架构匹配规则尚未覆盖 GB10。补齐识别后,仓库已有的 CUTLASS 等实现可以为该设备编译和运行,对应 PR #60。
接着优化读图速度。排查发现,视觉编码和语言预填充阶段尚未用上已有的 FlashAttention-2。接入后,在 GB10、Qwen3-VL-2B、BF16 和指定高清图输入下,首 token 延迟从 150.7 秒降至 2.51 秒。这是该适配路径优化前后的单次测试结果,详见 PR #64。
最后处理视觉模块的 LayerNorm 瓶颈。将调用从串行归约改为已有的块并行实现后,GPU kernel 总耗时降低约六成,端到端首 token 延迟进一步下降约 10%。两者降幅不同,是因为主机侧数据搬运仍占用较多时间,详见 PR #66。
四轮改动均已整理为 PR 提交至官方仓库,具体配置和验证结果见对应记录。
跑完这一趟,最直接的体会是:工程师负责把控方向、定测试边界和最后 code review;Agent 则在规范约束下去翻算子、提张量、做分层对齐。很多时候我们不用从头造轮子,仓库里本来就有现成的好算子,工作流规范让 Agent 顺着清晰的路径把这些能力找出来并接通。这种分工,比单靠工程师一个人死磕底层细节要轻松得多。
完成适配后,我们进一步在 DGX Spark 上对比了 APXInf 与主流框架的性能。
03
在桌面 AI 超算 DGX Spark,与主流框架同台实测
这里呈现的是 APXInf 在原先尚未正式支持的硬件上,经我们完成模型适配与优化后的表现。
测试模型为 Qwen3-VL-2B-Instruct,各框架使用官方 BF16 权重,输入同一张 1344×1792 图像,包含 9408 个 patch,图文输入合计 2379 个 token,以贪心解码生成 256 个 token。下表分别列出首 token 延迟(TTFT)、解码阶段平均每 token 耗时(TPOT)和解码速率。
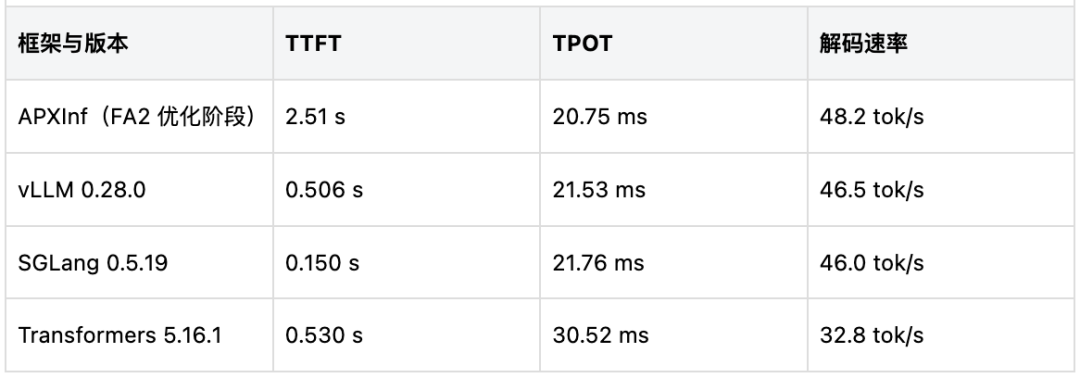
这轮测试中,APXInf 的解码速率要超过 vLLM 与 SGLang,而且明显高于 Transformers;首 token 延迟则仍明显更长。结合前面的性能分析,主机侧数据搬运是后续需要继续排查和优化的重点。
需要注意的是,我们这里测出来的 TPS,是 VLM 文本生成,48.2 tok/s 不能直接换算为机器人控制频率。完整控制链路还包括感知输入、动作生成、传输与执行。总的来说,这次的测试还是有些意外的,APXInf的解码速度居然比vLLM要更快一些,可以看出 APXInf 的性能确实是比较不错的。
04
写在最后:让模型的进步,早点用到机器人上
跑完这一轮,我们觉得 APXInf 值得关注的地方,除了推理速度,还有它让 Agent 参与底层开发的方式。
模型还会更新,适配也不会只做一次。如果每次都要等少数专家从头排查,新模型上机就快不起来。APXInf 把经验留在流程里,让 Agent 能接着推进,团队也少一些重复摸索。
虽然人还得把关,但有 Agent 一起排查和修改,人就能腾出些精力,继续改进模型本身。
这也解释了它为什么在 RLinf 生态中首发:RLinf 支持模型训练与评测,APXInf 负责端侧推理与部署,两者衔接起来,模型从训练到上机的路就更完整了。
期待这次实测中用到的适配与优化流程,今后能帮更多具身团队把自己的模型跑起来,让模型的进步,早点用到机器人上。
目前相关项目已正式开源。如果你也在为机器人本体的端侧推理部署寻找高性能方案,可以前往ApxInf官方仓库体验:https://github.com/RLinf/APXInf-robo
本项目有官方交流群,可以直接扫码进群:
开源贡献,点赞在看↓