端侧实时感知新标杆!通用线性骨干网络GTR开源:覆盖检测、分割与深度估计,4090仅需1.9ms
原创 CV君 2026-10-04 23:26 山东
线性视觉骨干全面进化
在计算机视觉的高分辨率密集感知场景中,二次计算复杂度一直是 Softmax 全局注意力的绕不开的瓶颈——随图像 Token 激增的计算与显存开销如同沉重镣铐,让边缘端部署的“极致精度”与“实时吞吐”常如鱼与熊掌不可兼得。
为了打破这一计算困局,来自滴滴国际化业务群、Intellindust AI Lab、中国科学院自动化研究所、香港科技大学(广州)与滴滴研究院的研究团队联合推出了全新的无 Softmax 循环视觉骨干网络——GTR(Gated Token Recurrence,门控 Token 递归网络)。通过纯单尺度 Key-only 门控线性注意力、四向交替空间扫描以及内嵌深度卷积的 Spatial SwiGLU 结构,GTR 彻底甩掉显式位置编码,实现了关于 Token 规模严格的线性复杂度(),并借助极简的“单阶段最终层特征对齐”直接继承大模型的表征能力。
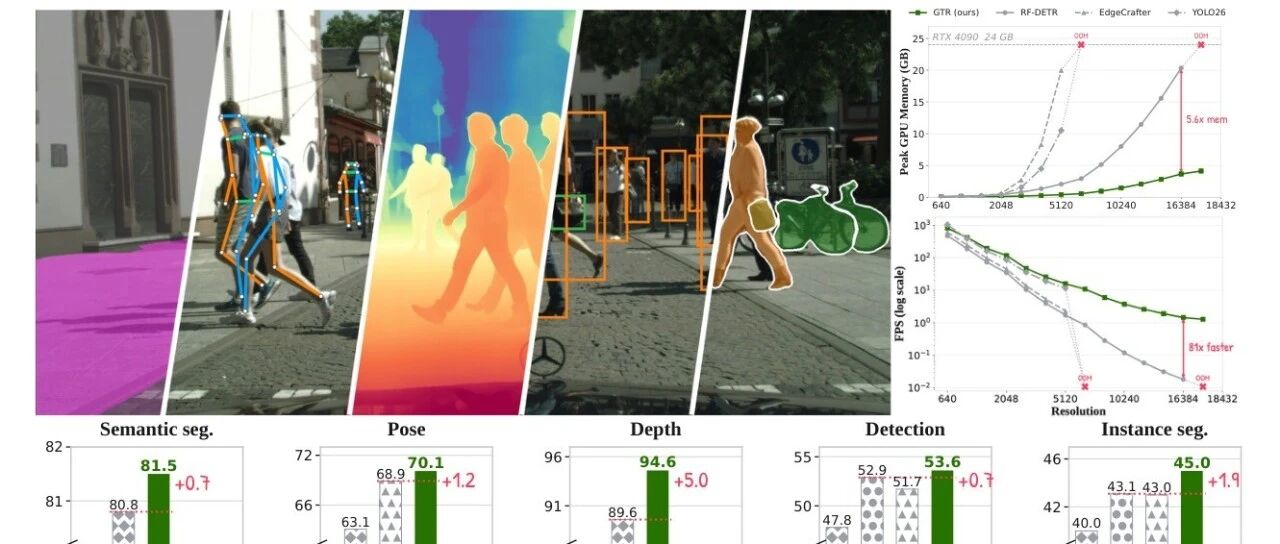
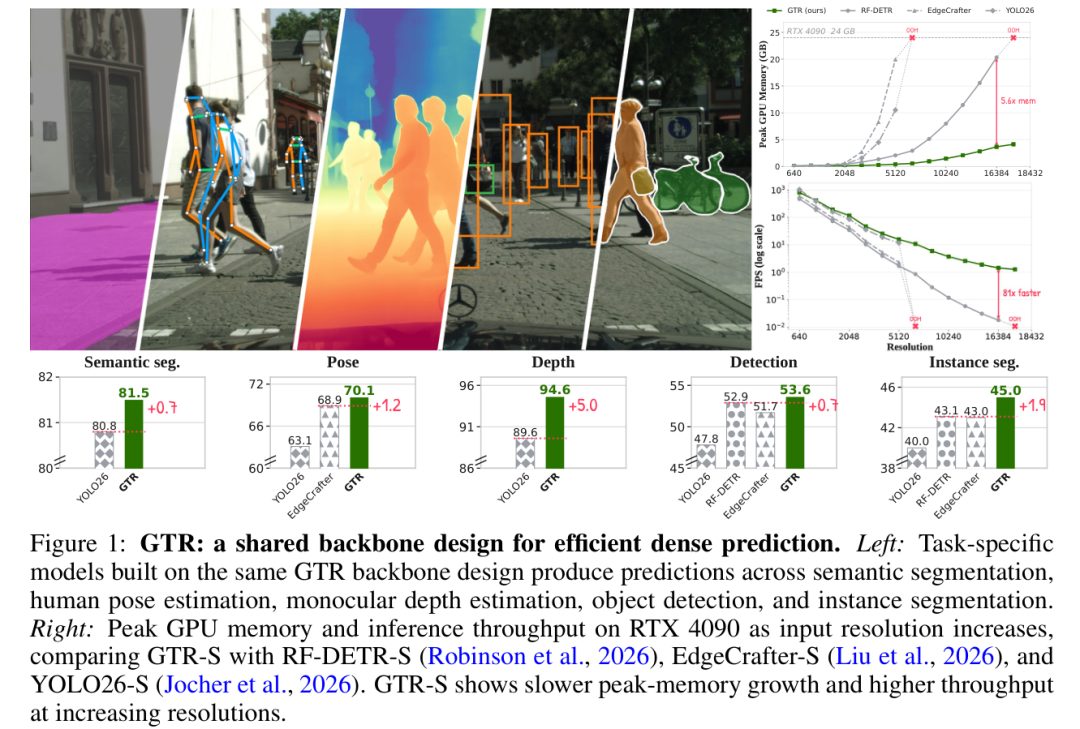
实测数据刷新了实时密集预测的新纪录:在 COCO 目标检测基准上,GTR-L 取得了 58.9 AP,在 RTX 4090 上的单图推理延迟低至 1.908 ms;旗舰款 GTR-X 更斩获 59.4 AP(2.115 ms),相比同量级标杆 RF-DETR-X(58.6 AP, 3.243 ms)参数量锐减超 63%、推理延迟降低 34.8%。此外,该网络零损泛化至分割、姿态估计与深度估计等六大密集任务,并在车规级芯片 NVIDIA DRIVE AGX Thor 上实现 2.28 ms 起步的端到端超低延迟。
目前,该项目已全面开源。
背景与动机:线性注意力为何难在密集预测中挑大梁?
线性注意力(Linear Attention)通过核函数分解与矩阵乘法结合律,将时间与空间复杂度降至 ,并可转化为单向循环(Recurrence)更新的形式。此前,包括 RetNet、RWKV、Mamba 及 GLA 在内的线性循环序列模型在自然语言处理中展现了优异潜力,亦有部分工作(如 EfficientViT、ViG)尝试将其引入视觉领域。
然而,构建一个能跨多项密集预测任务保持高精度的通用线性视觉骨干网络,仍面临三大核心挑战:
空间维度的因果衰减矛盾:递归序列模型天然具备因果单向性(Causal),而图像本质是二维且无向的,单向扫描容易丢失反向及正交维度的上下文信息;
局部细节与位置编码缺失:常规视觉 Transformer 极度依赖显式位置编码,而循环机制在不同分辨率缩放时对位置嵌入的泛化较差,亟需更自然的空间几何建模手段;
异构架构蒸馏的复杂性:从经典的 Softmax 架构迁移表征至线性注意力架构时,过往方法(如 ViT-Linearizer、ViT-AdaLA)通常依赖繁复的多阶段对齐、中间层激活匹配或掩码预测损失,工程实现与超参调优成本极高。
GTR 的设计初衷,正是探索线性注意力能否在兼顾纯粹结构与极简训练的前提下,全面替代 Softmax 注意力以释放高分辨率密集预测的落地潜力。
方法详解:GTR 的三大技术支柱
1. 骨干架构:Key-only 门控递归与四向交替扫描
GTR 采用纯单尺度(Single-scale)的 12 层 Block 拓扑。输入图像 经由 Stride 为 16 的 Patch Embedding 划分为 个图像 Token。
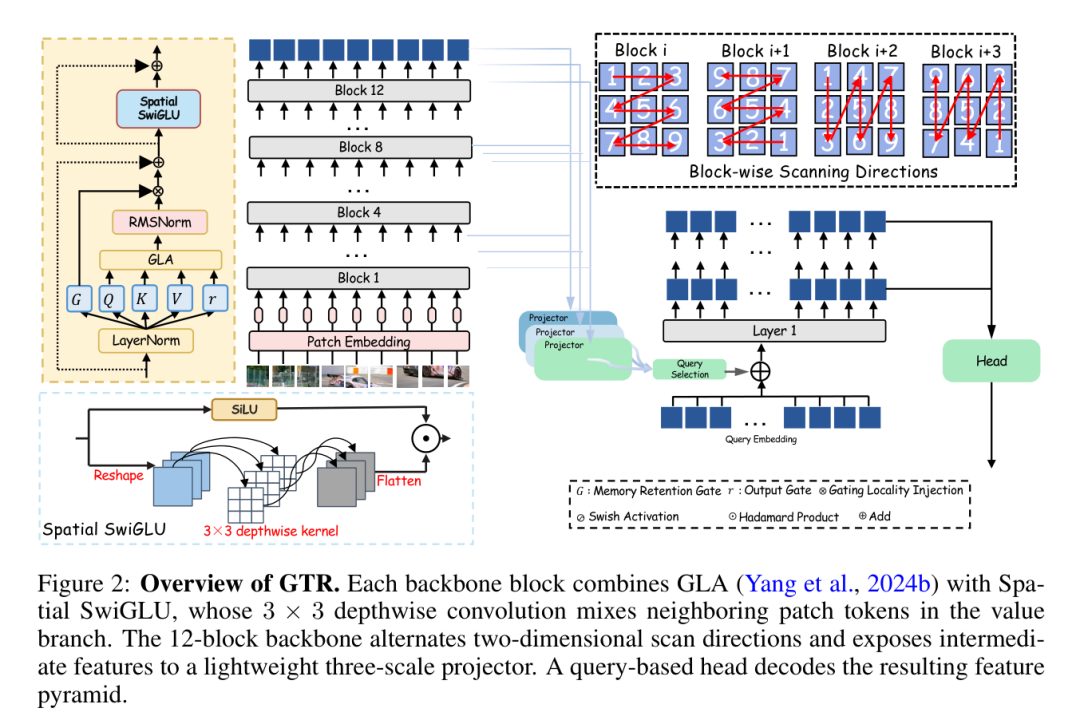
每个 Block 的核心为门控线性注意力(GLA)。不同于标准双侧衰减,GTR 采用了精简的 Key-only 递归机制:将值侧(Value-side)的状态衰减因子固定为 1(),仅保留键侧(Key-side)的自适应遗忘门控 。对于单个注意力头,其隐状态矩阵 的更新与输出计算如下:
其中,门控信号 由输入通过轻量级低秩投影(秩 ,温度 )动态生成:
输出端在经由 RMSNorm 归一化后,再乘以一个基于 SiLU 激活的数据相关输出门控 :。
为了在单向递归中捕获完备的 2D 全局上下文,GTR 摒弃了单层内多次双向扫描的高计算代价设计,转而在网络深度维度轮换扫描方向:从 Block 1 到 Block 12,依序循环采用从左到右(LR)、从右到左(RL)、从上到下(TB)、从下到上(BT)四种路径。每个 Block 仅执行单一方向的扫描,并在计算完毕后立刻还原二维网格排序。随着网络逐层加深,各位置的 Token 能够自适应汇合来自不同空间方位的全局上下文。
2. Spatial SwiGLU:摒弃显式位置编码
为了弥补序列化扫描对局部相邻区域交互能力的不足,GTR 提出了 Spatial SwiGLU(S-SwiGLU) 替代传统 FFN。在通道展开过程中,将 Value 分支显式重塑为二维空间网格,并通过一个 深度可分离卷积(Depthwise Conv)进行局部混合:
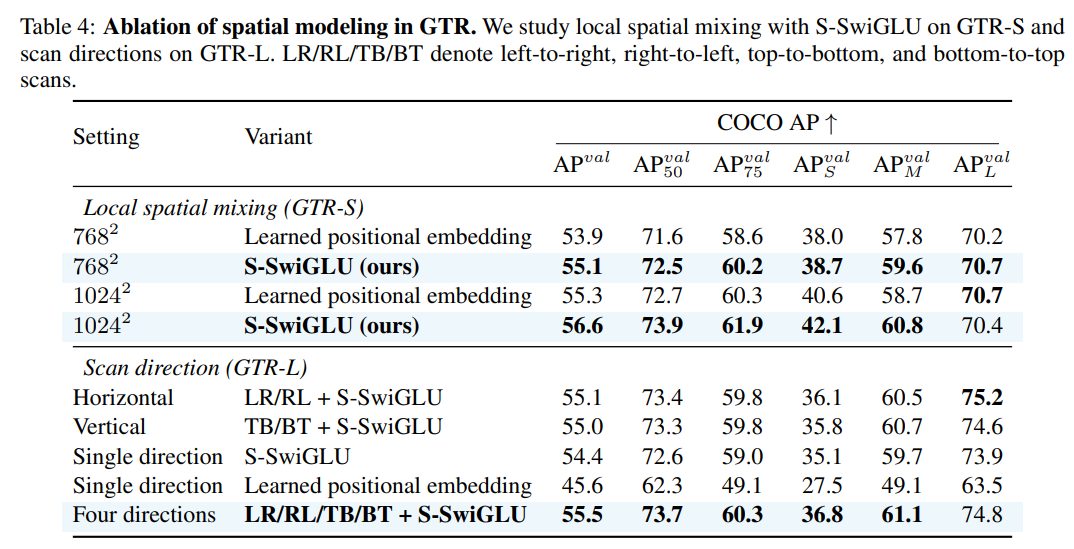
值得注意的是,GTR 全文完全没有使用任何显式的位置编码(Positional Embeddings)。四向交替扫描提供的全局方位线索,与 S-SwiGLU 提供的平移不变局部几何特征形成了优势互补,在大幅削减显存的同时,赋予了模型在动态高分辨率输入下的无缝外推能力。
3. 极简单的单阶段最终层对齐蒸馏
在表征学习阶段,GTR 采用冻结的检测特化 DINOv3 教师模型进行跨架构知识蒸馏。师生网络接收完全相同的全分辨率图像输入,输出对应的 Patch Token 表征。
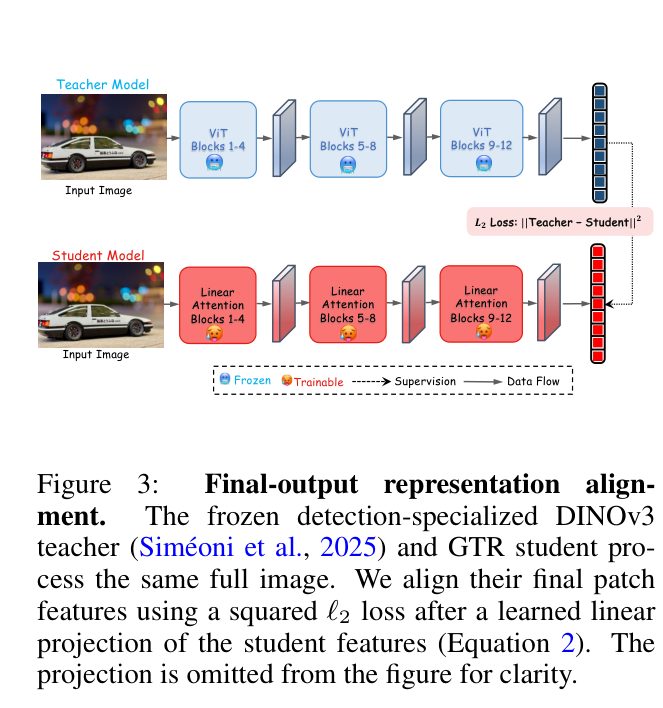
与以往复杂的跨架构对齐方案不同,GTR 仅在骨干网络最终层(Block 12)引入一个可学习的线性映射层 ,并通过均方 距离直接约束学生与教师的表征一致性:
整个蒸馏流水线不包含任何 Mask Token 预测任务,也不包含对注意力图或中间层隐状态的对齐。这一极简策略不仅降低了显存与计算负担,且消融实验证明其下游检测精度显著超越了更繁复的多阶段基线。
4. 硬件感知分块推理算子
在工程落地层面,研究团队针对推理场景定制了硬件感知的 Chunkwise CUDA 算子。将长序列划分为固定大小的块(Chunk Size ),分三阶段高效流水执行:
块概要并行计算:利用 Tensor Core 并行计算各块局部的矩阵贡献 ;
边界状态轻量级扫描:块间边界状态 的传递计算量微小,通过连续内存合并访问完成轻量顺序前传;
块输出独立生成与融合:利用 Shared Memory 暂存得分矩阵,消除向全局内存写回临时注意评分的通信开销,并将输出门控直接在 Epilogue 阶段融合。
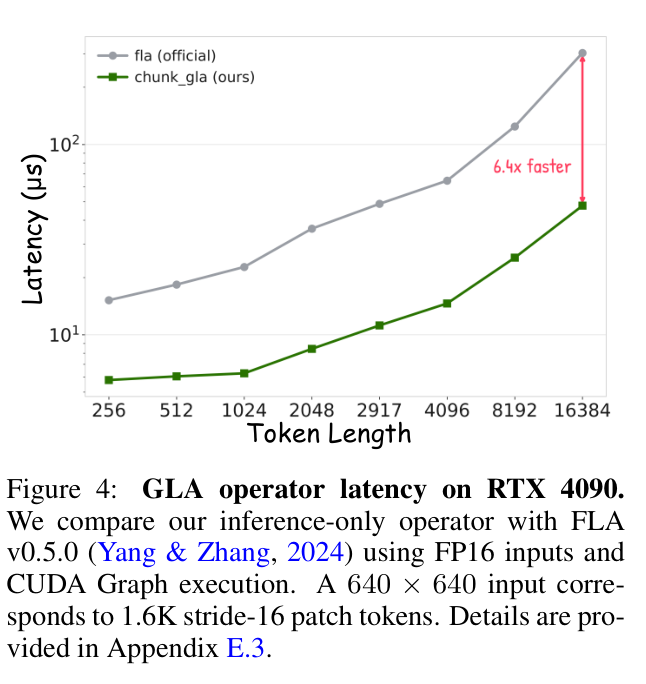
基准测试显示,在 RTX 4090(FP16 + CUDA Graph)环境下,该自研算子相较社区主流的 FLA v0.5.0,在 1.6K Token(对应 分辨率)下实现了 4.0倍速度提升,在 16.4K Token 下更达到 6.4倍 的加速比。
实验结果与多任务泛化
GTR 规划了 S、M、L、X 四种不同容量规模的模型配置,在目标检测网络中,将骨干网络第 4、8、12 层的特征送入由轻量 C2f 模块构建的三尺度特征金字塔,并接入 DETR 风格的集合预测解码器。
1. 实时目标检测:刷新精度与延迟权衡
在 COCO val2017 目标检测基准下,使用经 Objects365 预训练并微调 30 个 Epoch 的方案,GTR 取得了超越主流实时检测器的性能表现:
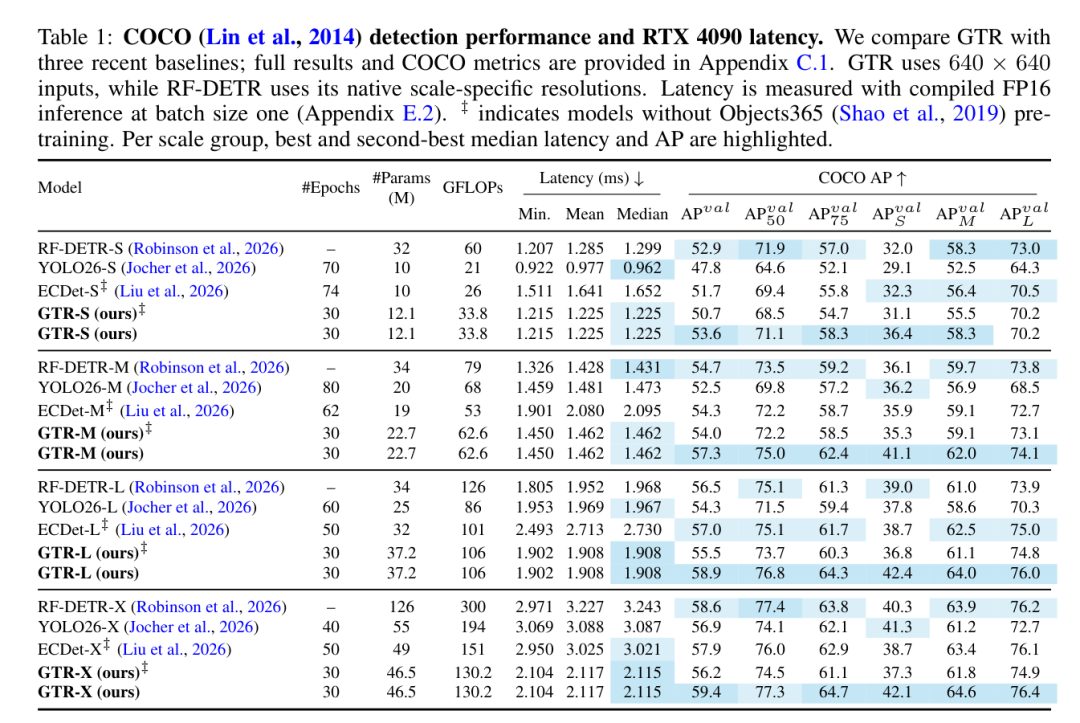
GTR-L:取得 58.9 AP,中位数延迟仅为 1.908 ms,相较同量级的 RF-DETR-L(56.5 AP, 1.968 ms)和 ECDet-L(57.0 AP, 2.730 ms),在速度与精度两端均确立了显著优势;
GTR-X:达到 59.4 AP 的顶尖性能,延迟压低至 2.115 ms。相比参数量高达 126M 的 RF-DETR-X(58.6 AP, 3.243 ms),GTR-X 节省了超 63% 的参数量,推理延迟降低 34.8%;
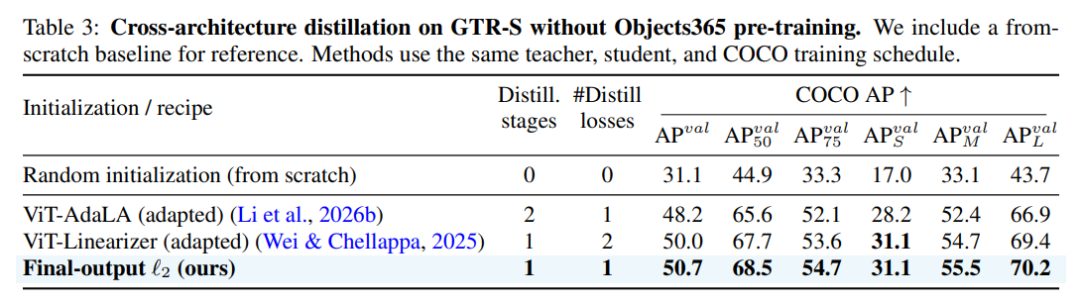
GTR-S:在 12.1M 参数下达到 53.6 AP(延迟 1.225 ms),小目标检测精度 达到 36.4(YOLO26-S 为 29.1),整体性能亦大幅领先 YOLO26-S(47.8 AP)。即便在不进行 Objects365 预训练的纯从头蒸馏设定下,GTR-S 仍斩获 50.7 AP。
2. 跨五大密集预测任务的零损迁移
得益于通用的特征表达,相同的 GTR 骨干架构被成功迁移至另外五类极具代表性的密集感知任务中:
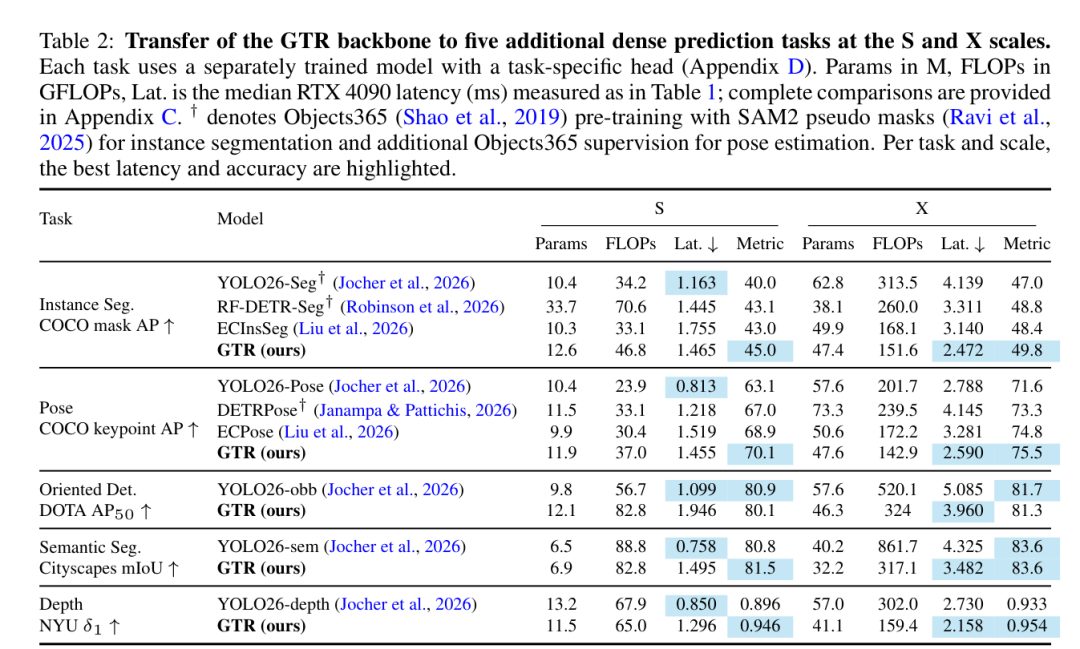
实例分割:GTR-X 达到 49.8 Mask AP(2.472 ms),优于 RF-DETR-Seg-X(48.8 Mask AP, 3.311 ms),且完全脱离了 SAM2 生成的大规模伪标签依赖;
人体姿态估计:在 COCO Keypoint 基准上,GTR-S 与 GTR-X 分别取得 70.1 和 75.5 的 AP 评分,精度不仅全面超越 YOLO26-Pose,在 X 尺度下延迟更较 DETRPose-X(4.145 ms)降低超 37%;
旋转目标检测(OBB):面向遥感航拍数据集 DOTA-v1.0,GTR-X 取得 81.3 ,中位数推理耗时为 3.960 ms(优于 YOLO26x-obb 的 5.085 ms);
语义分割:在自动驾驶基准 Cityscapes 上,仅挂载轻量级 FCN 解码头的 GTR-S 斩获 81.5 mIoU;GTR-X 以 32.2M 参数匹配了 YOLO26x-sem 的 83.6 mIoU,同时节省了 63.2% 的 GFLOPs 并削减了 19.5% 的延迟;
单目深度估计:在 NYU Depth V2 测试集上,采用八大数据集混合训练后零样本迁移评估,GTR-X 达到 ,相对误差 AbsRel 仅为 0.067,表现优于对应尺寸的 YOLO26-depth 系列。
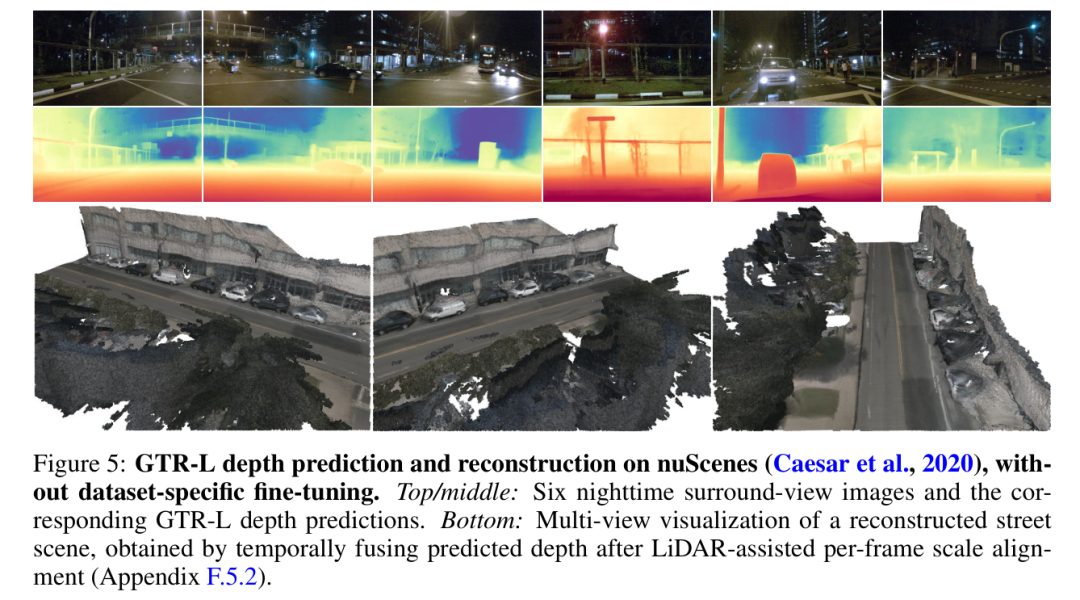
在 nuScenes 自动驾驶环视夜间场景下,基于 GTR-L 预测的深度图经由激光雷达尺度修正后,展现出极具连贯性的多视角 3D 点云与局部场景重建效果。
核心消融实验与洞见
论文针对几大核心设计展开了深入消融,提供了诸多富有价值的技术启示:
单阶段端到端蒸馏的优越性:在相同的 30 Epochs COCO 训练周期下,极简的 Final-output 策略达到 50.7 AP,显著胜过引入逐层注意力匹配的 ViT-AdaLA(48.2 AP)与带掩码预测的 ViT-Linearizer(50.0 AP)。这说明给无 Softmax 学生网络留出内部表征演化的自由度,比强行对齐中间特征更为关键。
S-SwiGLU 是无位置编码的前提:当采用单向扫描且缺少 S-SwiGLU 时,仅凭学习式绝对位置编码模型精度断崖式下跌至 45.6 AP;而引入 S-SwiGLU 辅以四向扫描,AP 一举跃升至 55.5。这证实深度卷积提供的局部归纳偏置能有效弥补一维扫描的时序盲区。
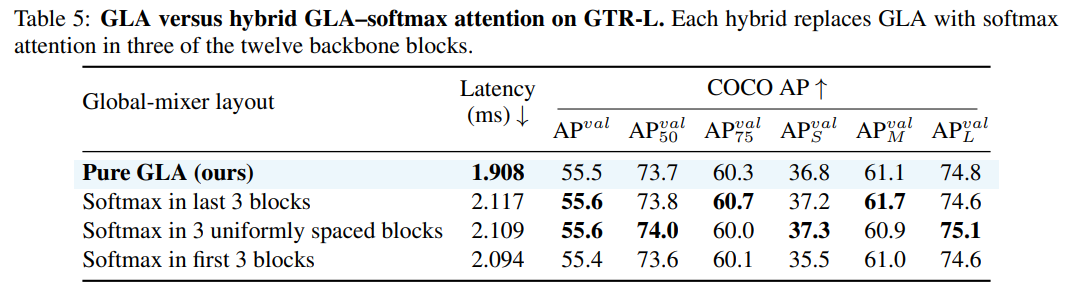
掺杂 Softmax 并无实质增益:在 GTR-L 的 12 个 Block 中将 3 个 Block 替换为标准的 Softmax 自注意力,其 AP 仅在 55.4 至 55.6 之间微弱浮动,但整体延迟却由 1.908 ms 恶化至 2.117 ms。保持架构的纯粹线性化是兼顾吞吐的最优解。
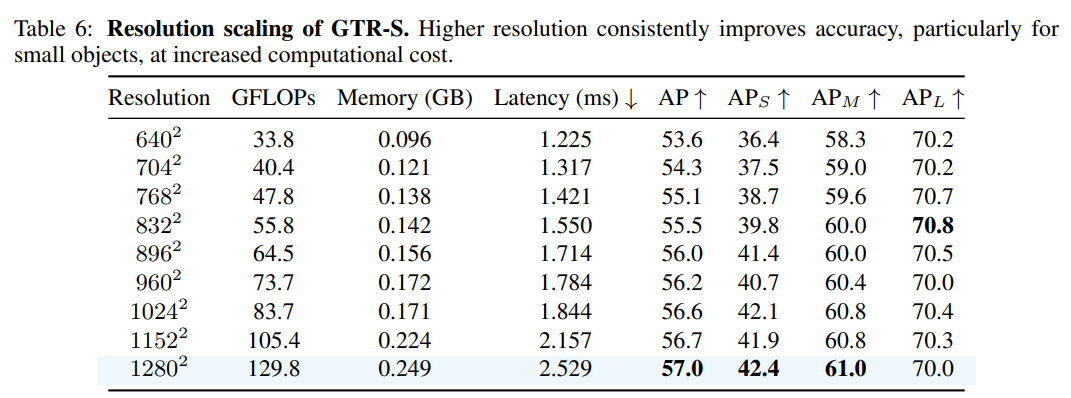
高分辨率输入的超线性扩展优势:将 GTR-S 的分辨率由 递增至 时,Token 序列长度膨胀为原先的 4 倍,但端到端延迟仅从 1.225 ms 增至 2.529 ms(仅增加 2.06 倍),小目标检测精度 更是由 36.4 跃升至 42.4。
车规级端侧落地:DRIVE AGX Thor 实测
工业应用往往高度依赖定制化部署环境。研究团队将 GTR 针对 NVIDIA DRIVE AGX Thor 车载计算平台(搭载 Blackwell 架构 GPU,支持 sm_110)进行了深度工程整合。
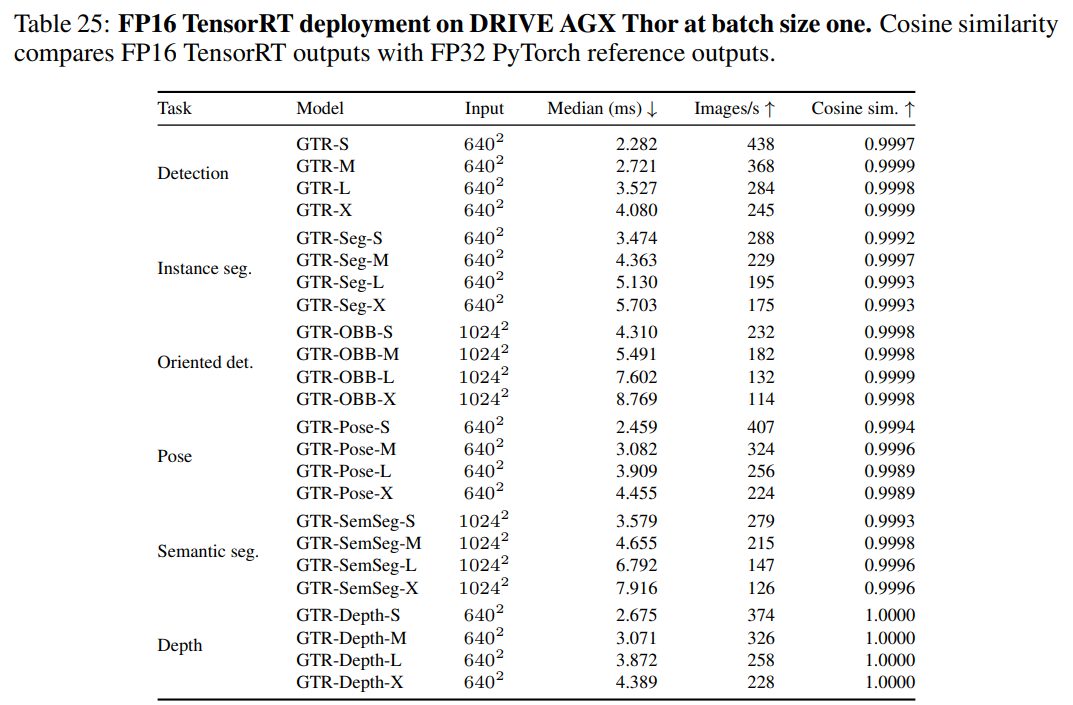
通过深入的 Roofline 模型分析,研究团队发现边缘端高分辨率推理主要受制于内存读写带宽。借由 TensorRT 图融合与定制融合 Kernel,消除了中间激活层大量的显存搬运。在 Batch Size 为 1 的测试中,全部六大任务的推理耗时均被压缩在 2.282 ms 至 8.769 ms 之间;
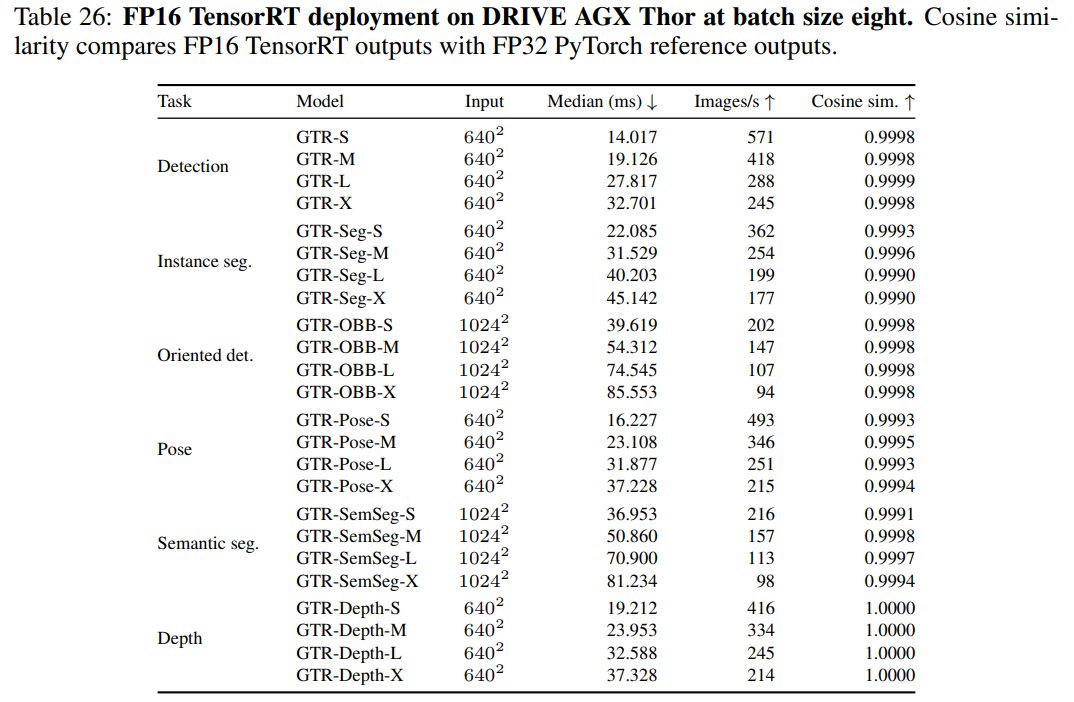
在 Batch Size 为 8 时,GTR-S 目标检测吞吐量达到 571 FPS,且各任务在 FP16 精度下的输出与 PyTorch FP32 参考值余弦相似度均维持在 0.9989 以上,展现了工业级部署的数值可靠性。
写在最后
GTR 的提出表明:在密集预测任务中,二次复杂度的 Softmax 全局注意力并非不可替代。通过精炼的 Key-only 门控线性循环、深层交替扫描以及局部卷积注入,线性模型完全有能力在多项高难度密集感知基准中取得 SOTA 级表现。配合定制的 Chunkwise 算子与边缘图优化,GTR 进一步填平了理论高效算法向车载与嵌入式端侧落地之间的技术鸿沟,为下一代端侧感知大一统骨干网络的设计提供了极具竞争力的工程范本。
论文标题: GTR: Gated Token Recurrence for Efficient Dense Prediction
机构: 滴滴国际化业务群、Intellindust AI Lab、中国科学院自动化研究所、香港科技大学(广州)、滴滴研究院
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。