上海交大&帝国理工等提出TurboClear:单步消除物体与伴生阴影,算力骤降40倍
原创 CV君 2026-10-02 23:16 江苏
单步扩散消除新标杆
在真实图像编辑中,擦除一个物体从来不仅是涂抹掉物体轮廓本身。物体投射在地面的阴影、水面的倒影或半透明玻璃的折射痕迹,往往会蔓延至常规涂抹掩码之外。如果模型只按掩码消除,往往会在边缘留下显眼的倒影残渣;而如果完全放开生成自由度,扩散模型的重绘过程又极易污染原本干净的背景纹理。
更棘手的是算力开销。现有的物体消除模型大多依赖多步去噪采样(如基于 SDXL 的 ObjectClear 或基于 Flux 的 OmniPaint),单张图像往往需要数十步迭代,耗时从数秒到几十秒不等,难以满足边缘设备或在线高并发服务的实时响应需求。
针对这一痛点,来自上海交通大学、荣耀终端有限公司和帝国理工学院的研究团队推出了 TurboClear。该模型命名由寓意超快单步推理的“Turbo”与彻底抹除残余痕迹、还原纯净画面的“Clear”组合而成,是针对“物体伴生效应消除”(Object-Effect Removal)任务设计的基于 SDXL 的单步扩散模型。该方法在保留高保真画质的同时,将去噪算力最高压缩了 665 倍,单图推理仅需 0.04 秒。
背景与动机:空间非对称性与单步蒸馏的冲突
物体伴生效应消除任务存在天然的空间非对称性(Spatial Asymmetry):
编辑区域(物体本体及其衍生出的阴影、倒影区):需要进行彻底的语义改写与纹理重建;
非编辑区域(与物体无关的原始背景):需要执行严格的“恒等映射”(Identity-mapping),像素纹理与高频细节须绝对保持原样。
以往研究通常借助复杂的交叉注意力机制或多步去噪逐步校准编辑边界。为了压缩计算量,学术界尝试通过一致性模型(Consistency Model)或分布匹配蒸馏(Distribution Matching Distillation, 如 DMD2)将多步扩散模型压缩为单步。
然而,通用的单步蒸馏策略在目标消除任务中表现欠佳。这是因为通用的分布匹配损失是在整图全域施加生成梯度,缺乏空间局部校准。直接应用到局部编辑任务中,会导致两难困境:要么在应保护的背景区域引入随机生成的噪声斑块,要么在需要消除的阴影区域因对抗约束不足而留下伪影。
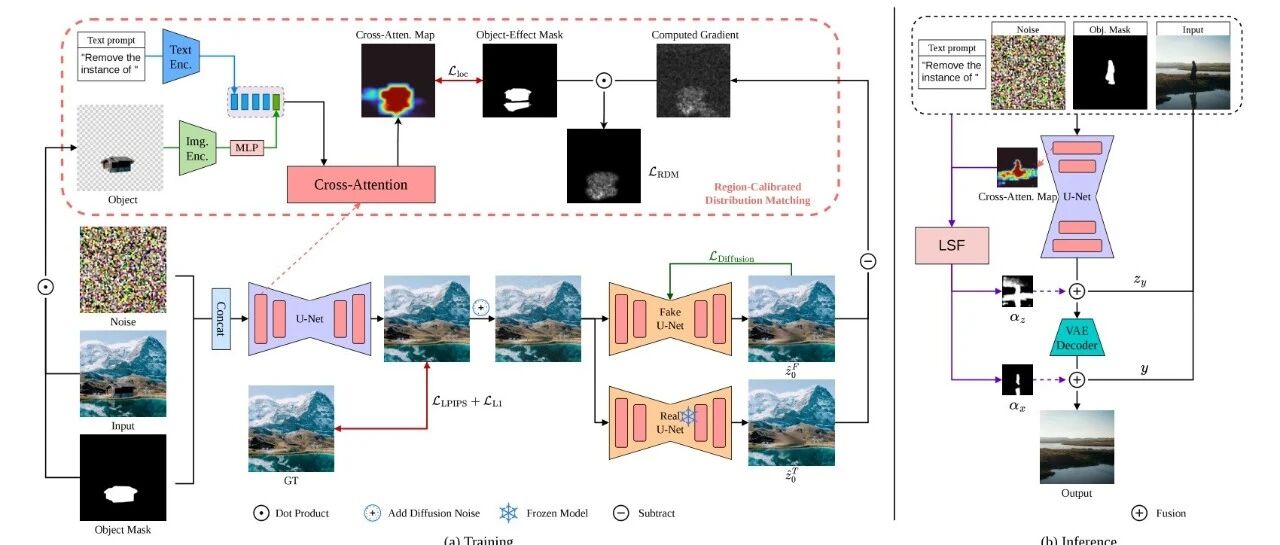
为此,TurboClear 从两阶段切入:在训练阶段通过区域校准分布匹配(Region-Calibrated Distribution Matching, RDM)约束单步学生网络的生成梯度流向;在推理阶段通过可学习空间融合(Learnable Spatial Fusion, LSF)构建双流架构,实现对生成内容与原始背景的自适应解耦融合。
方法详解:RDM 蒸馏与 LSF 双流融合
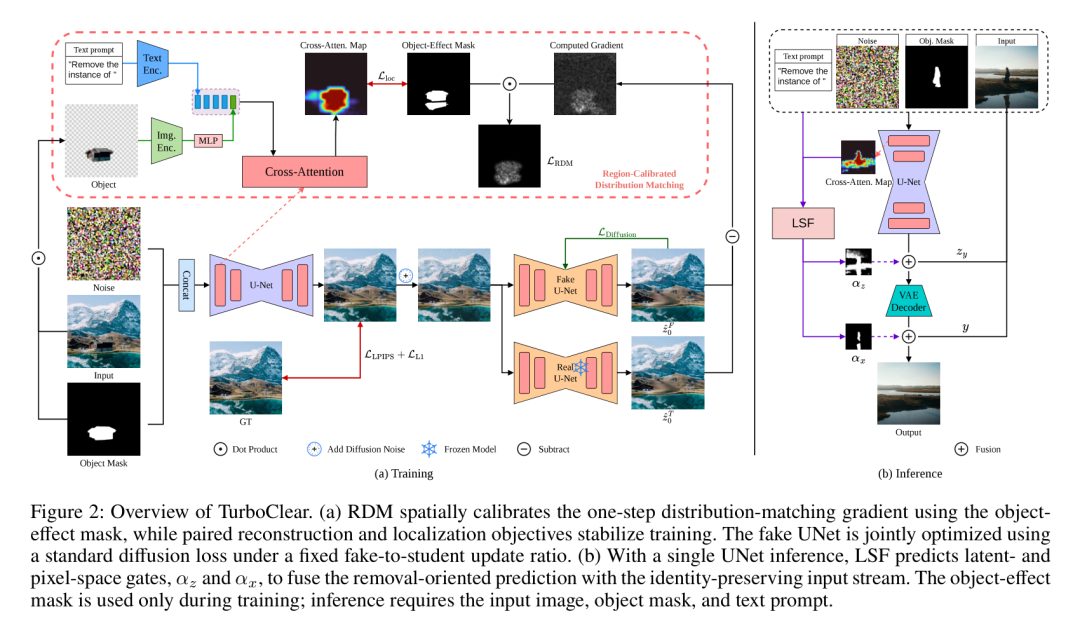
TurboClear 的整体架构如图 2 所示。整个方案将特权监督(训练期)与实际部署(推理期)清晰解耦。
1. 区域校准分布匹配(RDM)
在常规的 DMD2 蒸馏中,学生模型生成的潜空间估计 会重新加噪至时间步 得到 。随后由冻结的多步教师网络 和一个与学生网络同步更新的评估网络(Fake UNet) 分别预测去噪潜变量 与 。其全局分布匹配方向表示为:
该梯度旨在引导学生样本逼近教师分布,但若直接作用于全图,非编辑区就会被对抗性扰动篡改。
RDM 的核心是在训练阶段引入特权伴生效应掩码(覆盖物体主体及其实际产生的阴影/倒影)。首先将 下采样并平滑为潜空间软掩码 。随后计算效应区域的平均误差范数作为自适应缩放因子:
从而得到经空间掩码与幅度归一化后的 RDM 梯度:
通过截断梯度(Stop-gradient)构建局部更新目标 ,学生模型的 RDM 优化损失定义为:
配合前景与背景的加权 L1 重建损失、LPIPS 感知损失以及交叉注意力定位损失 ,RDM 成功将生成能力限定在效应区内,同时将无关背景锚定在真实图像上。
2. 可学习空间融合(LSF)
尽管 RDM 训练出了具备非对称特性的学生网络,但单靠单一前向通路去同时完成“局部重构”与“全图背景绝对无损保真”仍存在内在冲突。以往的多步模型(如 ObjectClear)常采用基于交叉注意力图的注意力引导融合(Attention-Guided Fusion, AGF),但在单步模型中,未经迭代细化的注意力图边界较为模糊,极易引发融合伪影。
论文从理论上指出,在像素点 处,使重构均方误差最小的最优混合门控值 取决于生成流 、参考输入流 与真实目标 之间的局部关系,单靠注意力图先验 并非求解最优门控的充分统计量。
为此,TurboClear 在推理阶段冻结学生 UNet,引入轻量级卷积网络构成的 LSF 模块。该模块维护双流机制:
生成去除流:由单步 UNet 生成的去噪潜变量 ;
保真参考流:由原始输入图像经 VAE 编码得到的参考潜变量 及其原始 RGB 图像 。
LSF 拼接多模态局部残差特征 ,通过浅层卷积预测残差修正项 ,分别生成潜空间融合门控 与像素空间融合门控 :
最终的混合输出在潜空间与像素空间层层递进完成:
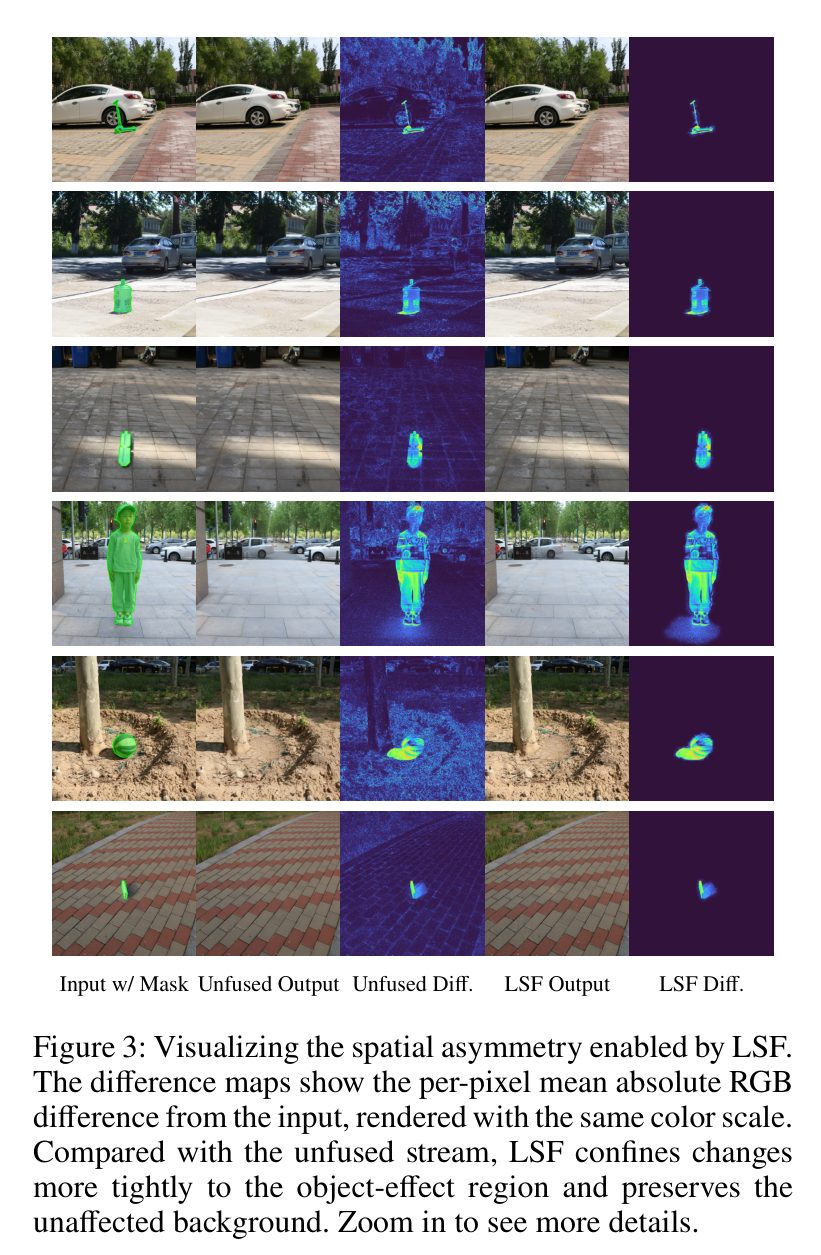
如图 3 所示,未经 LSF 融合的单步输出在非编辑区域存在明显的微小颜色漂移,而经过 LSF 自适应门控后,所有像素修改被严格约束在物体及其效应影响区内,背景区域实现了无损的恒等保留。
值得强调的是,特权掩码 仅在训练阶段用于损失约束;在实际推理阶段,用户仅需提供普通的物体选区掩码 和文本提示词即可。
实验与结果:算力降维下的全面超越
1. 定量性能与计算开销
研究团队在包含 163 张图像的 OBER-Test(512×512 分辨率)以及 343 张高分辨率图像的 RORD-Val(960×540 分辨率)基准上进行了详尽测试。
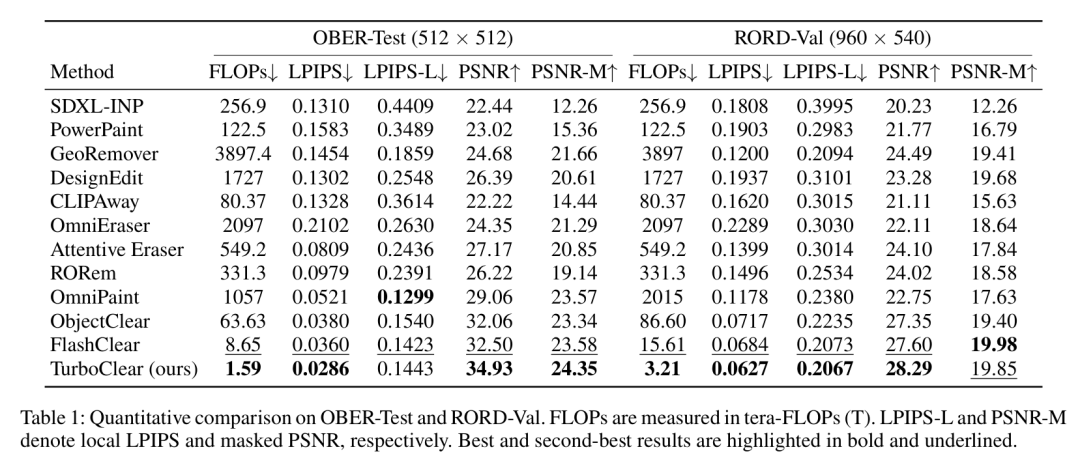
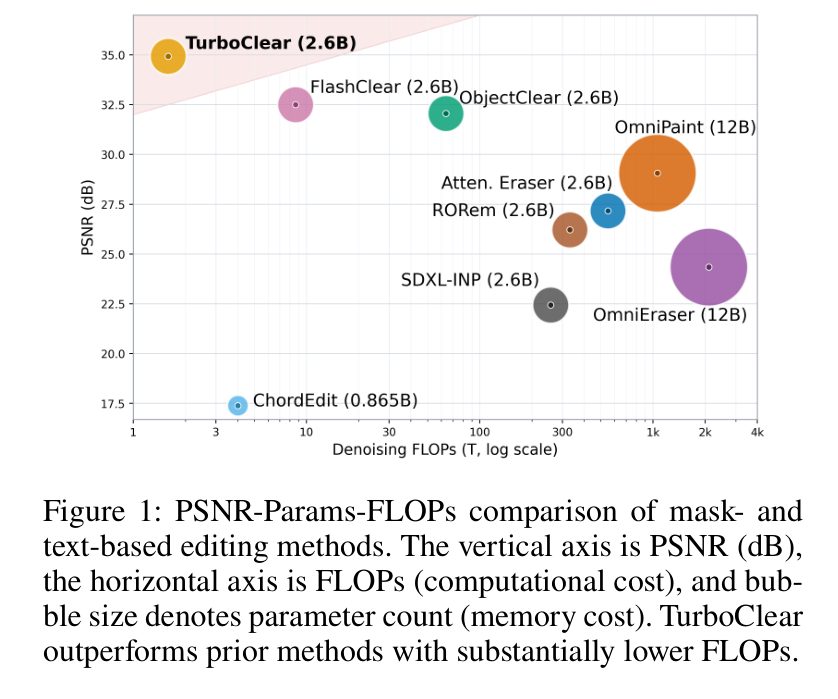
计算量与速度:在 OBER-Test 上,TurboClear 的理论去噪算力仅需 1.59 TFLOPs,相比多步教师模型 ObjectClear(63.63 TFLOPs)压缩了 40.04 倍,相比基于 Flux 的 OmniPaint(1057 TFLOPs)压缩高达 665 倍。
图像重建保真度:在 OBER-Test 上,TurboClear 的全图 PSNR 跃升至 34.93 dB,掩码内重建 PSNR-M 达到 24.35 dB,全图感知误差 LPIPS 下降至 0.0286,指标全面超越以往所有多步与少步方法。
高分辨率泛化:在无需微调直接面对 RORD-Val(960×540)时,TurboClear 的 PSNR 依然高达 28.29 dB,LPIPS 为 0.0627,展现出稳定的分辨率泛化韧性。
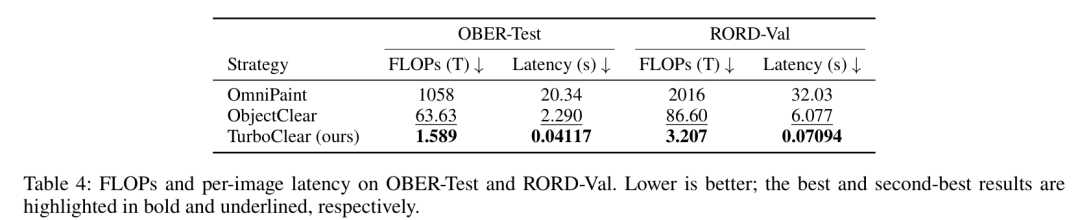
在单张 NVIDIA A800 GPU 的同步实测中,TurboClear 的端到端推理耗时仅为 0.04117 秒(具备 24 FPS 以上的实时交互潜力),相较于 ObjectClear 的 2.29 秒加速达 55.62 倍。
2. 真实场景视觉对比
在不提供真实 Ground-Truth 标签的复杂真实场景测试集 OBER-Wild 上,TurboClear 的优势更加直观。
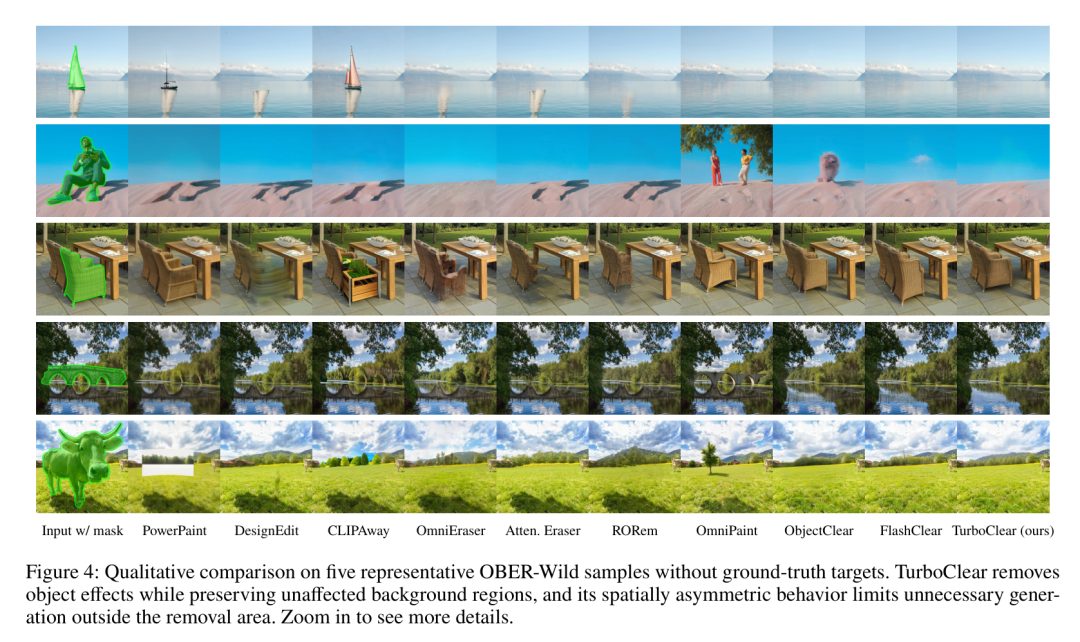
如图 4 所示,面对强烈阳光下的地表阴影与光滑平面的镜像倒影,传统的 Inpainting 模型(如 PowerPaint、GeoRemover)只能抹去选区内的物体,留下明显的黑色阴影;而多步全图重绘模型(如 OmniPaint)虽能擦除阴影,却容易篡改背景纹理。TurboClear 实现了“既彻底消除物体及其伴生投影,又严密保全未受影响背景”的效果。
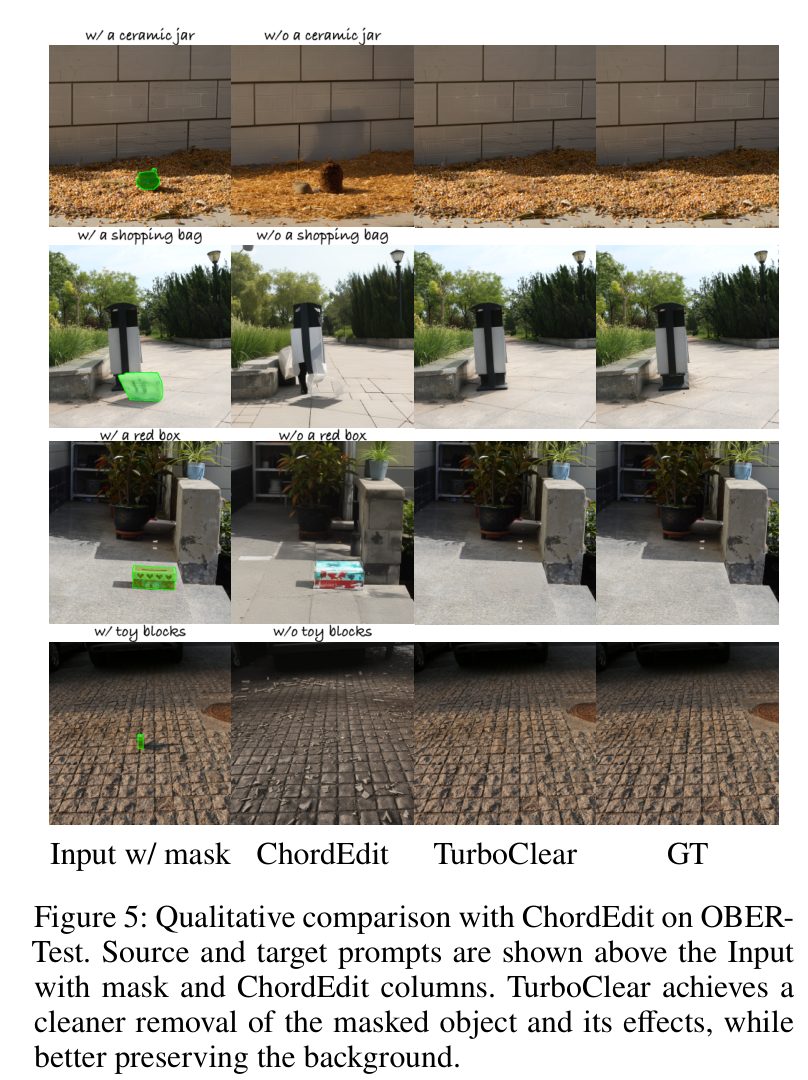
如图 5 所示,即使与最先进的免训练单步文本编辑前沿方法 ChordEdit 相比,TurboClear 同样展现出压倒性优势。凭借显式的空间掩码引导与双流融合门控,TurboClear 彻底消除了物体及其阴影倒影,避免了文本引导方法常见的全图语义漂移与背景畸变。
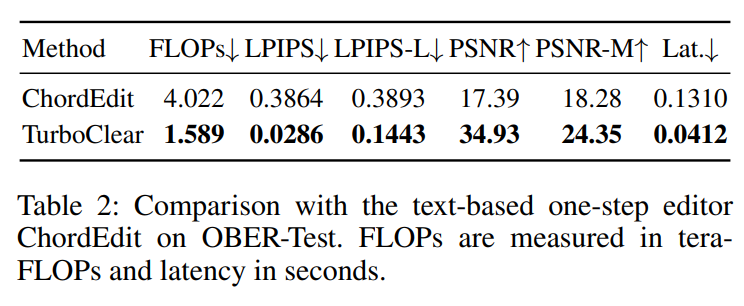
定量数据表明,TurboClear 仅需不到 ChordEdit 40% 的计算量(1.59 T 对比 4.02 TFLOPs)和三分之一的耗时(0.041 秒 对比 0.131 秒),便在重建保真度上实现断层式领先——全图 PSNR 高达 34.93 dB(超越 ChordEdit 17.39 dB 达 17.54 dB),感知误差 LPIPS 更是降低了一个数量级(0.0286 对比 0.3864)。
3. 主观盲测结果
研究团队组织了 20 位评估者参与的双盲评测,共收集 600 组配对比较。
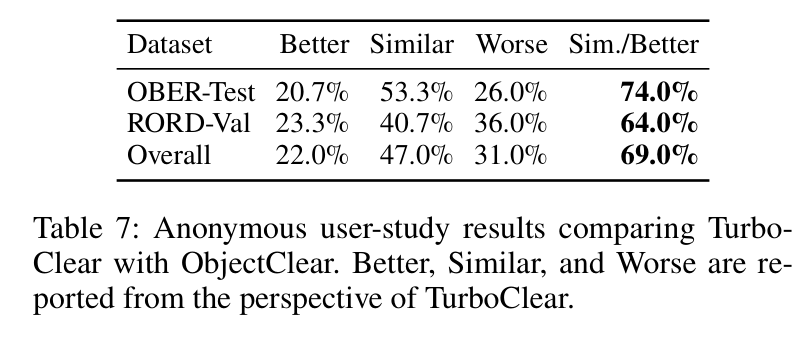
在面对多步基准模型 ObjectClear 时,TurboClear 在 69.0% 的评测中获得了“相当(47.0%)或更优(22.0%)”的主观评价,充分印证了其单步推理输出在视觉自然度与边缘过渡上的可靠性。
写在最后
TurboClear 的核心价值不仅在于将扩散编辑的推理步数压缩到极致的“单步”,更在于清晰拆解并解决了局部编辑任务与全局生成先验之间的张力。通过在分布匹配中引入区域加权校准(RDM),并结合轻量级的局部双流空间混合(LSF),模型证明了单步扩散架构完全有能力承担起兼顾“大幅度局部语义擦除”与“严密背景保真”的双重目标。
值得留意的是,尽管推理 FLOPs 和时间大幅减少,但由于保留了完整的 SDXL UNet 和 VAE,TurboClear 在 A800 单卡上的推理峰值显存仍约 7.96 GB。若要在移动终端或受限设备上运行,结合权重量化或更轻量化骨干网络进行二次压缩,将是后续极具落地潜力的演进路径。
论文标题: TurboClear: One-Step Object-Effect Removal via Region-Calibrated Distribution Matching and Fusion
机构: 上海交通大学、荣耀终端有限公司、帝国理工学院
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。