光照变化下,机器人如何稳定操作?RawVLA 让相机 ISP 为动作服务
原创 52CV 2026-09-30 23:55 江苏
论文:RawVLA: Embodied Neural Image Signal Processor for Robotic Manipulation
作者:Shuhong Liu、Heng Zhou、Lingfeng Qian、Yuhao Fang、Xianbao Hou、Qianyu Zhou、Lin Gu、Wei Sui、Jianfei Yang、Ziteng Cui
机构:东京大学、南洋理工大学、东北大学、香港科技大学(广州)、D-Robotics
项目主页:https://shuhongll.github.io/rawvla/
数据集:https://huggingface.co/datasets/ToferFish/RawVLA-Bench
我们常把机器人操作失败归因于模型能力不足:是不是视觉编码器还不够强?是不是训练数据还不够多?是不是动作策略还不够聪明?
但有时,问题发生得更早。
当房间里的灯光突然变暗,传感器读到的噪声随之增加;当强光照进镜头,目标物体的纹理和边缘可能直接淹没在过曝区域;当白平衡或颜色响应改变,模型接收到的画面也会偏离训练分布。对人类来说,这些只是“画面不太好看”,对依赖视觉输入的机器人来说,却可能意味着抓取点消失、目标识别错误,甚至整个动作流程无法启动。
由东京大学、南洋理工大学、东北大学、香港科技大学(广州)和 D-Robotics 联合提出的 RawVLA,把目光投向了长期处于机器人系统上游、却很少与动作目标共同优化的模块——相机 ISP。
它提出了一个简单但关键的问题:
相机输出的图像,为什么只为人眼“好看”服务,而不能直接为机器人的动作成功率服务?

一、机器人看到的RGB,并非世界本身
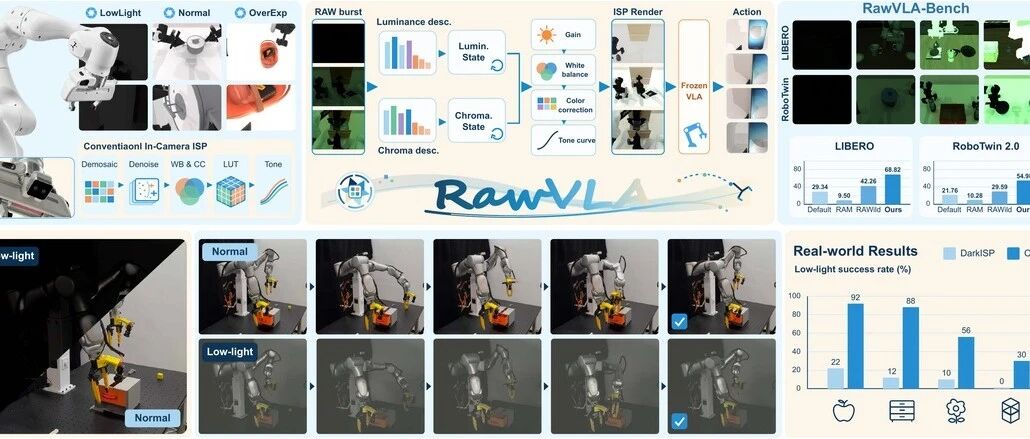
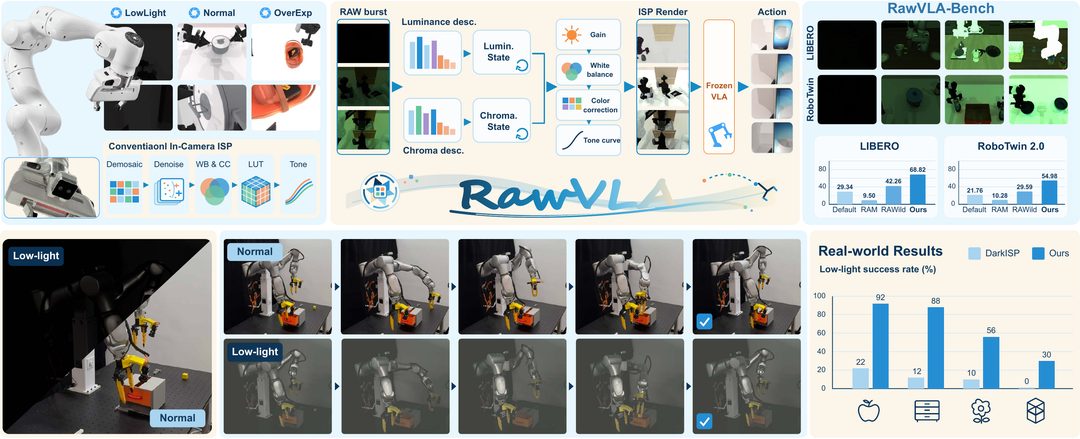
机器人相机并不会直接得到一张我们熟悉的 RGB 图片。光线到达传感器后,首先形成 RAW 信号,再经过图像信号处理器(Image Signal Processor,ISP)完成去噪、曝光、白平衡、颜色校正、色调映射和量化,最后才成为送入 VLA 的图像。
完整链路更接近:
真实场景 → 传感器 RAW → ISP → RGB → VLA → 机器人动作传统 ISP 通常以摄影和显示效果为目标:画面是否明亮、颜色是否自然、对比度是否讨喜。但机器人并不关心照片是否适合发朋友圈。它真正需要的,是夹爪轮廓、物体边界、接触区域和空间关系等与任务相关的信息。
一张在人眼看来更明亮、更鲜艳的图像,未必更利于机器人决策;反过来,一张视觉效果并不完美的图像,也可能保留了更多动作所需的线索。
这正是 RawVLA 的出发点:评价图像处理效果的最终标准,不应只是画质指标,而应是机器人能否完成任务。
二、只改变相机处理,VLA 的表现会差多少?
在提出方法之前,作者先系统测试了不同 VLA 和世界动作模型(WAM)对成像条件的敏感程度。
实验固定场景、任务和机器人状态,只改变 RAW-to-RGB 管线中的曝光、传感器噪声、白点、相对色彩、色调响应和位深。结果显示,即便动作策略本身完全不变,相机端的变化也足以让成功率大幅波动。
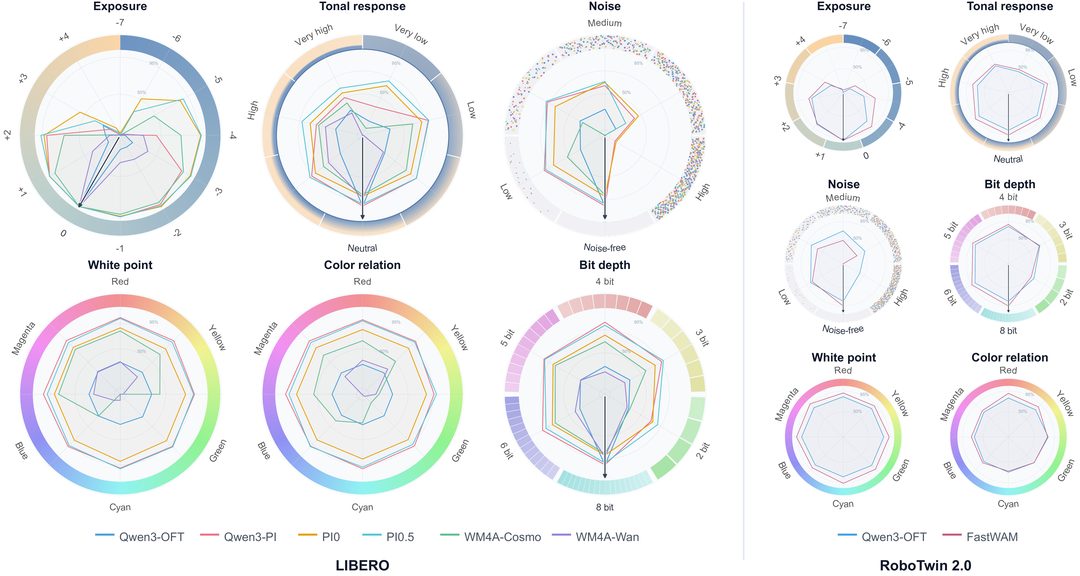
其中,曝光是最显著的影响因素。多数策略只在默认曝光附近保持较高成功率,一旦进入严重欠曝或过曝区间,性能便迅速下降。噪声则呈现出明显的阈值效应:轻微噪声尚可容忍,中高强度噪声却会造成突发性退化。
颜色与色调同样不能忽视。不同模型对冷暖色偏的容忍度并不一致,过平或过强的色调曲线也会破坏原有的视觉分布。相比之下,位深并非首要矛盾,真正严重的下降主要出现在两比特等极端量化条件。
这组实验揭示了一个容易被忽略的事实:VLA 的鲁棒性不仅由主干模型决定,也受制于相机把物理世界转换成数字图像的方式。
三、RawVLA:不改 VLA,先让相机学会适应环境
RawVLA 被放置在 RAW 信号与冻结 VLA 之间。它不修改 VLA 主干,而是根据连续 RAW 帧和当前成像状态,动态预测一组结构化 ISP 参数,再将处理后的 RGB 图像送给下游策略。
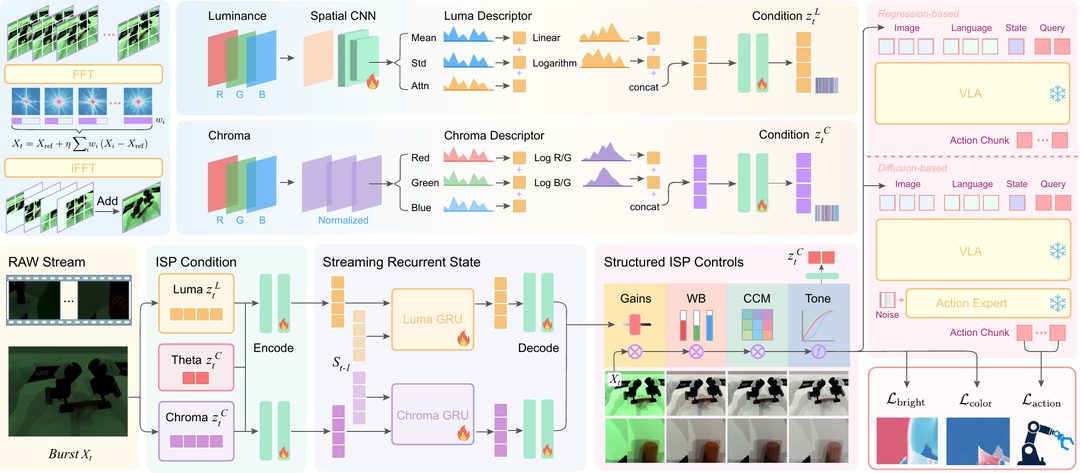
整个模块约有 88.7 万个可训练参数,设计重点可以概括为四点。
1. 在放大曝光之前,先处理低光噪声
低光图像一旦直接增亮,噪声也会被同步放大。RawVLA 使用当前帧和五帧历史图像组成六帧因果 burst,并根据局部可靠性在频域融合信息。
静止区域可以充分借助历史帧降低噪声;对正在运动的机械臂、夹爪和物体,模型会降低历史融合权重,避免简单多帧平均产生拖影。
2. 把亮度与颜色分开建模
图像变亮,可能来自曝光,也可能来自白平衡、颜色矩阵或色调曲线。不同参数相互耦合,会让学习过程变得不稳定。
RawVLA 因此构建了两条独立路径:亮度路径关注直方图、分位数、暗像素和饱和像素比例等信息;色度路径则提取尽量不受整体亮度影响的颜色统计。两条路径分别维护递归状态,使系统既能根据环境变化及时调整,也能减少连续视频中的画面闪烁。
3. 预测可解释参数,而不是自由生成图像
RawVLA 不让大型网络直接“画”出一张 RGB 图像,而是预测曝光增益、白平衡增益、3×3 颜色校正矩阵和单调色调曲线。
这种设计把输出限制在真实 ISP 可以解释和控制的范围内,既降低了模型规模,也减少了局部伪影和不稳定变化,更适合对实时性与连续性要求很高的机器人控制系统。
4. 让动作损失决定什么是“好图像”
训练期间,VLA 主干保持冻结,梯度只更新 RawVLA:
RAW → RawVLA → RGB → 冻结的 VLA → 动作损失换言之,RawVLA 并不需要一张像素级“标准答案”作为监督,而是直接学习什么样的成像结果更有利于下游策略输出正确动作。
针对极端欠曝或过曝时梯度不稳定的问题,作者加入了权重很小的亮度和色度先验。它们只负责把优化拉回合理范围,最终决定渲染方向的仍然是动作目标。
四、RawVLA-Bench:把光照和成像正式纳入机器人评测
为了系统研究这一问题,团队进一步构建了 RAW-domain 机器人操作基准 RawVLA-Bench。
基准覆盖 Extreme Low、Low、Normal、Over 和 Extreme Over 五种光照域,包含:
40 个 LIBERO 任务与 13 个 RoboTwin 2.0 任务;
2,403 条配对训练轨迹;
13,250 次评测 rollout;
408,075 个多视角帧。
其中,LIBERO 由 tone-mapped RGB8 反演构建 pseudo-RAW10;RoboTwin 2.0 则使用 tone mapping 前的 HDR buffer,并进一步加入异方差传感器噪声,因而更接近真实 RAW 成像过程。
与只在标准 RGB 图像上比较策略性能不同,RawVLA-Bench 把“相机如何看见环境”本身变成了可控、可重复、可量化的评测维度。
五、从仿真到真机,效果如何?
LIBERO:跨模型平均成功率达到 68.82%
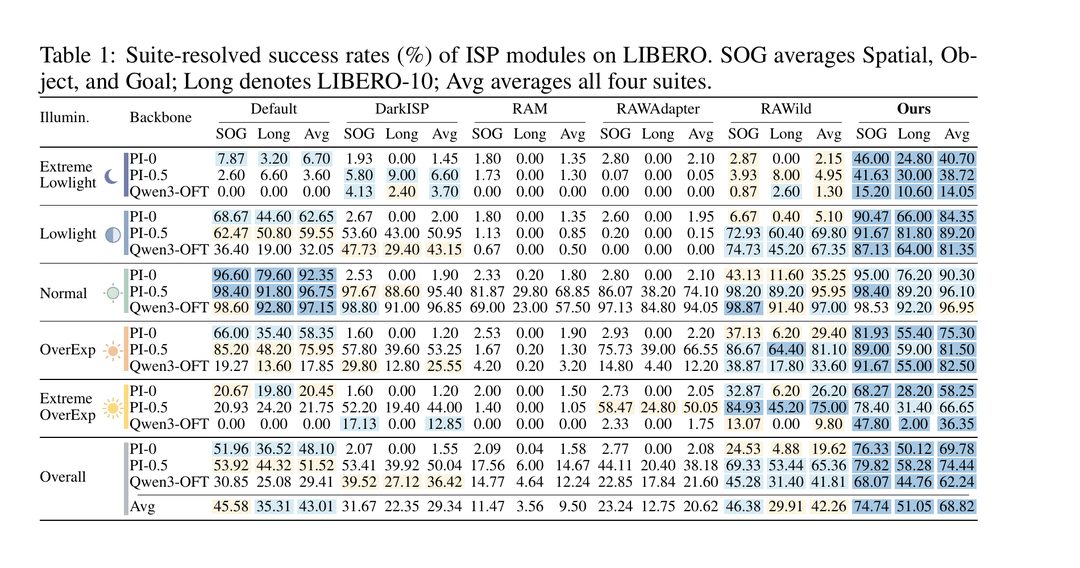
在 PI-0、PI-0.5 和 Qwen3-OFT 三种主干上,RawVLA 的跨模型平均成功率达到 68.82%,固定 Default ISP 为 43.01%。
更值得关注的是,主要收益来自低光与过曝等困难条件,而正常光照下的原有性能基本得到保留。RawVLA 并不是把所有画面一律增强,而是在不同环境中寻找更适合当前策略的成像参数。
RoboTwin 2.0:同时改善低光与过曝表现
在 RoboTwin 2.0 中,RawVLA 的跨主干平均成功率为 54.98%,比最强 neural ISP 对照 RAWild 高 25.39 个百分点,比 Default ISP 高 11.07 个百分点。
结果表明,这套结构化 ISP 并非只针对“把暗图变亮”这一种退化,而是能够覆盖欠曝和过曝两端的成像变化。
真机低光:Default ISP 为 0%,RawVLA 达到 66.5%
团队还在双臂机器人上测试了 Pick & Place、Drug Drawer、Pick Flower、Stack & Cover 四项任务。
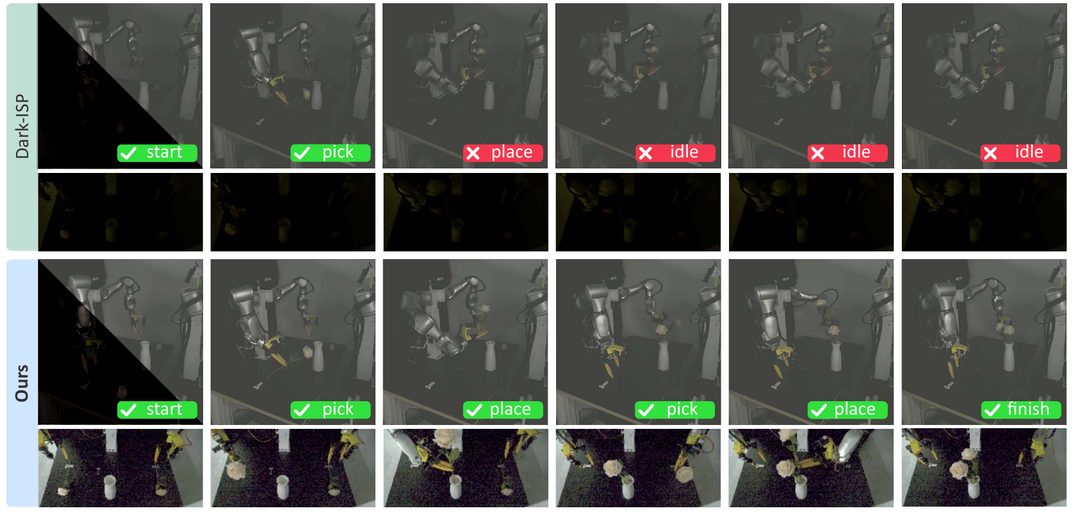
使用同一个 PI-0.5 策略时,传统 Default ISP 在低光条件下完全失败,平均成功率为 0%;RawVLA 则达到 66.5%。与此同时,它在正常光照下仍保持原有能力。
此外,RawVLA 的推理速度达到 168 FPS,高于实验相机的原生帧率,说明这并不是一个只能离线处理图像的增强算法,而具备进入实时机器人视觉链路的潜力。
六、这项工作带来了什么新的视角?
RawVLA 的意义,不只是把一张暗图调亮,也不只是又设计了一个图像增强网络。它重新划分了机器人视觉系统的优化边界。
过去,研究通常默认 RGB 图像已经准备完毕,再努力让视觉模型适应不同画面。RawVLA 则把优化向前推进到 RAW 域:在高光裁切、色调映射和量化等不可逆处理发生之前,尽量保留并重组对动作有用的信息。
它还改变了“图像质量”的定义。对机器人而言,最重要的不一定是 PSNR、SSIM 或主观观感,而是图像能否支持稳定决策。换句话说,成像不再只是感知之前的预处理,而可以成为闭环控制系统中可学习的一环。
同时,RawVLA 选择显式 ISP 参数而非自由度更高的图像生成分支,也体现了机器人系统与通用图像增强的差异:机器人不仅需要更强的表示能力,还需要实时、连续、可控且可解释的视觉输入。
七、目前还有哪些边界?
这项工作仍有几个值得关注的限制:
当前需要针对不同冻结 VLA 分别训练 ISP,并非一个 RawVLA 权重可以直接零训练适配所有策略。
学习型 ISP 在 WAM 上尚未获得与 VLA 同等稳定的收益,生成式路径中的动作梯度优化仍然困难。
LIBERO 使用的是由 RGB 反演得到的 pseudo-RAW,无法完全恢复真实传感器在裁切前的信息。
真机实验目前集中在一个双臂平台、四项任务以及正常与低光条件,跨传感器、真实过曝、背光和混合色温等场景仍待进一步验证。
对策略最有用的图像未必符合人类审美,因此 RawVLA 不应被简单理解为通用照片增强方法。
写在最后
当机器人在暗处停下时,我们或许不必立刻换掉整套大模型。问题可能出在视觉链路最前端:真正有用的信息,还没有被正确地交给策略。
RawVLA 证明,相机 ISP 并不是一个固定、中立、与任务无关的黑盒。它可以由动作目标驱动,可以随环境动态变化,也可以成为连接物理传感器与通用机器人策略的重要中间层。
从“让模型适应图像”,到“让成像服务动作”,这可能是机器人走出受控实验室、进入复杂真实环境时,需要补上的关键一环。
相关链接
📄 论文地址:https://arxiv.org/abs/2609.37530
🌐 项目主页:https://shuhongll.github.io/rawvla/
📦 数据集:https://huggingface.co/datasets/ToferFish/RawVLA-Bench
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。