NeurIPS 2026|让动作成为生成的剧本:KVLR 探索手术场景的多种视觉未来
原创 52CV 2026-09-29 23:29 江苏
项目、论文与代码已公开:
论文 PDF:https://arlo0o.github.io/KVLR-project/public/assets/KVLR.pdf
GitHub 代码:https://github.com/Arlo0o/KVLR
动作改变,生成的画面如何随之改变?
把画面停在器械即将移动的那一刻。接下来,不止一种可能。
向左移动,或向右移动;继续推进,或改变腕部朝向。同一张参考图像,可以作为不同动作分支的共同起点。如果把这些动作分别交给生成模型,我们能否看见它们各自展开的画面?
这让视频生成的问题从“接下来可能出现什么”,变成了更具体的一问:“如果给定这个动作,接下来会呈现怎样的视觉变化?” 从续写画面,到按动作展开画面,差别就在于控制。
我们提出 KVLR(Kinematic-to-Visual Lifting and Routing),将关节化器械动作转化为与图像对齐的视觉控制信号,再通过分层路由选择合适的控制模态与运动尺度。相关论文已被 NeurIPS 2026 接收,项目主页与研究代码现已公开。
参考图像给出起点,动作轨迹写下剧本,KVLR 将它们展开成可观看、可比较的视觉可能性。
KVLR 的三个关键设计,让这个目标变得更具体:用一阶、二阶运动信息描述动作如何变化,用分层路由增强精细控制,再用动作自适应计算提升生成效率。这里展示的是给定动作下的条件生成可能性,而非对真实手术结果的确定性预测。
让动作变得可见,让不同动作的后续画面可以被比较。 这就是 KVLR 希望推进的可控生成能力。
01 从“续写画面”,到“按动作展开画面”
给模型一句“器械夹取缝针”,它或许能生成具有手术外观的视频。但这句话并没有精确规定:器械从哪里出发、朝哪个方向转动、夹爪何时闭合。
即使进一步输入动作向量,问题也没有自动解决。机器人动作是紧凑的低维数值,视频却包含密集的空间结构和连续的时间变化。模型必须把“关节和位姿的变化”,转换成“画面中器械各部分如何移动”。
手术场景让这个问题更加突出:大范围移动与局部微调交替出现,细小的腕部转动和夹爪开合又可能被遮挡、反光或复杂背景干扰。
KVLR 的切入点,是先解决动作与图像之间的表示差异,再解决控制信息如何被模型使用。
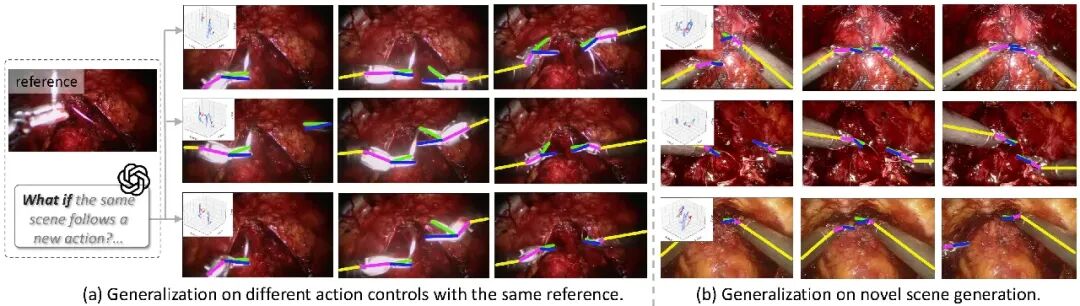
图 1|左侧展示同一参考画面在不同指定动作下的生成结果;右侧展示新场景中的定性迁移结果。彩色线段表示器械结构与动作的可视化,不代表临床操作建议。
02 给动作写上“速度”与“节奏”:从位置走向二阶变化
KVLR 构建了 KVA-Field(Kinematic-to-Visual Action Field)。它利用器械的关节结构与几何信息,将动作投影到相机视角,形成五类与图像对齐的控制信号:
部件语义:哪里是器械轴、腕部和夹爪?
深度:器械各部分在空间中的前后关系是什么?
旋转:器械部件朝向哪里?
速度:当前如何移动?
加速度:运动如何发生变化?
特别之处在于,我们不止描述器械的当前状态,还显式引入运动的一阶与二阶时间变化。
同一个位置,可以是一段运动的起点,也可以是减速后的停靠点。位置相近,不代表运动状态相同。位置告诉模型“器械在哪”;一阶变化得到速度,告诉模型“往哪里、以多快的速度移动”;二阶变化得到加速度信息,进一步刻画“运动正在怎样改变”。这里的“节奏”,指的正是这些可以计算的运动变化。
具体到论文实现,我们从连续关节状态的相机投影表示计算时间差分:先得到投影速度,再对速度作差分并取范数,形成加速度幅值通道。这是显式的二阶运动学线索,与语义、深度和旋转一起,构成图像对齐的控制场,而不是另行求解完整的力学或组织形变方程。
由“静态姿态”走向“运动变化”,KVLR 为精细动作对齐提供了更丰富的约束。这也是我们追求高保真、细粒度可控生成的关键设计之一;最终收益由整套方法的实验验证,不将某一个二阶通道单独宣称为精度保证。
这一步也区别于直接依赖完整场景的密集视觉条件:KVLR 的控制表示由关节化动作与器械几何构造,重点是把可投影的动作信息转成生成模型更容易利用的形式。
03 不把每个细节一视同仁:让控制跟着动作走
有了五类信号,并不意味着所有时刻都应该等量使用它们。
器械快速移动时,速度与加速度很重要;局部关节变化时,旋转和部件结构更加关键;变化较小的区域,则未必需要同样强度的控制更新。
KVLR 因此采用两级路由:
第一级,在控制模态之间选择。 模型根据当前状态,选择更相关的语义、深度、旋转或运动信息。
第二级,在运动尺度之间选择。 进一步区分精细操作、大范围移动以及可跳过的控制更新。
此外,运动学先验引导的训练约束,让路由既关注动作本身,也兼顾时间一致性和控制路径的可预测性。
核心不是简单增加控制通道,而是:把合适的控制信息,用在合适的部位和时刻。
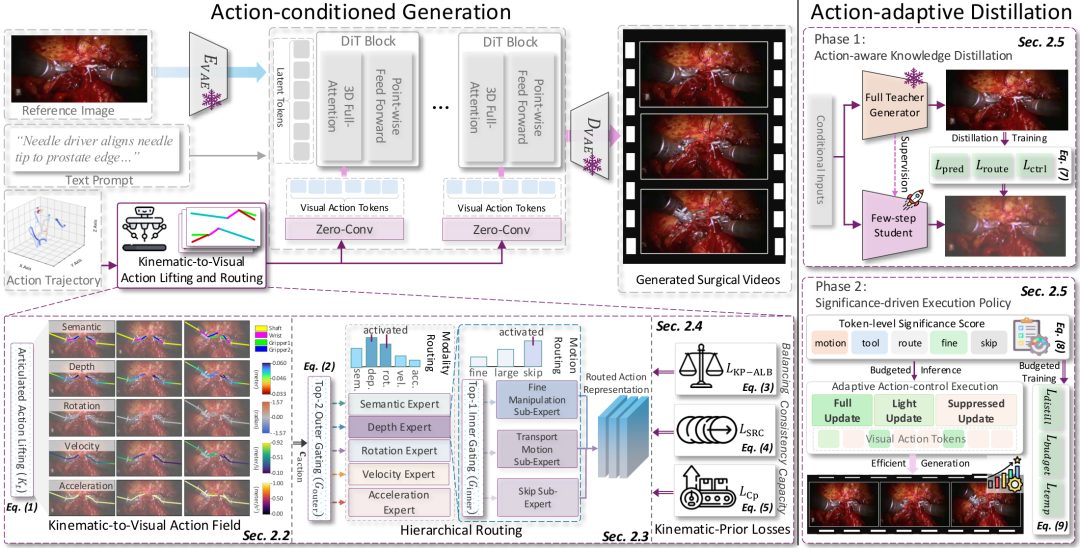
图 2|KVLR 总体框架。左侧将动作提升为五类视觉控制;中部通过模态与运动尺度两级路由实现条件控制;右侧展示面向高效生成的蒸馏与自适应执行。
04 不只提出方法,也构建可评测的数据基础
可控生成需要成对的“视频与动作”监督。真实手术视频并不总是附带可以直接使用的机器人运动学记录。
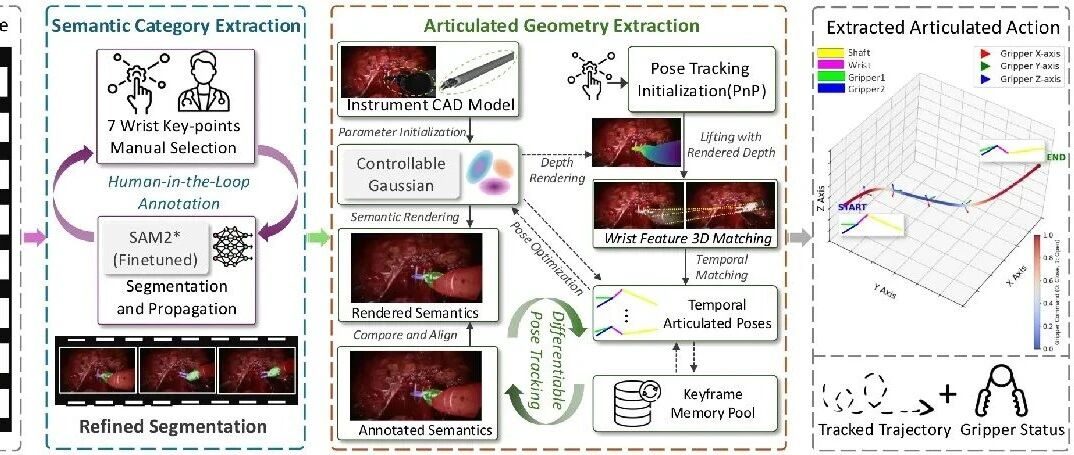
为此,我们基于 SAR-RARP 整理构建了 KASA:通过人在回路的语义标注与可微位姿跟踪,从视频中恢复关节化器械运动,为生成模型提供与视觉观测对应的动作监督。
KASA 包含 1,047 个手术场景、105,175 帧视频,覆盖三类代表性动作:打结、夹取缝针和穿刺。数据将较大范围的器械移动与精细局部操作纳入同一评测框架。
这些动作标注来自视频恢复与人工辅助标注流程,不应与机器人编码器直接测量的运动学真值混同。
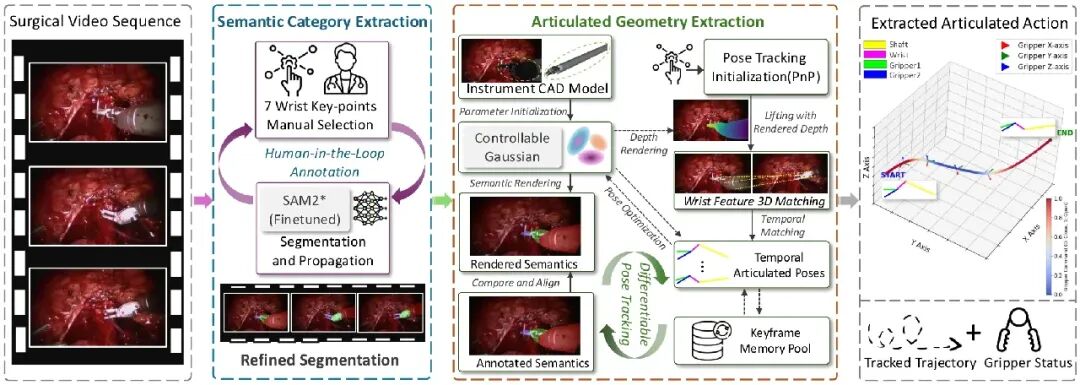
图 3|KASA 从真实手术视频出发,通过人在回路的部件分割和可微位姿跟踪,建立视频与关节化动作之间的对应。
05 效果如何?既看画面,也看动作
论文在 KASA 上比较了文本条件、原始动作条件和密集视觉条件三类方法。在相同数据划分下,完整 KVLR 在三类动作的全部所列动作忠实度和生成保真度指标上,均取得表中最佳均值。
下面摘录生成保真度结果。FID 与 FVD 均为越低越好:FID 关注图像分布,FVD 关注视频分布。
KASA 动作 | KVLR FID | KVLR FVD |
|---|---|---|
打结 | 14.78 ± 0.89 | 154.56 ± 8.72 |
夹取缝针 | 16.60 ± 0.91 | 168.94 ± 9.85 |
穿刺 | 11.75 ± 0.68 | 87.10 ± 5.96 |
数据来自论文正文 Table 2,报告三次运行的均值与标准差;FID 按帧计算,FVD 在 17 帧片段上计算。
以加入原始动作条件的 Cosmos-H-Surgical 为参照,三个动作子集的 FID 均值从 23.35 降至约 14.38,降低 38.4%。该百分比按子集指标等权平均后计算,并非重新合并全部帧计算的 FID。
视觉质量并不是唯一依据。论文还使用独立评估器检查生成器械与指定动作的一致性,并补充轨迹级验证和动作扰动实验。在 GraSP 上无需额外微调的跨数据集测试,也展示了对不同组织外观、光照与视角的迁移能力。
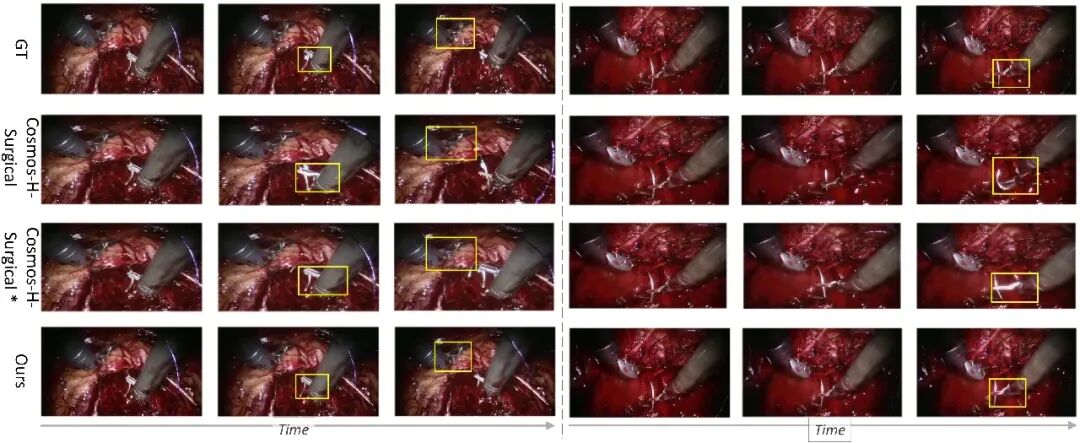
图 4|KASA 定性比较。从上到下为真实视频、Cosmos-H-Surgical、加入原始动作条件的 Cosmos-H-Surgical,以及 KVLR。黄色框标出对比区域;示例展示了器械状态与动作演化的差异。图中基线名称后的星号表示动作条件版本,与作者贡献标识无关。
06 KVLR-fast:更快,也尽量保留动作控制
完整 KVLR 优先追求动作忠实度与画面质量。面向效率需求,我们进一步提出 KVLR-fast,将动作感知蒸馏、空间自适应执行和时间缓存结合起来。
它不仅减少采样步数,还利用路由提供的重要性信息,减少低重要性控制路径的重复计算。
在论文的 NVIDIA H20、17 帧片段、288×512 分辨率测试设置下,KVLR-fast 的生成延迟为 0.37 秒/片段,相较原始动作条件版 Cosmos-H-Surgical 的 0.70 秒降低 47.1%。在 576×1024 分辨率下,延迟为 1.88 秒/片段。
加速并非完全没有代价:效率消融中,完整模型到最终高效版本的 CD 从 86.89 变为 89.87,FID 从 14.37 变为 17.67。KVLR-fast 提供的是速度与质量之间的明确取舍,而不是“无损加速”。
这些数字描述指定实验设置下的视频生成速度,不代表真实机器人闭环控制延迟,也不等于已经具备临床实时部署能力。
07 一张画面,不止一个后续:让“如果”变得可见
一张参考图像,不必只对应一条生成路径。保持参考画面不变,输入不同的关节化动作序列,KVLR 可以呈现不同的动作条件视频,让研究者直观比较:改变动作后,器械的姿态、轨迹和局部画面将如何随之变化?
这正是本文“多种动作未来”的含义:在模型的预测空间里,把不同动作假设展开为可视化结果,为后续仿真与交互研究提供可观察的候选情景。它不是穷举所有未来,也不代表模型已经能够判断哪条动作最安全或最优。
从一阶、二阶运动信息,到图像对齐的控制场,再到按模态与运动尺度分配计算,KVLR 将动作表示、条件生成和高效执行连接起来。
它为手术仿真研究、训练素材构建和数据增强提供了可探索的工具,也为更广泛的动作条件生成提供了设计思路:控制信号不必只停留在一个向量中,而可以成为与视觉空间对齐、可解释、可调度的条件表示。
当前验证主要围绕代表性的缝合相关子动作。更广泛的手术类型、器械与长期交互仍需进一步研究。生成视频不能替代真实临床证据、专家判断或安全验证。
项目主页与研究代码已公开,欢迎围绕可控视频生成、手术机器人与视觉世界建模开展交流和复现。
论文与资源
论文题目:From Articulated Kinematics to Routed Visual Control for Action-Conditioned Surgical Video Generation
会议:NeurIPS 2026
作者:Bohan Li, Shuojue Yang, Baorui Peng, Xianda Guo, Erli Zhang, Youqi Tao, Junfeng Duan, Daguang Xu, Qi Dou, Xin Jin, Wenjun Zeng, Hao Zhao, Yueming Jin。
参与单位:SJTU、NUS、THU、EIT、WHU、Harvard、NVIDIA、CUHK、南方医科大学深圳医院。
引用
@article{li2026articulated,
  title={From Articulated Kinematics to Routed Visual Control for Action-Conditioned Surgical Video Generation},
  author={Li, Bohan and Yang, Shuojue and Peng, Baorui and Guo, Xianda and Zhang, Erli and Tao, Youqi and Duan, Junfeng and Xu, Daguang and Dou, Qi and Jin, Xin and others},
  journal={arXiv preprint arXiv:2605.08712},
  year={2026}
}
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。