上手体验 IDA 9.5 beta
原创 0xcc 2026-10-04 02:18 瑞士
IDA 前两天发了 IDA 9.5 的 beta,今天周末顺手试用一下。
https://hex-rays.com/blog/ida-9.5-beta-is-available
https://docs.hex-rays.com/release-notes/9_5beta
具体更新日志内容可以用 AI 查看总结原文。下面是一些上手体验。
扩展菜单终于提升了优先级,被单独拿出来放到顶层了。
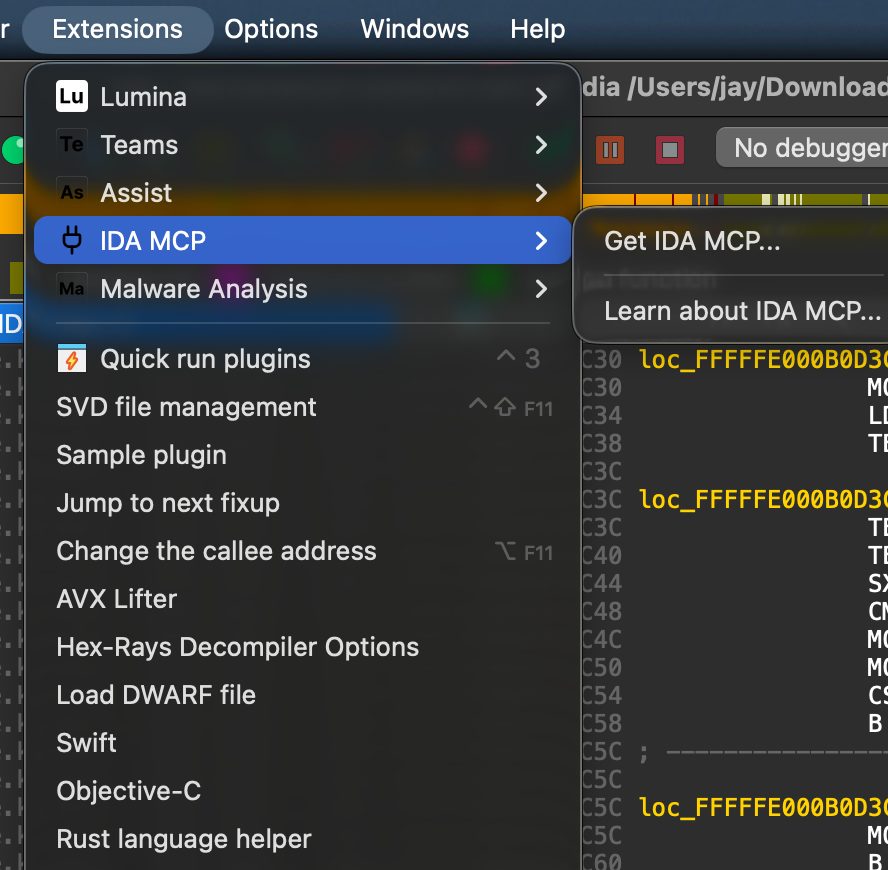
在更新日志里也提到了 Assist 和官方 MCP,还需要单独安装一下才会启用。
在 IDA 9.4 的更新当中加入了对 iOS dyld_shared_cache 的界面优化,专门在界面右侧提供了一个文件树结构来动态加载所需的模块列表。
这个 UI 和工作流的设计目前被应用到了 kernelcache 和 DriverKit 的分析上。
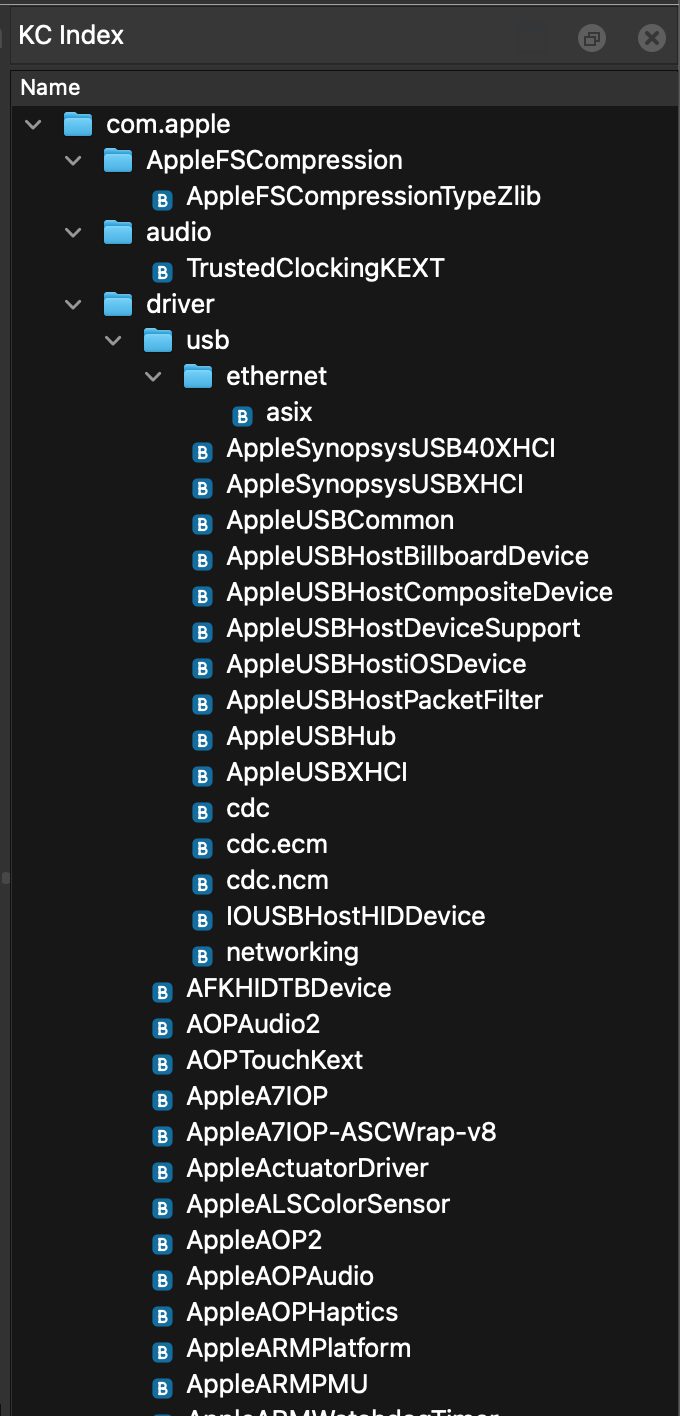
驱动按照树形结构整理好,双击载入模块。
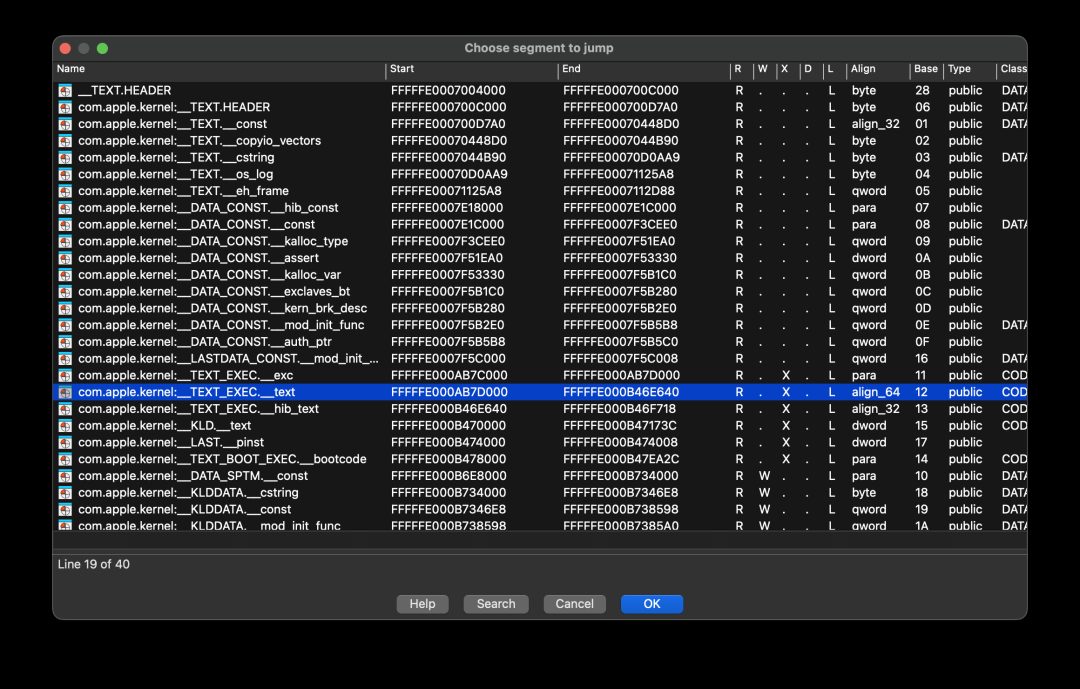
9.4 和以下版本中 kernelcache 并不区分具体模块:
9.5 则干净了很多
在 macOS / iOS 27 发布之前就有人注意到新的系统中,可执行文件的切片(Macho Slice)多了一个新的 CPU 类型:arm64e.x1。
不久前发布的 iPhone 18 所使用的 A20 芯片和 M6 Mac 都采用了用上了 Armv9 扩展指令集。其中一个对普通用户不起眼,但对内存安全有影响的特性就是对 FEAT_CPA(Checked Pointer Arithmetic,检查指针算术)的支持。
如下是来自 A20 内核的一段代码:
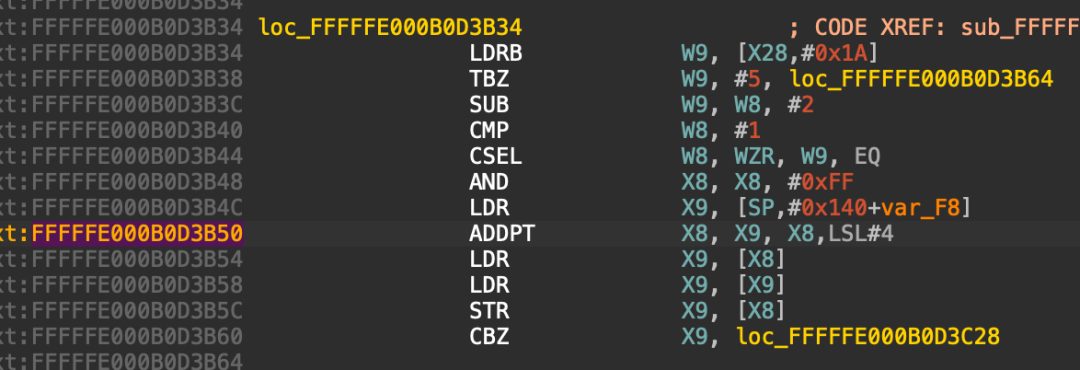
请注意这个 ADDPT 指令。在 IDA 9.4 和以下版本中不被支持:
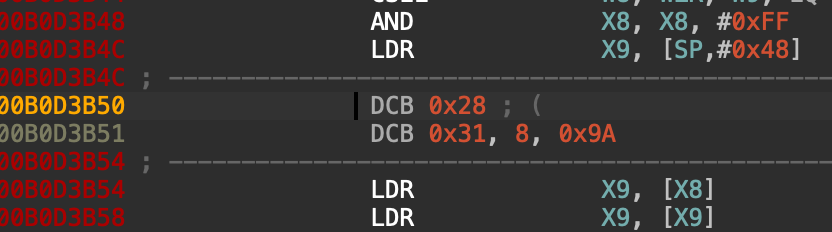
在 ARMv9 架构中,FEAT_CPA(Checked Pointer Arithmetic,检查指针算术)可以让开发者不必修改 C 代码,而仅在工具链中针对新架构启用编译选项获得更强的保护。ADDPT 和 SUBPT 指令可以在指针运算时检查整数溢出和越界访问,结合目前已有的 PAC(控制流完整性保护)和 MTE(内存标签扩展)等特性,协同提升内存安全性。
关于如何在编译器中启用 FEAT_CPA,可以参考 Apple 官方文档:
除了 FEAT_CPA 之外,Armv9 还引入了 FEAT_PAuth_LR(Pointer Authentication for Return Address,返回地址保护),是对 PAC 的进一步增强。
篇幅所限就不详细展开说,可以阅读这篇文章:
Strengthen return address protection using ARM64e.x1 with PAuth_LR https://blakecrosley.com/blog/arm64e-x1-checked-pointer-arithmetic
IDA Pro 其实很早之前就支持 smali 了,这个时候才加上 Java 伪代码反编译。晚到总比不到好。
说到官方的 IDA MCP 就顺便扯几句没营养的。
以前头痛欲裂看几天都未必搞得定的二进制,ai 几下子就蹬完了,谁不爱呢。今年的 Flare-On 挑战赛已经没有人味儿了,一个多小时 ai 全部解完。不过具体到用什么方案就百花齐放了。在 vibe 产品太多,用户反而不够用的今天,这个选题快被社区玩出花了。软件真正实现了“用完即走”,想要什么功能花点 token 直接现写。
以前社区比较有影响力的两个项目:
mrexodia/ida-pro-mcp
blacktop/ida-mcp-rs
社区版的 ida-pro-mcp 主要以 Python 实现,在 MCP 协议上暴露了许多工具,如 decompile、disasm、xrefs_to、list_funcs、rename、set_comments、set_type。 Rust 版的路线也差不多,目前默认暴露 75 个工具,并允许按类别裁剪。在此之上,为了覆盖工具没有实现的功能,他们都提供了直接执行 IDAPython 代码的接口。
值得注意的是新的这个 IDA 官方版的重要维护人就是 mrexodia。
这个官方的插件则只暴露 open_database、execute_python、reference、list_databases、 save_database、close_database 六个工具;反编译、找交叉引用、筛字符串乃至修改数据库,都让模型临时写 Python 完成。reference 则提供了查文档的能力。
确实由于模型能力的进化,很多曾经需要封装的技能,模型早就背得滚瓜烂熟了,直接生成动态脚本比封装工具更灵活。
在没有官方工具的时候我体验了以上两个社区的工具,最后还是决定重新 vibe 一个。
Rust 版是纯 headless,可以同时管理多个数据库实例。而很多时候我的工作流是顺手在 IDA 界面里打开一个数据库,然后想起来要用 AI 干点什么。这样只能打开两份数据库副本。
而那个 Python 社区版 MCP 塞了一堆没什么用的工具,甚至还有什么文件 hash 计算。这个需求一行 bash 就搞定了,还放 MCP 里占用上下文。而且我很不喜欢这个每开一个 idb 就要多启动一个 http 端口的设计。
我自己的设计路线就略有不同。一个 python 的 cli 暴力接口给 harness,同时提供一个 daemon 模式作为消息路由。在 IDA 里则是主流的 python 插件形式,但是不直接启动 MCP 服务,而是通过 Unix socket 反向连接到 daemon 服务上。
如果 cli 还想在 headless 模式下打开新的 idb,就走 IDA Domain API。
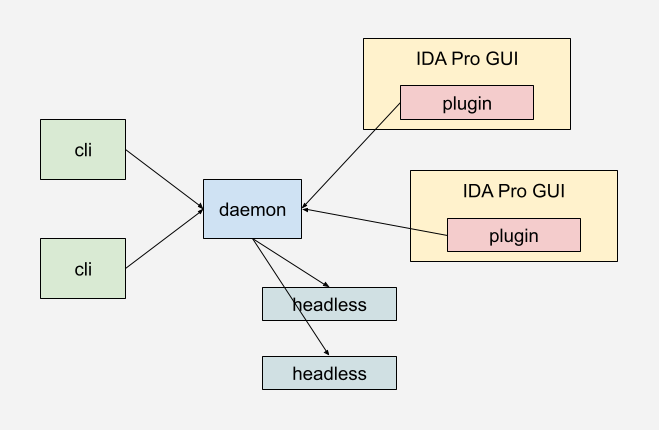
这样活动的 IDA 图形界面还是可以随时上去人工查看状态,虽然可能会被模型的请求打断。倒是解决了端口满天飞和 headless 模式查看不了任何信息的问题。
但是既然都说到 AI 反编译了,可以更大胆点。
现在模型的能力强的令人咋舌,以至于反编译的质量稍微差点也不怎么影响出活。哪怕是没有反编译器的情况下,模型现在 objdump 用得飞起,直接看反汇编,只是这样比较费 token 和时间罢了。
由于我自用的场景基本上就局限在 ARM 指令集,所以用一堆开源库糊一个完全不依赖 IDA 的反编译器也很快。
除了传统的 capstone 搭配 loader 出汇编代码,还可以看看这个基于 ghidra 移植而来的反编译引擎 kuna:
https://github.com/noelo-Lab/kuna
这甚至解决了一个 IDA 的短板。比如反编译超大的二进制文件,dyld_shared_cache (现在其实还好)或者 AppStore 里解密出来的 ipa,载入一次就要很久。
而一般的 app 如果没有专门针对瘦身过,是会携带很多运行时信息,对 llm 很友好。IDA 刚载入数据库会消耗很长时间,但如果只是写一个工具仅仅提供指到哪里反编译哪里,相当于跳过全局分析。加上 ARM 指令有一个特点就是对齐,这上面可以加速的技巧就太多了。
牺牲准确性和反编译效果,那边自动分析还没跑完,已经出活了。
今天的自吹就到这
本文转载自微信公众号「非尝咸鱼贩」,查看原文。版权归原作者所有,如有侵权请联系删除。