NeurIPS 2026|多模态推理模型为何“越想越幻觉”?C3PO 压缩思维链并从推理源头抑制幻觉
原创 52CV 2026-10-06 23:29 江苏
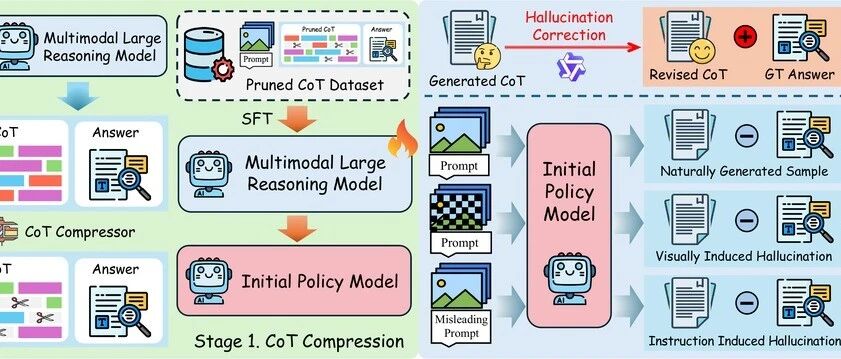
近年来,以 DeepSeek-R1 为代表的大推理模型通过显式生成中间推理过程,在数学、代码和复杂逻辑任务上展现出强大能力。随着这一范式扩展到视觉语言场景,多模态大推理模型(Multimodal Large Reasoning Models,MLRMs)也开始借助长思维链处理视觉数学、科学问答和复杂图像理解问题。
然而,“想得更多”并不一定意味着“看得更准”。
近期的评测却呈现出一个反直觉现象:相比非推理基座模型,引入显式推理机制后,MLRM 反而可能产生更严重的视觉幻觉。模型生成了更长、更连贯的解释,注意力却逐渐从图像转向文本上下文,最后依靠语言常识补全并不存在的物体、属性与关系。
例如,下图中并没有叉子,但模型看到沙拉和餐巾后,沿着“沙拉通常搭配叉子”的语言先验展开了一段看似合理的推理,并最终给出错误答案。更值得关注的是,R1-Onevision 和 MM-Eureka 等推理模型在 AMBER 上的表现甚至低于非推理基座 Qwen2.5-VL-7B。
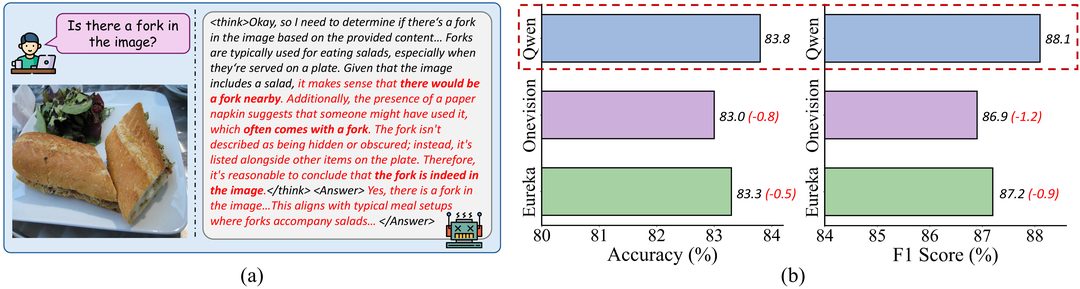
图 1:多模态推理模型中的幻觉案例
当多模态模型生成更长的思维链时,为什么反而更容易忽略图像?是否能让推理过程变得更紧凑、更依赖视觉证据,从源头阻断幻觉向最终答案传播?
针对这一问题,研究团队在最新被 NeurIPS 2026 录用的论文中提出 C3PO,一个面向 MLRM 的两阶段幻觉缓解框架。该方法先通过 Chain-of-Thought Compression 删除低信息、冗余的推理 token,再利用 Contrastive Preference Optimization 提升推理链质量。训练过程中,视觉与文本诱导机制还会主动暴露模型的幻觉模式,为偏好学习提供更有针对性的负样本。
实验表明,C3PO 在五种代表性 MLRM 和多个幻觉评测基准上均取得一致改进,同时保持了模型原有的通用多模态能力。
论文标题: Seeing Through the Chain: Understanding and Mitigating Hallucinations in Multimodal Large Reasoning Models
机构单位: 清华大学,哈尔滨工业大学(深圳)
代码链接:https://github.com/ffhibnese/MLRM_Understanding_Mitigating_Hallucination
1. 问题背景
MLRM 与普通多模态大语言模型的一个关键区别,是它会先生成显式思维链,再给出最终答案。给定图像 与文本问题 ,模型首先生成推理链 ,随后在该推理链的条件下生成答案 :
这一生成过程意味着,CoT 不是附加在答案前的一段解释性文本,而是连接多模态输入与最终答案的中间表征。一旦错误视觉实体或不受图像支持的推断进入 CoT,它们就可能在后续生成中被不断强化,并最终影响答案。
已有幻觉缓解方法大多围绕最终响应开展训练或解码优化,但 MLRM 引入了一个新的问题:幻觉可能在答案生成之前,就已经写进了推理链。 如果只在输出端纠正答案,却不处理产生答案的推理过程,模型仍可能保留一条充满视觉错误的思考路径。
为理解这一现象,该研究从 MLRM 的注意力分配和 CoT—Answer 依赖关系入手,分析幻觉如何进入推理链,又如何影响最终答案。
2. 多模态推理模型为什么会产生更多幻觉?
2.1 推理让模型“看图更少、看文字更多”
研究团队在 MSCOCO 的 300 个样本上统计了模型对不同 token 类型的注意力分布。如下图左侧所示,相比非推理模型 Qwen2.5-VL,MM-Eureka 和 R1-Onevision 分配给视觉 token 的注意力明显更低,而生成文本所占的注意力进一步增加。

图 2:视觉注意力变化与 CoT 幻觉传播分析
换句话说,显式推理并没有自动促使模型更加细致地查看图像。CoT 越写越长,模型需要处理的文本上下文越多,视觉信号在整个生成过程中的相对权重也随之下降。
当视觉证据变弱后,模型更容易依赖语言先验完成推理。例如,“沙拉通常配叉子”“晴朗场景通常能看到太阳”“北极熊通常出现在冰川附近”等常识,都会在缺乏直接视觉依据时被错误地写入 CoT。
2.2 CoT 中的幻觉会传播到最终答案
随后,研究团队在 CHAIR 评测下将推理链和最终答案中的幻觉分开统计。图 2 右侧给出了两类条件下的结果:-H 表示 CoT 中存在幻觉,-NH 表示 CoT 无幻觉。
结果显示:
当 CoT 已经出现幻觉时,大部分最终答案也会包含幻觉;
当 CoT 不包含幻觉时,最终答案几乎总能保持无幻觉;
CoT 幻觉并非百分之百传播,但它显著提高了答案出错的概率。
中间推理链的质量由此成为答案可靠性的关键。缓解 MLRM 幻觉不能只停留在“把答案改对”,还要减少推理链中的低信息噪声,让模型真正偏好视觉忠实的推理轨迹。
3. C3PO:压缩并校正多模态思维链
上述观察构成了 C3PO 的直接动机。整体框架包含两个阶段:第一阶段通过 CoT Compression 学习更加紧凑的推理方式;第二阶段通过 Contrastive Preference Optimization 提升推理与答案的整体可靠性。
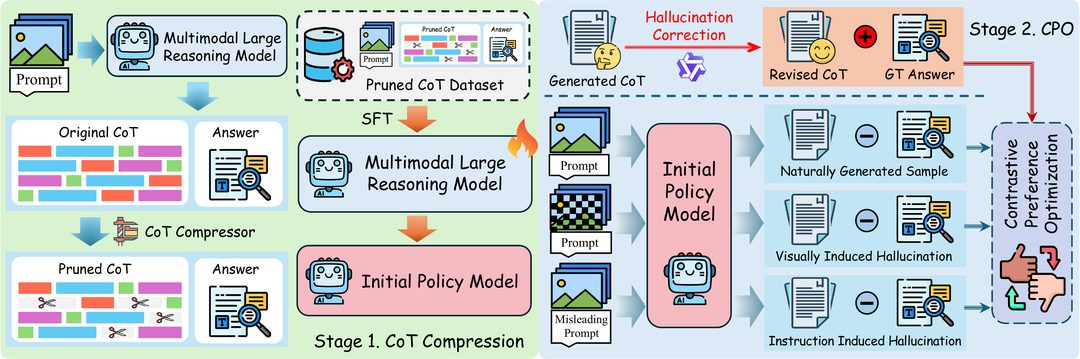
图 3:C3PO 整体框架
3.1 阶段一:CoT Compression
前面的注意力分析表明,MLRM 的长 CoT 中包含大量低信息文本。这些 token 不仅增加推理成本,还可能持续稀释视觉信息。C3PO 因此首先对模型自身生成的推理链进行选择性压缩。
对于每个图像—问题对 ,目标 MLRM 先生成原始推理链 和答案 。LLMlingua-2 随后为每个推理 token 计算重要性分数,并保留分数最高的 比例,得到压缩后的推理链:
默认设置为 ,即保留 90% 的 token、删除约 10% 的低重要性内容。这里的目标并不是让模型“越短越好”,而是删除对最终预测贡献有限的功能词、过渡词和重复表达,同时保留对象、属性、场景关系等关键视觉信息。
压缩后的 与原始答案 被用于 LoRA-SFT。这个阶段不依赖额外答案标注,也没有向模型注入新的外部知识,只是重新组织模型自身的推理轨迹,让它学习生成信息密度更高的 CoT。
3.2 阶段二:构造高质量正样本
压缩主要解决“推理太冗余”的问题,但无法保证保留下来的内容一定正确。第二阶段进一步引入 AI Feedback,对推理链中的视觉错误进行检测和修订。
具体来说,Qwen3-VL-30B-Instruct 会同时接收图像 、问题 、模型生成的 CoT 和真实答案 。教师模型以句子为单位识别 CoT 中不受图像支持的内容,并进行尽可能小的修改,得到修订后的推理链 。
最终, 与真实答案 共同构成偏好样本。这样的正样本既保留目标模型原有的表达方式,又纠正了其中的视觉事实错误。
3.3 从模型的“错误习惯”中构造困难负样本
稳定生成完全无幻觉的响应并不容易,但诱导模型产生幻觉却相对简单。C3PO 利用这一特点,主动暴露模型内在的失败模式,并将其转化为偏好优化中的负样本。
每个训练样本包含三类拒绝响应:
自然生成负样本。 使用初始策略模型直接生成 ,捕获模型在正常输入下自然出现的错误。
视觉诱导负样本。 随机遮挡 30% 的视觉 token,削弱真实视觉证据,迫使模型更多依赖语言先验,得到 。
指令诱导负样本。 在提示中要求模型优先使用语言先验、必要时忽略图像,从而生成看似连贯但缺乏视觉依据的 。
相比随机生成错误答案,这两种诱导机制更接近模型真实的幻觉方式。模型学到的不只是“哪个答案错了”,还包括视觉证据不足或语言先验过强时,一条推理链会怎样逐步走向错误。
3.4 推理增强的对比偏好优化
C3PO 使用三组互补目标完成第二阶段训练。
推理偏好损失 直接比较修订后的可靠 CoT 与三类低质量 CoT,使模型优先生成视觉忠实的推理轨迹:
联合响应损失 进一步在“CoT+Answer”的完整输出上进行偏好优化。这样既能提升推理质量,也能维持输出格式和最终答案的一致性。
锚定损失 约束正样本的奖励,避免标准 DPO 只改善正负样本的相对差距,却同时降低正样本自身的生成概率。
最终目标为:
因此,C3PO 的训练信号同时覆盖推理链本身和完整响应:前者负责把视觉错误挡在答案生成之前,后者保证模型最终给出结构完整、事实一致的回答。
3.5 信息瓶颈视角
论文还从信息瓶颈(Information Bottleneck,IB)视角解释了 C3PO。将输入记为 、真实答案记为 、推理链记为 ,CoT 可以被视为输入与答案之间的中间表征。理想的推理链应当压缩输入中的冗余信息,同时保留与正确答案相关的内容:
其中,减小 对应删除冗余内容,增大 对应保留能够支持正确答案的视觉线索。论文进一步从两个阶段分别给出理论解释。
对于 CoT 压缩, 将原始推理链分解为保留的关键部分 与被裁剪的冗余部分 。由互信息的链式法则:
由于被裁剪部分可以包含与输入相关的冗余信息,却不贡献于真实答案,即 、,因此有:
对于推理增强, 优化后的推理链 更贴近真实答案,因此 ,从而 ;同时,补充进 的信息来自 ,使得 。在 时可得:
这一视角也给出了 C3PO 两个阶段之间的关系:压缩负责去除噪声,偏好优化负责补强与正确答案有关的信号。
4. 实验结果
实验从 RLAIF-V 中随机采样 20K 个图像—问题对进行训练,并在五种代表性 7B MLRM 上验证 C3PO:R1-Onevision、Orsta-R1、MM-Eureka、MM-R1 和 ThinkLite。
评测覆盖四类幻觉基准:
CHAIR: 评估开放式图像描述中的对象幻觉;
POPE: 通过随机、热门和对抗三类 Yes/No 问题检测对象存在性幻觉;
AMBER: 评估对象存在、属性和关系等多维幻觉;
GPT-4 Assisted Evaluation: 检测更加细粒度的句子级幻觉。
4.1 CHAIR:在五种 MLRM 上一致降低对象幻觉
下表给出了 CHAIR 结果,其中 和 越低越好。
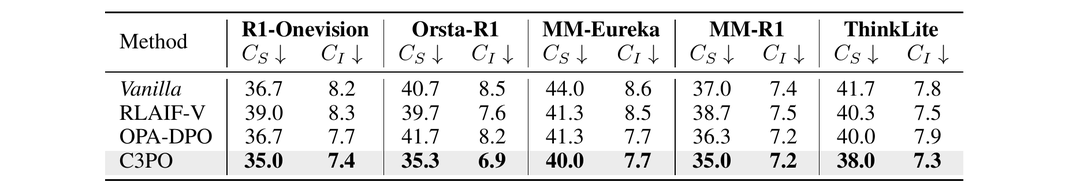
表 1:CHAIR 基准上的性能对比
C3PO 在五种模型上均取得最优或并列最优结果。以 Orsta-R1 为例, 从 40.7 降低到 35.3, 从 8.5 降低到 6.9,相对降幅分别达到 13.27% 和 18.82%。
相比之下,将面向普通 MLLM 的方法直接迁移到推理模型并不稳定。例如,RLAIF-V 在 R1-Onevision 上使 从 36.7 上升到 39.0,OPA-DPO 在 Orsta-R1 上也出现退化。这些波动反映出,MLRM 的幻觉缓解需要把中间推理过程纳入训练目标。
4.2 POPE 与 AMBER:提升不同类型的视觉事实判断
在 POPE 的 Random、Popular 和 Adversarial 三种设置下,C3PO 同样取得一致改进。
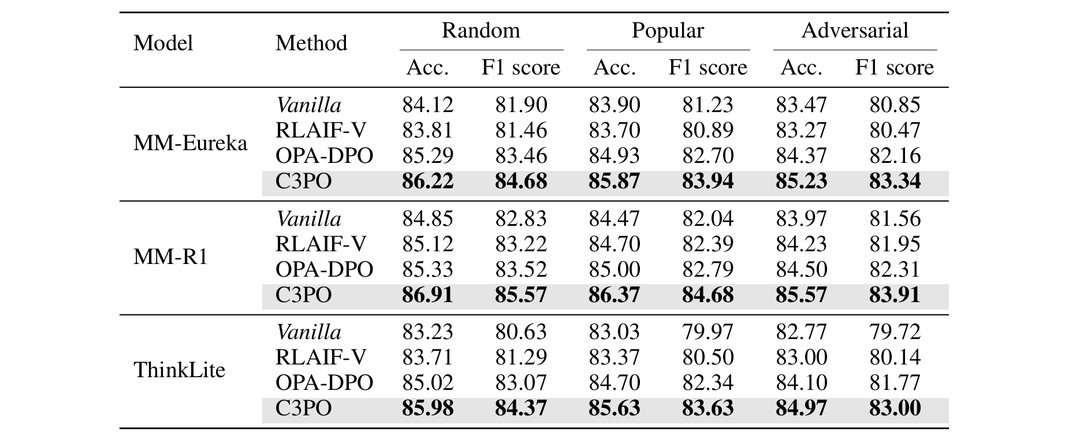
表 2:POPE 基准上的性能对比
AMBER 进一步覆盖存在、属性和关系幻觉。在五种 MLRM 上,C3PO 的 Accuracy 和 F1 均优于 Vanilla。
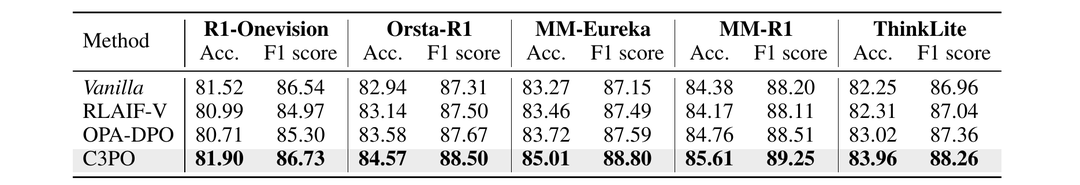
表 3:AMBER 基准上的性能对比
例如,MM-Eureka 的 Accuracy/F1 从 83.27/87.15 提升至 85.01/88.80,MM-R1 则从 84.38/88.20 提升至 85.61/89.25。
这些结果表明,C3PO 的收益并不限于开放式描述中的对象名称,而是能够延伸到更加细粒度的视觉事实判断。
4.3 细粒度幻觉:更可靠,同时保留回答细节
GPT-4 Assisted Evaluation 使用 Sentence-level Hallucination Ratio(SHR)衡量句子级幻觉,同时通过 SPI、WPI 以及 1-gram、2-gram 衡量回答的细节和多样性。
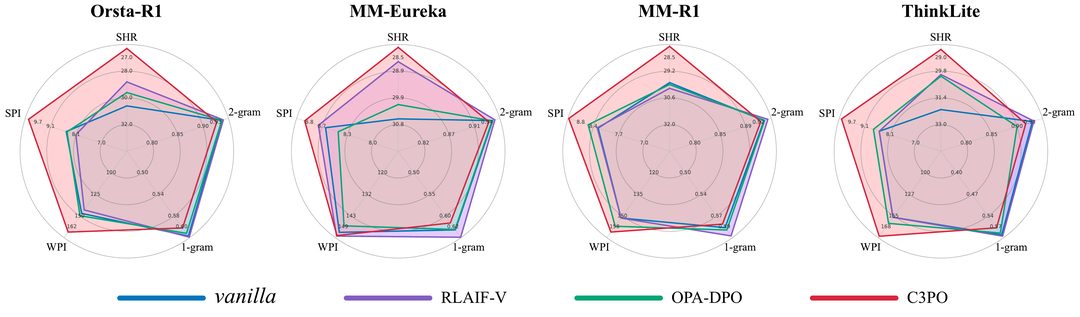
图 4:GPT-4 辅助评测结果
C3PO 在四种模型上均减少了细粒度幻觉。以 Orsta-R1 为例,SHR 相比 Vanilla 相对降低 14.05%。与此同时,WPI 和 SPI 并未因 CoT 压缩而下降,部分设置下反而提高。
换言之,C3PO 学到的并不是简单地“少说话”。被删掉的是缺乏视觉依据的推理冗余,而不是回答中有用的细节。
5. 总结与思考
这项研究从中间推理链的视角重新审视了 MLRM 的幻觉问题。分析表明,显式推理会增加文本上下文占比,使模型减少对视觉 token 的关注;一旦 CoT 中出现不受图像支持的内容,幻觉又很容易沿自回归生成过程传播到最终答案。
为此,C3PO 将幻觉缓解前移到推理过程本身。CoT Compression 删除低信息 token,使中间表征更加紧凑;AI Feedback 用于修订推理链并构造视觉忠实的正样本;视觉遮挡和误导指令则诱导模型暴露自身的幻觉模式,产生更具针对性的负样本。在此基础上,推理偏好、联合响应偏好和锚定目标共同约束 CoT 与最终答案。
五种 MLRM 和多类幻觉基准上的结果共同指向一个结论:更可靠的多模态推理并不等同于更长的推理。每一步思考是否保留了足够的视觉证据,比单纯延长思维链更重要。
沿着这一方向,固定比例的 token 剪枝还可以扩展为自适应压缩或长度奖励,正样本修订也可以交给更专门的幻觉纠错器,或由多个智能体协同完成。随着 MLRM 开始承担更复杂的视觉决策任务,模型不仅要“会推理”,还要始终“依据图像推理”。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。