NeurIPS 2026 Oral | 西安交大提出BaryBind:基于Wasserstein重心与单形体积对齐破解多模态偏置
原创 CV君 2026-10-07 23:55 江苏
重心对齐破解模态偏置
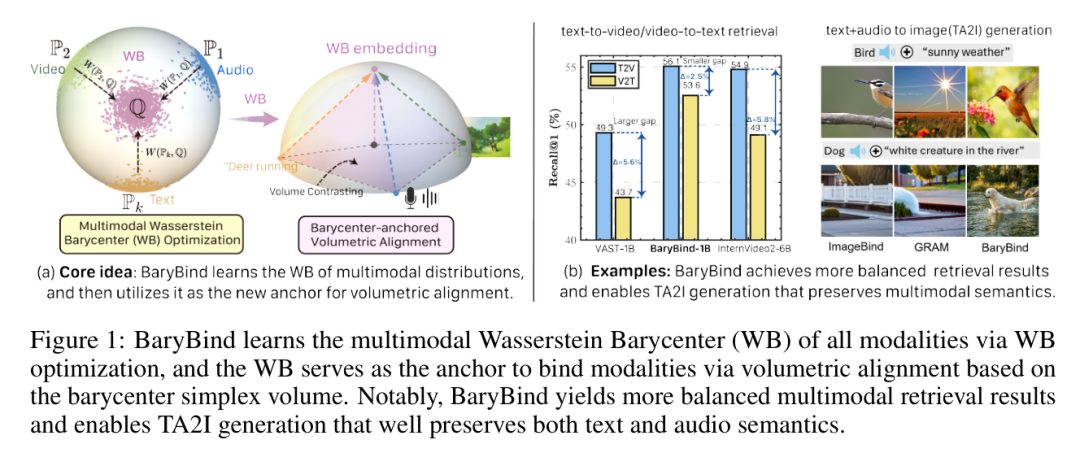
在三模态及以上的多模态对齐中,不同传感器如同“盲人摸象”,所捕捉的视觉、语言、音频本质上皆是现实世界的侧影。然而,ImageBind、VAST 等传统方案强行钦定文本或图像为“绝对中心锚点”,导致表征空间被强势模态支配,更酿成了严重的双向检索不对称(如正反向召回率差距悬殊)。
针对这一痛点,西安交通大学团队打造了全新框架 BaryBind——跳脱单一模态的“引力霸权”,依托最优传输理论求解各模态分布的几何中心:多模态 Wasserstein 重心(Wasserstein Barycenter, WB),并借由高维重心单形体积实现全局紧凑对齐。这一无偏设计收效显著:在 MSR-VTT 跨模态检索中,双向性能剪刀差被大幅缩窄 3.1%(差距降至仅 2.5%);在 VGGSound5K 音视联合分类中,Top-1 准确率跃升至 55.6%(超 baseline 达 7.5%),以坚实的数学理论真正重塑了多模态空间的平衡与协同。
该研究成果已被 NeurIPS 2026 接收为 Oral 报告,相关代码已在 GitHub 开源。
背景与动机:打破中心模态的“引力霸权”
在传统的对比学习框架(如 InfoNCE、BYOL)中,对齐目标大多针对 的模态对展开。当拓展到视频、音频、文本、深度等更多模态时,两两配对对齐的计算复杂度会呈组合级增长。为了缓解这一问题,近期的代表性工作(如 VAST、GRAM、Triangle 等)倾向于指定某一中心模态(例如文本),并让其他所有模态向该中心模态看齐。
然而,这种人工指定的锚点在几何表征空间内构成了强烈的先验偏置。由于优势模态在语义密度和先验结构上的不对称性,非锚点模态往往被迫扭曲自身的几何流形以迎合锚点,造成次优且失衡的表征分布。这一现象直接体现在检索任务的“方向性鸿沟”上:模型在文本检索视频(T2V)与视频检索文本(V2T)时往往表现出悬殊的性能差距(如图 1b 所示,VAST 在两项任务上的 R@1 差距达 5.6%)。
多模态表征理应编码出跨模态的“语义共识”(Semantic Consensus)。在统计与度量几何学中,Wasserstein 重心正是寻找一个与已知多个概率分布的平均 Wasserstein 距离最小的中心测度。因此,借助最优传输对偶理论求解 WB,使其作为所有模态自然汇聚的几何中心,成为了破除单一模态偏置的可行路径。
方法详解:WB 对偶求解与重心单形体积对齐
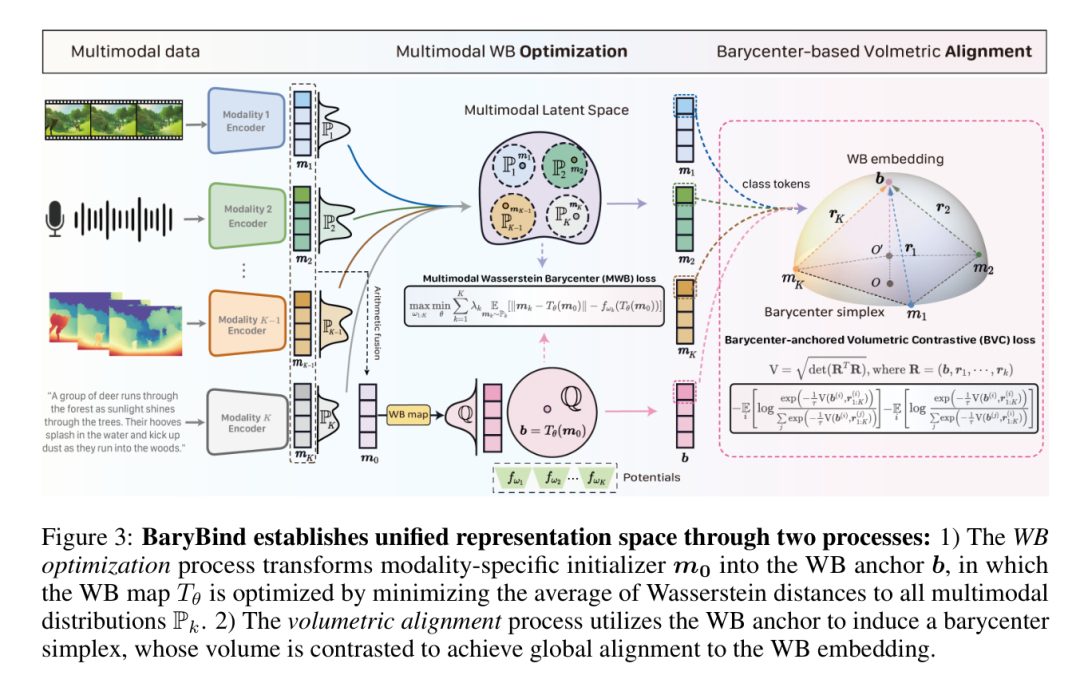
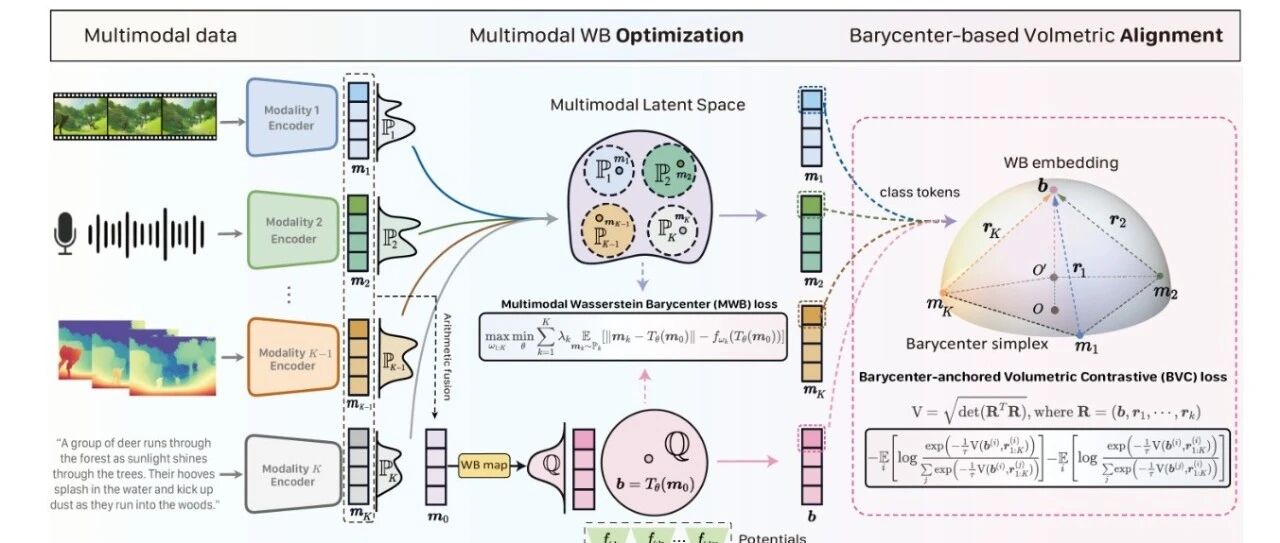
BaryBind 的整体架构分为两大核心阶段(如图 3 所示):
多模态 Wasserstein 重心(MWB)优化:将特定模态初始化向量平移映射为无偏的 WB 锚点 ;
重心锚定体积对比(BVC)对齐:以 WB 锚点为极点构建多维重心单形,并以其高维几何体积作为全局多模态对齐的相似性度量。
1. 多模态 Wasserstein 重心(MWB)对偶求解
设多模态潜空间中共有 个模态,编码特征记为 ,其边际概率分布记为 。记重心空间为 ,其对应的概率分布为 。多模态 WB 的原生极小化目标为:
其中 为模态重要性权重,满足 。直接在测度空间对上述目标进行变分优化极度困难。研究人员给出了其对偶形式的重构表达(Proposition 3.1):
其中 为连续势函数(Potentials)。
为了在神经网络中有效执行该过程,BaryBind 引入了一个轻量级 MLP 参数化映射网络 ,直接从初始特征 (实践中可取全模态均值或特定模态输入)生成重心嵌入 。为了严格满足一致性零和约束(Congruence Constraint: ),每个模态的势函数 采用两层 MLP 并进行中心化消除:。
最终的 MWB 损失函数 写为鞍点极大极小化问题:
在训练中,势函数权重 采用梯度上升更新,而映射网络参数 与模态编码器采用梯度下降联合优化。理论推导(Theorem 3.2)进一步证明,在强凸性假设下,估计测度 与真实重心测度 之间的二阶 Wasserstein 距离严格受优化对偶间隙(Duality Gaps)的上界约束。
2. 重心锚定体积对比(BVC)对齐
在获得当前批次样本的 WB 锚点 后,模型需要将各模态向量 向 聚拢,同时保持 个模态之间的协同几何结构。
BaryBind 提出了以 WB 向量 (原点到重心)为极点(Apex),并以模态到重心的差异向量 ()为边张成的 重心单形(Barycenter Simplex)。定义由这些张成向量组成的矩阵 ,该单形体积的平方由 Gram 行列式直接算出:
在向量单位归一化条件下,对于三模态情况(),体积展开式严格受各模态与重心的偏角正弦项()以及不同模态差异向量之间的相对夹角()支配。当所有模态向重心高度靠拢且模态间偏差一致时,单形体积趋近于 0;而当各向量相互离散或正交时,体积急剧膨胀。
基于此几何性质,研究团队构建了 BVC 损失函数:对于同一实体的配对多模态样本,将其 作为正样本对(拉小单形体积),而在批次内打乱负样本构造伪单形(推大负样本体积),形成对称化的对比目标:
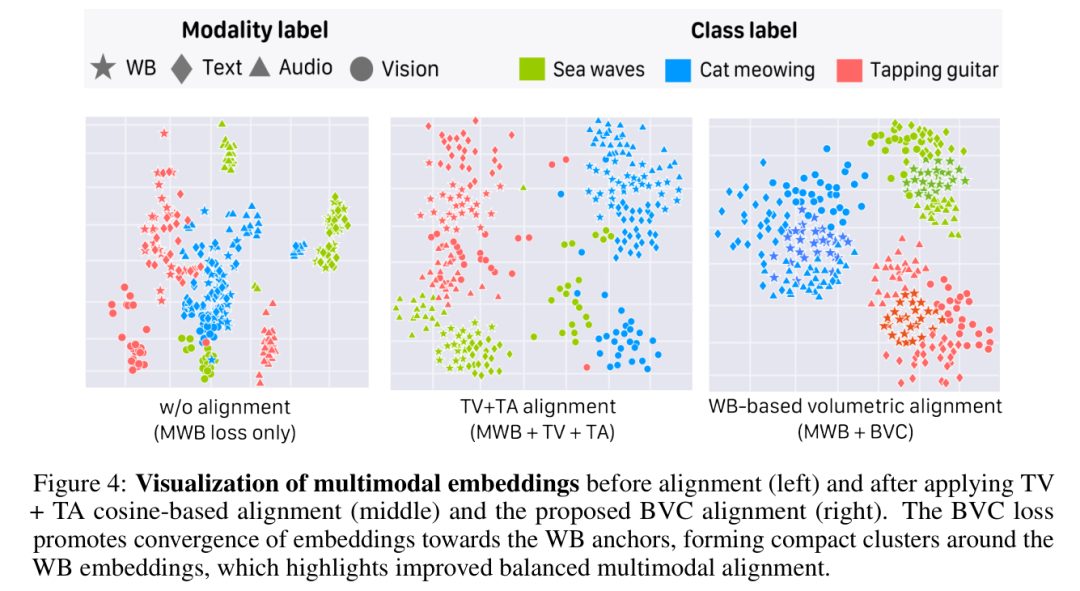
结合用于区分细粒度实例匹配的数据-锚点匹配损失(),整体训练目标整合为 。如图 4 所示,相比未对齐前的杂乱分布与余弦对比学习下的明显模态分层,BVC 损失驱使同一类别的不同模态特征高度汇聚在类属的 WB 嵌入周围。
实验与结果:多维任务下的均衡性与鲁棒性验证
BaryBind 以 VAST 为基础框架,采用 BERT-B 作为文本编码器、BEATs 作为音频编码器、EVA-CLIP-ViT-G 作为视觉编码器,总参数量约为 1.34B。训练在 2 张 NVIDIA A100 80GB GPU 上基于 150k 图文音子集展开继续预训练。
1. 零样本跨模态分类与检索
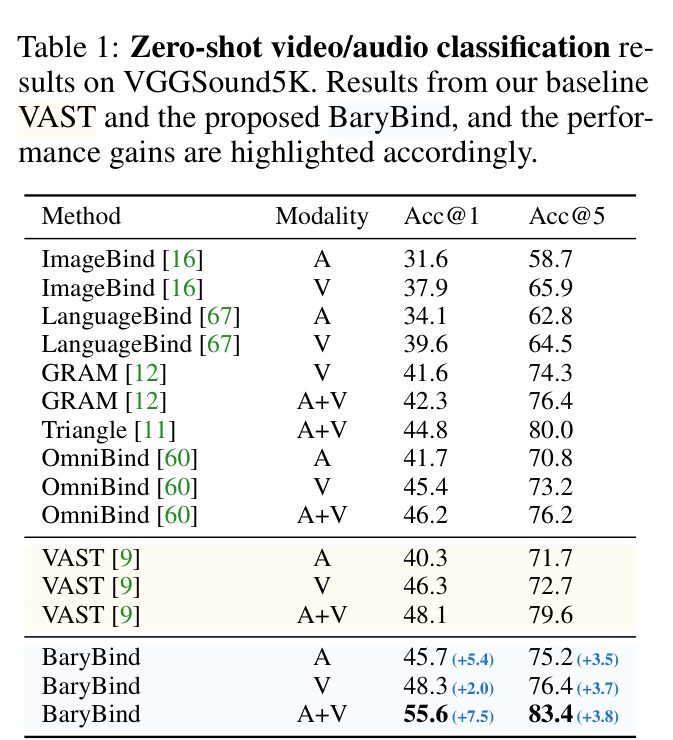
在音频-视频事件分类基准 VGGSound5K 上(表 1),BaryBind 在单模态与多模态组合输入下均取得了优异成绩:
在纯音频(A)分类中,Top-1 准确率达到 45.7%,相较 baseline(VAST 40.3%)大幅提升了 5.4 个百分点;
当音频与视频联合推理(A+V)时,Top-1 准确率攀升至 55.6%(超越 VAST 的 48.1% 以及 Triangle 的 44.8%),体现出跨模态信息的高度互补与无偏利用。
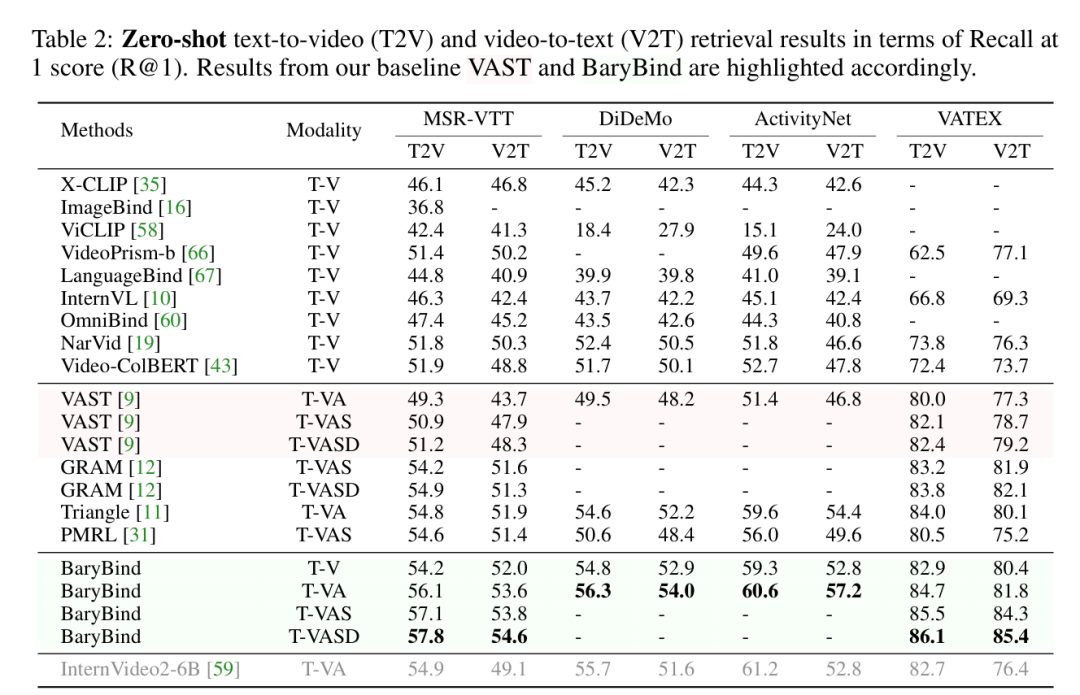
在跨模态视频检索基准(表 2)中,BaryBind 在 MSR-VTT、DiDeMo、ActivityNet、VATEX 等数据集上全面刷新了零样本召回指标。更关键的是,检索对称性得到了显著改善:在 MSR-VTT(T-VA 设定)下,T2V 与 V2T 的 R@1 达到 56.1% 与 53.6%,两者差距仅为 2.5%,而基线模型 VAST 的差距高达 5.6%,缩窄了 3.1 个百分点。
2. 模态缺失下的优雅降级
实际应用场景中常出现传感器缺失或数据不全的问题。研究团队设计了两组严格的缺失测试:
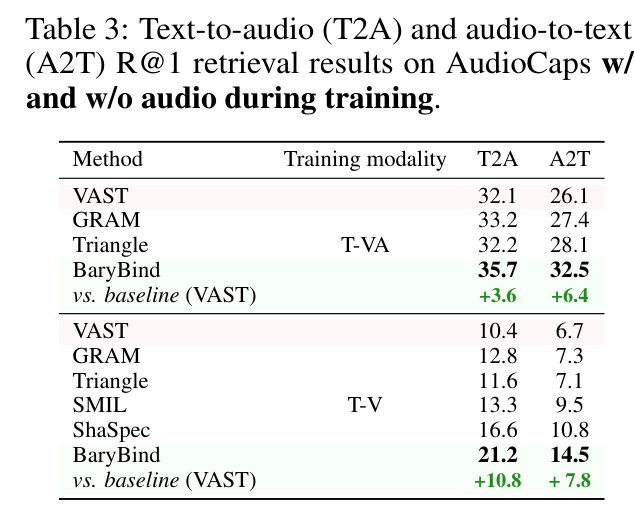
训练期缺失音频(表 3,AudioCaps):当模型在缺乏音频配对监督的情况下进行跨模态检索时,BaryBind 的 T2A 和 A2T R@1 分别达到 21.2% 和 14.5%,超越基线达 +10.8% / +7.8%,展现出由其余模态推导出的 WB 表征具备优异的代理迁移能力。
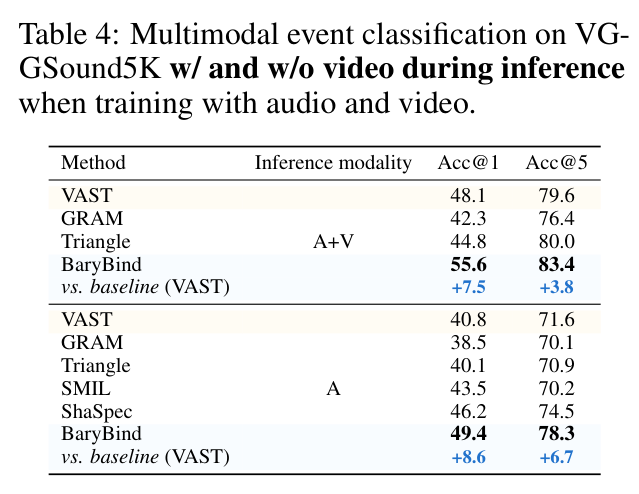
推理期缺失视频(表 4,VGGSound5K):双模态训练后,若测试阶段仅输入音频,BaryBind 依然保持了 49.4% 的 Top-1 准确率,相较 VAST 提升了 8.6 个百分点。
3. 训练动力学与高模态拓展
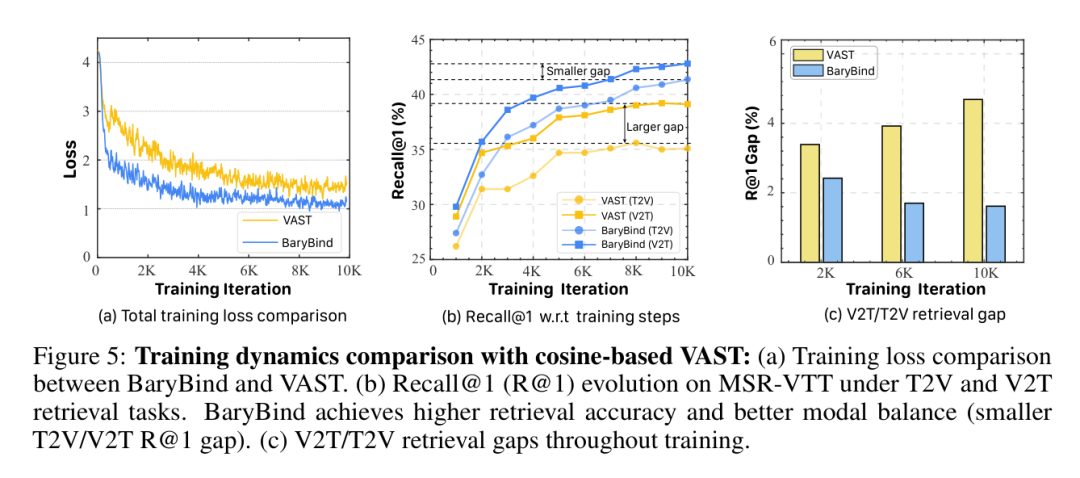
监控训练过程(图 5)可见,BaryBind 的总损失下降更迅速平缓(图 5a),且从初期到收敛,V2T 与 T2V 的性能差距均平稳收窄并保持在极低水平(图 5c)。
此外,随着输入模态由 2 个逐步增加至 5 个(文本、视频、音频、字幕、深度),BaryBind 的检索指标呈现单调上升(在 VATEX 上 T-VASD R@1 达到 86.1%)。实测表明,在 下计算 5 模态单形体积仅耗时 秒,随模态数增长的计算开销极低。
写在最后
多模态系统向三维视觉、听觉、具身感知等多源异构信号延伸已是必然趋势。BaryBind 摆脱了过去以文本或图像为单一锚点的直觉设计,将数学上严格的最优传输理论与度量几何引入多模态表征,构建了以 Wasserstein 重心为支点、以高维单形体积为约束的表征空间。这种架构不仅缓解了长期困扰检索任务的模态偏置问题,也为复杂多传感器融合系统在非完备观测下的稳健落地提供了有价值的方法参考。
论文标题: Binding Multiple Modalities via Multimodal Wasserstein Barycenter
录用情况: NeurIPS 2026 Oral
主要机构: 西安交通大学
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。