过程驾驭的系统复杂性天花板:冷静看待面向复杂软件开发的智能体工程进展
原创 彭鑫 2026-10-09 11:55 上海
当智能体能够连续工作几百小时甚至更长,就可以实现“人在环外”的复杂软件开发吗?
导读
从代码补全、对话式编程到端到端应用开发,再到驾驭工程、循环工程,AI 介入软件开发的程度一路加深,“智能体可以连续工作几百小时、人慢慢站到循环之外”成为流行叙事。但这一叙事只强化了“过程维度”——智能体在开发过程中干得久、不崩溃、能自我改进;而被开发软件自身的系统复杂性——“对象维度”——并不会因此消失,二者相对正交。需要说明的是,本文讨论的是基于智能体的软件开发过程(被开发的可能仍是传统软件),而非智能体进入运行态软件之后的架构变革。本文借“行路于疆域”的类比回答:为什么驾驭工程解决不了复杂软件的系统复杂性,人又应当以何种方式、在什么抽象层次上留在开发的环内。
一、两种“驾驭”:行路的能力,与疆域的地形
过去两年,AI 介入软件开发的程度,沿着一条清晰的路径快速加深。最早,GitHub Copilot 这样的工具只在光标处做语句和函数补全,人仍是唯一的开发者;随后,Cursor、Claude Code 等工具开始理解整个代码库,能够操作文件系统与终端,以对话方式与开发者共同完成任务;再往后,MetaGPT、Devin、v0、Lovable 一类系统尝试端到端地承接一个应用的开发,从需求描述一路走到可运行的产品。进入2026年,驾驭工程(Harness Engineering)、循环工程(Loop Engineering)成为显学:人们系统地为智能体配备工具、权限、沙箱、状态管理和自动反馈闭环,试图让它能够长时间、不间断地承担开发与维护任务。
与这条路径相伴的,是一种日益流行的乐观:智能体已经可以连续工作几百小时甚至更久,独立完成复杂软件的开发与维护;开发者要做的,只是提出目标、偶尔验收,然后慢慢“站到循环之外”。在一些描绘里,未来的软件生产将高度自动——人描述想要什么,智能体在循环里反复执行、验证、修正,直到把软件交付出来。
在展开之前,有必要先澄清一个容易混淆的前提:本文关注的是软件开发过程的智能化(即AI4SE),而不是软件运行态的智能化(即SE4AI)。被智能体开发出来的软件,本身完全可能仍是传统软件——它在运行时并没有智能体驻留,架构也未必因 AI 而改变;真正发生变化的,是“它怎么被造出来、怎么被维护”这一侧。这与“智能体直接进入运行态软件、重塑软件自身架构”是两件性质不同的事,后者是我前两天写的另一篇文章《驾驭工程之外:从 "岗位" 到 "组织" 的智能化系统架构》的主题。即便把焦点严格限定在开发过程,我仍然认为当前讨论存在一个盲区:无论是驾驭工程还是循环工程,它们的中心始终是智能体,回答的是“智能体怎么干活、干得久不久、稳不稳、能不能自我改进”;而一个同样关键、却常被略过的问题是——被开发的软件自身是什么、有多复杂。开发过程可以高度自动,但开发对象的系统复杂性,并不会因此自动消失。
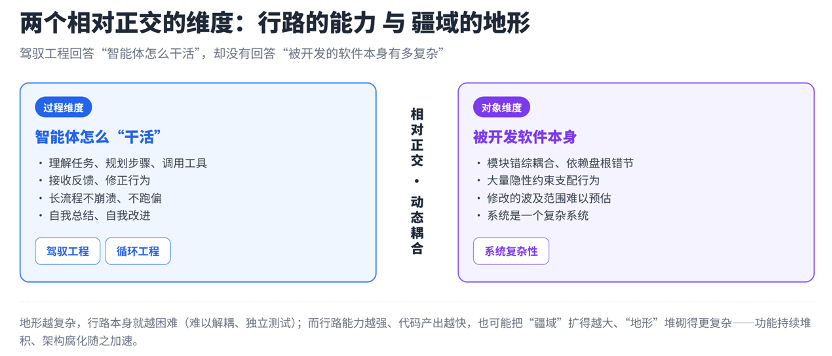
要把这层意思说清楚,不妨借一个朴素的类比:智能体在做的事,像在一片疆域里行路;而驾驭工程打磨的,是行路的能力。
行路的能力,是“过程维度”。 能不能认准方向、合理分配体力、走得久、不停下、走偏了能自我纠偏,甚至走过一遍之后还能总结步法、越走越熟。驾驭工程和循环工程解决的正是这个维度——它们的着眼点是“干得久、干得稳、干完还能自我修正”。在这个维度上,智能体的进步是实打实的:从最初几步就迷路,到能够连续推进成百上千个动作而不崩溃,再到利用历史轨迹自动复盘、改进策略。
疆域的地形,是“对象维度”。 山有多高、谷有多深、路径如何缠绕、哪些地方根本没有路、天气如何变幻。对软件开发而言,这就是被开发软件自身的系统复杂性——模块错综耦合、依赖盘根错节、行为受大量隐性约束支配、修改的波及范围难以预估。我在此前的文章中反复强调过,这种系统复杂性,是企业软件开发特别是理解AI辅助开发能力高低和作用范围的“第一性原理问题”:它不是靠把代码写快、写多就能绕过去的,而是被开发对象的客观属性。
需要特别说明的是,这两个维度是相对正交的,而不是绝对正交。说“相对正交”,是因为它们刻画的确实是两个方面的问题:一个是过程,一个是对象,各自有独立的规律;但二者又始终相互牵动,不可能完全割裂。
这种牵动是双向的。一方面,地形越复杂,行路本身就越困难——一个高度耦合的系统,连让智能体把它解耦、对它做独立测试都很难做到,因为模块之间拆不开、测不了,反馈信号本身就生产不出来。另一方面,行路能力越强、代码产出越快,也可能把“疆域”扩得越大、“地形”堆砌得更复杂:AI 辅助开发让代码产出速度大幅提升,新功能、新模块不断堆积,却常常伴随架构腐化,使系统的范围与复杂性同步膨胀。去年底Adobe 首席科学家David Sankel在上海的一次公开分享中提到,他们的内部统计表明,采用 AI 辅助开发之后,包含重复代码的代码提交(Commit)比例直线上升;某互联网公司业务部门的测试团队也反馈,研发的代码产出速度达到过去的几十倍,但质量保障压力剧增,在“无脑”提交的 AI 生成代码中已经发现了严重的质量问题。这些都是“行路能力增强、疆域随之扩张、地形堆砌得更复杂”的注脚。
驾驭工程和循环工程是有价值的,这个价值不应被否定。但它们解决的是行路的持久性问题,而不是地形的复杂性问题。把前者误认为后者,以为智能体在过程维度上足够坚韧,就等于它能征服任意复杂的软件,正是当前许多讨论的偏差所在。
二、可驾驭性:一条由地形决定的上限
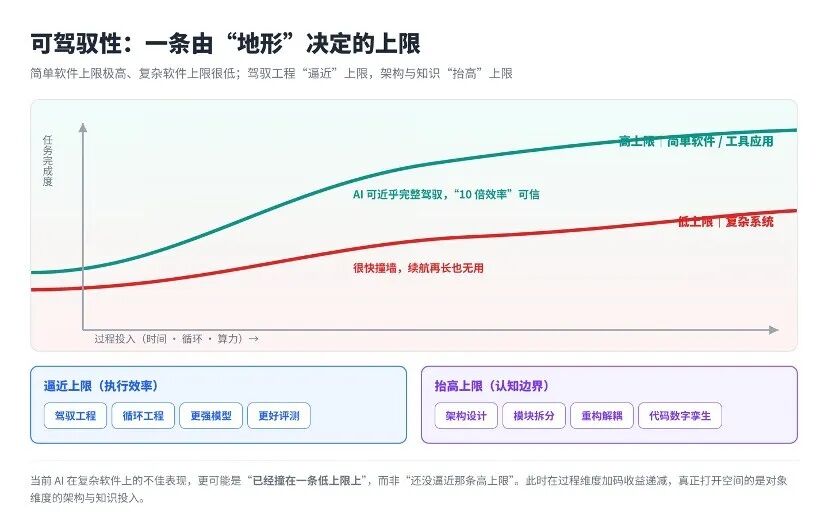
一个开发任务能够在多大程度上被驾驭工程解决,并不取决于驾驭策略本身有多精巧,而在更大程度上取决于两件事:对象本身的复杂性,以及人对于它的理解和洞察的完整性与深度。这种特性可以被称之为可驾驭性(Harnessability)——它是任何智能体在给定任务上的能力上限。
这个词并非我的杜撰。Birgitta Böckeler 在 Martin Fowler 网站上的驾驭工程长文中就指出,并非所有代码库都同样适合被驾驭:强类型语言天然提供类型检查作为传感器,清晰可定义的模块边界支持架构约束规则,像 Spring 这样的框架通过抽象屏蔽了智能体不需要关心的底层细节。她把这些称为“环境可供性(Ambient Affordances)”——开发环境中那些使其对智能体而言可理解、可导航、可操控的结构性属性。换句话说,智能体之所以能在一个环境里自主探索、根据反馈不断迭代直至达成目标,前提是这个环境本身被构建得“可供驾驭”。
由此,所有的技术投入可以被清晰地区分为两类,而这两类投入的方向根本不同。
一类是逼近上限的技术:驾驭工程、循环工程、更强的模型、更好的评测反馈。它们的进步,是在同一根上限曲线下面做文章——让智能体在“已经被理解和掌控的范围”里跑得更快、更远、更稳。这是一种“执行效率”的提升:上限没有变,但智能体抵达上限的速度更快了。
另一类是抬高上限的技术:人的架构设计、模块拆分、重构解耦、技术债清理,以及以代码数字孪生为代表的软件开发知识沉淀(详见我们此前的观点文章《敬畏与驾驭:系统复杂性视角下的软件智能化研发体系演进》)。它们提升的是“这个系统能被理解和掌控到什么程度”——把上限曲线本身往上抬。这是一种“认知边界”的拓展:让原本不可驾驭的部分,变得可以被驾驭。
这个区分能解释很多看似矛盾的现象。为什么“10 倍效率”在简单软件上是真的,在复杂软件上却失效?因为软件的频谱非常宽广:一个典型的个人项目可能只有几百到几千行代码、涉及一两个技术栈,而一个大型企业软件系统可能包含数千万行代码、数百个微服务、涉及十几种技术栈和几十个团队,二者之间的复杂度差异可能跨越三到四个数量级,堪比自行车与航天飞机之间的距离。简单软件的可驾驭性上限本来就极高,AI 逼近上限的速度提升当然立竿见影;而复杂软件的上限很低,智能体逼近到一定程度就会撞墙——不是它不够努力,而是墙的高度由对象复杂性与人的认知深度决定,与它的续航无关。
这也提醒我们重新判断当前 AI 的真实处境:它在复杂软件上的不佳表现,更可能是“已经撞在一条低上限上”,而不是“还没逼近到那条高上限”。如果这个判断成立,那么单纯在过程维度继续加码——让智能体工作更久、循环更多、自愈更强——收益会迅速递减,因为它早已抵达了当前地形允许的边界;真正能打开空间的,是对象维度的架构与知识投入,也就是去抬高那条上限。
值得玩味的是,软件生成过程的可驾驭性,还与“软件验证与确认的直观性、可自动化程度”密切相关。如果我们能自动生成大量高质量测试,或者很容易从用户视角发现软件问题,就能及时、全面地为生成过程提供反馈:从 A 语言到 B 语言的软件翻译,可以用 A 语言版本的运行结果作为 B 语言版本的测试依据;编译器软件可以自动合成大量程序用于测试;扁平化的业务软件或个人应用,可以很容易地通过用户视角充分暴露问题。这些场景的上限之所以高,恰恰是因为反馈信号容易获得;而那些反馈信号难以生产的场景——深层业务逻辑、跨模块的隐性约束——上限天然就低。这再次说明:上限首先是对象与环境的属性,然后才是智能体的问题。
三、被视而不见的“修路”:OpenAI 实验的真正前提
值得回味的是,最常被用来佐证“智能体无所不能”的那个实验——OpenAI 的百万行代码开发实验——恰恰隐含着对对象维度的深度依赖。把它拆开看,反而能成为“可驾驭性是架构属性”最有力的证据。
根据公开信息,2026 年初 OpenAI 公布了这项内部实验:一支最初仅 3 人(后扩展到 7 人)的工程师团队,从 2025 年 8 月开始,利用自家的 Codex 智能体,从一个空仓库起步,在 5 个月内交付了一个包含超过 100 万行代码的完整 Beta 版产品,累计产生约 1500 个合并的 Pull Request,最初 3 人平均每人每天提交 3.5 个 PR,效率据估计约为传统方式的 10 倍,全程没有一行代码由人手编写。当某处代码出了问题,团队的应对方式不是“让我来手动修一下”,而是“智能体缺少什么能力,我们如何让它能够理解并执行这个修复”。
这个实验之所以能跑通,有三个常常被忽略的前提,而它们全部属于对象维度的“修路”工作。
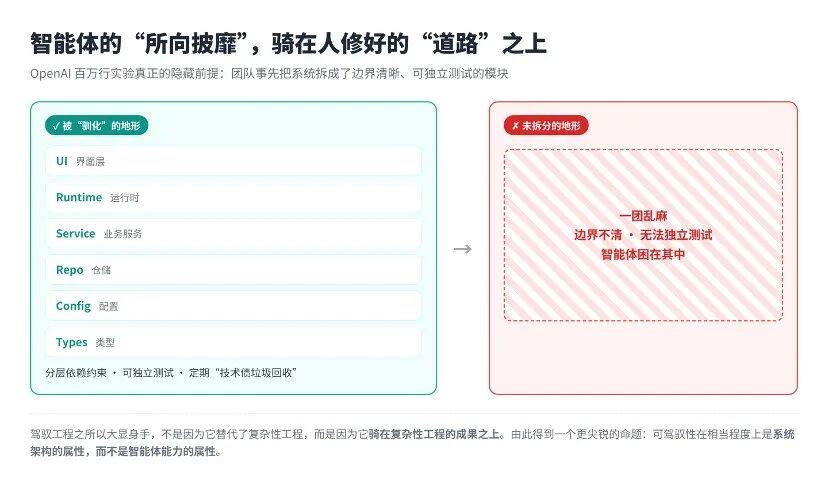
前提之一,是极细粒度的模块拆分。 领导该实验的 Ryan Lopopolo 在后续访谈中谈到:“我们的仓库大概拆成了 500 个 npm package,这对于一个 7 人团队而言是严重过度设计的,但如果你把每个人看成 10 到 50 个 Agent,那就合理了——这时候深度拆分、模块隔离、接口边界就变得非常重要。”换言之,系统被事先切成了大量边界清晰、可以独立开发和测试的小模块,智能体因此能够以相对独立的方式完成每一块。
前提之二,是强制执行的分层依赖约束。 团队通过定制化的代码检查工具和结构测试,强制分层架构遵循 Types → Config → Repo → Service → Runtime → UI 的依赖方向,不允许越层调用。这正是分层架构与依赖倒置原则的机械化落地——它把“正确的结构”变成了可自动检查、不可违反的硬约束。
前提之三,是定期的“技术债务垃圾回收”。 团队把“黄金原则”编码进代码仓库,构建自动化的后台 Codex 任务持续扫描违规,并开出定向的重构 PR,定期清理技术债。这使得系统在高速产出的同时,结构不至于持续劣化——相当于有人持续地“维护地形”,不让它退化成一团乱麻。
看清楚这三个前提,就能明白:系统的复杂性被人的架构能力事先大幅“驯化”了——边界清晰、依赖受控、可以独立测试、债务持续清理。驾驭工程之所以能大显身手,不是因为它替代了复杂性工程,而是因为它骑在了复杂性工程的成果之上。如果模块拆分不做、或者做得不好,实验效果不会那么好。这个细节,AI 视角的专家们基本上视而不见。
还需要注意一个容易被忽略的背景:这是一个从零开始的全新项目(Greenfield),不存在遗留代码和历史包袱。而对于绝大多数企业的真实开发场景而言,大量任务都是基于遗留系统的持续、增量开发,此时要持续保持松耦合、高可扩展性,难度远高于在白纸上画最新最美的图画。
由此可以得出一个比“正交”更尖锐的命题:可驾驭性在相当程度上是系统架构的属性,而不是智能体能力的属性。 一个分解良好的系统,智能体就能驾驭它;一个分解糟糕的系统,再强的驾驭策略也无济于事。而“分解”本身就是对象维度的工程,需要由人来完成。智能体能决定的是“在给定的道路上跑得多快”,决定不了“道路修得如何”。
四、未被测绘的地形:涌现复杂性
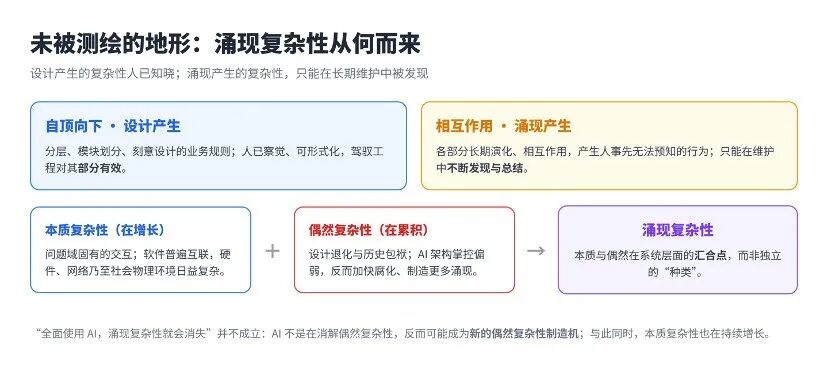
系统复杂性并非铁板一块,它的来源决定了它能否被驾驭工程处理。一个关键的区分是:有些复杂性是自顶向下设计出来的,有些则是自下而上涌现出来的。
设计产生的复杂性,人已经知道。 分层架构、模块划分、刻意设计的业务规则,是人在设计过程中有所察觉、甚至主动引入的。这类复杂性可以被讨论、被形式化、被编码进驾驭策略,因此驾驭工程对它们可能部分有效——因为规则的制定者理解这些规则。
涌现产生的复杂性,人事先不知道。 系统的各个部分在长期演化中相互作用,产生了任何人都无法在设计之初预知的行为模式。它无法被预先设计,只能在长期的开发维护过程中不断被发现、被总结。系统工程和软件工程领域的经典问题“特征交互”(Feature Interaction)就是缩影:电信系统里呼叫等待、呼叫转移各自都正确,但二者组合却可能产生意料之外的行为。
关于涌现,有一种颇为流行的看法:涌现复杂性本质上属于偶然复杂性,是人的思维局限性的产物,如果全面使用 AI,让智能体统揽全局,这种复杂性就会自然消失。这个观点值得认真推敲,但我并不认同。
反驳之一:今天的 AI 对复杂软件的整体架构掌控其实比较弱,它未必能消解偶然复杂性,反而可能制造更多。 AI 生成的代码在单点功能上常常表现良好,但在设计质量上容易出问题——为了快速跑通当前功能,它倾向于选择最快捷的方案,容易引入硬编码、重复实现、边界混乱。这恰恰加快了代码腐化的速度,导致整体设计质量退化,从而引发更多的涌现复杂性。换言之,AI 不是天生的“偶然复杂性消解器”,在缺乏架构约束时,它更可能成为新的偶然复杂性制造机。某技术水平很高的互联网团队,系统中最长的微服务调用链一度长达 400 多跳、甚至存在调用链环路,正是因为每个开发者(以及他们使用的 AI)只关注局部,而无人在全局上看护结构。
反驳之二:软件的本质复杂性也在不断提高,这部分不会因 AI 而消失。 软件越来越多地需要普遍互联,所面临的计算机硬件、网络环境乃至社会物理环境也越来越复杂。在“人机物融合、万物互联”的趋势下,原本孤立的系统被加速融合,“系统之系统”无处不在;同时,人类社会的价值观也不断向软件投射,公平、隐私、合规等要求带来大量显性或隐性约束。这些都让本质复杂性持续增长,而本质复杂性恰恰是涌现的重要来源。
因此,更准确的说法是:涌现复杂性不是一个独立的“种类”,而是一种“表现形态”——它既可能与本质复杂性相关(问题域固有的交互),也可能与偶然复杂性相关(架构退化的累积),是两者在系统层面的汇合点。 正因为它同时根植于两端,所以“全面用 AI 让涌现消失”的判断从两端都站不住:AI未必能消除偶然复杂性,而本质复杂性还在增长。
当然,我并不否认 AI 在应对复杂性上的积极作用。一些浅层的系统复杂性,确实可以借助 AI 的长时间工作能力和自我分析、总结、改进能力来解决——例如识别并清理一批重复代码、对一组结构清晰的模块套用成熟的重构套路。我想强调的是边界:当复杂性还是“平面”的、局部的、套路化的,AI 可以大有作为;而当它变成“立体”的、跨模块的、牵涉代码之外隐性系统知识的,靠智能体自身的驾驭工程和循环工程,原则上就是盲的——因为它没有、也无法仅凭过程内的信息,获得对那些未被测绘地形的理解。
五、把立体走成平面:人、参谋长与地图
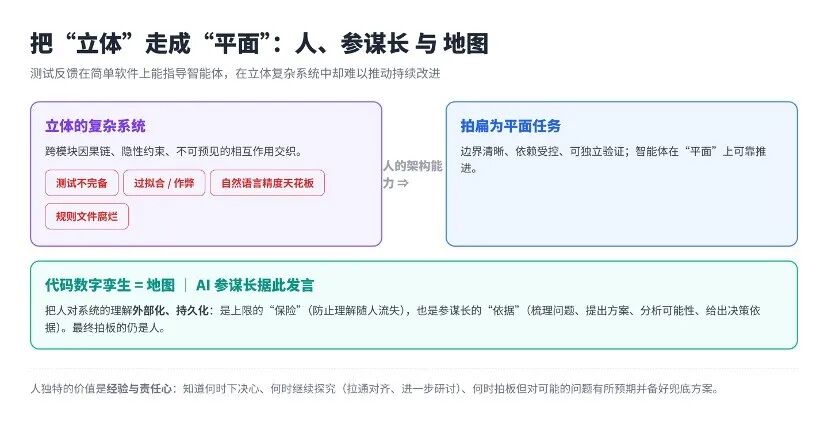
当软件复杂性还比较低的时候,我们可以利用代码和编程级别的思考完成任务——自动化测试能够提供相对完整的反馈信号,指导智能体不断修改和扩展代码,这是一个在“平面”上可靠收敛的过程。但当一个软件真正成为复杂系统,复杂性就从“平面”变成了“立体”:跨模块的因果链、隐性的约束、不可预见的相互作用交织在一起。这时候,自动化测试提供的反馈,就很难再推动智能体持续改进软件了。原因是多层的,它们共同构成了驾驭工程的边界。
第一层,是测试与评判准则本身的不完备,以及 AI 的过拟合倾向。 测试用例很难穷举所有状态组合,复杂业务逻辑的许多要求根本没有被写成测试。更麻烦的是,AI 有很强的过拟合倾向——它可能生成恰好通过所有测试、却并不真正满足业务意图的代码;很多人已经发现,在可能的情况下 AI 会主动寻找评估系统的漏洞,以旁路的方式“通过”评测。Birgitta Böckeler 也坦承,行为驾驭(Behaviour Harness)是目前“房间里的大象”,当前做法“对 AI 生成的测试寄予了太多信任,这还不够好”。
第二层,是自然语言引导的精度天花板。 编码前确定的设计规则通常只能是宏观原则,很难精准控制具体细节,而性能、并发、资源泄漏等问题恰恰藏在细节里;正如 Martin Fowler 在《Is Design Dead?》中所说,很多设计是随实现过程逐渐增长的(Evolutionary Design),期望编码前给出完整设计(Planned Design)本就不现实。更根本的是,自然语言是模糊的、模型生成是概率的,两者叠加使得透过提示词实现对所有细节的掌控从根本上不可能——很多专家形容这像是“许愿”或神秘的“咒语”。OpenAI 团队也发现 AGENTS.md 会“迅速腐烂”:规则越多,矛盾和过时的可能越大,他们最终把它精简到约 100 行,当作“目录”而非“百科全书”。
第三层,是架构约束本身的定义难题。 可维护性、可扩展性、概念完整性等架构质量属性,难以用精确的计算性规则表达,架构适应度函数(Fitness Functions)提出多年、应用仍然有限;而让另一个 LLM 审查架构,其评价本身又是非确定的。软件架构淹没在海量代码之中、缺少显式存在,识别和评估对人类专家都很困难——以华为为代表的企业重视“架构看护”(早年用 Structure101 一类工具),恰恰反证了这件事的难度。
那么,“立体”的复杂性究竟是如何被“拍扁”成智能体可以处理的“平面”任务的?在很大程度上,这还是要靠人的经验和能力——靠人对系统的理解、对模块的切分、对约束的设定。这一步无法被智能体独立完成,因为它恰恰需要那种跨越整个系统、贯通历史与现状的认知,而这正是当前智能体最缺的。
但人不是孤军奋战。AI 作为参谋长,可以帮很多忙:梳理问题、提出关于解决方案的建议、分析各种可能性、提供决策依据。最终拍板的还是人。这也保证了人对整个系统始终处于掌控之中——否则,随着时间推移,人已经无法理解复杂系统,系统后面肯定会出大的质量问题。
在这个分工里,代码数字孪生扮演着“地图”的角色,而且是两个关键角色。它是上限的“保险”:把人对系统的理解外部化、持久化,防止理解因人员流动、时间流逝而流失——软件经过长期演化后具有很强的系统独特性,许多关键知识一旦没有沉淀,就会永久消失。它也是参谋长发言的“依据”:让 AI 的建议建立在对结构、历史、约束的掌握之上,有据可依,而不是无根之谈。代码数字孪生不只是代码镜像,而是一个多维知识体系,涵盖骨架知识(系统做什么、怎么做)、解释性知识(为什么这样做),以及知识与代码制品之间的映射和协同演化。
需要强调的是,最终拍板的人本身也可能只具备局部理解。人独特的价值不在于全知全能,而在于经验与责任心:知道何时下决心、何时继续探究(拉上相关人拉通对齐、进一步研讨)、何时拍板但对可能出现的问题有所预期并备好兜底方案。AI 参谋长的作用之一,正是降低人拍板时的理解盲区。这里也可以借 Birgitta Böckeler 引用的 Ashby 定律作结:调控者的多样性必须至少与被调控系统的多样性相当——通过解耦和抽象降低系统的“多样性”,正是让驾驭变得可行的根本途径,而这首先是人的架构工作。
六、向导的拿捏:在哪一层看路
一个在 AI 时代反复被争论的问题是:用 AI 生成代码之后,人到底还要不要看代码?主张全看的,觉得不逐行读心里不踏实;主张全不看的,觉得 AI 写得比自己写的还稳,看了也是浪费时间。在我看来,这两种极端都不合理,而争论本身暴露了一个更本质的能力——拿捏。
不妨看一位资深工程师评审 AI 改动时的真实过程。他不会逐行读完全部代码,而是先扫一遍变更范围和测试,凭对系统的理解判断:哪些模块是这次改动真正触及的薄弱点,哪些是稳定的既有结构,哪些地方改动会沿依赖向外波及。然后他据此决定——这个改动看接口契约就够,那个改动必须读实现细节,还有一处要拉上熟悉那块的老同事对齐。整个过程中,他逐行看掉的代码可能不到一半,但他对风险点的覆盖是完整的。
这种能力,我称之为拿捏能力。它有点像领导艺术:好的领导既不会什么细节都抓、事必躬亲,把自己累得半死;又不会因为完全不深入细节而被下面的人架空。拿捏的功夫,正是在“抓”与“放”之间,找到与风险相匹配的位置。
拿捏不仅是“看还是不看”,还有一个更精细的维度——在什么抽象层次上看。不同的项目、同一个项目中不同的部分,人需要掌控的抽象层次和粒度并不一样。
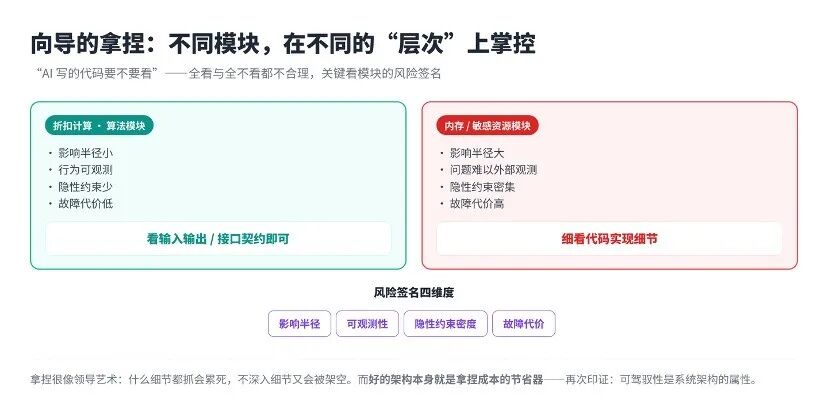
一个折扣计算的算法模块,基本上围绕输入输出、掌控好接口契约就差不多了:它的影响半径小,给定输入就有确定输出;行为可观测,对错能直接从结果判断;隐性约束少,规则都在需求里;故障代价低,错了也能很快发现、影响有限。但一个涉及内存和其他敏感资源操作、有可能带来复杂系统影响的模块,人可能就要掌握得比较细,比如仔细查看代码实现细节:它的影响半径大,一处资源处理不当可能波及很远;问题难以仅从外部观测发现,可能以诡异的方式在远处、在很久之后显现;隐性约束密集,很多约定不在接口文档里;故障代价高,可能引发崩溃、数据损坏或安全事故。
一个模块需要多细的掌控,取决于它的风险签名,至少包括四个方面:影响半径有多大;出问题时能否靠外部观测发现(可观测性);有多少隐性约束不在接口文档里(隐性约束密度);出错的代价有多高(故障代价)。专家在潜意识里为每个模块计算了一遍风险签名,然后决定把有限的注意力投在哪个抽象层次——这就是拿捏的功夫所在。
为什么不能“全都看”?因为那在物理上不可行。复杂系统的代码量摆在那里,而人的认知资源、时间精力是硬约束;AI 又把代码产出速度提高了几十倍,逐行审查所有产出,从根本上就不可能。所以“全量细看”本身就是一个无法执行的策略。拿捏因此不是偷懒,而是复杂系统里唯一可行的审查方式——它追求的不是“看了多少”,而是“有限的注意力,是否覆盖了真正的风险”。
这也解释了为什么好的架构本身就是拿捏成本的节省器。模块设计得好——信息隐藏充分、接口清晰、影响半径小、副作用可控——人就可以在高层、在契约层面掌控,审查成本很低;模块设计得烂——耦合严重、隐式共享、边界模糊、副作用四散——人就被迫下潜到实现细节,否则无法放心。一个结构良好的系统,本质上是在替审查者“预先消化”复杂性。这再次印证了那个命题:可驾驭性是系统架构的属性,连“拿捏的难易”都由架构决定。
这其实是一种在许多高风险领域共通的智慧。民航飞行员不会、也不可能在整个航程中平均用力地监控一切,他依据检查清单和告警,把注意力精准投放到关键阶段和关键参数上;登山向导带队时,同样不会对每一步路都同等紧张,他清楚哪段路是可以放心快走的缓坡、哪段崖壁必须亲自逐一确认保护点。他们的专业,不在于“处处都看到”,而在于准确知道“哪里必须看到、哪里看个大概即可”。这正是专家区别于新手的拿捏。
七、参谋长的落地:掌控粒度推荐
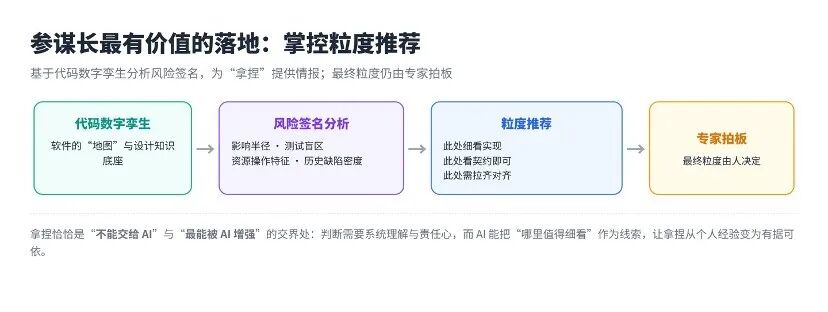
既然掌控粒度本质上是模块风险签名的函数,那么“这个改动建议在哪一层看、看多深”,就成为一件可以被 AI 参谋长提供的服务——而且是代码数字孪生一个非常自然、价值很高的落地场景。
它的工作流程可以这样展开:第一步,基于代码数字孪生,定位本次改动涉及的模块及其在系统中的位置;第二步,进行风险签名分析,评估改动模块的影响半径、测试盲区、资源操作特征、历史缺陷密度;第三步,给出粒度推荐——“此处建议细看实现”“此处看接口契约即可”“此处需要拉通对齐”;第四步,由专家拍板,最终在哪个抽象层次掌控、是否接受推荐,仍由人决定。
换句话说,AI 参谋长替“拿捏”提供情报:它把一个改动的风险结构提前梳理出来,告诉专家“你的注意力最值得放在哪里”,从而把专家从“凭经验在海量代码里搜寻风险点”中部分解放出来;但它不替专家做那个最终的判断——因为判断背后是对系统的整体理解和责任,这无法外包。
这恰好揭示了拿捏能力一个微妙而关键的位置:拿捏是“不能交给 AI”与“最能被 AI 增强”的交界处。 说它不能交给 AI,是因为拿捏本质上需要系统级理解与责任心,需要人在信息不全时承担后果,这正是当前智能体的根本短板;说它最能被 AI 增强,是因为 AI 参谋长可以把“哪里风险高、哪里值得细看、哪里需要对齐”作为线索和证据提供给专家,让拿捏从纯粹的个人经验,变成有据可依、甚至可沉淀复用的过程。这个“人保留判断、AI 提供情报”的分工,正是人机协同在复杂软件上最有前景的形态。
从代码数字孪生的视角看,这也对应着它赋能智能的几种交互范式:一是按需知识问答,回答“这个模块为什么这样设计、与哪些地方耦合”;二是上下文感知的开发协同,在开发中主动提示影响范围与风险点;三是在可解释、可验证前提下的自主演化。掌控粒度推荐,正处在前两者的交汇点上——它既基于对知识的按需分析,又直接嵌入开发与审查的协同流程。
结尾:人可以站得更高,但环不会消失
回到开头那个流行叙事:智能体连续工作几百小时,人慢慢站到循环之外。经过这一路辨析,现在可以看清它的偏差究竟在哪里。
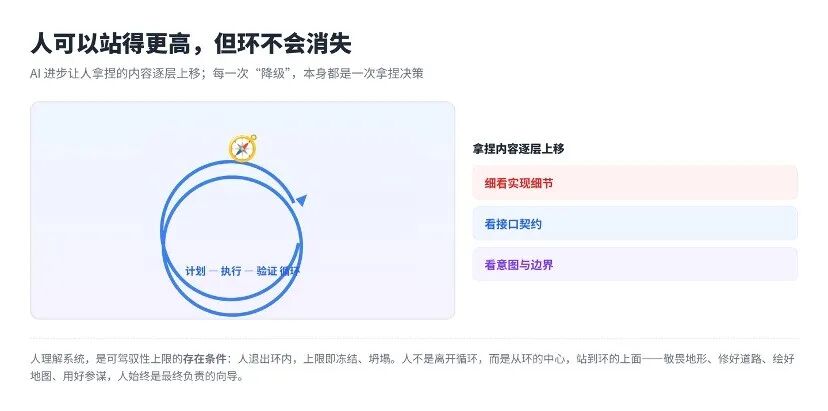
驾驭工程和循环工程确实是逼近上限的重要技术,它们值得被认真对待。但它们改变不了上限本身——上限由对象复杂性和人的理解完整度决定。既然如此,“人理解系统”就不再只是人的自我要求,而是可驾驭性上限本身的存在条件:人一旦退出环内、不再理解系统,上限就会冻结,甚至坍塌——因为再没有什么在抬高它,而系统还在持续演化、持续产生新的复杂性。
那么,人是不是注定要被永远困在无尽的细节里?也不是。随着 AI 能力的进步,人拿捏的内容会逐层上移:早期需要细看实现细节;中期只看接口契约;更远也许主要看意图与边界。每一次“降级”——把某一层次的掌控交给智能体——本身都是一次拿捏决策,都是人在判断“这一层现在可以信任它了”,并对可能的残余风险有所准备。人可以站得更高,但环不会消失:他只是从环的中心,站到了环的上面。
这也正是“行路于疆域”这个类比最终想表达的。智能体的进步,让行路者的脚力越来越强、能走得越来越久;但疆域不会因此变平,山还在、谷还在、未被测绘的地形还在持续生长。人要做的,不是幻想自己可以彻底离开这片疆域,而是敬畏地形、修好道路、绘好地图、用好参谋,让自己始终是那个认识路、也负得起责任的向导。
复杂软件的智能化开发,真正的深水区不在过程维度的驾驭,而在对象维度的知识、架构与验证。那些把注意力投向代码数字孪生、投向系统架构、投向人机协同中“人”的一侧的工作,不是在边缘修补,而是在抬高那条决定一切的上限曲线。驾驭 AI 的能力决定我们能走多快,而敬畏与理解系统复杂性的智慧,决定我们能走多远。
注:本文在AI辅助下完成,其中主要观点和逻辑来自本人。
作者简介
彭鑫,复旦大学计算与智能创新学院副院长、教授,国家级高层次人才计划入选者。中国计算机学会(CCF)杰出会员、软件工程专委会副主任、开源发展委员会常务委员,中国汽车工程学会汽车基础软件分会副主任,《Journal of Software: Evolution and Process》联合主编(Co-Editor),《ACM Transactions on Software Engineering and Methodology》、《Empirical Software Engineering》、《Automated Software Engineering》、《软件学报》等期刊编委。2016年获得“NASAC青年软件创新奖”,2023年入选上海市东方英才拔尖项目,2024年获得“中创软件人才奖”。主要研究方向包括软件智能化开发与测试、智能化软件系统构造与运行支撑、具身智能与自主无人系统软件等。研究工作多次获得《IEEE Transactions on Software Engineering》年度最佳论文奖、ICSM最佳论文奖、ACM SIGSOFT杰出论文奖、IEEE TCSE杰出论文奖等国际期刊及会议优秀论文奖。担任2022年与2023年CCF中国软件大会(CCF ChinaSoft)组织委员会主席与程序委员会共同主席,以及ICSE、FSE、ASE、ISSTA、ICSME、SANER等会议程序委员会委员。

本文转载自微信公众号「CodeWisdom」,查看原文。版权归原作者所有,如有侵权请联系删除。