NeurIPS 2026 | Mixture-of-Top-k 注意力:从快权重统一高效注意力,让 Top-k 专家灵活又可复用
原创 52CV 2026-10-09 22:34 江苏
Transformer 架构包含两类看似泾渭分明的核心模块:注意力模块(Attention)与前馈网络(Feed-Forward Network,FFN)。由于标准注意力的平方复杂度,研究者提出了许多高效注意力机制:线性注意力、混合专家注意力、Top-k 注意力……从前馈网络到标准注意力,再到高效注意力,它们不同的策略背后是否存在共同的设计逻辑?
北京邮电大学团队提出的 Mixture-of-Top-k Attention(MiTA),从快权重(Fast Weights)的视角出发,将前馈网络与注意力机制联系起来,进一步为高效注意力建立了一套统一的分类框架,并据此设计出一种兼顾全局信息与细粒度检索的高效注意力机制。该工作已被 NeurIPS 2026 接收,代码已开源。
这篇工作的核心出发点是:标准注意力机制可以等价写成快权重版本的两层 MLP,不同注意力机制的区别可以从如何组织和使用快权重来理解。MiTA 的关键改进是:不按固定规则将上下文切分成路由块,而是先用少量代表性查询构造可复用的 Top-k 专家,再让不同查询按需访问。这样既打破了固定分块的形状限制,也避免了为每个查询单独索引一组 Top-k 集合。在论文测评的长序列基准实验中,MiTA 将总训练时间砍掉近五分之四,同时保持了有竞争力的准确率。
论文标题: Mixture-of-Top-k Attention: Efficient Attention via Scalable Fast Weights
标准注意力其实是前馈层的动态化
通常,我们将注意力理解为查询对键值对的检索。换一个角度,把它与两层多层感知机(Multi-Layer Perceptron,MLP)放在一起,对应关系就很直观了。
沿用论文的列向量记号,令查询 ,键和值分别按列组成 。标准注意力与隐藏层宽度为 的两层 MLP 分别为:
将 Softmax 展开,并把缩放与归一化写入权重:
于是,注意力就变成了:
查询对应输入,两组变换后的键和值对应两层权重,指数函数对应激活函数,偏置为零,隐藏层宽度则由 变为序列长度 。这里的 吸收了依赖当前查询的 Softmax 归一化项,因此这个等价写法完整保留了标准注意力的归一化。
区别在于权重从哪里来:普通 FFN 的 是训练得到的慢权重(Slow Weights);注意力中的 则由当前输入动态生成,是随上下文变化的快权重。
这也揭示了注意力的扩展瓶颈:上下文越长,这个快权重 MLP 就越宽。每个查询需要访问 个隐藏单元,处理 个查询便产生随 增长的总体开销。高效注意力的设计,由此转化为一个统一的问题:如何让不断扩大的快权重网络保持可扩展性?
高效注意力的两条路线:压缩与路由
从快权重视角看,论文将所讨论的高效注意力方法归纳为两条主要路线。
第一条是通过压缩实现扩展(Scaling by Compression)。把完整的快权重 MLP 浓缩成更小的模块。例如,线性注意力(Linear Attention)将键值信息压缩到共享线性层,Linformer 等方法使用更窄的 MLP,测试时训练(Test-Time Training,TTT)则可以通过学习构造紧凑的快权重模块。这类方法能够提供全局概括,但通常无法再精确访问每一个原始键值对。
第二条是通过路由实现扩展(Scaling by Routing)。保留原始键值对,将其中的子集组织为快权重专家(Fast-Weight Experts),再让每个查询只访问选中的专家。这样可以保留被选中内容的细节,但仅靠局部选择,可能缺少对完整上下文的全局概括。
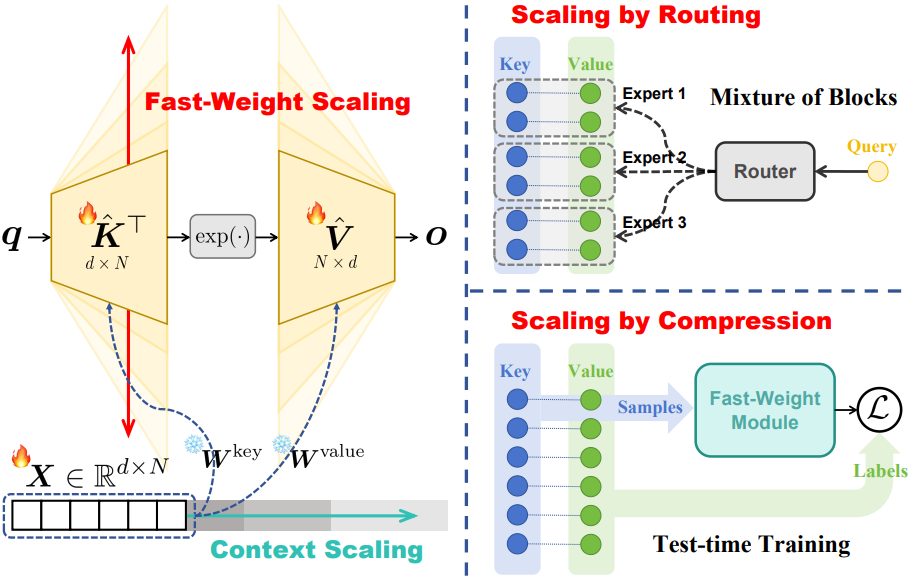
在此基础上,作者进一步提出五维分类框架:扩展策略(Scaling Strategy)、专家数量(Expert Count)、专家类型(Expert Type)、专家构造方式(Expert Construction)与路由拓扑(Routing Topology)。
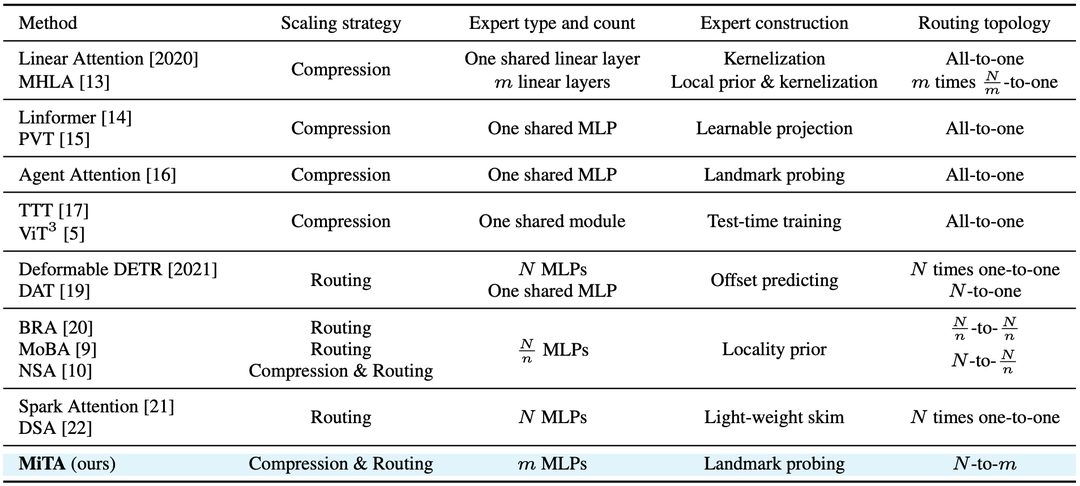
这张表让不同方法的联系更清楚,也把后续设计落到了具体问题上:专家应该如何构造?数量是否必须随序列长度增长?哪些查询能够共享同一个专家?
固定分块不够灵活,逐查询 Top-k 又难以复用
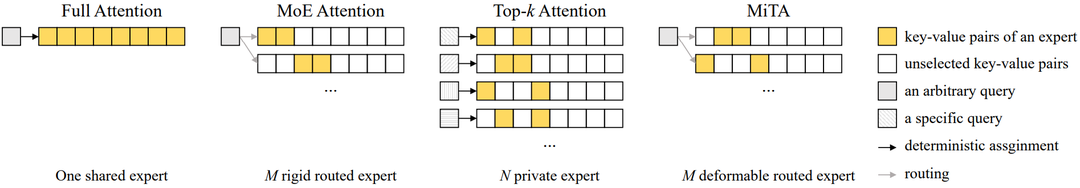
以 MoBA 等分块混合专家注意力(Mixture-of-Experts Attention)为例,一种常见做法是将序列切成连续、不重叠的块,每个块作为一个专家,再让查询选择要访问的块。计算组织很规整,但块的形状和边界也是固定的。图像中同一个目标的相关信息,未必恰好落在同一个矩形块里。
Top-k 注意力允许每个查询选择最相关的 个键值对,能够形成更灵活的稀疏访问模式。然而,在逐查询构造集合的设计中, 个查询对应 套“私有”专家。即使不同查询关注相似内容,也仍需要分别执行选择和组织。
MiTA 希望同时保留 Top-k 选择的灵活性,以及 MoE 路由的可复用性:先构造数量可调的专家,再让查询按需访问。
MiTA:用少量地标查询,同时完成压缩与专家构造
MiTA 引入 个地标查询(Landmark Queries),用它们探查完整上下文。论文采用了简单的局部平均池化(Average Pooling)来获得这些地标查询,但它们检索键值对的范围覆盖整个序列,并不受原始局部窗口限制。
同一次探查承担两项工作:一方面汇总全局信息,另一方面找出值得保留的原始细节。
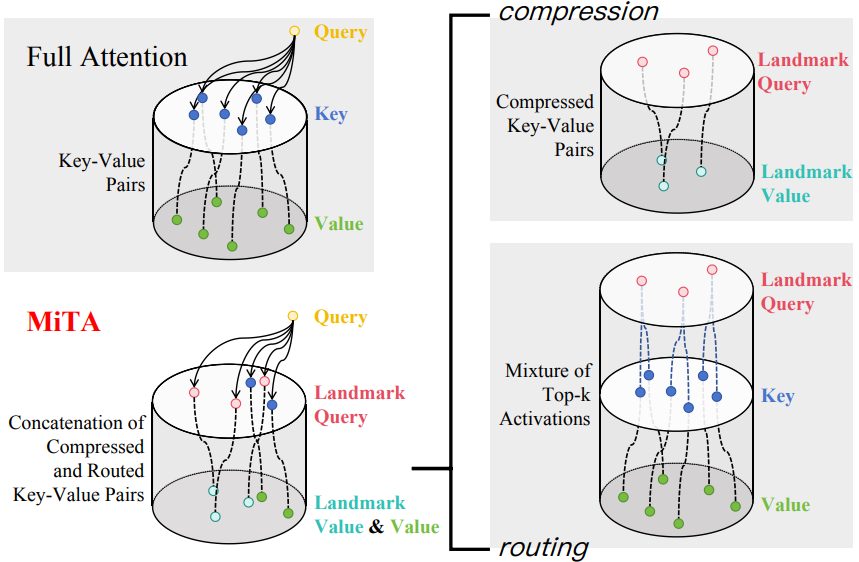
构造可变形的路由专家。第 个地标查询 与所有键匹配,选取相关性最高的 个位置:
这些键值对构成第 个路由专家(Routed Expert)。它们可以跨越不同空间位置,随图像内容改变形状;不同专家之间也可以选择重叠的键值对。随后,每个原始查询根据与地标查询的匹配关系选择专家。论文实验中,每个查询路由到一个专家,即 。
这里共享的是候选键值集合。不同查询即使进入同一专家,仍会计算各自的注意力权重,得到不同输出。
构造全局共享的压缩专家。同一组地标查询还通过交叉注意力(Cross-Attention)汇总完整上下文:
将地标查询作为压缩后的键,地标值作为对应的值,就得到一组紧凑的全局键值对 ,组成供全部查询访问的共享专家(Shared Expert)。
最后,将两部分拼接后做注意力。若查询 路由到专家 ,在论文的 配置下:
这使查询既能获得全局概括,也能精确访问选中的原始信息。两部分使用统一的 Softmax 归一化;用于 Top-k 选择与全局汇总的打分可以共享,查询到地标的打分也可用于路由。
在 ImageNet-1K 实验中,论文设置 ,因此每个查询最终访问 25 个压缩键值对与 25 个原始键值对,共 50 个。地标查询仍需扫描完整序列,但扫描由少量地标完成,专家数量不再被绑定为查询数量 。
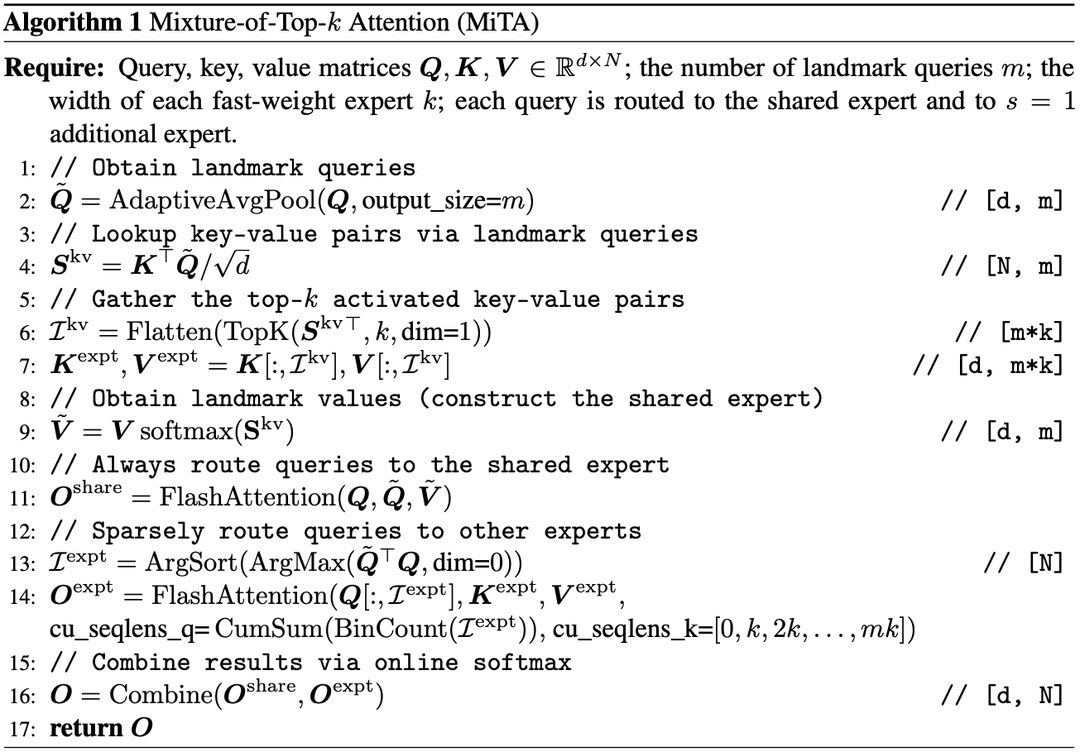
实现上,MiTA 可利用 FlashAttention 加速交叉注意力,并按专家分组处理查询。原始键值对的收集(Gather)会引入不规则访存,因此是否真正加速,还需要看运行时间实测。
实验结果:接近完整注意力,长序列训练时间减少约 77%
图像分类:先比较机制本身,再看增强配置
在 ImageNet-1K 上,作者首先采用相同的 DeiT 训练配置,对比不添加额外组件的注意力机制。
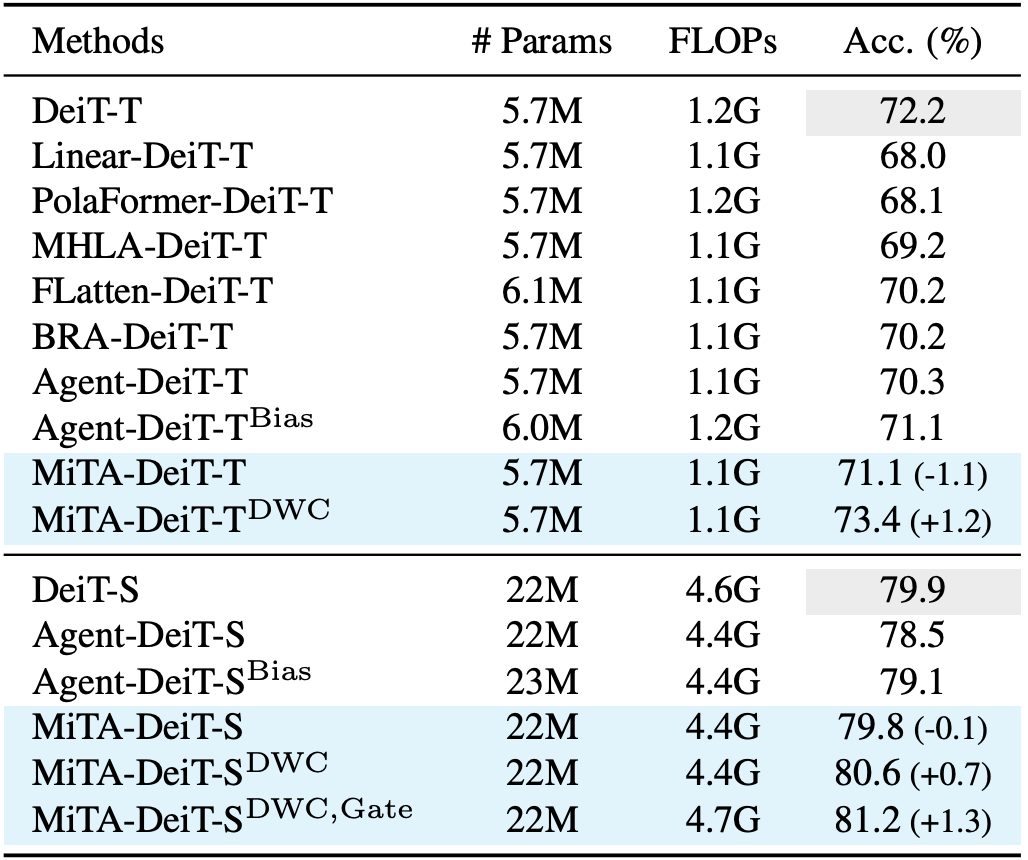
在 DeiT-S 上,基础 MiTA 达到 79.8% 的 Top-1 准确率,与完整注意力的 79.9% 仅差 0.1 个百分点,同时将 FLOPs 从 4.6G 降至 4.4G。相同设置下,Agent Attention 的准确率为 78.5%。
加入逐通道卷积(Depth-Wise Convolution,DWC)后,MiTA 的准确率进一步达到 80.6%;再加入数据相关门控(Data-Dependent Gating)后达到 81.2%,对应 FLOPs 为 4.7G。这些增强配置展示了进一步提升性能的空间,也应与基础 MiTA 的结果区分。
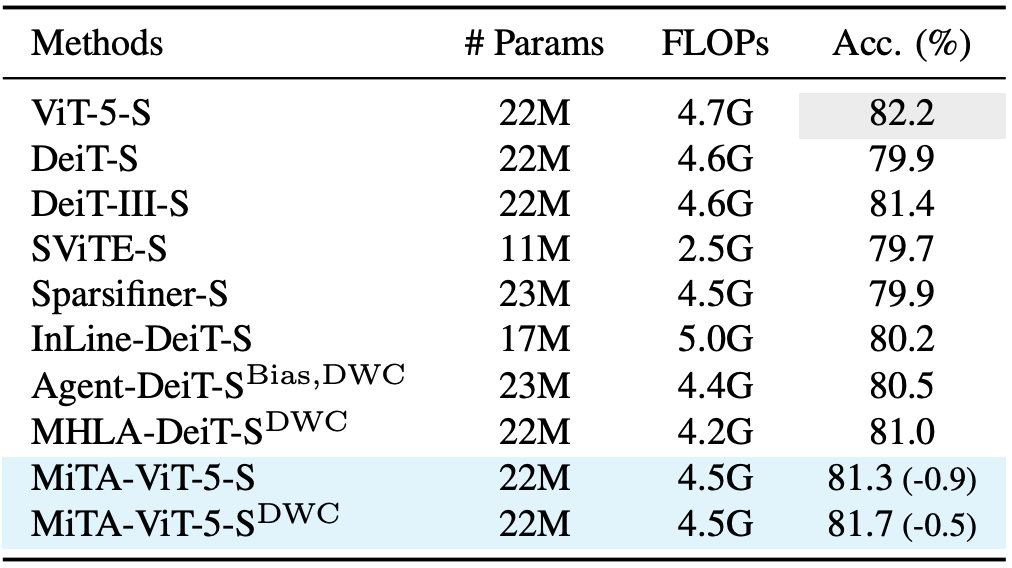
结合 ViT-5 的架构设计,MiTA-ViT-5-S 加入 DWC 后达到 81.7%,距离 ViT-5-S 的 82.2% 相差 0.5 个百分点,计算量则从 4.7G 降至 4.5G。
语义分割:在更长的视觉序列上节省计算
ADE20K 语义分割(Semantic Segmentation)需要更高分辨率输入。论文将预训练 ViT 的注意力替换为 MiTA,再训练分割模型;此时设置 ,每个查询访问 98 个键值对,而完整注意力在两种实验分辨率下分别访问 1,024 或 1,600 个。
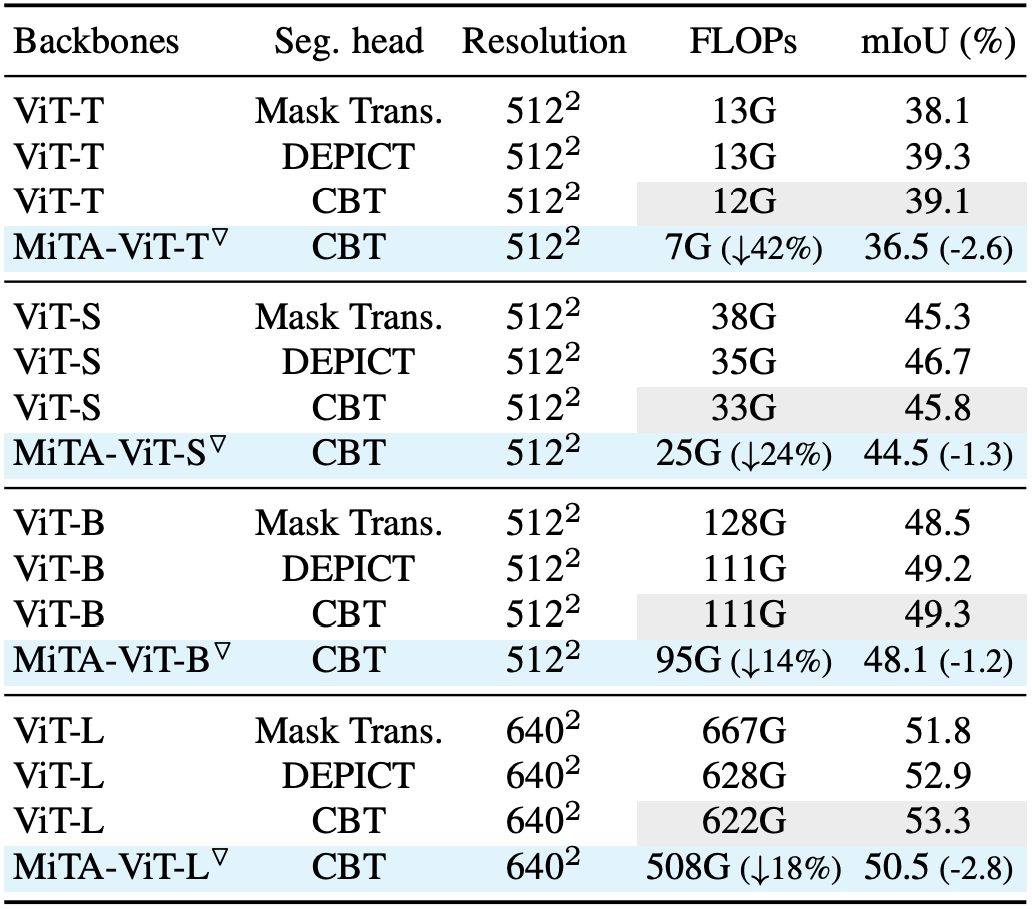
例如,ViT-S + CBT 配置的 FLOPs 从 33G 降至 25G,减少约 24%,平均交并比(Mean Intersection over Union,mIoU)从 45.8% 变为 44.5%。ViT-T 配置的 FLOPs 减少约 42%,对应 mIoU 下降 2.6 个百分点。这些结果展示了不同模型规模下的精度与效率折中。
长序列建模:实际运行时间也能明显缩短
在 Long Range Arena(LRA)五项任务中,MiTA 的平均准确率为 58.91%,完整注意力为 58.19%;总训练时间从 10.6 小时降至 2.4 小时,减少约 77%。
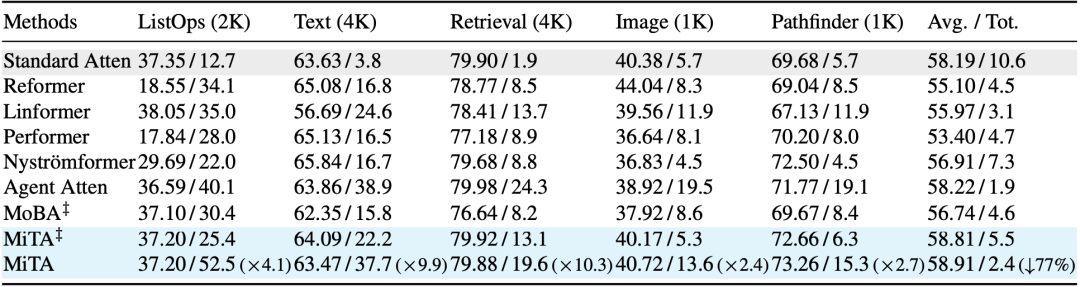
上述时间在 24GB RTX 4090 上测得,完整注意力基线采用 PyTorch 融合内核(FlashAttention)。这些是论文统一训练配置下的对比结果,并非分别为各方法调优得到的最佳准确率。
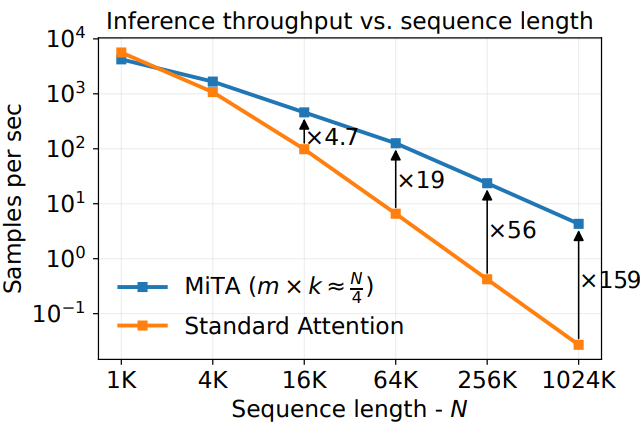
随着序列增长,吞吐量优势进一步扩大:在 64K、256K 和 1024K 长度下,图中报告的加速比分别约为 19 倍、56 倍和 159 倍。该测试使用嵌入维度为 128 的三层 Transformer,并分别调整批大小以最大化吞吐量;这些数字对应这一特定测试设置。
两个有意思的发现:自动聚焦目标,复用已有预训练权重
第一个现象是涌现的词元剪枝效应(Emergent Token-Pruning Effect)。随着网络层数加深,被选入路由专家的键值对逐渐集中在与类别相关的区域,许多背景位置不再被选中。
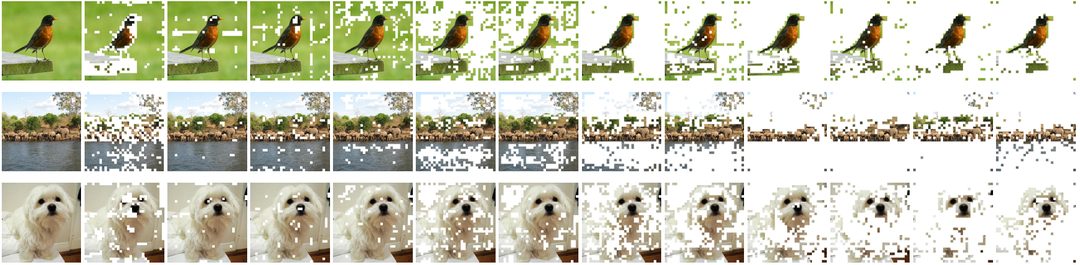
这种现象来自 MiTA 自身的专家选择机制。这里的“剪枝”指路由分支不再选取某些键值对;这些词元仍可能通过全局压缩分支参与计算。
第二个发现是已有预训练权重能够迁移到 MiTA。论文将完整注意力预训练的 ViT 替换为 MiTA,再在 ImageNet-1K 上微调。ViT-S 上,MiTA 与完整注意力的准确率分别为 80.9% 和 81.2%;ViT-L 上分别为 85.5% 和 85.9%。
此外,在保持训练后模型参数不变时,适当增加专家数量 或专家宽度 ,部分配置的准确率还能进一步提高。这为按推理资源调整注意力预算提供了实验依据。
从统一视角走向更灵活的注意力设计
MiTA 的设计逻辑可以概括为:把注意力看作快权重网络,把效率问题转化为快权重的组织问题,再通过可变形、可复用的专家结合压缩与路由。
在这个框架下,专家无需局限于固定块,Top-k 集合也无需成为每个查询独占的结构;全局概括和原始信息检索可以共用一部分计算。当前实验主要覆盖视觉任务和 LRA,面向大型语言模型解码(LLM Decoding)的验证仍是后续方向。
对于关注高效注意力的研究者,论文的五维分类框架提供了一组具体的设计维度:构造什么样的专家、允许多少个专家、以何种方式让查询共享它们。MiTA 展示了沿这些维度改进注意力机制的一条路径。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。