Flow-JEPA:基于流匹配的隐空间动态建模,提升JEPA世界模型的规划鲁棒性
原创 52CV 2026-10-10 22:42 江苏
论文标题: Flow-JEPA: Robust Latent Dynamics for JEPA World Models via Flow Matching
作者: Yanchen Huo、Ziying Song、Yadan Luo
研究机构: 南洋理工大学、昆士兰大学
论文地址:https://arxiv.org/abs/2608.29029
代码仓库:https://github.com/HuoYanchen/Flow-JEPA
在表征学习的路线中,联合嵌入预测架构(Joint Embedding Predictive Architecture,JEPA)提供了一种无需重建目标的选择:将观测映射到隐空间,直接预测目标的隐式表征,让模型能够更多关注与任务有关的信息,而不必重现例如背景、纹理和光照等全部细节。与此同时,缺少显式重建约束也带来了表征坍塌的风险。模型可能将不同输入编码成近似相同的表征,以很低的损失完成训练,却没有学到有效信息。因此,如何通过正则化等手段维持稳定、有信息量的隐空间,一直是 JEPA 研究的重要问题。
而当 JEPA 走向世界模型,仅解决表征层面的稳定性还不够。世界模型需要根据当前状态和动作预测未来,并将预测结果用于规划。即使编码器已经受到正则化约束,预测器仍可能对观测中的噪声敏感。围绕这一问题,南洋理工大学与昆士兰大学的研究者提出了 Flow-JEPA,将传统的确定性自回归预测替换为基于流匹配(Flow Matching)的概率性轨迹生成,在保留 JEPA 无需像素重建这一特点的同时,重新设计未来状态的建模方式。
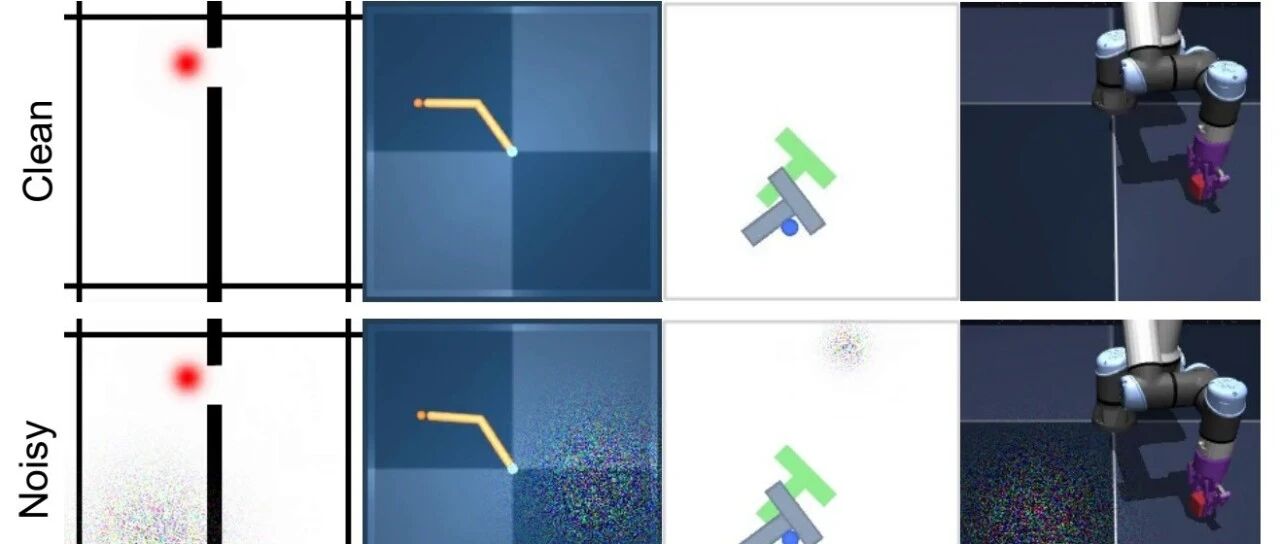
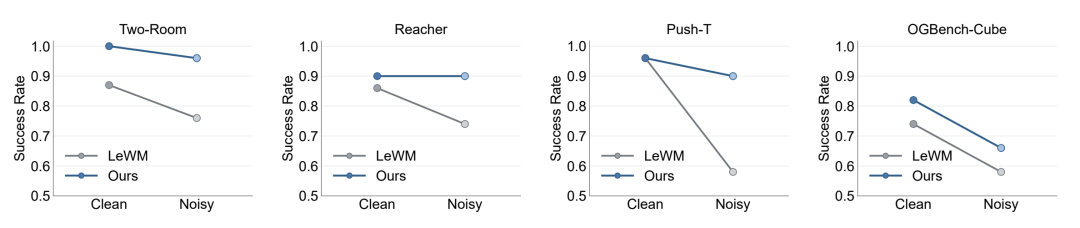
实验覆盖 Two-Room、Reacher、Push-T 和 OGBench-Cube 四个控制环境。相比 LeWorldModel(LeWM),Flow-JEPA将干净观测下的平均规划成功率由 86% 提升至 92%,在加入噪声扰动后则由 67% 提升至 86%。从干净环境到扰动环境,LeWM 的平均成功率下降 19 个百分点,Flow-JEPA 只下降 6 个百分点。
研究背景:表征受到正则化约束,未来预测仍可能受到噪声影响
LeWM是代表性的 JEPA 世界模型。它利用视觉编码器提取图像的隐式表征,并通过预测器推理给定动作后未来状态转移。SIGReg 对编码器输出进行正则化,以避免表征坍塌。不过,SIGReg 只约束了跨样本的表征分布,并不直接决定:当同一个物理状态由于视觉扰动而对应不同的表征向量时,预测器应当给出怎样的结果。
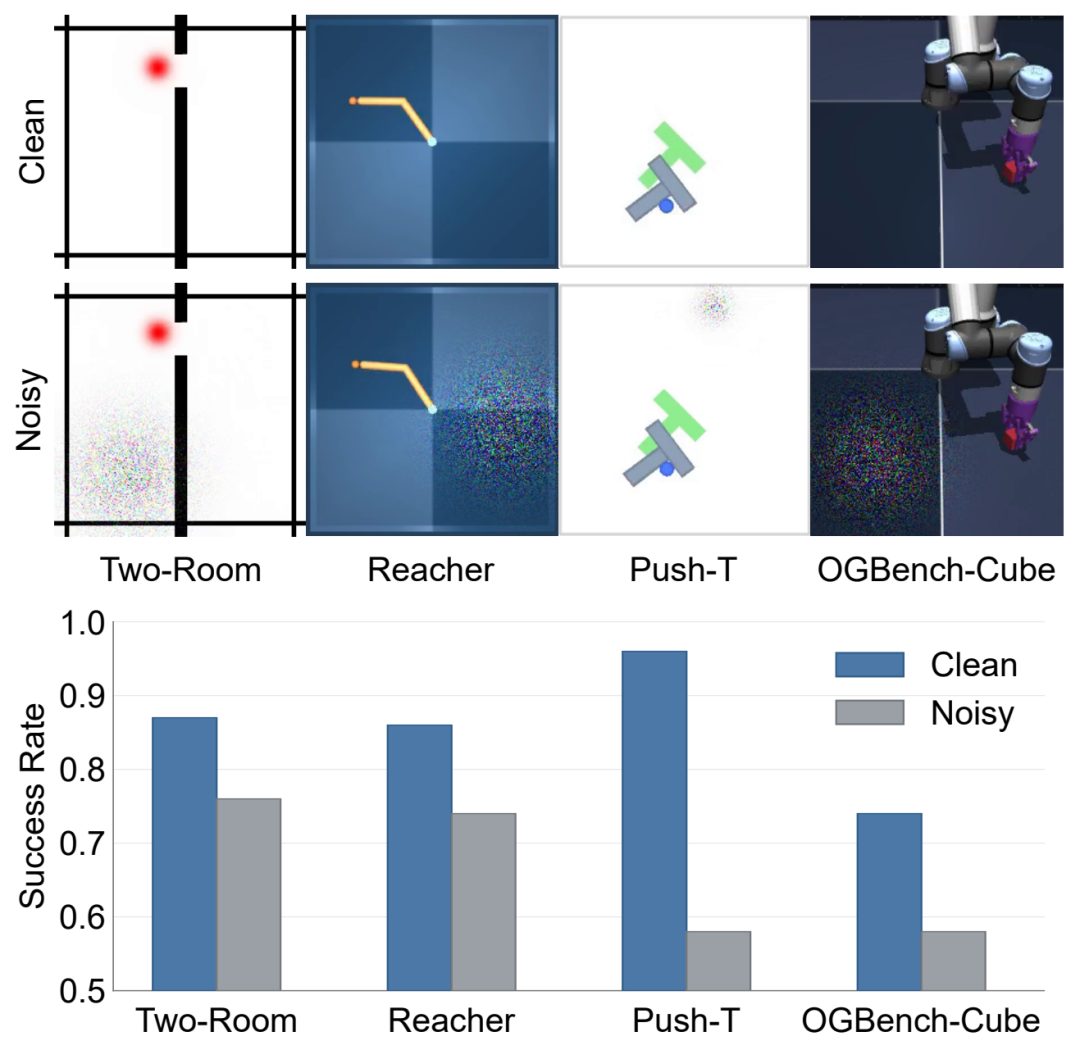
研究团队据此设计了一项针对性的鲁棒性测试:保持任务目标和真实环境状态不变,只在观测图像的背景区域加入局部高斯噪声。
结果显示,LeWM 在四个任务上的平均规划成功率从 86% 下降至 67%。对于人类而言,这类背景噪声通常不影响对任务的判断;对于依赖隐空间进行规划的模型,同样的扰动却可能改变编码后的状态,并进一步影响未来预测,这也是 Flow-JEPA 的主要研究动机。
问题分析:确定性点回归如何导致状态偏移
LeWM 采用经典的自回归预测方式:以给定的动作为条件,将当前状态映射到下一时刻的状态,再将预测结果作为后续预测的输入。这一结构能够把单步状态转移连续组合为未来轨迹,但其鲁棒性受到两方面的影响。
最明显的是递归预测中的误差累积。早期预测产生的偏差会进一步影响后续预测,最终导致规划所依据的轨迹大幅偏离真实情况。其次,更重要的是确定性点到点回归的监督范围:训练主要依据真实样本中的状态转移,优化从给定输入到目标下一状态的映射,却没有覆盖偏离训练轨迹的中间状态。
实际运行中,观测噪声可能使隐状态产生偏移,对于这些状态,传统单步回归目标没有直接提供对应的预测约束。因而,问题不仅在于自回归结构会累积误差,也在于确定性点回归没有显式学习从随机偏移的状态出发,未来轨迹应当如何演化。
方法设计:以流匹配学习概率性生成过程,并联合预测未来轨迹
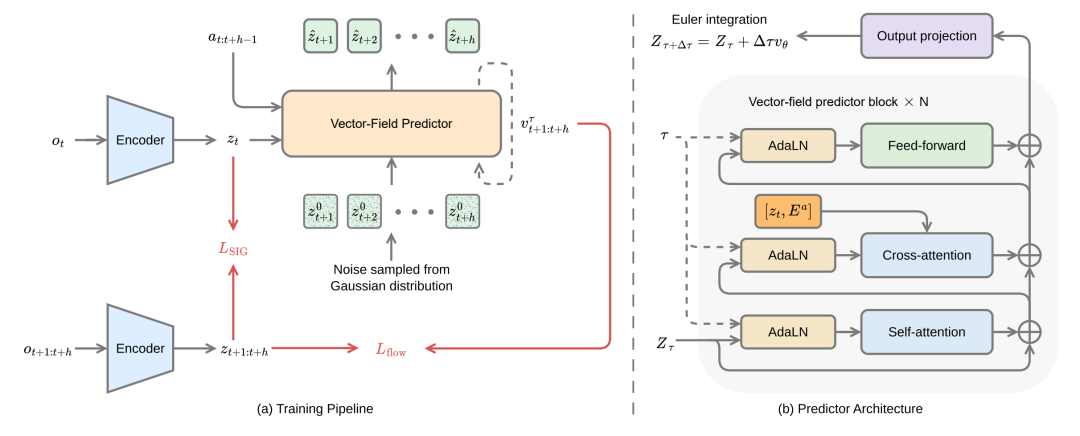
Flow-JEPA 的核心变化,是用条件流匹配替代逐点的确定性状态回归。它不直接输出唯一的下一状态,而是在当前状态和未来动作序列的条件下,从随机源分布出发,生成整段未来轨迹。
训练时,模型首先从高斯分布中采样一段随机源轨迹,并将其与真实的未来轨迹通过线性路径连接。在这条路径上随机选择流时间,就能构造介于源轨迹和目标轨迹之间的中间状态。预测器的学习目标是一个随流时间变化的向量场:给定当前中间轨迹及其条件,预测它向真实未来轨迹演化的方向。
与自回归不同,训练覆盖的不再只有真实样本上的离散输入,而是包含源分布与目标轨迹之间更丰富的随机状态。研究认为,这种随机轨迹级训练有助于提升模型对扰动的鲁棒性。
在模型结构上,Flow-JEPA 使用 Transformer 构建向量场预测器,以当前隐空间状态、未来动作序列及流时间作为条件,对整段未来轨迹进行联合更新。推理时,模型从采样的源轨迹出发,通过欧拉积分逐步求解向量场,得到用于规划的未来预测轨迹。
实验评估:基础规划性能得到保持,视觉扰动下的差异更加明显
研究在 Two-Room、Reacher、Push-T 和 OGBench-Cube 中展开验证,任务涵盖导航、连续控制与物体操作。在干净视觉条件下,Flow-JEPA 的四任务平均成功率达到 92%,LeWM为 86%。这一结果表明,改用流匹配建模未来轨迹,并不会牺牲正常条件下的规划表现。
视觉扰动条件下的提升更加显著:LeWM 的平均成功率为 67%,Flow-JEPA 达到 86%,提高了 19 个百分点。若比较两种方法从干净环境到扰动环境的性能变化,LeWM 平均下降 19 个百分点,Flow-JEPA 仅下降 6 个百分点。
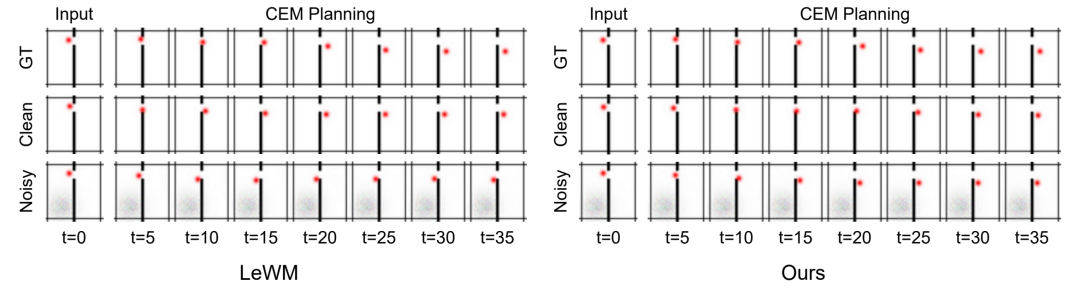
规划过程的可视化给出了更直观的补充。在相同的初始状态和目标状态下,两种方法在干净观测中均能完成任务;加入背景噪声后,LeWM 未能成功完成任务,而 Flow-JEPA 仍然到达了目标。
为了检查性能差异是否依赖某一组参数,论文还进行了压力测试,分别改变局部高斯噪声的空间范围、噪声强度、流积分步数和 CEM 规划预算。在各个测试条件下,Flow-JEPA 均普遍取得高于 LeWM 的成功率。模型在欧拉积分步数设置为 8 时获得最优规划性能。增加至 16 或 32 步会明显提高推理时间,但没有进一步改善规划表现,体现性能差异并非由额外计算带来。
研究意义:从约束表征走向鲁棒的未来建模
过去,围绕 JEPA 的研究已通过多种正则化与训练策略缓解表征坍塌。Flow-JEPA 进一步将重点放在隐空间动态本身。通过基于流匹配的概率性轨迹生成,为 JEPA 世界模型提供了另一种未来建模思路。
Flow-JEPA 关注的不只是提高特定基准上的规划成功率,更是对于 JEPA 世界模型而言,两个相互关联、却不能相互替代的问题:学到稳定的表征是基础,如何在这一表征空间中可靠地建模未来,同样决定着系统能否作为世界模型运作。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。