NeurIPS 2026 Oral | 显式建模解耦 Artifacts 的两阶段图像篡改定位
原创 52CV 2026-10-10 22:42 江苏
项目 | 内容 |
|---|---|
论文标题 | Can We Model the Artifacts Explicitly? Disentangle Artifacts via Pairwise Edit Relations for Image Manipulation Localization |
会议 | NeurIPS 2026(Oral,Top 0.3%) |
机构 | 四川大学 × 蚂蚁集团光鉴 |
作者 | 朱学康,冯凯文,王锐锋,王汐文,马晓晨,杜博,曲晨帆,刘健,冯文韬,周吉喆,吕建成 |
导读:本文核心内容
图像篡改定位(IML)长期被当作"给一张图、出一张掩码"的端到端监督任务,结果模型学到的其实是"哪块内容通常会被改"这种语义捷径,一换域就崩。
这篇被 NeurIPS 2026 选为 Oral 的论文把篡改伪影(artifacts)重新形式化为一个潜变量,并用一个精巧的"减法"(对比"原图与其编辑版"和"两张无编辑关系的图")把伪影从语义中显式地剥出来,再用它作为初始化去赋能任意检测器。 PAL 不改动任何现有 IML 模型的架构,只替换 backbone 的初始化权重,是一个即插即用的训练范式。论文把它接到 6 种骨干与 5 个已有方法上,11 个模型无一例外全部提升,增益与具体网络结构无关,是一种通用的取证初始化。
它拿下了 NeurIPS 2026 主会 112 / 30709 的 Oral,也是 NeurIPS 主会历史上第一篇篡改检测方向的 Oral 论文。
(一)AI 时代的内容安全正在从"选修题"变成"必修题"
文生图模型在几年内把"生成一张以假乱真的图"变成了成本几毛钱的一次点击,Deepfake 把换脸视频的门槛压到了普通笔记本能跑的程度。当合成的成本远低于核实的成本,内容安全的技术重心就必须从"事后追责"前移到"事中拦截"。这一切的前提,是有一层足够可靠、能在大规模真实流量上跑得动的鉴伪能力。
整个赛道近十年的主线是"统一":Deepfake、IMDL、AIGC、文档篡改四个子领域长期各自为战,而统一之后立刻暴露下一个问题,跨域一换,模型就崩。今天能认出 PS 拼接的模型,未必认得出 AIGC 重绘;能在 CASIA 上打到 0.9 的模型,换到 NIST16 上可能只剩 0.4。
这背后不是模型不够大,而是模型学到的根本不是"篡改痕迹"本身。
二、问题的病灶:模型学的是语义,不是伪影
当前 IML 范式被统一表述为:给定图像 x,直接估计篡改掩码 y 的条件分布 P(y|x)。这本质上是一个一阶段、端到端、隐式的建模过程,它隐式地假设深度网络会"自发地"学出伪影表征。这条路有三个结构性的病灶。
(一)病灶一:语义捷径(Semantic Shortcut)
监督信号只有掩码,而掩码与图像内容之间存在极强的统计相关性。模型会发现一条捷径:在 PS 训练集里,被篡改的区域恰好常是草地、天空、证件照。于是它学到的不是"这条边界被动过",而是"这块地方通常会被动"。一旦换域,这条捷径瞬间失效。
(二)病灶二:标签噪声(Label Noise)
掩码标注本身是粗糙的:边界一圈到底是篡改还是没篡改?AIGC 全图重绘的"篡改区域"如何定义?标注的不确定性被模型当成了真实信号吸收进去。
(三)病灶三:手工特征的代价
为了对抗前两个问题,已有方法普遍引入手工设计的特征提取器,SRM 高通滤波、Bayar 卷积等。论文的对比很说明问题:
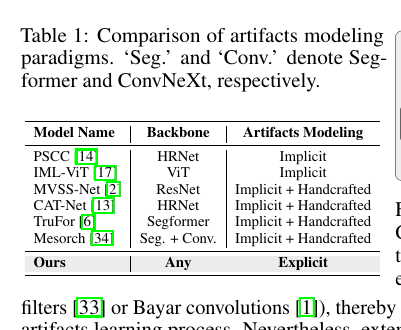
而实验已经反复证明:这些刚性、不可自适应的人工先验,恰恰损害了模型在多样化篡改场景下的泛化能力。论文自己的消融数据也印证了这一点,去掉手工特征依赖的路线(Baseline 0.5661 → 加绝对监督的 Baseline-ABS 0.5820)在跨域上几乎没动(0.5320 → 0.5292,甚至略降),说明在源域上刷分很容易,跨域才是照妖镜。
三、核心重构:artifacts 是一个隐变量
作者指出:artifacts 是篡改操作引入的细微特征不一致,它决定了输出掩码,却主要栖息在非语义域,人眼几乎不可见,直接标注在物理上就不可行。既然标注不可得,那它本质上就是一个隐变量 z。
于是整个任务被重新写成一个潜变量学习问题:
把难以直接求解的 ,分解为「显式伪影后验 」加上「基于伪影的定位 」。
"显式"到底显式在哪?
论文把 artifacts 从"端到端掩码预测的副产品",变成"一个被直接优化、可用关系监督约束的独立目标"。作者特别澄清了一个容易被误读的点:显式建模不需要假设伪影与语义在统计上独立,这个假设太强且不成立;它真正要做的是压低语义捷径的权重,把模型的注意力逼向"编辑所引发的差异"。
(一)关键洞察:编辑关系是那把钥匙
要显式建模伪影,就得找到一种监督信号,能把"伪影"从"语义"里剥出来。作者找到了一个非常朴素但极其有效的载体:同一张原图,与它被编辑后的版本之间的关系。
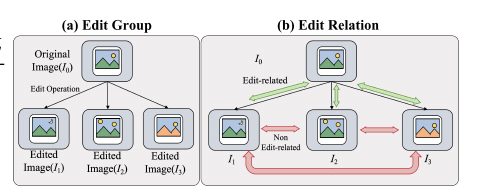
编辑关系的三段逻辑:① 编辑相关的图像对(原图 vs 它直接编辑出的图),两者的差异等于伪影加语义变化,混在一起;② 非编辑相关的图像对,差异只有语义变化,因为没有任何编辑操作发生;③ 两者相减,语义成分被抵消,剩下的就是伪影。这是全文最核心的减法。
换句话说,不要求模型"理解"什么是伪影,只要求它能区分"这一对图之间有没有发生过编辑"。而后者,是一个可以用成对数据直接监督的二分类问题。这是一次把"无监督的发现"降维成"有监督的辨识"的经典操作。
四、方法:PAL 两阶段训练范式
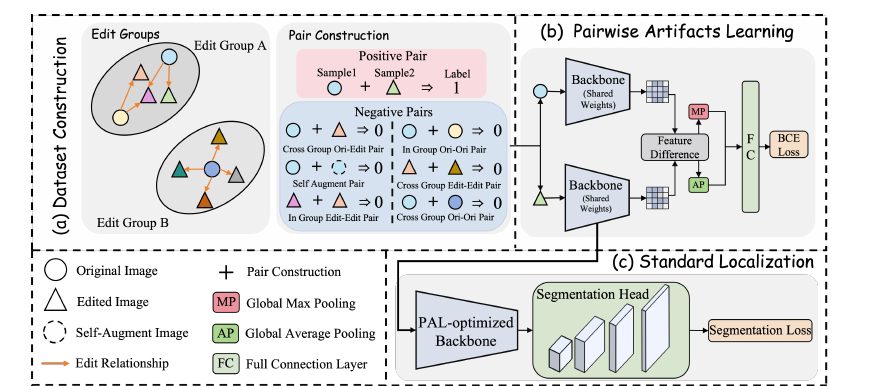
有了上面的洞察,方法实现非常简洁,简洁到有点反直觉:不设计新架构,只设计一个预训练阶段。
(一)阶段一 PAL:显式学习 P(z|x)
一对图像输入共享权重的 backbone,计算特征差的绝对值 |f(x_a) − f(x_b)|,再经过 global average pooling 和 global max pooling 聚合成一个 relation vector,最后由一个轻量 decoder 输出关系分数,用 pairwise BCE 损失训练模型判断这对图像是否 edit-related。
理论分析表明,这个 BCE 目标的最优解是在估计条件似然比 log(q_rel / q_neg)。只要数据构造满足 marginal matching 约束,语义先验就会被抑制,模型只能依靠编辑操作引入的 artifacts 来完成判断。
负样本的设计是这一阶段的关键。论文共构造了六种负样本对,沿两个维度变化:图像对的来源(同组、跨组、自身)和图像的状态(原图、篡改图)。
| 负样本对 | 构成 | 设计目的 |
Cross-group Original-Edited | 原图 + 另一组的篡改图 | 防止模型把 " 假图的通用统计特征 " 当成判断依据 |
Self-Augment | 原图 + 它自己的增强版本 | 区分篡改痕迹与无害的增强操作 |
In-group Edited-Edited | 同组两张不同的篡改图 | 把 " 图像被篡改过 " 和 " 具体是哪种篡改痕迹 " 解耦 |
In-group Original-Original | 同组两张不同的原图 | 防止模型利用语义相似性走捷径 |
Global Edited-Edited | 跨组两张篡改图 | 引入全局多样性,防止过拟合特定篡改模式 |
Global Original-Original | 跨组两张原图 | 提供纯语义变化的对照 |
这六种配对覆盖了模型可能利用的各类捷径。负样本的角色不是"陪衬",而是定义任务边界的那只手。如果负样本都是随手抓的无关图像,模型只要判断"两张图像不像"就能拿满分,根本不用管有没有编辑关系,那就退化回"隐式建模"的老毛病了。
(二)阶段二 SL:学习 P(y|z)
用 PAL 训练好的 encoder 作为初始化,然后按照与现有 IML 方法完全相同的标准协议进行定位训练(Protocol-CAT),保证公平对比。不同之处在于,模型此时从一个"已经具备 artifacts 感知能力"的表示出发,原本耦合的 P(y|x) 被简化为更直接的 P(y|z),对语义捷径的依赖随之降低。
需要特别强调:PAL 不改动任何现有 IML 模型的架构,只替换 backbone 的初始化权重。这是一种即插即用的训练范式,而不是一个新的网络模块。换句话说,它给所有 IML 检测器提供的是同一个"取证初始化",与具体网络结构无关,这也正是它能直接套用到后文 11 个模型上、且无一掉队的原因。
(三)为什么用 BCE 而不是对比学习?
一个自然的问题:既然是"对比真假",为什么不用对比学习?论文做了对照实验:
| 方法 | 类内紧致性假设 | 训练轮数 | Cross-Avg | All-Avg |
PAL-Con (对比式) | 需要 | 30 | 0.5548 | 0.5951 |
PAL ( BCE ,本文) | 不需要 | 12 | 0.5868 | 0.6266 |
原因在于篡改伪影本质上是异质的(heterogeneous)。copy-move、splicing、inpainting、全图生成,这些编辑相关对在关系空间里天然不构成一个紧致类。强行把它们拉近,会在不同篡改模式之间引入梯度冲突。而 BCE 只要求"能分辨编辑相关与非编辑相关",不施加任何类内紧致性假设,收敛更快(12 轮 vs 30 轮),上限也更高。这是一个很典型的"任务结构决定损失形式"的例子。
五、EditGroup-45K:让"关系"有 45,546 个组可学
要落地上面的逻辑有个前提:你得有成千上万组"原图—编辑图"配对。而现实是,几乎所有现有数据集都不具备这个结构。
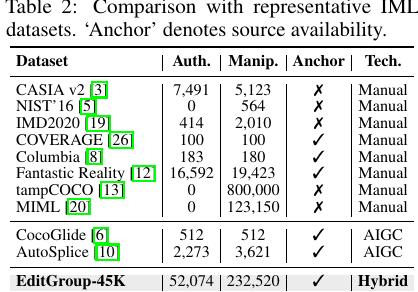
可以清楚地看到一个二分困境:要么有原图锚点但规模太小(Fantastic Reality 有锚点但只有 1.6 万真图),要么规模够大但没有锚点(tampCOCO 80 万张,却一张原图都不留)。而且现有数据还普遍"只走一条路",要么纯手工 PS,要么纯 AIGC 合成,无法反映真实世界中两种攻击并存的状态。
(一)EditGroup-45K 怎么建的
真实锚点来源:取自 M³(作者团队此前的篡改掩码生成工作),兼顾分辨率与语义多样性。
篡改生成双通道:① 手工篡改,用 Photoshop 等工具模拟传统篡改工作流,覆盖 copy-move、splicing、removal;② AIGC 合成,用 Doubao、Qwen-Edit、Banana、GPT-Image-1 做上下文感知的 inpainting 与内容改写。
组结构定义:每个编辑组 G_i 由"≥1 张真实锚点"与"≥1 张它的篡改变体"组成,强制建立严格的谱系依赖,组内所有样本共享同一语义内容,差异只来自施加的编辑。
一个容易被忽略但极其考究的细节:为避免模型从"与篡改无关的低层线索"(比如真实图和假图的 JPEG 压缩痕迹差异)取巧,真实锚点与篡改图经过了完全相同的后处理流水线。这一步是整个数据集可信度的地基。
| 组成 | 数量 | 占比 |
编辑组总数 | 45,546 | — |
真实图像 | 52,074 | — |
篡改变体 | 232,520 | — |
手工编辑 | 140,137 | 60.27% |
AIGC 编辑 | 92,383 | 39.73% |
copy-move | 70,958 | — |
splicing | 60,603 | — |
inpainting | 50,911 | — |
全图生成 | 50,048 | — |
约 28.4 万张图像总量,是目前唯一同时提供"大规模 + 原图锚点 + 手工/AIGC 混合"的 IML 基准。
六、理论保证:为什么这样"减"真的减出了伪影
这是全文最有分量的部分。论文给出了一个干净的贝叶斯最优解推导:
最小化成对 BCE 损失,判别器收敛到"编辑相关 vs 非编辑相关"的条件似然比(论文 Eq. 7→9)。这个式子的含义是:最优打分函数等于两个条件分布的对数比。而论文构造负样本时刻意满足了一个约束,边际匹配:
即:负样本的"边缘分布"要与正样本一致,但"条件关系"必须不同(论文 Eq. 10)。
这一句是全文的理论支点。如果 与 差得很远,那么 自己一个人就携带了标签信息(比如负样本系统性更干净、或来自完全不同内容域)。此时判别器完全可以靠"边缘语义先验"降损失,根本不用去看两图之间的编辑关系,语义捷径就是这样被引入的。
而一旦强制边际匹配, 单独能提供的标签信息被抽干了。在贝叶斯最优目标下,判别器只剩下唯一一条出路:依靠 与 之间的条件差异。而这个差异的来源,正是编辑过程本身,也就是 artifacts。
换句话说:理论证明了"减法"减出来的是伪影。而前面那六种负样本对,正是为了让这个约束在数据层面真正成立而设计的。
七、实验
实验采用 pixel-level F1 作为指标,统一使用 ConvNeXt-Small 作为 backbone,在 CASIA v1、Coverage、NIST16、Columbia、AutoSplice、CocoGlide 六个测试集上评估,覆盖域内与跨域场景。In-Domain 为源域内性能(CASIA v1),Cross-Avg 为五个未见数据集的跨域平均,All-Avg 为六数据集总平均。
(一)消融实验
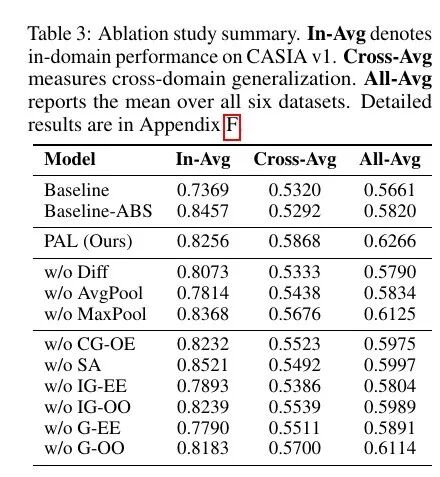
Baseline-ABS 那一行,是全文最有说服力的"反例"。用 EditGroup-45K 做绝对标签监督(真图标 0、假图标 1,不用成对关系),In-Avg 冲到 0.8457,比 PAL 的 0.8256 还高,源域表现更好看。但 Cross-Avg 是 0.5292,比什么都不知道的 Baseline(0.5320)还低,在 NIST16 上 0.3650、AutoSplice 上 0.3637,都比纯 Baseline 更差。在源域上刷分和学到可迁移的伪影表征,是两件完全不同的事。只有把成对关系作为监督,才能逼出那个真正泛化的信号。
消融表还有两点值得记住:一是显式差分是地基,去掉 |f(x_a) − f(x_b)| 后 Cross-Avg 从 0.5868 掉到 0.5333,几乎回到基线;二是去掉自增强负样本,In-Avg 飙到全表最高的 0.8521,Cross-Avg 却掉到 0.5492,典型的源域涨、跨域跌,是过拟合的信号。去掉组内篡改—篡改对则拿到最低的 Cross-Avg 0.5386,说明"在同一语义上下文内区分不同篡改类型"是最紧的约束。具体数字建议直接看原表。
(二)数据规模行为:PAL 与 ABS 的分水岭
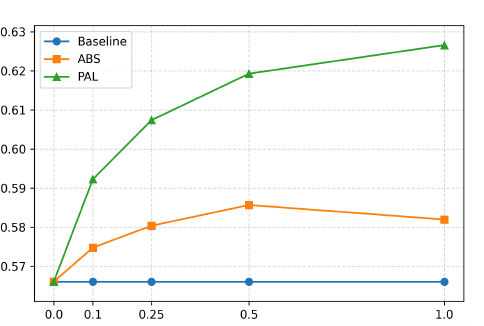
论文用不同比例的 EditGroup-45K 做预训练:PAL 的性能随数据量持续上涨,而 ABS 在用到 50% 数据时就趋于饱和,用满全量数据反而略有下降。原因在于数据集中部分锚点图像本身可能带有一些编辑或生成痕迹,ABS 直接给单张图贴标签会遇到标签冲突,而 PAL 学习的是图像对之间的相对差异,不受这个问题影响。关键不只是数据本身,还在于如何利用图像间的关系把 artifacts 学出来。
(三)迁移性实验:11 个模型,全线提升
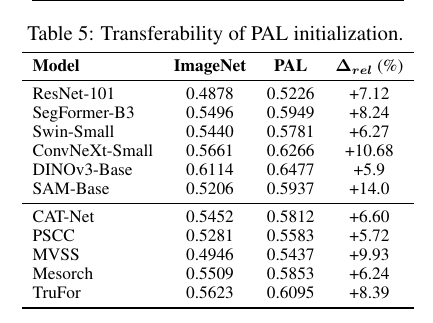
| 骨干 / 方法 | ImageNet 初始化 | PAL 初始化 | 相对提升 |
SAM-Base | 0.5206 | 0.5937 | +14.04% |
ConvNeXt-Small | 0.5661 | 0.6266 | +10.68% |
MVSS | 0.4946 | 0.5437 | +9.93% |
TruFor | 0.5623 | 0.6095 | +8.39% |
SegFormer-B3 | 0.5496 | 0.5949 | +8.24% |
ResNet-101 | 0.4878 | 0.5226 | +7.12% |
CAT-Net | 0.5452 | 0.5812 | +6.60% |
Swin-Small | 0.5440 | 0.5781 | +6.27% |
Mesorch | 0.5509 | 0.5853 | +6.24% |
DINOv3-Base | 0.6114 | 0.6477 | +5.94% |
PSCC | 0.5281 | 0.5583 | +5.72% |
11 个模型,无一例外,全部提升。三点信号:跨架构族有效,CNN、现代 ConvNet、层次化 Transformer、自监督基础模型、可提示分割骨干都涨,说明 PAL 不是靠卷积的归纳偏置吃饭;越强的基础模型增益越明显(SAM-Base +14.04%、DINOv3-Base +5.94%),提示 PAL 提供的是一种与骨干表征正交、可叠加的取证先验;老方法同样受益(MVSS +9.93%、PSCC +5.72%),因为 PAL 补的是它们最缺的那块,对语义捷径的免疫能力。
这正是论文所说的 universal performance booster(通用性能增强器):只要把 backbone 初始化换成 PAL 优化后的权重,无论后面接什么架构或已有方法,都能在跨域泛化上拿到一致提升,增益与具体网络结构无关。它的普适性不是口号,而是 11 个模型全线翻红给出的结论。
(四)鲁棒性:后处理操作下的表现
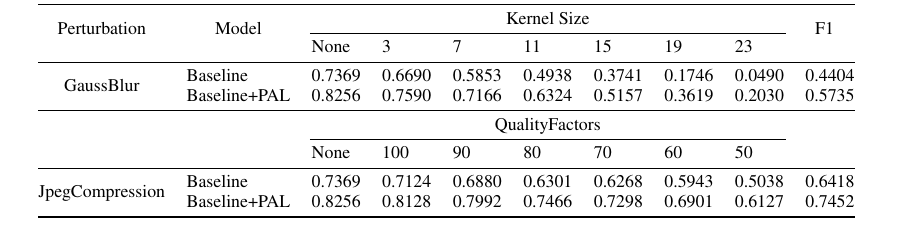
论文还测试了模型面对常见后处理操作的鲁棒性。在 CASIA v1 上分别施加不同强度的高斯模糊和 JPEG 压缩,PAL 在所有强度下都优于 Baseline,且性能退化更慢。
| 模型 | 核 15 | 核 19 | 核 23 | JPEG QF 80 | QF 60 | QF 50 |
Baseline | 0.4938 | 0.3741 | 0.1746 | 0.6301 | 0.5943 | 0.5038 |
Baseline+PAL | 0.6324 | 0.5157 | 0.3619 | 0.7466 | 0.6901 | 0.6127 |
重度模糊下 Baseline 已接近失效(核 23 时 0.1746),PAL 仍保持可用性能(0.3619)。这一点对实际应用比较重要,因为社交平台上的图片几乎都经过多次压缩。
(五)它真的学到伪影了吗?三个直接验证
光看下游指标不够,作者给了三个更直接的证据。
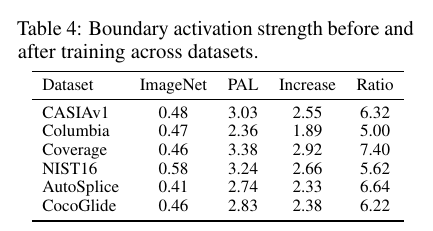
证据一:边界响应提升 5–7 倍。篡改伪影往往集中在边界区域。论文用 7×7 形态学腐蚀提取边界,测量 ImageNet 预训练编码器与 PAL 优化后编码器在边界上的特征激活强度,在全部 6 个数据集上稳定放大 5–7 倍,且源域与跨域数据集增幅一致,说明这是学到了某种普适的伪影敏感度,而非针对某个数据集的调参。
证据二:残差探针可视化。作者诚实地指出一个 gap:优化目标上的解耦,不等于物理特征上的解耦,因为 ImageNet 预训练本身就是一个"语义滤波器",且有效篡改必然伴随语义变化,所以原始特征差里语义分量是物理上不可避免的。于是用一个固定的 ImageNet 编码器去近似纯语义方差 S(f),再从模型响应中减掉它:
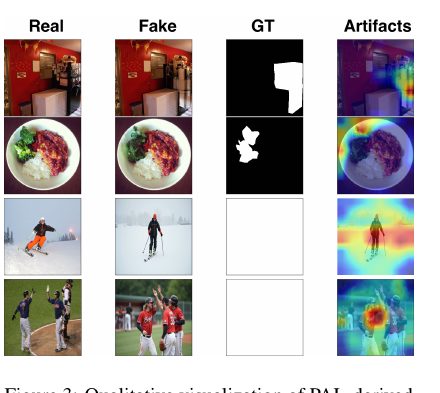
可视化结果显示了一个很有意思的分化:手工局部篡改的样本中,artifacts 响应集中在被篡改区域的边界处;AIGC 全图编辑的样本中,响应分布的范围更大。这说明 PAL 捕获的是与篡改方式相关的 artifacts,而非某种固定模式的边缘响应。
证据三:定位结果对比。
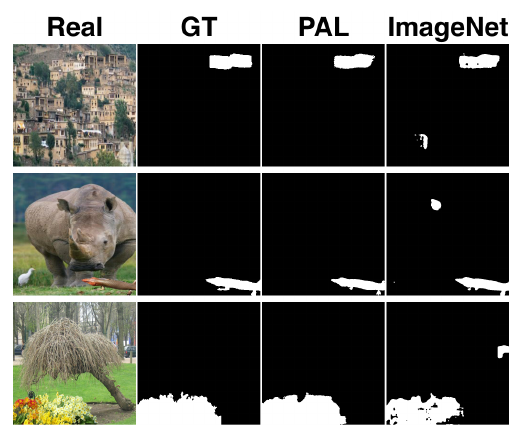
在 copy-move、splicing、inpainting 三类典型篡改上,PAL 预测的 mask 与 ground truth 更一致,误报区域也更少。这印证了 PAL 提供的是一个 artifact-aware 初始化,帮助下游定位模型聚焦于篡改相关区域,而非语义或背景干扰项。
(六)实现细节
基于 ForensicHub 框架训练,8×A100,输入统一缩放到 256×256;EditGroup-45K 按组级别划分 95% / 5% 训练测试(防止原图泄漏);最优超参为 lr 1e-4、12 epochs、正负样本 1:1,Stage I 测试 AUC 达 0.8926。
小结
这篇论文的朴素之处,在于它没去堆更复杂的网络,而是把"伪影到底是什么、模型到底该学什么"这个问题重新问了一遍。用"原图 vs 编辑图"这对关系把伪影从语义里显式剥出来,再把它作为初始化交还给任意检测器,整套方法即插即用、可解释、可迁移。对做图像取证的人来说,它给出的是一个可以接着用的训练范式和一份稀缺的关系型数据集,而不只是一个更高的分数。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。