KDD 2026 | 防护噪声形同虚设?哈工大(深圳)&清华提出TS-LFO:5种主流版权防御被大幅削弱,FID从364降至168
原创 52CV 2026-10-08 23:47 江苏
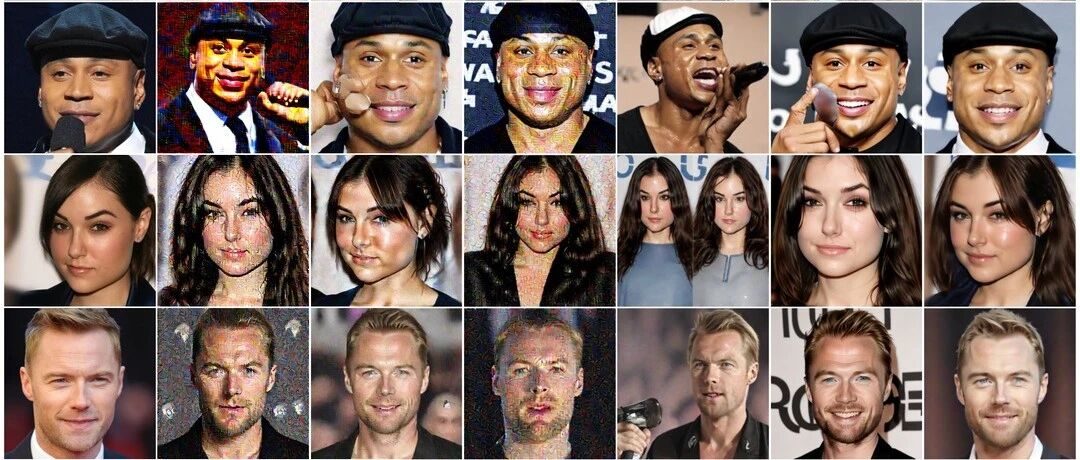
扩散模型个性化定制(DreamBooth、Textual Inversion 等)只需几张图就能“学会”一个人脸或一件作品,随之而来的是肖像盗用、作品抄袭等版权风险。为此,Anti-DreamBooth、AdvDM、SimAC、DisDiff 等方法给图像加上不可见的对抗扰动,让扩散模型“学不会”受保护的图像。
这些保护真的牢靠吗?哈尔滨工业大学(深圳)与清华大学深圳国际研究生院的研究团队发现:现有防御的本质是破坏“图像 → 潜空间”的映射,而这恰恰是它们的软肋。基于这一发现,团队提出 TS-LFO(Two-Stage Latent Feature Optimization),一种面向潜空间扩散模型(LDM)的两阶段版权攻击方法,无需知道对方用了什么防御,就能把被保护的图像“还原”成高质量的训练样本。
在 CelebA-HQ、LSUN-cat、LSUN-sheep 三个数据集、DreamBooth 与 Textual Inversion 两种定制方式下,TS-LFO 均能有效削弱 AdvDM、SimAC、DisDiff 等主流防御(DreamBooth 下还包括 Anti-DreamBooth,CelebA-HQ 上还包括 PhotoGuard),并在 FID 与身份一致性(ISM)上优于 DiffPure、GrIDPure、IMPRESS 等现有攻击方法;在 CelebA-HQ 上用 DreamBooth 对抗 Anti-DreamBooth,FID 从 364.30 直接降至 167.75,甚至略优于直接用未受保护原图训练的结果(172.42)。论文强调,这项工作旨在暴露现有防御的盲区,提醒社区重新审视版权保护方法的鲁棒性。该工作已被 KDD 2026 接收,代码已开源。
论文标题: Bypassing Copyright Protection in Diffusion-based Customization via Two-Stage Latent Feature Optimization
作者: Ziang Xu(共同第一作者),Wenbo Yu(共同第一作者),Hongyao Yu,Hao Fang,Jiawei Kong,Bin Chen(通讯作者),Hao Wu,Shu-Tao Xia,Zhiyong Wu
机构单位: 哈尔滨工业大学(深圳),清华大学深圳国际研究生院
1. 背景:对抗扰动能保护版权,也可能被绕过
基于扩散模型的个性化定制,让用户用少量样本就能生成特定概念的高保真图像,但也让恶意用户可以伪造受版权保护的视觉内容、冒用他人身份。
要理解保护与攻击,先回顾潜空间扩散模型(LDM)的训练:编码器 把图像 映射为潜变量 ,解码器 负责还原图像,Unet 去噪器 则通过预测加入潜变量的噪声来训练,其中 为加噪后的潜变量, 为文本条件嵌入:
目前主流的保护思路源自 AdvDM:针对扩散模型个性化训练的损失函数,在图像上优化出一个 有界的对抗扰动 ,使得模型用受保护图像 训练后,生成结果与原图相去甚远:
SimAC 在此基础上加入特征干扰损失与贪心时间步选择,DisDiff 则引入交叉注意力擦除模块。
而现有的“版权攻击”(DiffPure、GrIDPure、IMPRESS 等)大多沿用通用的“净化”范式,即盲目地去除扰动,并不理解防御究竟破坏了什么,攻击效果的上限因此受限。研究团队的出发点是:先搞清楚防御到底破坏了什么,再针对性地修复。
下图展示了版权攻防的三种场景:无保护时攻击者可直接盗用;仅有保护时攻击失败;而保护与攻击共存时,攻击者通过修改定制生成器,仍可能成功复现原图。
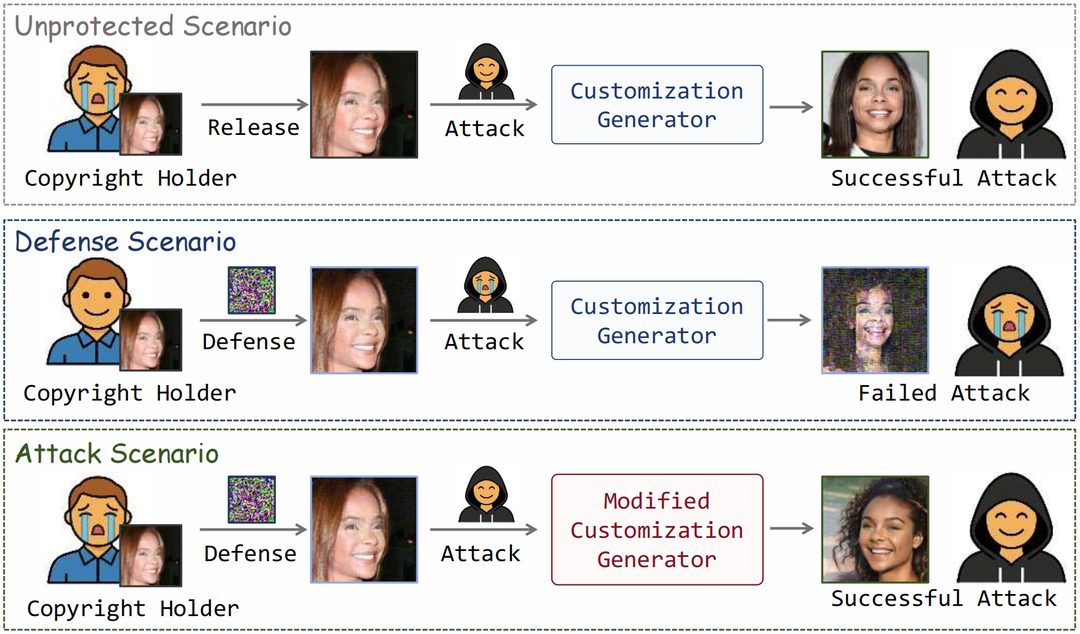
论文将威胁模型定义为:版权持有者发布带防御扰动的图像 ;攻击者对 LDM(VAE 与 Unet)完全白盒,但不知道所用的保护方法,也拿不到干净原图 ,目标是用 训练出仍能生成与 高度相似图像的定制模型。
2. 关键发现:保护扰动到底做了什么?
扩散模型个性化训练主要涉及两个核心模块:VAE 编码器 和 Unet 去噪器 。团队分别考察了保护扰动对它们的影响。
2.1 对编码器:图像与潜变量的映射被破坏
对受保护图像 ,将其潜变量 经解码器还原得到 ,再比较 与 的差异。如果编码器工作正常,两者应当非常接近。
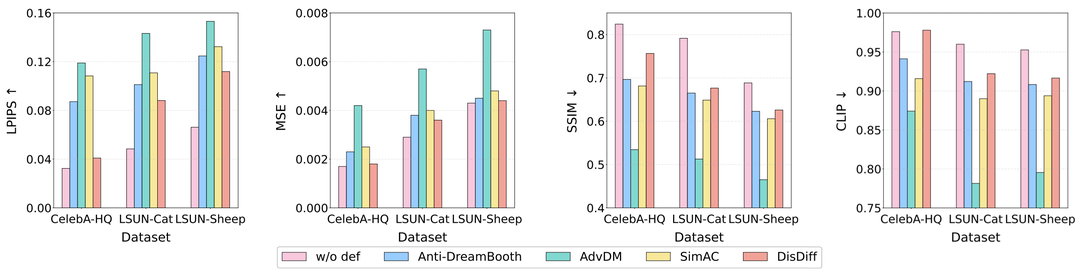
结果显示,所有防御方法处理后的图像,LPIPS 和 MSE 大幅升高,SSIM 和 CLIP 显著下降。以 CelebA-HQ 为例,无防御时 LPIPS 为 0.0324,AdvDM 将其提高到 0.1189(超过 3.6 倍),CLIP 相似度由 0.9761 降到 0.8742。也就是说,受保护图像编码出的潜变量是一个“失真”的表示,已无法准确描述图像本身。
2.2 对 Unet:训练损失被显著抬高
当语义不一致的潜变量被送入 Unet 训练时,会给模型提供相互矛盾、不稳定的学习信号。
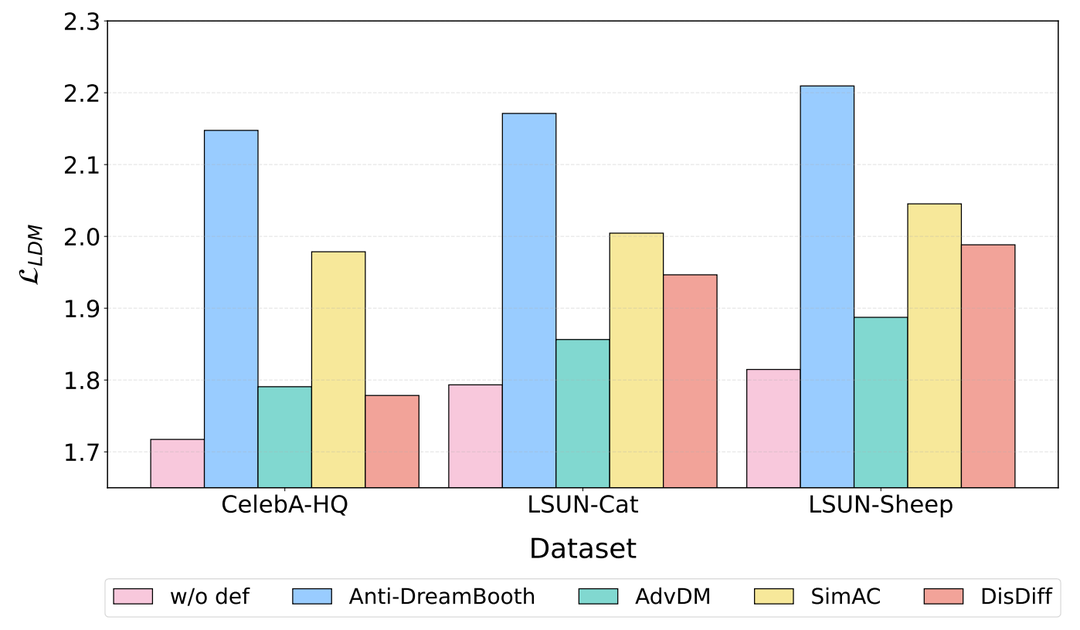
实验验证了这一点:所有保护方法都显著抬高了 Unet 的训练损失。CelebA-HQ 上基线损失为 1.7173,Anti-DreamBooth 将其提高到 2.1476,上升约 25%。
小结:现有防御依赖于(1)扰乱图像-潜变量映射,(2)抬高 Unet 训练损失。 TS-LFO 正是针对这两点设计的。
3. 方法:TS-LFO 两阶段潜空间优化
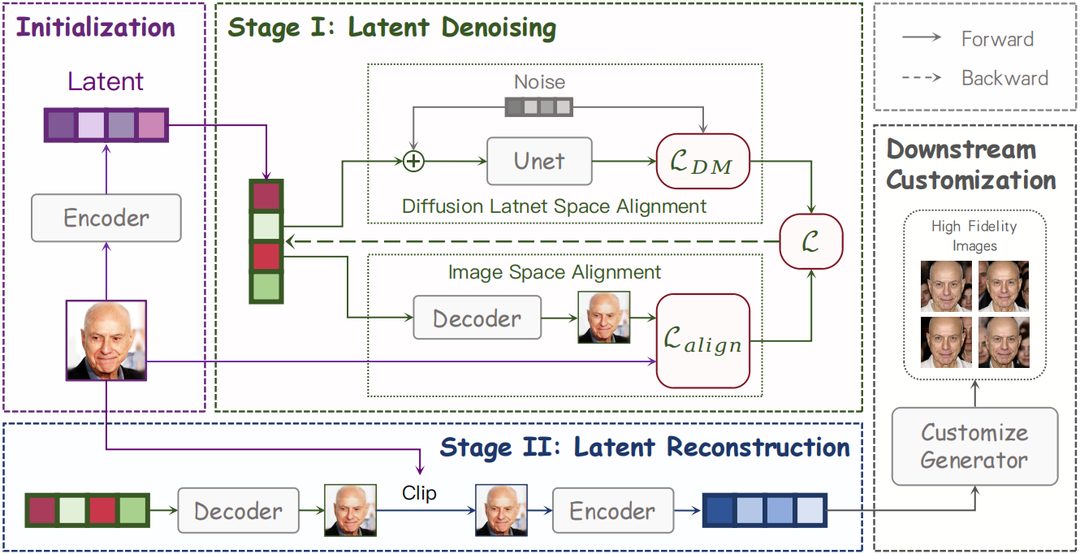
TS-LFO 的核心思路是直接在潜空间中优化潜变量 ,初始化为 ,分为两个阶段。
3.1 阶段一:潜变量去噪(Latent Denoising)
目标是去除高频对抗扰动,恢复潜变量与图像的语义一致性。为此设计了两个损失。
潜变量-图像对齐损失。 用解码器把优化中的 解码回图像,约束其与输入图像相似,对应 2.1 节发现的“映射被破坏”:
其中 是图像相似度度量。团队还有一个有意思的发现: 选用朴素的 MSE,反而优于 LPIPS、SSIM 和 CLIP,原因是这些高级度量容易把对抗扰动误当作合法特征。
潜变量扩散损失。 随机采样时间步 给 加噪,用冻结的预训练 Unet 预测噪声并计算误差:
最小化它,相当于让 成为预训练扩散模型眼中“易去噪、易学习”的特征,直接抵消防御对训练动态的干扰,对应 2.2 节发现的“训练损失被抬高”。
时间步相关的权重。 将两项损失以权重 相加,即:
作者观察到,固定 时 会随 增大而自然衰减,导致小 时偏重 、大 时偏重 ,优化失衡。为此采用随时间步线性变化的权重:
其中 为扩散总步数, 与 分别为初始与最终权重,分别取 和 。
3.2 阶段二:潜变量重建(Latent Reconstruction)
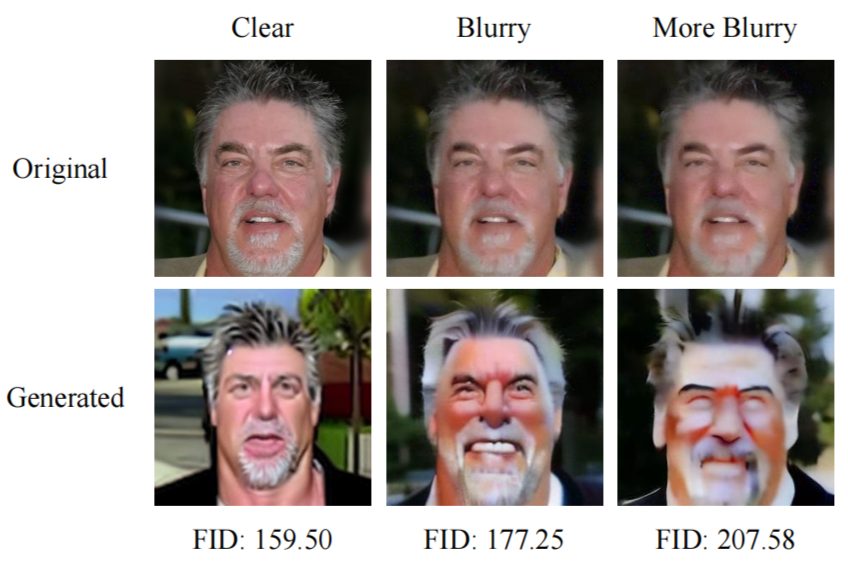
定制化是生成任务,输出质量高度依赖输入质量。作者用 Textual Inversion 做了验证:输入图像越模糊,生成图像与清晰原图的 FID 越高(159.50 → 177.25 → 207.58)。
阶段一得到的 虽然语义一致,但质量有所下降。因此阶段二对解码结果施加像素级约束,把它限制在 的 邻域内,再重新编码,其中 取 :
这样既保证 的语义不偏离原图,又恢复了低频结构与细节;即便残留少量防御扰动,对 LDM 训练的影响也可以忽略。
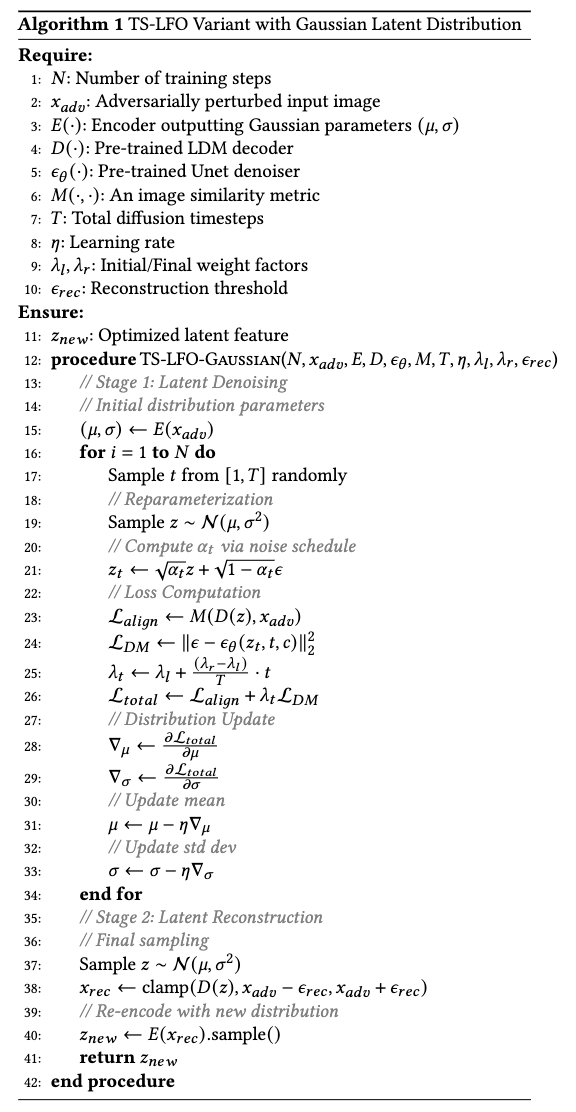
实际使用的 VAE 编码器通常输出高斯分布的参数 。为此,论文附录给出了变体算法:阶段一直接对 和 做梯度更新,阶段二再从该分布中采样、解码、约束并重新编码,思路与上述流程一致。
4. 实验结果
实验设置: 数据集为 CelebA-HQ(人脸)、LSUN-cat、LSUN-sheep;防御方法包括 PhotoGuard、Anti-DreamBooth、AdvDM、SimAC、DisDiff(噪声预算均为 16/255);对比攻击包括高斯噪声、IMPRESS、DiffPure、GrIDPure;下游定制采用 DreamBooth(SD-v2.1)和 Textual Inversion(LDM)。指标为 FID、CLIP 图像相似度、LPIPS,人脸数据额外使用 FDFR(人脸检测失败率)和 ISM(身份一致性)。优化器为 Adam,学习率 5e-3,共优化 3000 步。
4.1 对抗 SOTA 防御
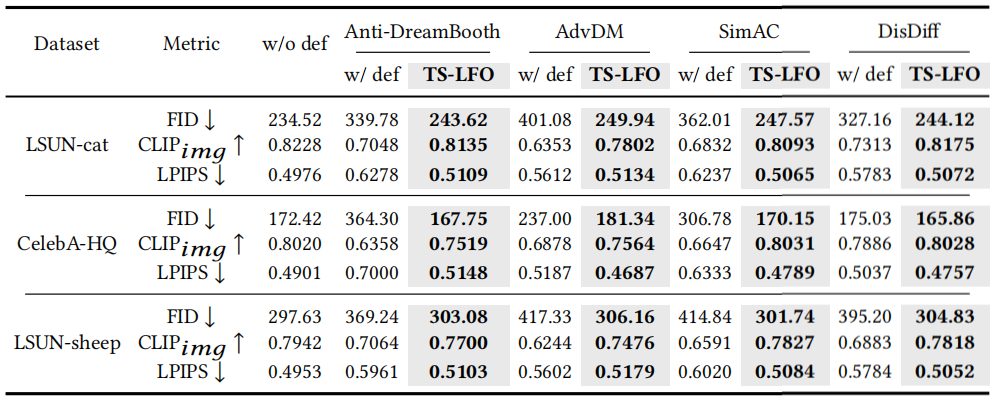
表1为 DreamBooth 的结果,覆盖 Anti-DreamBooth、AdvDM、SimAC、DisDiff 四种防御;表2为 Textual Inversion 的结果,覆盖 AdvDM、SimAC、DisDiff 三种防御。
DreamBooth:
Textual Inversion:
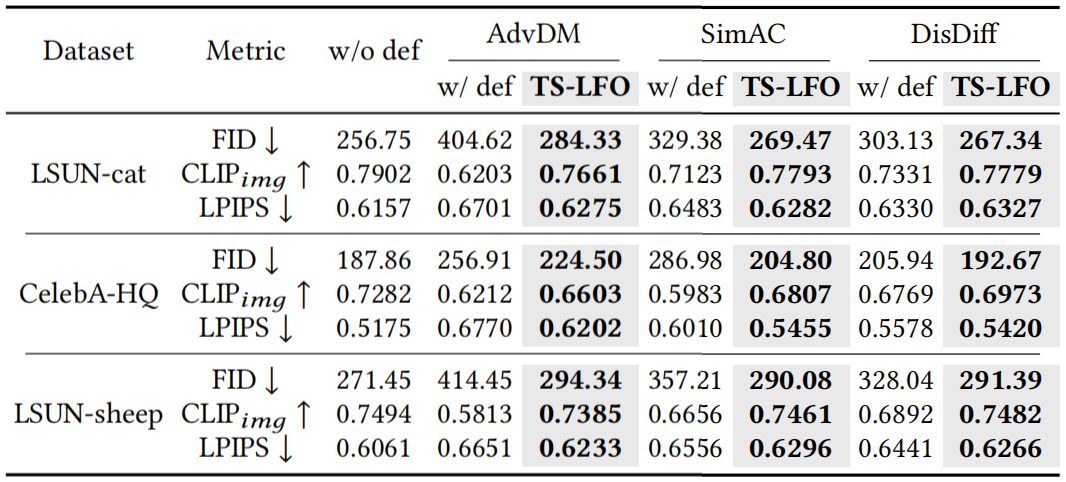
没有攻击时,防御确实能够破坏生成效果。以 Textual Inversion 为例,AdvDM、SimAC、DisDiff 使三个数据集的 FID 平均分别上升 119.97、85.84 和 40.35。而施加 TS-LFO 之后,防御效果大幅削弱:
DreamBooth:CelebA-HQ 上 Anti-DreamBooth 的 FID 由 364.30 降到 167.75,AdvDM 由 237.00 降到 181.34,均接近甚至优于无防御的 172.42;LSUN-cat 上 AdvDM 的 FID 由 401.08 降到 249.94,已接近无防御水平(234.52)。
Textual Inversion:AdvDM、SimAC、DisDiff 三种防御下,三个数据集的平均 FID 经 TS-LFO 处理后,分别由 358.66、324.52、279.04 降到 267.72、254.78、250.47,降幅 90.94、69.74、28.57。
4.2 与现有版权攻击方法对比
CelebA-HQ(人脸):
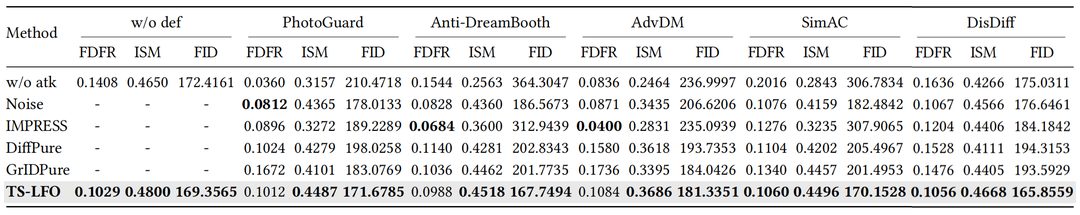
TS-LFO 在 ISM 与 FID 上全面领先其他攻击方法。例如面对 PhotoGuard,TS-LFO 的 ISM 为 0.4487、FID 为 171.68,优于 IMPRESS 的 0.3272 和 189.23。值得注意的是:
TS-LFO 并非专为 PhotoGuard 这类基于自编码器的防御设计,但其 FDFR(0.1012)依然低于无防御的干净图像基线(0.1408)。
在 PhotoGuard、Anti-DreamBooth、AdvDM 下,TS-LFO 的 FDFR 高于 Noise 和 IMPRESS,但仍低于干净图像基线;在更新的 SimAC、DisDiff 防御下,TS-LFO 的 FDFR 则是所有方法中最低的。
将 TS-LFO 直接用在没有任何防御的干净图像上,FDFR、ISM、FID 同样全面改善(FID 172.42 → 169.36),说明它是一种主动的潜变量优化器,而不仅是扰动过滤器。
更多数据集(附录):
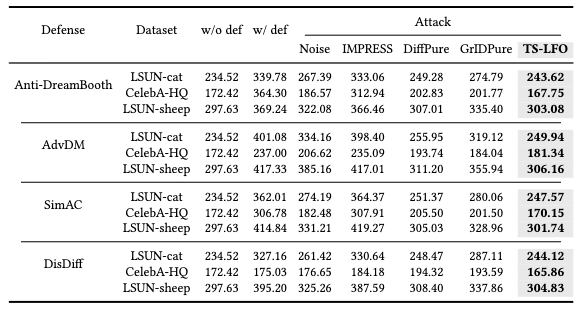
在 3 个数据集、4 种防御共 12 组设置中,TS-LFO 的 FID 均为最低。例如 SimAC 防御下,CelebA-HQ 上 TS-LFO 的 FID 为 170.15,比 DiffPure、GrIDPure 分别低 35.35 和 31.35;LSUN-cat 上为 247.57,比次优的 DiffPure 低 3.8。
另外,简单的高斯噪声表现出人意料地强:在 CelebA-HQ 的多数防御下,它甚至仅次于 TS-LFO,超过了 IMPRESS、DiffPure 等专门方法。这也说明现有攻防方法仍有很大的改进空间。
4.3 可视化对比与用户研究
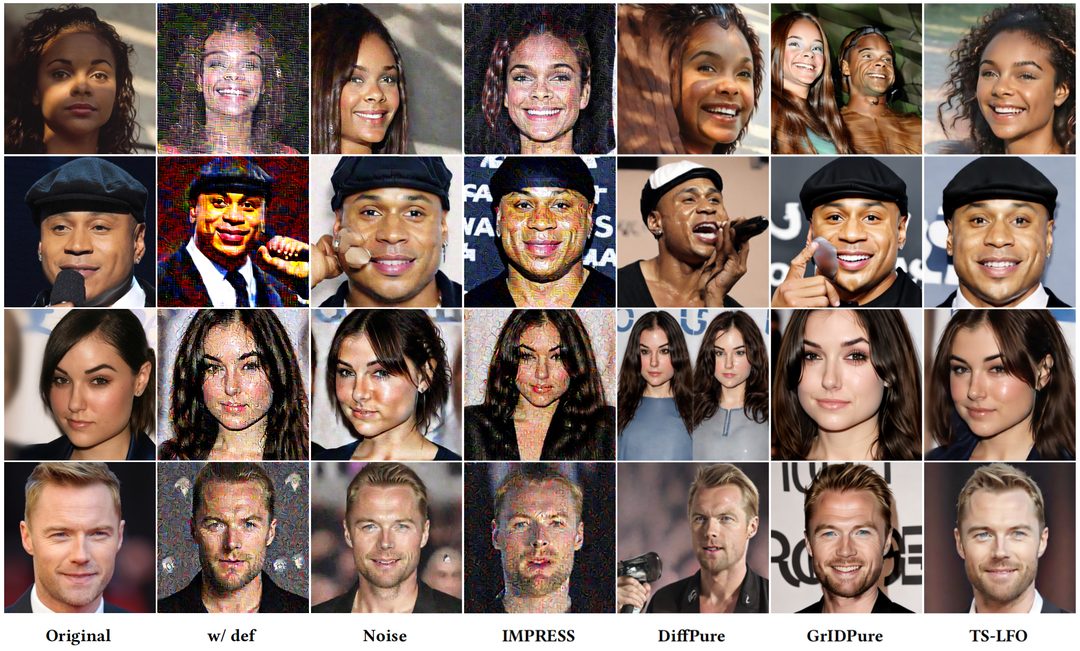
可以直观看到,在 Anti-DreamBooth 与 SimAC 两种防御下,相比其他版权攻击方法,TS-LFO 生成的图像与原图的相似度明显更高。
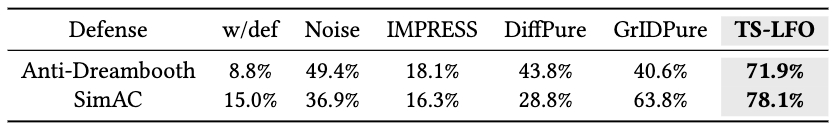
团队还邀请了 100 名用户参与主观评测,要求从各方法的生成结果中选出 2 到 4 张“质量最好且与参考原图最相似”的图像。TS-LFO 在两种防御下被选中的比例分别为 71.9% 和 78.1%,均明显高于所有对比方法(因为是多选,同一防御下各方法的比例之和可超过 100%):
4.4 消融实验
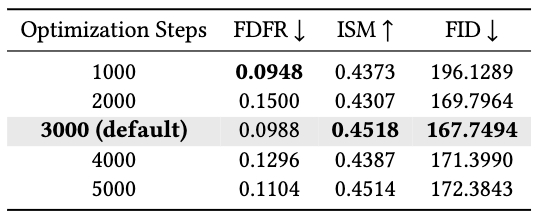
以下消融均在 CelebA-HQ 上进行,指标为 FID(越低越好)。前三项使用 AdvDM 防御与 Textual Inversion,优化步数一项使用 DreamBooth。
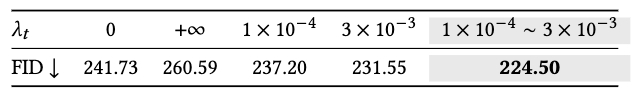
时间步相关的权重。 去掉 ()或去掉 (),FID 分别为 241.73 和 260.59;使用固定权重 或 ,分别为 237.20 和 231.55;而线性调度权重取得最优的 224.50。两项损失缺一不可,动态权重也优于固定权重。
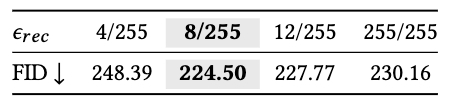
重建范围 。 不做重建()时 FID 恶化到 230.16,说明阶段二必不可少; 在特征质量与扰动幅度之间取得最佳平衡。
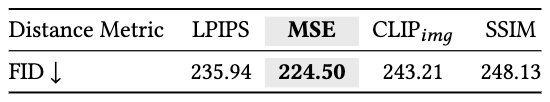
对齐度量。 在 LPIPS、MSE、CLIP 和 SSIM 中,朴素的 MSE 效果最好。
优化步数。 测试 1000 到 5000 步,3000 步时 ISM 与 FID 同时达到最优(0.4518 和 167.75),在欠拟合与过拟合之间取得了最佳平衡;步数继续增加后指标略有波动和下降,出现过拟合与优化不稳定的迹象。
4.5 对语义级水印防御同样有效
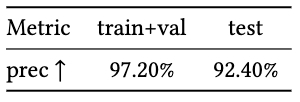
除了像素级对抗扰动,作者还测试了通过语义层面变化嵌入水印信号的 DIAGNOSIS 方法。团队先训练了一个二分类器,用来判断图像中是否含有 DIAGNOSIS 水印,其在训练加验证集上的准确率为 97.20%,在测试集上为 92.40%:
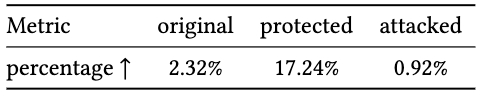
随后用该分类器检测各类图像经 DreamBooth 定制后的生成结果:受保护图像生成的结果中,水印检出比例相比原图基线(2.32%)显著上升,约为原来的 7 倍,说明 DIAGNOSIS 确实起效;而经 TS-LFO 处理后,检出比例降到 0.92%,甚至低于原图基线。
5. 总结与展望
TS-LFO 揭示了一个关键事实:现有基于对抗扰动的版权保护,依赖于扰乱潜空间中的“图像-潜变量”映射,而这一映射可以被针对性地修复。通过潜变量去噪与潜变量重建两个阶段,TS-LFO 能够在不了解具体防御方法的前提下,高效绕过 PhotoGuard、Anti-DreamBooth、AdvDM、SimAC、DisDiff 等主流保护。
这项工作也提醒社区:防御研究者往往只针对传统攻击评估鲁棒性,而忽略了更强的攻击。团队希望 TS-LFO 成为评估保护方法鲁棒性的基准,推动更稳健、真正考虑潜空间脆弱性的版权保护方案出现,在版权保护与开放创新之间取得平衡。

本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。