SGF+:仅5s训练实现24h自回归视频生成
alex 2026-10-11 21:11 江苏
分享最近做的一个流式视频生成的工作:SGF+: Decoupling Gradient Flows for Autoregressive Video Generation。在只使用 5 秒训练窗口的情况下,SGF+ 改善了视觉质量和长视频一致性,并展示了最长 24 小时的连续生成。
从 Self Forcing 到 Self Gradient Forcing
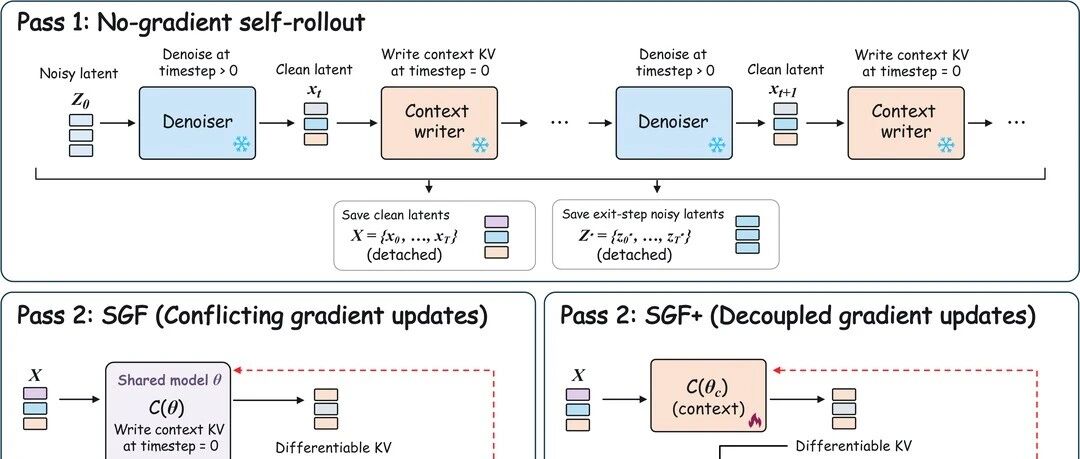
先从自回归视频生成的过程说起,每生成一帧或一个 chunk,模型主要做两件事。
第一步是去噪当前内容。 模型读取历史上下文,去噪当前帧(timestep > 0),逐步生成当前画面。
第二步是写入历史上下文。把生成好的干净帧在 timestep = 0 时再做一次 forward,得到历史 KV,供后续帧使用。
也就是说,模型既要学会“现在怎么画”,也要学会“这段内容应该怎样表示,才能帮助后面继续生成”。
而Self Forcing(SF)其实只优化了去噪这一步,没有优化上下文写入这一步。当推理的视频时长超过训练的视频时长时,误差累计非常严重,画面有明显的崩坏。
Self Gradient Forcing(SGF)就是在上下文写入这一步开启了梯度,模型学习到了如何更好生成memory以供后续帧使用,因此模型有良好的外推效果,生成长视频时误差累计明显减小。SGF 已被 SolarWM、Zing-0.5、XPACE、EditWorld、EchoWM等世界模型采用。
开启上下文梯度后出现了什么
不过,在部分样例中,我们发现 SGF 的首帧会比 SF 糊一些。
首帧很有意思,它还没有前面的历史视频 KV 可以依赖,因此可以帮助我们观察模型自身的去噪能力。SGF 相比 SF 只加入了上下文写入梯度,所以我们怀疑:用于“写好 memory”的梯度,会不会和用于“画好当前帧”的梯度互相干扰?
于是,我们把两类梯度单独拿出来分析,可视化如下。
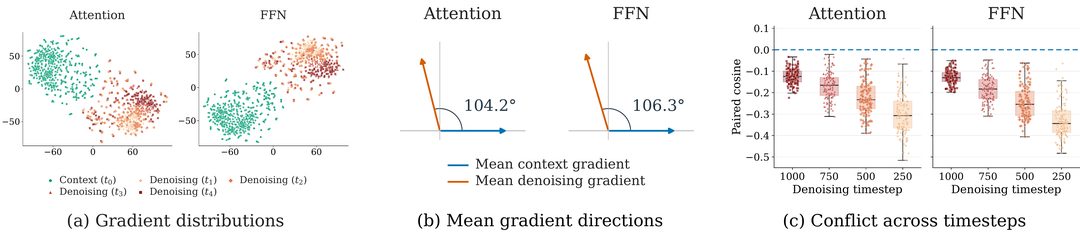
结果确实支持了这个猜测。在 Attention 和 FFN 中,两种角色的梯度在 t-SNE 可视化中形成了明显不同的簇。进一步看平均方向,两者的夹角分别约为 104.2°和 106.3°,都超过了 90°。我们还计算了梯度的配对余弦相似度:在 128 个 prompts × 4 个去噪 timesteps,共 512 对测量中,Attention 和 FFN 两类模块的配对余弦均为负。
这说明两者有明显的梯度冲突现象。因此SGF虽然开启了上下文梯度,但是由于梯度冲突,去噪(视觉质量)和上下文写入(外推)2个任务都得到了次优的结果。
SGF+ 让两个角色各司其职
基于这些观察,我们提出了Self Gradient Forcing Plus(SGF+),采用了最简单直接的方法,分离参数(类似MoE)。SGF+把这两种角色的参数分开:context writer 负责把干净的历史内容编码为 KV,denoiser 读取这些 KV,负责当前内容的去噪生成。
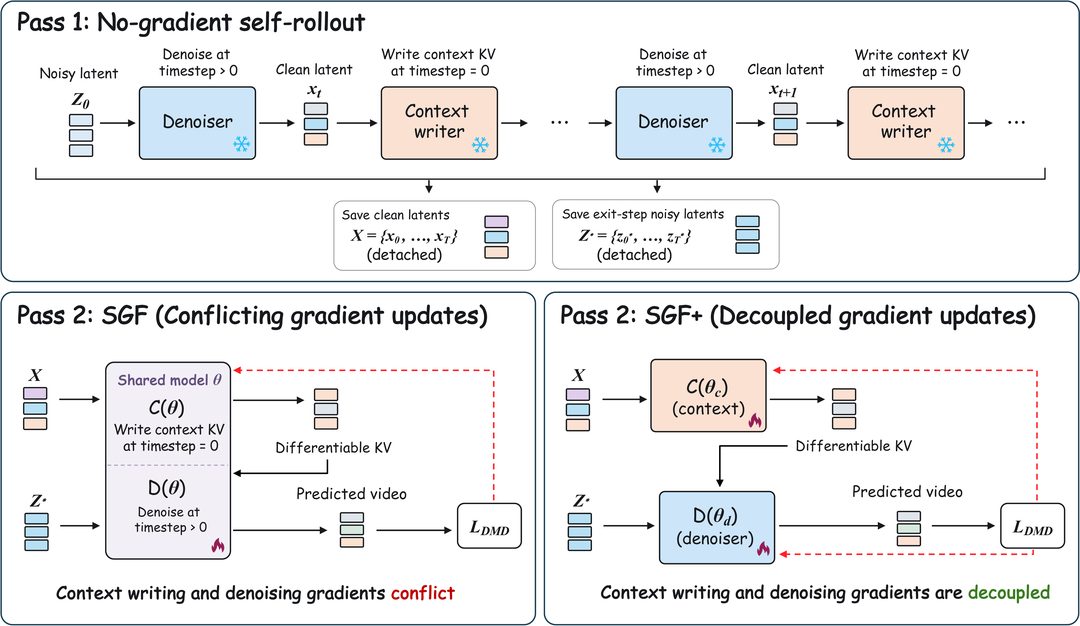
可以把它理解为按角色固定分工的两个专家:写上下文时调用一套参数,去噪时调用另一套参数。两者仍然通过因果注意力协作,并使用原来的生成目标联合训练。后续生成效果依然会监督 context writer,只是两条路径的梯度不再更新同一份参数。
整个方法保留了 SGF 的自生成 rollout 和可微 replay,无需额外的 loss、额外视频训练数据或 teacher 微调,也不需要把训练 rollout 拉长。
我们在 framewise 和 chunkwise 两种生成方式下,对比了 SF、SGF 和 SGF+,覆盖 5 秒、60 秒和 240 秒的视频生成。SGF+ 在多数质量与一致性指标上取得了更好的结果。此外,我们还展示了从 5 秒训练窗口外推到 24 小时连续生成的样例,没有进行长视频微调。完整视频可以在文末的项目主页查看。
一些思考
实际应用SGF+时可以在Attention和FFN开2份lora,一份lora负责一个任务。另外,我们建议把角色分离提前到 Teacher Forcing初始化阶段,因为在 TF 初始化模型上,已经能观察到两种角色的梯度分离和负向对齐。
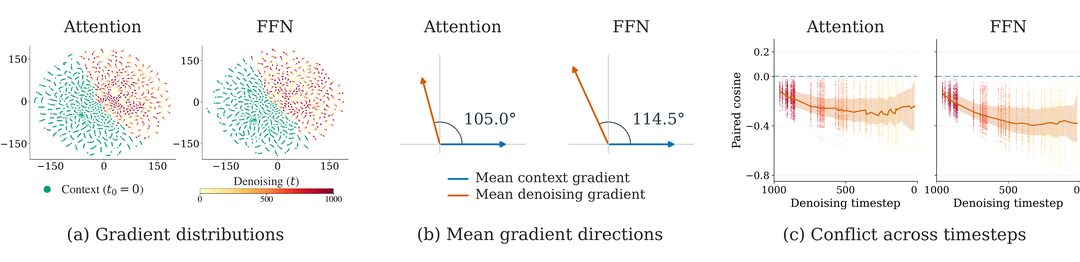
这项工作最想传达的观点是:对于自回归视频生成,上下文写入和去噪是梯度冲突的两件事情,针对这个冲突需要有针对的设计。
参数分离是我们采用的最简单直接的方案。对于多任务学习梯度冲突这件事情,还可以继续探索model merge等方法,还有不少探索空间,论文的附录也讨论了更多未来工作。
还有一个很自然的问题:LLM也要写 KV、预测后续 token,为什么自回归视频生成要把两个角色分开?语言理解与生成已广泛在统一的 token 预测框架下建模,视觉理解与生成的统一仍是开放问题。GPT 在一次 forward 中构建 KV 并预测 next token;自回归视频扩散在生成时,则交替执行 t=0 的上下文写入与 t>0 的去噪。我们猜测,这些输入状态与功能上的差异,可能使共享参数面临不同、甚至冲突的优化需求。
训练代码、推理权重和梯度冲突实验代码均已公开,欢迎大家交流~
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。