EMNLP 2026 Findings | RIDGE 让长视频关键帧保留事件前因后果
原创 52CV 2026-10-11 21:11 江苏
代码已开源
长视频理解中,模型答错问题,有时并非因为推理能力不足,而是关键证据没有进入它的视野。一段一小时的视频,即使每秒只采样一帧,也会产生约 3600 帧。面对有限的视觉输入预算,如何选出真正有用的画面,直接影响后续问答。
我们提出 RIDGE,将视频帧与问题之间的相似度序列视为随时间变化的信号,利用曲线的斜率与曲率识别不同阶段的证据,再根据问题需求分配选帧预算。它在保留事件核心画面的同时,兼顾事件之前的铺垫、之后的发展以及转折和上下文,无需额外训练,也不需要反复调用下游视觉语言模型。
在 Qwen2.5-VL-7B、32 帧设置下,RIDGE 在 LVBench 上较均匀采样提升 12.4 个百分点。论文已被 EMNLP 2026 Findings 录用,代码已开源。
论文标题:RIDGE: Region-Informed Derivative-Guided Evidence Selection for Long Video Understanding
论文作者:Shanqing Xu, Meng Luo, Mengchen Qian, Yuhui Gao, Siyue Peng, Xiaohan Zhong, Xiaojin Zhang, Zhongyu Wei, Wei Chen, Xiang Bai
研究单位:华中科技大学、新加坡国立大学、复旦大学
1 高相似度帧之外还有重要证据
现有查询感知选帧方法通常先计算每一帧与问题的相关性,再结合排序、覆盖率或多样性等策略,选出一个紧凑的帧集合。相关性得分提供了重要线索,但如果主要依据分数高低筛选,预算就容易集中到某个事件最显眼的时刻。
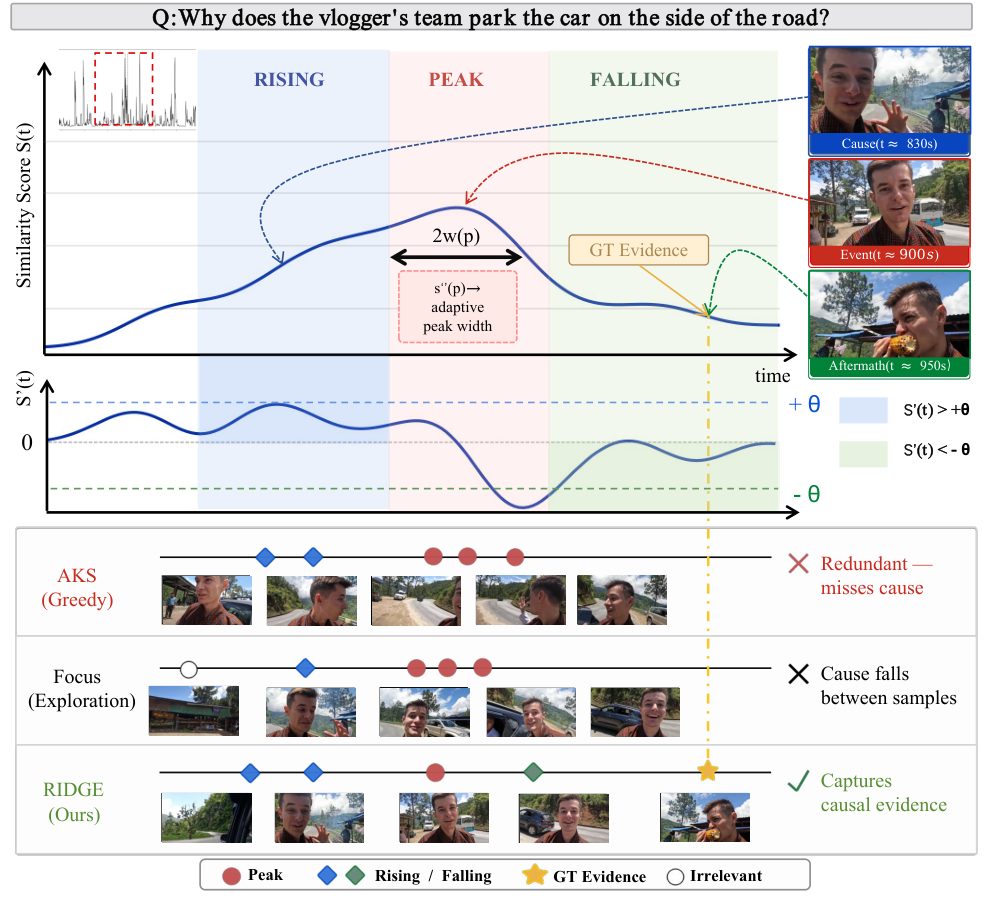
以“视频中的人为什么把车停在路边”为例,停车画面可能与问题高度相关,但解释停车原因的证据可能出现在此前的行为中,也可能需要结合停车后的活动才能确定。仅仅看到“停车”这一刻,未必足以回答“为什么”。
RIDGE 的出发点是:除了关注相关性曲线的高度,还要关注它如何上升、达到峰值、下降,以及在哪里发生明显变化。这些时序形态可以帮助寻找事件周围的证据。不过,上升和下降是相关性信号的结构,并不自动等同于语义上的原因和结果;最终仍需由下游模型结合实际画面回答问题。
2 从相似度曲线到有时序结构的证据集合
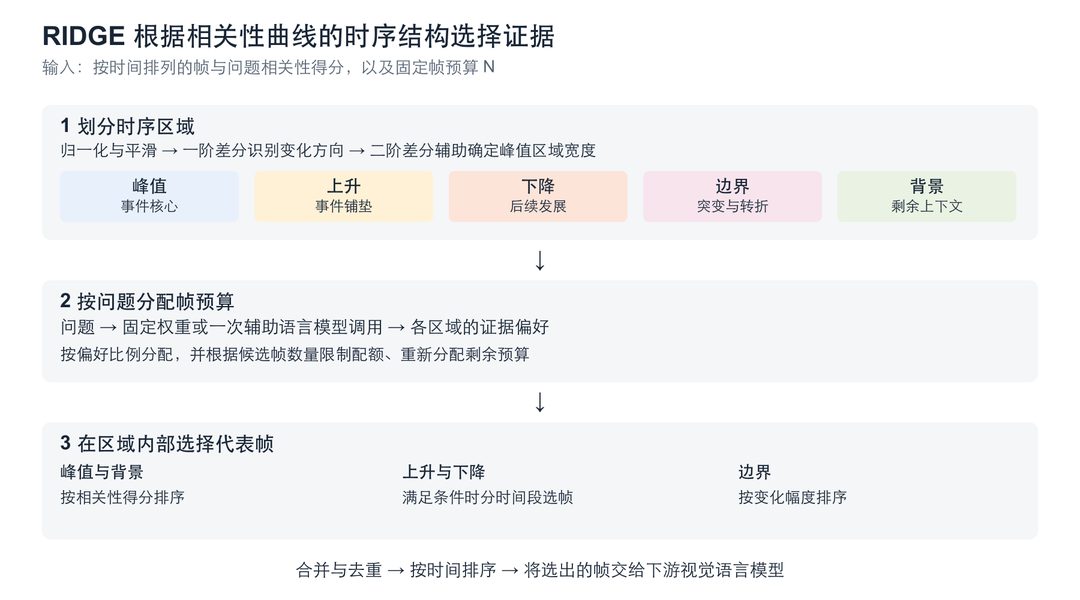
RIDGE 接收按时间排列的帧与问题相关性得分,以及预先设定的帧预算。方法包含三个阶段:划分时序区域、按问题分配预算,以及在各区域内部选择代表帧。最终选出的帧按原有时间顺序输入下游模型。
利用局部变化划分五类区域
RIDGE 先对得分序列归一化并进行高斯平滑,随后计算一阶与二阶差分。一阶差分描述相关性正在增加还是减少,以及变化有多快;二阶差分则帮助判断峰值的尖锐程度,进而调整事件核心区域的宽度。较尖锐的峰值采用较紧凑的窗口,较平缓的峰值采用较宽的窗口。
在此基础上,时间轴被划分为峰值、上升、下降、边界和背景五类区域。峰值对应潜在的事件核心;上升与下降区域覆盖相邻的发展过程;边界区域从剩余帧中识别相关性变化较快的位置;其余帧保留为背景上下文。RIDGE 可围绕多个满足条件的局部峰值建立区域,适应长视频中存在多个相关事件的情况。
根据问题决定证据预算
不同问题需要的证据并不相同。识别某个物体时,事件核心附近的清晰画面可能最重要;询问事件如何发展或发生之后的变化时,则可能需要更广的时间覆盖。RIDGE 使用六维证据偏好向量,表示对峰值、变化幅度、上升阶段、下降阶段、边界和上下文的需求,再将其映射为五类区域的预算优先级。
偏好向量既可以固定,也可以由辅助语言模型根据问题生成一次。各区域按优先级分配帧数,并根据实际候选帧数量设置上限,将未使用的预算重新分配。问题偏好还会调节峰值两侧的延伸范围,让需要过程信息的问题覆盖更宽的时间区间。
让选帧规则匹配区域的作用
在峰值与背景区域,RIDGE 优先选取相关性得分较高的帧;在边界区域,优先选择相关性变化幅度较大的帧。对于上升与下降区域,当区域长度和预算允许时,RIDGE 将其划分为若干时间段,并在每段内选择高分帧,避免所有帧都挤在邻近峰值的位置。最后合并、去重、补足预算并按时间排序,得到兼顾相关性与时序覆盖的视觉输入。
3 四个基准和三类模型验证选帧效果
我们在 Video-MME、LongVideoBench、MLVU 和 LVBench 上进行评测,使用 LLaVA-OneVision-7B、InternVL-3-8B 和 Qwen2.5-VL-7B 三类下游模型,默认帧预算为 32。Video-MME 采用无字幕设置,LongVideoBench 使用验证集,MLVU 报告开发集 M-Avg。对比方法包括均匀采样、AKS、BOLT、MDP³ 和 FOCUS。
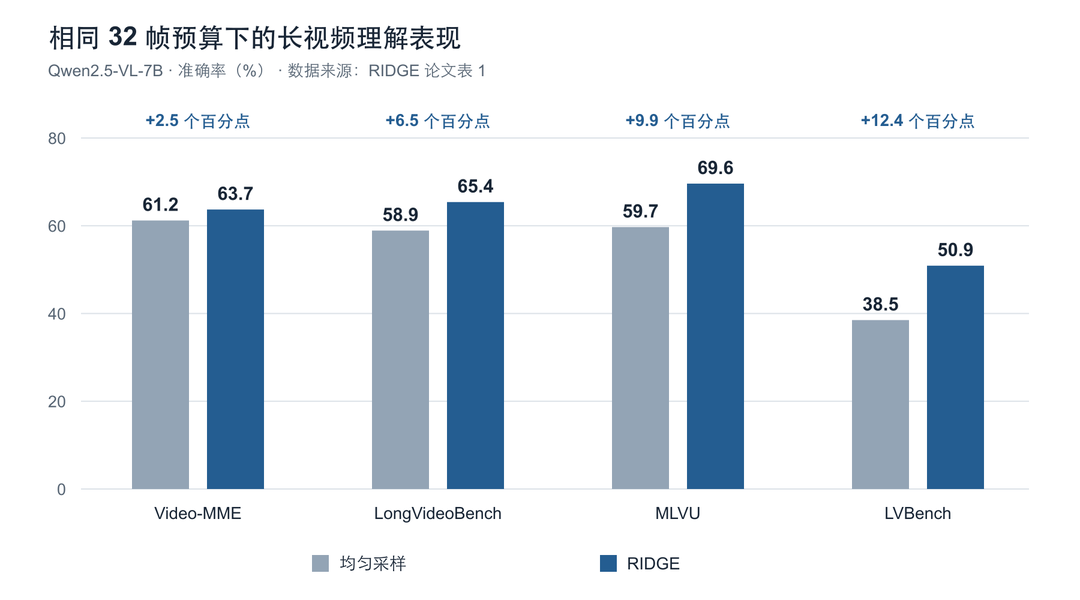
以 Qwen2.5-VL-7B 为例,RIDGE 在四个基准上均优于相同帧预算的均匀采样。具体结果如下。
表1 Qwen2.5-VL-7B 在 32 帧预算下的结果。分数单位为 %;提升为准确率的绝对差值。数据来源:论文表1。
| 评测基准 | 均匀采样 | RIDGE | 提升 |
|---|---|---|---|
Video-MME | 61.2 | 63.7 | 2.5 个百分点 |
LongVideoBench | 58.9 | 65.4 | 6.5 个百分点 |
MLVU | 59.7 | 69.6 | 9.9 个百分点 |
LVBench | 38.5 | 50.9 | 12.4 个百分点 |
在另外两类模型上,RIDGE 也在四个基准中均优于均匀采样。其中,InternVL-3-8B 在 LVBench 上由 43.5 提升至 54.5,LLaVA-OneVision-7B 由 40.4 提升至 48.9。这表明收益并不局限于某一个下游模型。与更强的选帧方法比较时,RIDGE 在多数设置下表现领先,但并非每项最优。例如,在 Qwen2.5-VL-7B 的 Video-MME 测试中,RIDGE 为 63.7,略低于 MDP³ 的 63.8。
控制打分模型后仍有收益
主实验保留各对比方法默认的相关性打分模型,因此论文进一步设置了相同打分模型的对照实验。在 Qwen2.5-VL-7B、32 帧条件下,同用 CLIP 得分时,RIDGE 的四基准平均分为 61.2,BOLT 为 57.7;同用 SigLIP 得分时,RIDGE 为 61.6,MDP³ 为 57.8。八项对应比较中,RIDGE 在七项上更高,说明提升并非仅由打分模型的选择带来。
时序结构与问题偏好共同发挥作用
LongVideoBench 上的消融实验显示,完整 RIDGE 得分为 65.4;去掉问题相关的证据权重后降为 63.8,去掉转折建模后降为 64.2,去掉上升与下降阶段的建模后降为 64.3。不同组件都对最终表现有贡献。固定权重版本仍取得 61.1 的四基准平均分,高于实验中的 FOCUS(59.7)和 AKS(59.2);采用问题相关权重后,平均分进一步提升至 62.4。
4 轻量选帧与模型扩展互为补充
RIDGE 在已有相关性得分上完成后处理,无需训练新的选帧网络。论文在 LongVideoBench、32 帧设置下测得,不调用辅助语言模型的选帧后处理约为每个视频 8.1 毫秒。这个数字不包含相关性得分计算,也不是视频问答的端到端延迟。若采用 Qwen3-8B 生成问题权重,每个问题还需一次辅助调用,论文测得约 0.6 秒;这不会增加下游视觉语言模型的调用次数。
更大的模型同样能从更合适的输入证据中受益。在 LongVideoBench、32 帧预算下,Qwen2.5-VL-72B 结合 RIDGE 后,准确率从 60.6 提升至 66.9,增加 6.3 个百分点。论文还在 8、16、32 和 64 帧预算下观察到相对均匀采样的提升。选帧质量与模型规模因此可以作为相互补充的改进方向。
5 从案例看模型获得了哪些证据
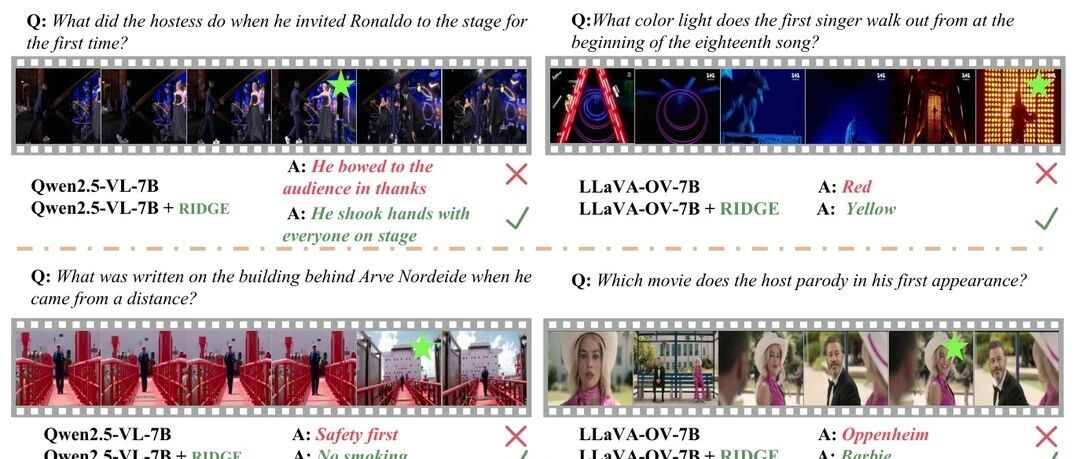
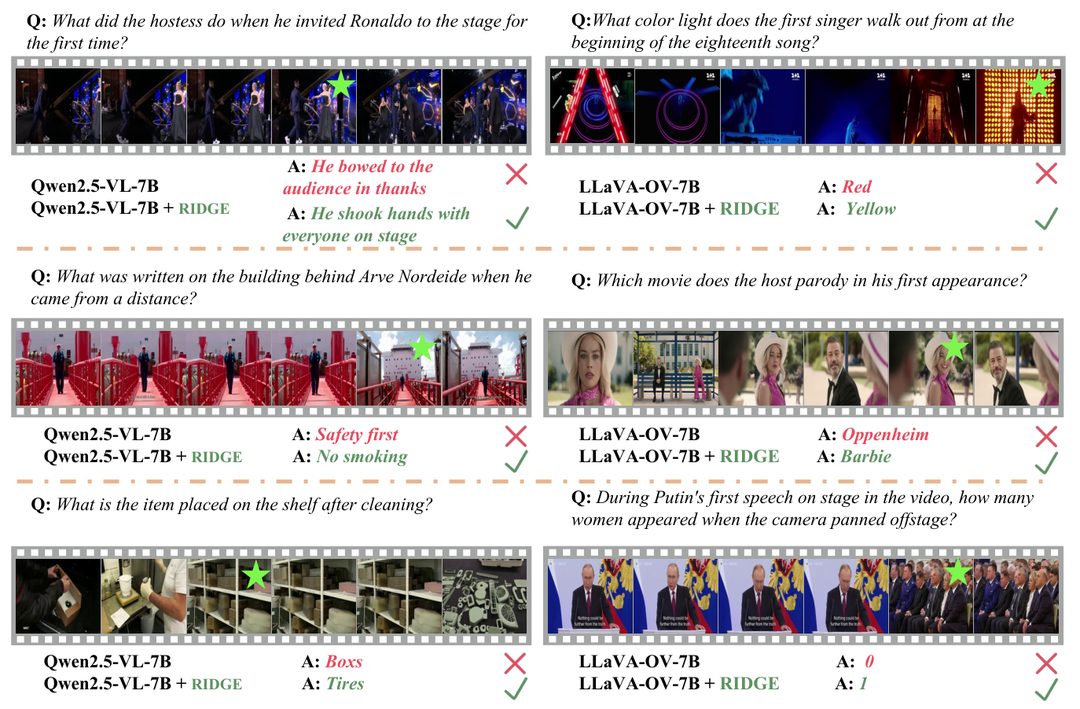
论文的可视化案例展示了选帧对细粒度视觉问答的影响。例如,在询问某首歌开场时歌手从什么颜色的灯光中走出的问题中,加入 RIDGE 后,模型获得相应时刻的画面,将错误答案“红色”纠正为“黄色”。在读取建筑物标语的案例中,模型也从错误的“Safety first”转为正确的“No smoking”。这些案例展示了关键画面进入输入后可能带来的变化,整体有效性则由前述基准实验评估。
6 开源与后续方向
RIDGE 提供了一种利用已有相关性信号改善长视频证据选择的思路:在有限帧数下,既保留事件核心,也为理解事件过程和上下文留下空间。它的效果仍依赖相关性打分的质量,曲线形态与真实事件语义之间也不是一一对应关系。如何在更复杂的视频中稳定识别跨事件证据,仍值得进一步研究。
项目已公开选帧算法、问题权重生成脚本、评测代码和最小输入示例,便于研究者接入现有的视频理解流程。基准视频与标注需从各数据集的官方来源获取。欢迎围绕长视频理解、证据选择与高效多模态推理交流。
供稿人:徐山青,华中科技大学软件学院博士研究生,论文第一作者。
参考资料
[1] Xu, S. et al. RIDGE: Region-Informed Derivative-Guided Evidence Selection for Long Video Understanding. arXiv:2608.29958, 2026. https://arxiv.org/abs/2608.29958
[2] RIDGE 官方代码仓库。https://github.com/Xssq999/RIDGE
[3] 华中科技大学软件学院。软件学院5篇论文入选NLP顶会EMNLP 2026。https://sse.hust.edu.cn/info/1026/4725.htm
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。