历史既能帮忙,也会误导:ReTurn 揭示多模态对话中的选择性历史使用难题
原创 52CV 2026-10-13 23:50 江苏
同一个问题、同一段视频,直接交给模型时能答对,放进几轮对话后,却可能答错。问题究竟出在看不懂,还是没有用对上下文?
随着多模态助手从单次问答走向连续交流,用户的提问也会自然地承接上文,或回到之前看过、听过的内容。以挑选衣服为例,我们可能先发一张外套照片,问“这件有帽子吗?”,再发来另一件,接着问“那这件呢?”。我们不会每次都把问题说完整,而是期待助手明白,这次仍然问的是帽子,只是要根据新照片重新判断。聊了几句后,我们也可能回头追问:“最开始那件是什么颜色来着?”这时,助手又得从之前的照片中找答案,不能只看最新发来的这一件。这样的交流很平常,却要求模型不断判断该沿用什么、该更新什么:历史里既有理解当前请求所需的信息,也有可能把回答带偏的旧答案;模型需要根据当前请求,将历史与当前信息正确结合。
来自哈尔滨工业大学(深圳)、智元机器人和清华大学深圳国际研究生院的研究者提出 ReTurn,用受控的配对任务评测选择性历史使用能力(selective history use):根据当前请求,从历史中选择所需的问题或证据,并与当前信息正确结合。在覆盖全模态、视觉语言和音频语言模型的评测中,13 个模型的开放式问答准确率中位数,从单轮输入的 93.7% 降至多轮对话的 72.3%。ReTurn 由此追问:那些直接问就能答对的问题,为什么进入多轮交流后,模型反而容易用错依据?
论文:When History Helps and Hurts: Selective History Use across Multimodal Turns
作者:Shuoyang Sun、Kerui Gu、Hao Fang、Shaoli Huang、Bin Chen
01 历史既是线索,也会成为干扰
先看两个直观例子。
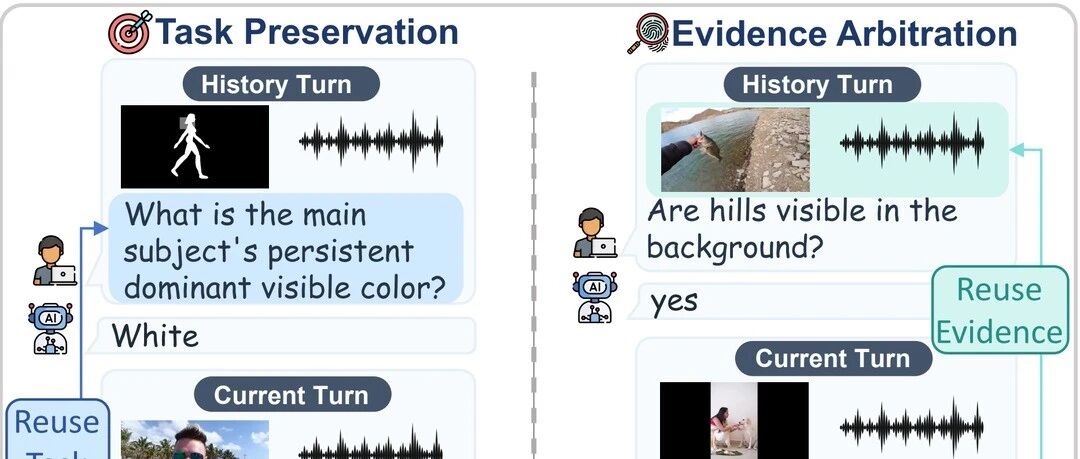
在第一个例子中,用户最初询问视频主体的颜色,答案是白色。随后换了一段视频,要求模型“再回答第一个问题”。模型需要保留“询问颜色”这个任务,但根据新视频回答黑色。如果仍沿用白色,保留下来的就是过时答案。
第二个例子则相反:用户的新问题明确指向第一段视频,正确答案是鱼。但当前视频出现了狗,模型却回答了狗。它找到了一个看起来合理的答案,却把问题对应到了错误的视频。
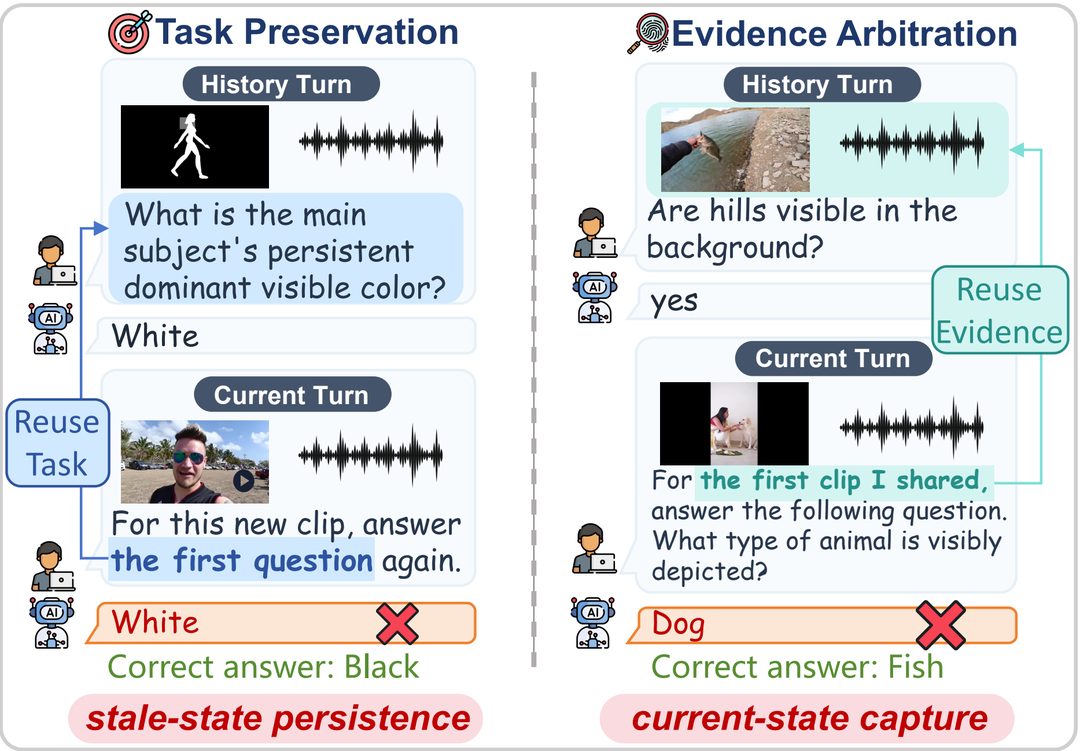
图1 两种互补的历史使用失败。左侧应继承历史问题,并根据当前证据更新答案;右侧应依据历史证据回答当前问题。图中正确答案分别为 Black 和 Fish。
这两个例子指向同一个要求:根据当前请求,保留必要的历史依赖,同时避免被不适用的信息带偏。 ReTurn 将这一要求转化为两个互补方向的受控任务。
02 任务与证据互换,单轮与多轮对照
这一次,该沿用历史中的问题,还是历史中的证据? ReTurn 围绕这一选择,设计了两个互补方向:沿用旧问题时,要根据新证据更新答案;追问旧证据时,要按新问题回到指定来源。历史与当前各自提供不可缺少的一部分,再通过两层受控对照观察模型是否用对了它们。
任务侧:历史问题 + 当前媒体。 模型必须从历史继承问题,再用当前视频或音频回答。Reconfirm 中,历史媒体与当前媒体支持相同答案;Reground 中,两者支持不同答案。后者要求模型保留问题,却不能照搬旧答案。
证据侧:当前问题 + 历史媒体。 当前轮给出完整问题,但目标证据在历史中。Retrieve 提供竞争较弱的当前媒体;Rebind 则加入支持另一个合理答案的当前媒体。模型需要始终回答被指定的历史来源。
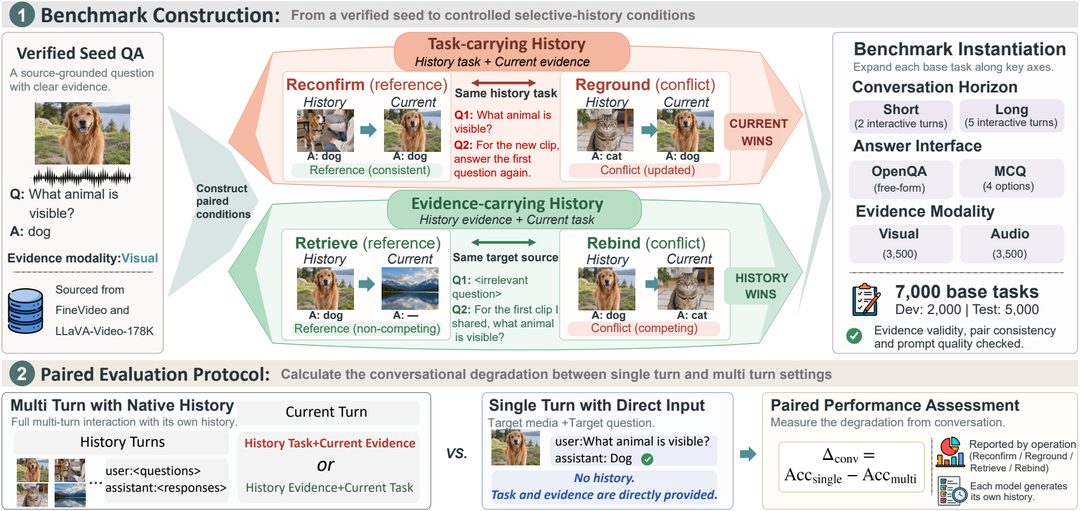
图2 ReTurn 的任务构建与配对评测(论文 Figure 2)。上半部分展示任务侧与证据侧的四类条件,每组配对保持目标问题、媒体和答案不变;下半部分将模型生成历史的多轮交互,与直接提供目标问题和媒体的单轮输入进行对照。
围绕这两个方向,ReTurn 设置了两层对照。单轮/多轮对照为每个任务提供相同目标的直接问答版本:将完整问题与目标媒体放在一起,先观察基础问题是否可答,再比较需要跨轮获取和组合信息时的表现。两者准确率之差记为对话性能下降 Δconv,以百分点计。
参考/冲突对照则保持目标问题、目标媒体和正确答案不变,只改变历史答案的一致性或当前媒体的竞争性。前一层衡量进入对话后的表现变化,后一层进一步观察模型在必要信息与干扰并存时,能否仍然选对依据。
ReTurn 共包含 7,000 个任务、3,500 组配对,覆盖视觉和音频证据,以及 Short 和 Long 两种配置,分别包含 2 轮和 5 轮带媒体的用户输入。每个任务同时提供开放式问答(OpenQA)与四选一(MCQ)两种形式。数据划分为 2,000 个开发任务与 5,000 个测试任务,后续主结果来自测试集。
素材取自 FineVideo 与 LLaVA-Video-178K,并通过大模型辅助的媒体验证与一致性检查构建任务。评测时,每个模型生成自己的历史回复;之前说错的话也会继续留在上下文中。
03 从整体掉点到条件差异 多轮交互难在哪里
ReTurn 覆盖全模态模型、视觉语言模型和音频语言模型,分别在模型支持的模态上进行评测。下图展示了一个跨越模型家族的共同现象:基础问题可答,并不意味着模型能在对话中正确定位和使用答案依据。
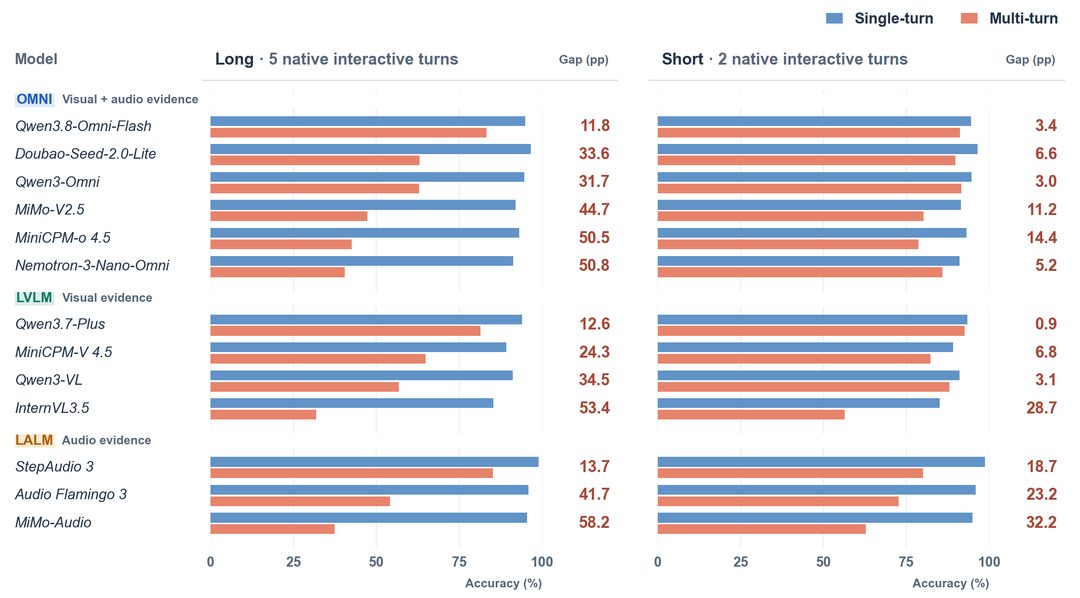
图3 13 个模型在 Test 上的 OpenQA 结果。蓝色为单轮,橙色为多轮;Gap 为两者之差,单位为百分点。Long 与 Short 分开展示,各行对应单个模型。
整体差距在 Long 配置中更为突出。 在 OpenQA 上,13 个模型中有 12 个的多轮准确率低于 Short;在 MCQ 上,13 个模型均如此。OpenQA 的模型级对话下降中位数,从 Short 的 6.8 个百分点增加到 Long 的 34.5 个百分点。这两种配置在历史长度和组成上均有差异,展示了模型面对更长、更丰富交互时的表现变化。
配对条件进一步揭示了冲突带来的困难。 图4(a)展示两条能力阶梯:单轮直接回答、在参考条件下使用历史,以及在冲突条件下完成跨轮组合。任务侧需要保留旧问题、更新答案,证据侧则需要根据新问题选中旧证据。在 Long OpenQA 中,模型级准确率中位数从 Reconfirm 的 79.5% 降至 Reground 的 48.5%;从 Retrieve 的 78.9% 降至 Rebind 的 19.9%。相关历史能够帮助模型回答,但竞争信息出现后,模型未必还能坚持正确的目标。
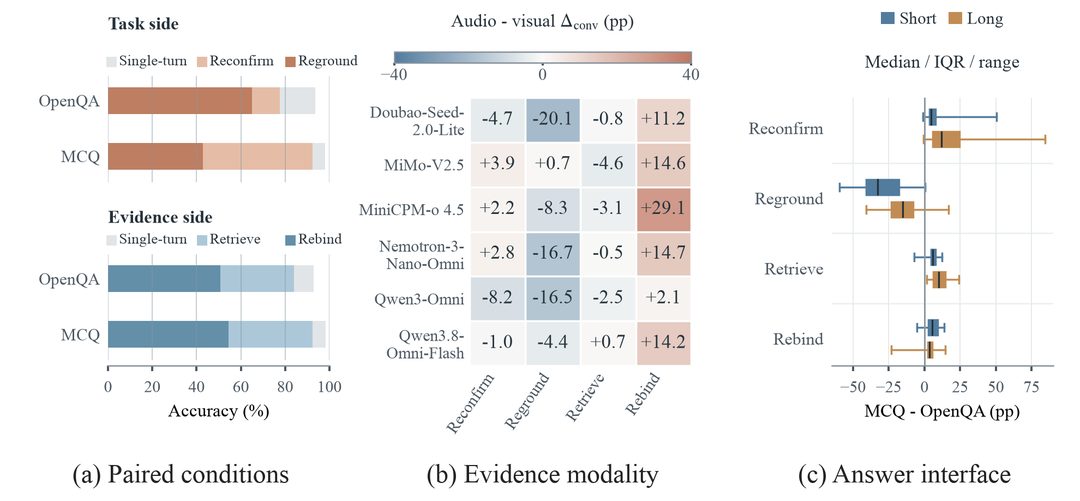
图4 配对条件、模态与回答形式(论文 Figure 3)。(a) 汇总两种长度、基于完整配对的 13 模型平均准确率;横条覆盖绘制。(b) 六个全模态模型的音频减视觉对话下降,汇总长度并平均两种回答形式。(c) 13 模型的 MCQ 减 OpenQA 准确率,按长度展示中位数、四分位区间和范围。差值单位为百分点。
模态差异取决于历史承担的角色。 图4(b)中,六个全模态模型在 Rebind 上的音频掉点均大于视觉;而在 Reground 上,其中五个模型的视觉掉点更大。同一批模型在两侧呈现不同趋势,说明应结合任务中的历史依赖来理解模态差异,而不能简单归结为“音频更难”或“视觉更难”。
选择题也不总比开放问答容易。 图4(c)中,Reground 的 MCQ 相对 OpenQA 呈现出更明显的负向差异。以 Qwen3-Omni 为例,两种形式的总体多轮准确率几乎相同,但 Reground 分别为 81.76%(OpenQA)和 57.76%(MCQ)。任务侧选择题还需要继承之前的候选项及字母映射,这可能构成额外的困难。
总体准确率由此呈现出不同的失败模式。要进一步解释这些差异,还需要观察模型究竟能获取哪些历史信息,以及这些信息如何影响最终回答。
04 记得历史,为什么还会用错
研究据此考察两个互补的能力需求:历史获取(history access),即恢复所需的历史问题或媒体信息;以及跨轮绑定(cross-turn binding),即将历史问题与当前证据、或当前问题与历史证据正确配对,同时抵抗竞争内容带来的错误关联。
发现一:记得问题,不等于用对问题。 在 Reground OpenQA 的问题回忆探针中,Qwen3-Omni 和 Qwen3.8-Omni-Flash 分别达到 96.8% 和 99.8%,但原始对话任务准确率为 81.8% 和 84.1%。将历史问题在当前轮重新明确写出后,准确率升至 95.2% 和 96.4%。模型在独立探针中能回忆出问题,却仍可能在实际对话中用错;将问题重新明确后,表现明显改善。
相比之下,中和历史中的旧答案并没有带来一致收益,三个受测模型中有两个反而下降。仅去掉旧答案,不能替代把需要继承的任务说清楚。
在证据侧,研究先检查历史来源的信息是否仍可获取。 在针对历史媒体的独立事实问答中,受测模型的 OpenQA 准确率达到 66.9%–85.7%,说明历史来源中的相当一部分信息仍可被利用。这些信息可能来自媒体本身,也可能得到历史文本的帮助。
发现二:准确率几乎没变,错误答案却跟着干扰内容走。 研究固定历史目标,只替换当前轮的竞争媒体,观察模型的回答会不会随之改变。以 Qwen3-Omni 为例,目标准确率从 52.6% 变为 51.7%,变化很小;但模型答案与替换后媒体所支持答案的一致率,从 0.1% 升至 36.5%。两个时点均使用同一个替换媒体答案进行比较。
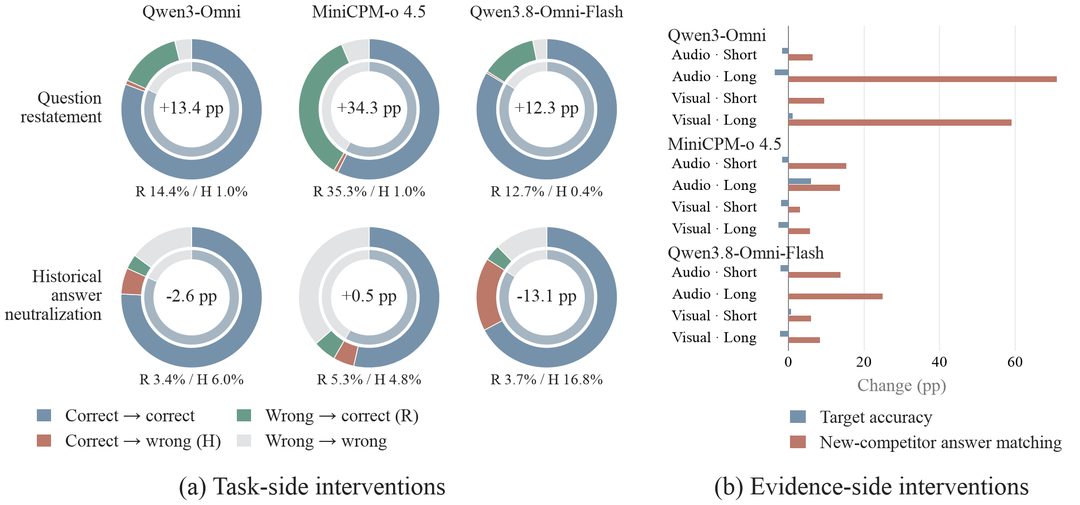
图5 历史使用的行为诊断。左:重述问题与中和旧答案的效果不同,环图区分保持正确、修复、损害和保持错误;右:替换当前竞争媒体后,目标准确率变化较小,但回答更倾向于匹配新的竞争答案。pp 表示百分点。
在 12 个受测配置中,都观察到了替换答案匹配率上升。只看答对多少,会漏掉模型究竟跟随了哪一份证据。 这一诊断将总体掉点进一步落实到具体行为:历史目标没有变,回答却受到当前非目标内容的牵引。
05 从诊断到改进 如何帮助模型选对历史
围绕任务继承与证据选择,研究设计并比较了推理时干预和训练适配两条路径。前者直接调整模型如何使用已有上下文,后者利用 ReTurn 的对话与配对结构进行学习。
推理时:重述任务、重加权上下文,再按请求结构路由。 Restatement 将历史问题在当前轮明确写出,选择题同时恢复原有选项。Reweighting 则根据请求中的媒体指向,在生成最终答案时降低对非目标媒体和历史助手回复的注意力权重,减弱竞争内容的影响。
在此基础上,Routed policy 将两类干预组合起来:需要继承历史问题的请求使用重述;已经给出完整问题的请求使用重加权。策略依据用户可见的请求结构与媒体指向选择路径,不使用正确答案或四类任务标签。这个设计直接对应了 ReTurn 的两侧需求:把需要继承的任务说清楚,以及帮助模型选择被指定的证据。
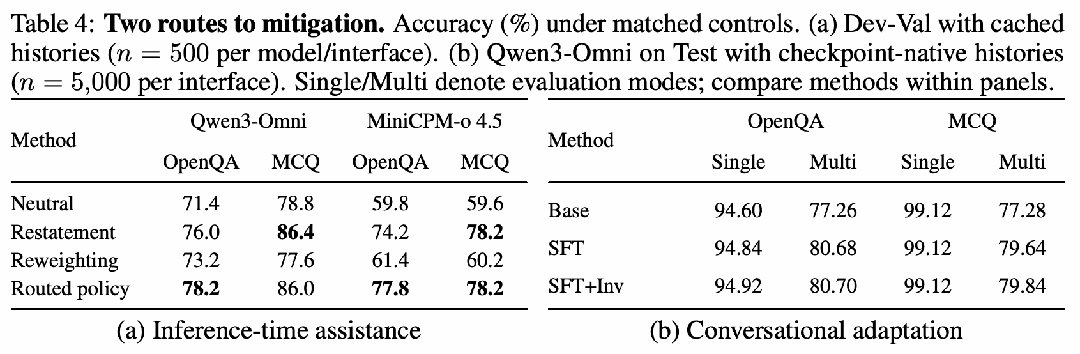
表1 论文 Table 4 原表。左侧是 Dev-Val 上的推理时干预,每个模型/回答形式 500 个任务;右侧是 Qwen3-Omni 在 Test 上的训练适配,每种回答形式 5,000 个任务。两侧使用不同评测设置,应分别在各自子表内比较。
在 Dev-Val 的 OpenQA 上,Routed policy 将 Qwen3-Omni 从 71.4% 提升到 78.2%,将 MiniCPM-o 4.5 从 59.8% 提升到 77.8%。它在这两组结果中均超过单独重述;MCQ 中则与重述接近或略低,说明两类干预的组合收益随模型与回答形式而变化。
训练时:原生对话 SFT 与配对一致性约束。 研究使用 1,018 个 Short OpenQA 训练视图对 Qwen3-Omni 进行 SFT,并进一步测试 SFT+Inv:对保持正确答案不变的配对任务,约束模型的答案分布保持一致,鼓励它在竞争条件变化后仍围绕同一目标作答。
SFT 将 Test 上的 OpenQA/MCQ 多轮准确率分别提升 3.42 和 2.36 个百分点;仅用 Short OpenQA 训练,也在 Long OpenQA 上获得了 4.36 个百分点的提升。SFT+Inv 在本次实验中与 SFT 表现接近,主要收益来自监督适配。
这些方法将诊断转化为可测试的改进方向:显式恢复任务、降低非目标上下文的影响,以及利用受控配对训练更稳定的历史使用能力。ReTurn 也能进一步区分,收益发生在任务侧还是证据侧,以及能否从短对话扩展到更长的交互。
06 从会看会听,走向会在对话中使用信息
ReTurn 将多模态交互中的一个自然需求变成了可以控制和比较的评测问题:如何根据当前请求,结合历史与当前信息作答。旧问题需要应用到新证据上,新问题也可能需要回到旧证据中寻找答案;两种情况下,模型都必须同时处理跨轮依赖与竞争信息。
当多模态模型走向持续交互,评测需要同时关注信息的感知、保留与使用。ReTurn 的配对设计、跨模型评测和行为诊断,为研究这些能力之间的差距提供了工具,也为后续的上下文组织、训练与推理策略提供了可检验的方向。
论文、项目主页及代码仓库已上线。数据侧目前提供 80 个开发任务的预览及配套媒体,完整数据集即将发布。欢迎使用现有推理与评测入口,探索模型在不同历史条件下的表现。
Hugging Face:https://huggingface.co/datasets/Link-world/ReTurn
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。