NeurIPS 2026 | 不止记住摘要,OmniMem让长视频生成直接检索完整历史
原创 52CV 2026-10-14 23:10 江苏
生成长视频,难道只能一边向前,一边遗忘?删掉早期画面,主角容易变样;把历史压成摘要,又可能找不回关键细节。美国东北大学与Adobe Research提出的OmniMem,首次实现完整历史的长视频生成,让模型实时检索当前需要的记忆。

论文首页的标题、作者与单位信息。
论文标题:OmniMem: Scalable and Adaptive Memory Retrieval for Long Video Generation
作者:Lin Zhao、Yushu Wu、Yifan Gong、Yanzhi Wang、Pu Zhao;前两位为共同一作。
机构:美国东北大学(Northeastern University)、Adobe Research。
完整历史保留下来 需要什么再取什么
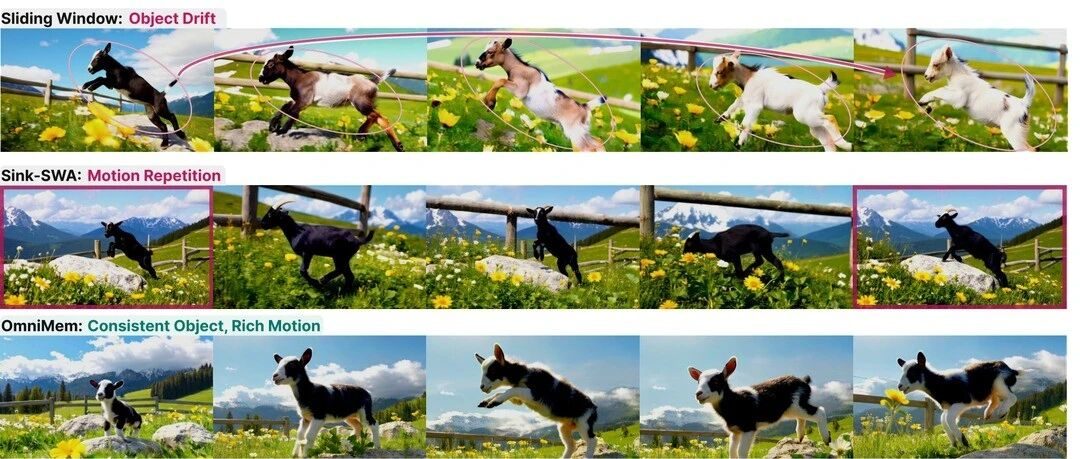
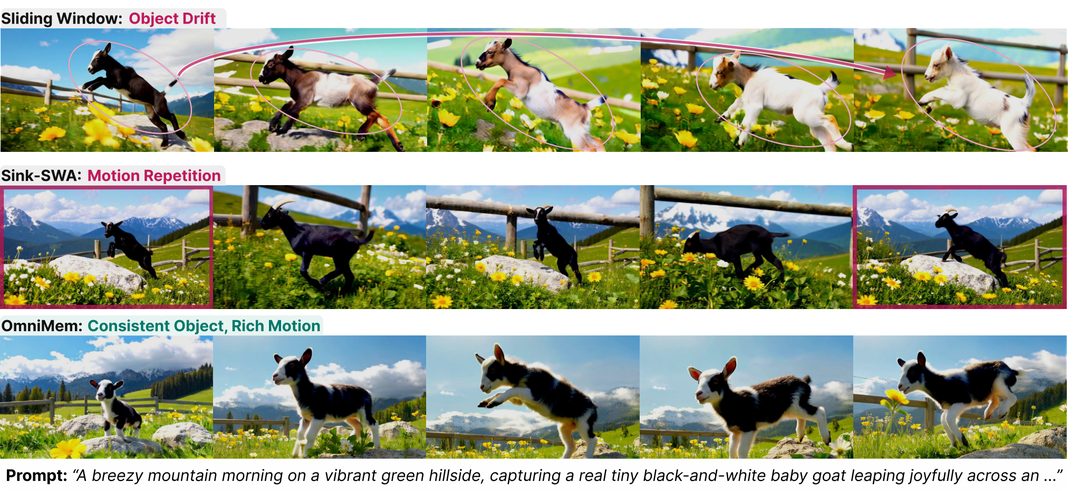
自回归视频模型逐段生成画面,并参考历史键值缓存(KV cache),历史越长,读取开销越大。滑动窗口丢弃远处内容,固定开头锚点又可能诱发动作重复。而将全部历史压进紧凑状态,又会损失重要细节。
OmniMem的核心是full-range memory retrieval:完整分辨率历史KV持续保留在CPU,模型在整个历史范围内按需实时检索到GPU。“完整”描述历史覆盖范围,每一步只取回相关部分,无须读取全部历史。
先找到相关历史 再取回原始细节
框架包含三路注意力:滑动窗口负责近期上下文,压缩分支提供全局概览与检索线索,选择分支取回完整分辨率KV。三路通过学习到的门控融合。
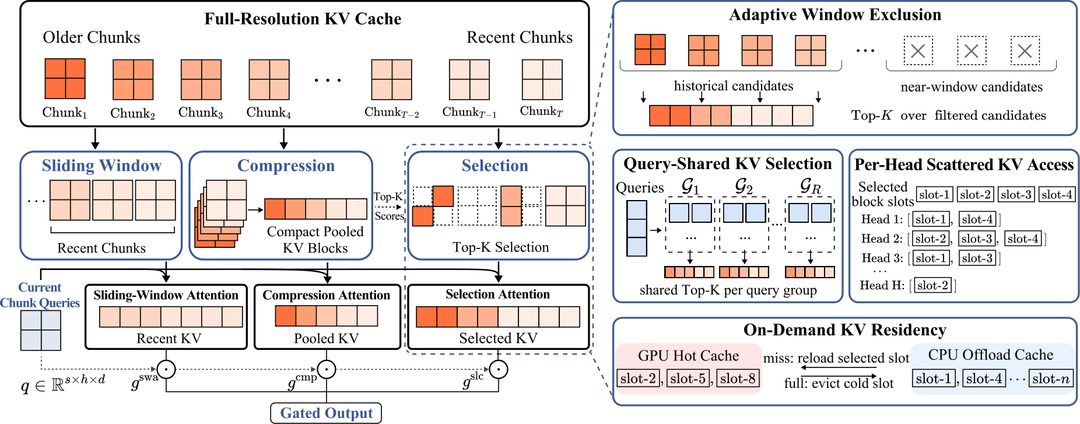
直接按相关性选取时,注意力容易被附近画面吸引,检索名额被滑动窗口已覆盖的内容占满。OmniMem采用自适应窗口排除:远处历史足够时,先排除近期块,让检索预算用于更早的内容;历史不足时暂不排除。
从CPU召回历史 把检索优化到GPU内核
视频每次生成一个片段,要同时处理数千个查询。即使每个查询只选少量历史块,所有查询和注意力头的选择合起来,也可能覆盖大量历史,造成并集膨胀(Union Explosion)。
OmniMem让相邻查询共享选择,减少选择差异;各注意力头仍独立检索。GPU保留近期与活跃KV,较冷的完整分辨率历史存入CPU主存,需要时再取回GPU参与计算。
为让完整历史真正“调得动”,团队把优化深入到CPU/GPU之间的数据通路,围绕块级检索打造定制Triton与CUDA内核。召回内核直接从页锁定主存读取被选中的KV小块,一次启动融合数据搬运、指针发布和失效地址清理;GPU端去重减少重复请求,稀疏注意力再沿指针表读取各个头需要的历史,避免拼出庞大的统一KV缓存。从CPU中的历史存储,到GPU上的细节召回和注意力计算,full memory retrieval的每一步都有底层实现支撑。
记忆找得回来 长视频才能继续向前
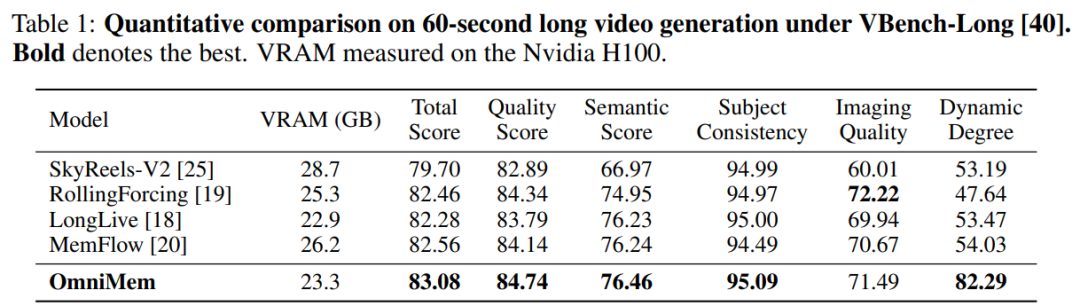
研究基于Wan2.1-T2V-1.3B,经过初始化微调、Self-Forcing和长视频微调。在60秒单提示词VBench-Long评测中,OmniMem总分83.08。动态程度由MemFlow的54.03提高至82.29,相对提升52.3%,主体一致性为95.09。
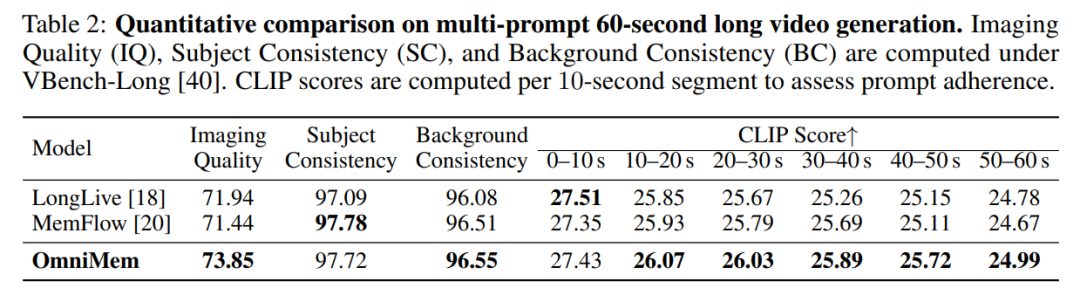
Omnimem同样支持多提示词实时交互实验,成像质量和背景一致性均达到最佳效果(论文表2)。

在717帧的历史访问实验中,OmniMem的显存约为完整历史注意力的三分之一,速度为其2.7倍。全量历史可检索与稀疏访问相结合,让较早的细节有机会再次参与生成。论文、代码与模型权重均已公开。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。