RelightFormer :重光照无需逆渲染
原创 52CV 2026-10-14 23:10 江苏
想象一下:
你有一张产品照片,想让它从“办公室白光”切换到“夕阳余晖”,或是“霓虹夜景”...
传统方法会让你崩溃:重建3D模型,估计材质,最后渲染...一步错,步步错。
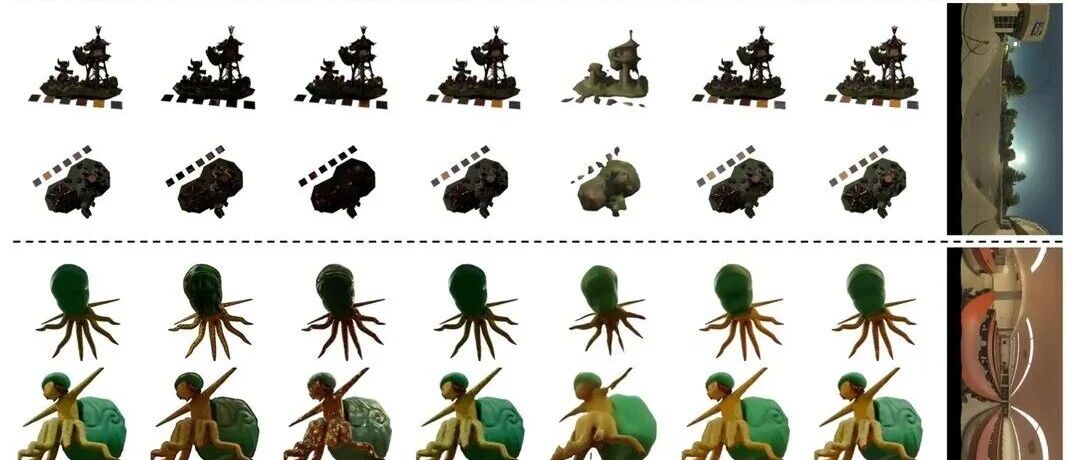
今天,香港理工大学vLAR团队提出RelightFormer:抛弃了病态的逆向渲染,用生成式 AI重新照明多视角图片。
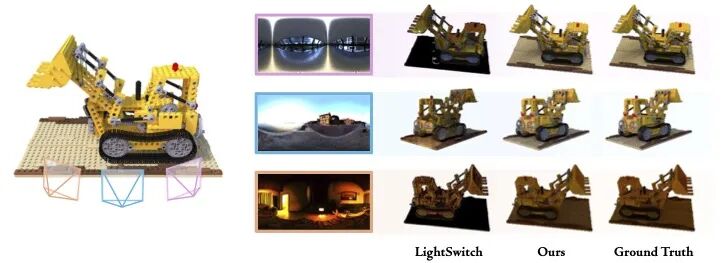
一、 为什么说逆向渲染是病态的?
传统方法需要显式地从若干张 2D 照片,反推 3D 世界的几何、材质、纹理等内禀参数。
然而,从RGB像素反推,有无穷多种答案:淡黄色小球究竟是本身淡黄色,还是纯白小球在灯光下? 这个物体到底是黑色橡胶,还是在阴影里等白色金属? 这一块到底是阴影还是黑斑?
更糟糕的是,这些参数以高度非线性的方式高度耦合,一旦某个参数偏了一点点,重量化的结果完全不同。
我们决定:不猜了! 换条路走!
用交叉注意力引入环境光照
用生成式模型做颜色矫正
完全绕过逆向估计的病态问题
二、 核心洞见:一场数学上的“双向奔赴”
为什么偏偏是交叉注意力(Cross-Attention)?
因为我们发现了一个数学巧合:
Transformer 的交叉注意力:
→ 根据 Q 和 K 的相似度,对 V 求和。
图形学的渲染方程:
→ 根据角度和材质,对入射光求和。
这两个公式,本质上在做加权求和:Cross-Attention根据相似度加权,渲染方程是“看光上色”,根据物理属性加权。
数学结构上的相似性提醒我们:可以用Cross-Attention“悟”出渲染方程呢?
基于这个洞见,我们打造了 RelightFormer 的三大核心武器:
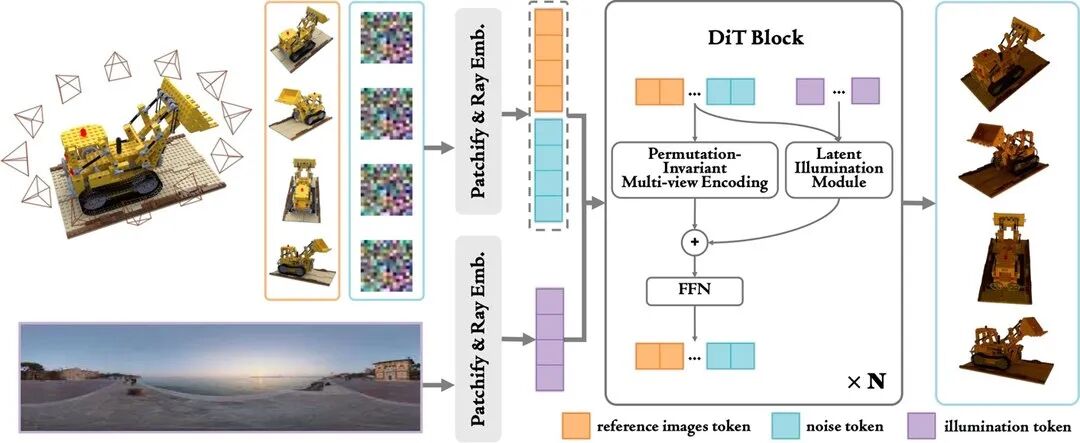
三、 三大核心武器
武器一:微调视频模型 —— 站在巨人的肩膀上
多视角图片最怕视角之间不一致! 这个角度看是篮球,那个角度看变魔方,直接穿帮。
我们选择在视频生成基础模型 Wan2.1 上微调:毕竟视频模型天生就懂“多帧一致性”!
关键魔改:RoPE → PRope
视频模型原本按时间顺序处理帧,但多视角图片没有先后之分。
我们把 RoPE改造成 PRope,确保无论以什么顺序喂视角,输出都一致。
武器二:隐空间照明模块 —— 给模型戴上“光影眼镜”
光照信息怎么喂给模型?
我们引入 Latent Illumination Module(隐空间照明模块):
不在像素层操作,而是在隐空间里注入光照。
用 Cross-Attention 的 Q、K 交互,让模型理解新光照条件。
在特征层面完成光影重构,最后再解码成图片。
武器三:Laval Objaverse Dataset —— 全球最大开源多视角重光照数据集
要训练这么强大的模型,需要海量数据。
我们打造了 Laval objaverse 数据集:
90,545 个高质量 3D 物体
39,008 种真实世界光照环境
完全开源的制作流程和材料
这是目前世界上最大的开源多视角重光照数据集。 在这个数据集上微调,模型就学会了应对各种复杂的光影变幻。
四、 实验结果
我们在 Laval Objaverse Dataset 上选取 7,248 测试样本,覆盖 484 种物体类型。
【单视角输入】
sPSNR:23.80(基线最高 22.27)
PSNR:21.16(基线最高 20.25)
SSIM:0.894(基线最高 0.883)
【16视角输入】
我们的 sPSNR 飙升到 24.83
PSNR 达到 22.62
SSIM 达到 0.905
LPIPS 降至 0.084(越低越好)
【32视角输入】
各项指标继续提升,sPSNR 达 25.07
结论:视角越多,RelightFormer 越强!
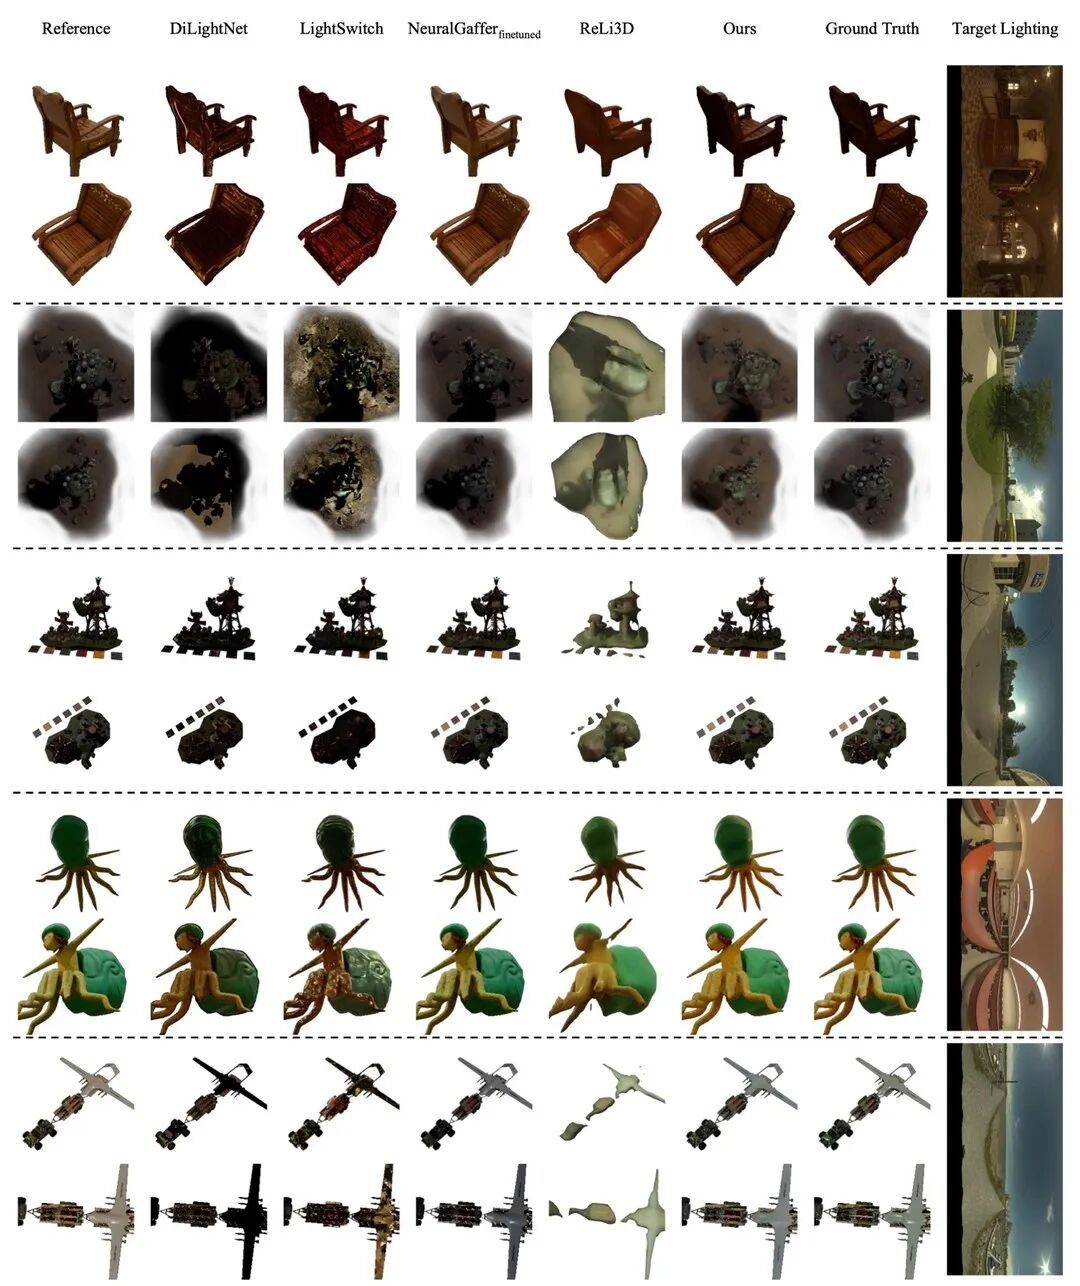
五、 真实场景测试:零样本泛化能力
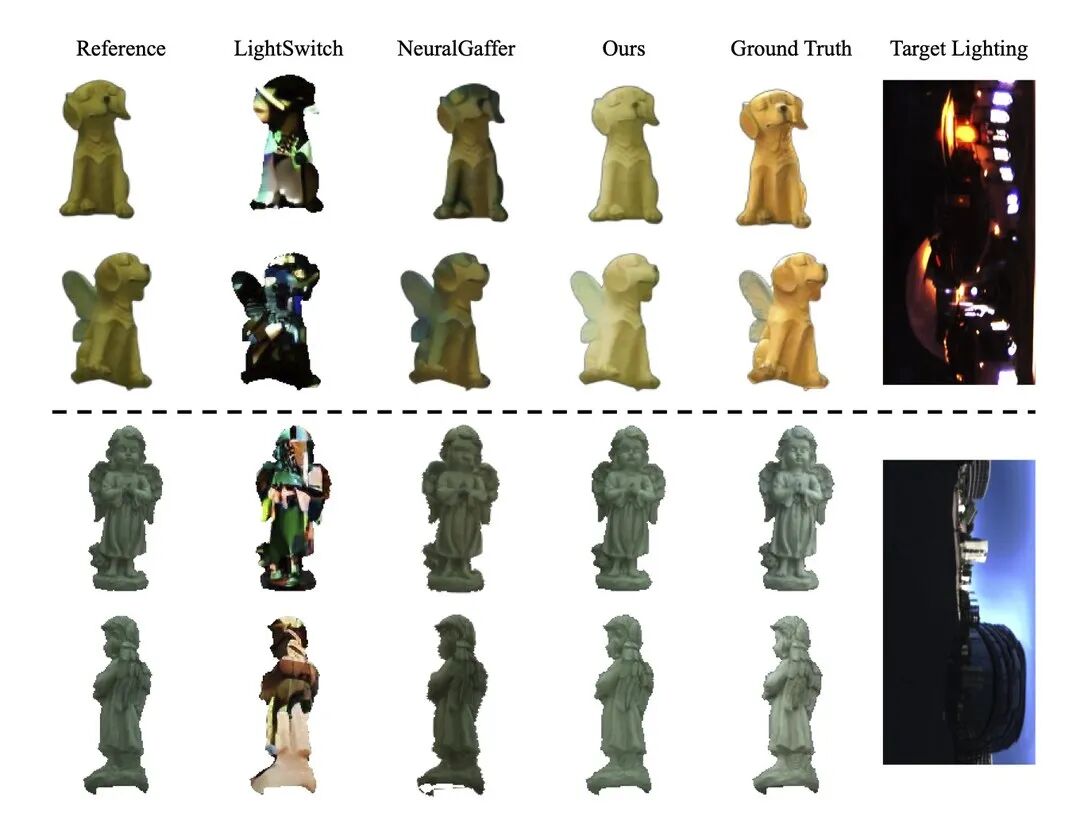
我们还在 OLATverse(真实世界物体数据集)上进行了测试。
结果:RelightFormer 在多视角重光照任务上,依然全面超越所有基线方法!
这证明了我们的模型具有强大的泛化能力,真正学会了“光怎么和物体相互作用”。
六、 总结
RelightFormer绕开传统逆向渲染的“病态优化”,转向用交叉注意力引入环境光照; 它不再依赖高度非线性、高度耦合的物理建模,而是直接用生成式模型做颜色校正。
七、 资源链接
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。