港科大×腾讯视频:音视频大模型后训练往哪儿使劲?边学边改,不再提前定死
原创 52CV 2026-10-15 22:27 江苏
导读|你一定见过这样的 AI 视频:主播张嘴却没声音,狗叫声响了嘴还闭着,人物说着说着就「换了张脸」。音视频联合生成模型越做越大,但让画面好看、声音好听、语义对得上、口型还同步,几个目标经常互相「打架」。
来自 港科大 MMLab@HKUST、腾讯视频与香港大学 的研究团队给出了新答案——Adaptive Reward Routing(自适应奖励路由):让强化学习后训练既知道「往哪儿改」,又知道「怎么权衡」,而且随着模型训练实时更新。
| 论文标题 | Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL |
|---|---|
| 作者单位 | 港科大 MMLab@HKUST、腾讯视频、香港大学 |
| 论文链接 | |
| 关键词 | 音视频联合生成 / 扩散模型强化学习 / DiffusionNFT / 多奖励优化 |
00 一图看懂:这篇论文有多能打
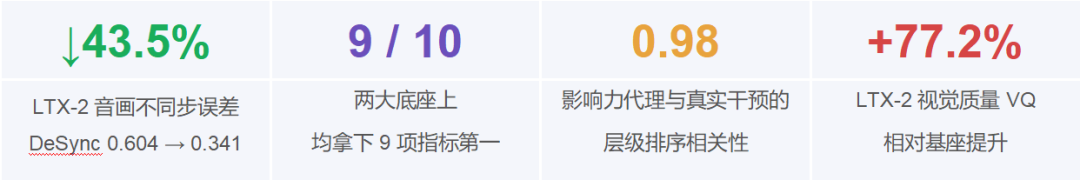
一句话总结:把「奖励往哪儿打」和「奖励怎么配比」这两件事,从训练前一次性定死,变成了训练中随模型一起进化。
01 痛点:多奖励 RL 的两道「送命题」
要让一个音视频大模型同时做好画质、音质、文本对齐和音画同步,业界通常会请来多个「裁判」(奖励模型)打分,再用强化学习去优化。本文用了 5 个裁判:VideoAlign、HPSv3(视频质量)、AudioBox Aesthetics(音频质量)、CLAP(文本-音频对齐)和 DeSync(音画同步)。
问题是:裁判越多,事情越复杂。作者把它归结为两个相互耦合的问题——
送命题一:奖励应该打在哪儿?(Where to Optimize)
LTX-2 这类模型由视频、音频两条分支组成,靠双向交叉注意力(A2V / V2A)互相「沟通」。此前的 OmniNFT 已经意识到要分模态、分层去分配奖励,但它的分层路由是根据基座模型一次性固定的。
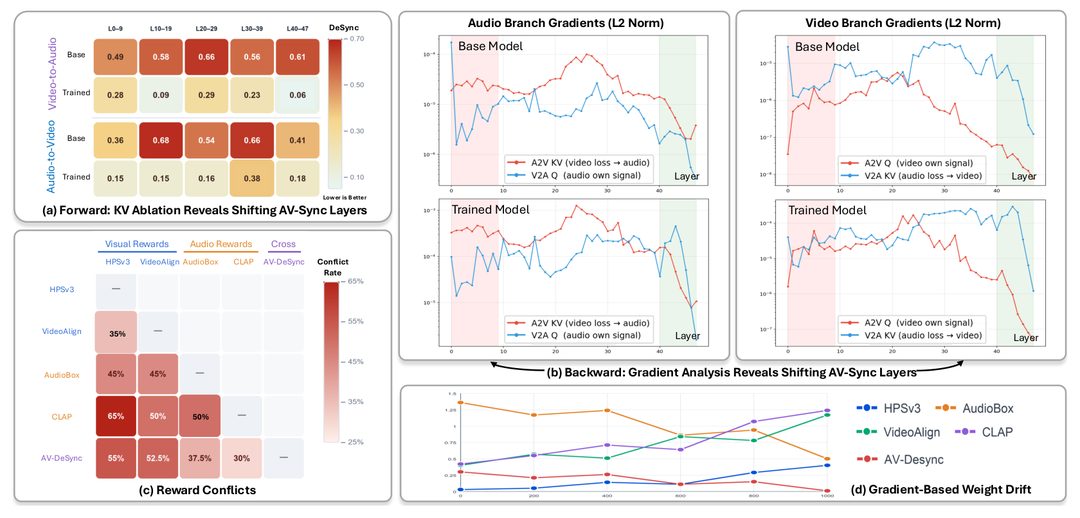
作者做了一个关键实验:分别屏蔽不同层的跨模态 K/V,看同步误差怎么变。结果发现——基座模型和训练后模型里,「管同步」的关键层根本不是同一批!反向梯度分析也给出了一致结论:跨模态梯度的峰值位置在训练中发生了明显迁移。
打个比方:这就像拿着出发前下载的「离线地图」开长途——路况早变了,你还在按老路线走。
送命题二:多个奖励该怎么平衡?(How to Balance)
裁判之间经常意见相反。论文统计显示,在同一批样本上,CLAP 和 HPSv3 的冲突率高达 65%,AV-DeSync 和 HPSv3 的冲突率也有 55%。
现有两类方案各有硬伤:GDPO 用固定权重,冲突来了不会变通;MARBLE 按梯度几何自动调权重,但它只看「梯度合不合得来」,不管「用户认为谁更重要」。结果是——AV-DeSync 这种早期梯度噪声大、却至关重要的同步目标,权重被一路压到接近 0。
02 方法:两把钥匙,一套「实时导航」
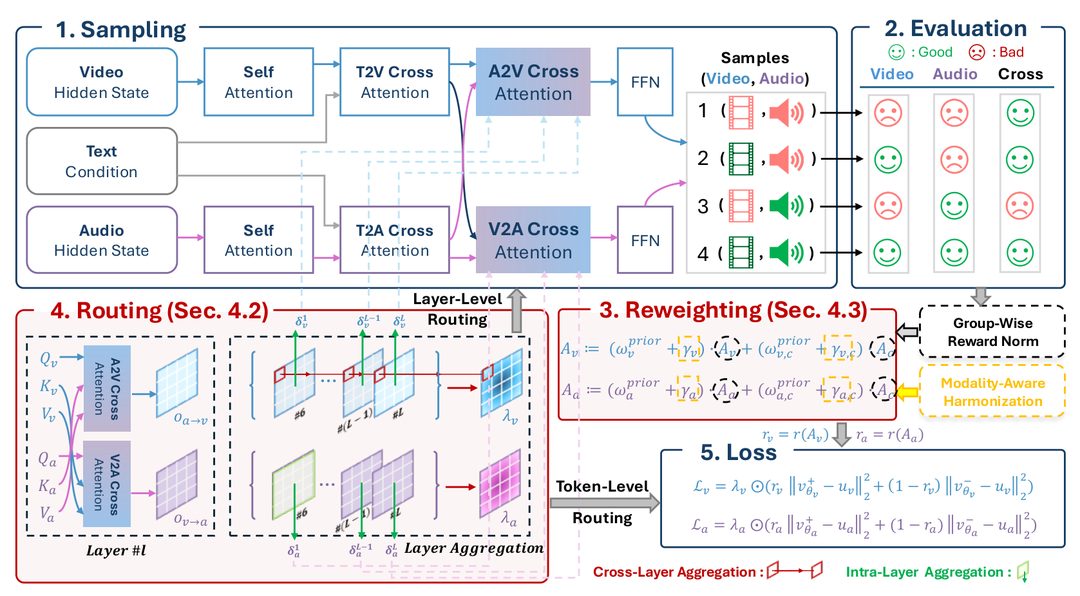
针对这两个问题,作者在前向过程强化学习框架 DiffusionNFT 之上提出了 Adaptive Reward Routing,整体流程可以概括为四级路由:
奖励重加权(每个目标用多大力)→ 分支路由(交给视频还是音频分支)→ Token 路由(重点优化哪些位置)→ 层路由(梯度从哪些跨模态层穿过去)
钥匙一:跨模态影响引导路由 —— 解决「往哪儿改」
想知道哪一层、哪个 token 对跨模态影响最大,最直接的办法是逐个「关掉」看效果,但训练中反复这么做太贵。作者的巧思是:直接复用前向过程中已经算好的交叉注意力输出强度(pre-gate response)作为代理信号,几乎不增加额外的模型前向计算。
▸ Token 级路由:跨层聚合响应强度,得到每个 token 的损失权重——跨模态影响大的位置(例如与声音强相关的画面区域)被重点优化;视频按帧内归一化,避免帧间亮度差异喧宾夺主。
▸ 层级路由:在层内聚合响应强度,给每一层一个「软截断」系数。前向值完全不变,只缩放反向梯度:影响力强的层保留更多梯度,弱耦合层的梯度逐步被截断。A2V 和 V2A 各自独立路由。
▸ 动态刷新:这些路由在训练中随当前模型重新计算,而不是从基座模型一次性抄过来。
钥匙二:偏好保持的模态感知重加权 —— 解决「怎么平衡」
作者的思路很朴素:用户偏好和梯度冲突,不二选一,而是两个都要。
▸ 分支感知:视频奖励只在视频分支里探测梯度,音频奖励只在音频分支里探测,跨模态奖励两边都算,冲突在「各自负责的分支」内部求解。
▸ 残差修正:预设权重作为「偏好先验」保底,梯度冲突得到的系数只作为残差微调——相当于给每个目标设了一个非零地板,弱但关键的目标不会被饿死。
▸ 预热机制:训练早期梯度关系不可靠,先按预设权重跑一段,等估计稳定了再开启动态调整。
一句话:先听用户的,再根据实时「路况」做微调——既不墨守成规,也不随波逐流。
03 效果:口型、身份、同步,全面在线
看得见的提升:四组真实生成对比
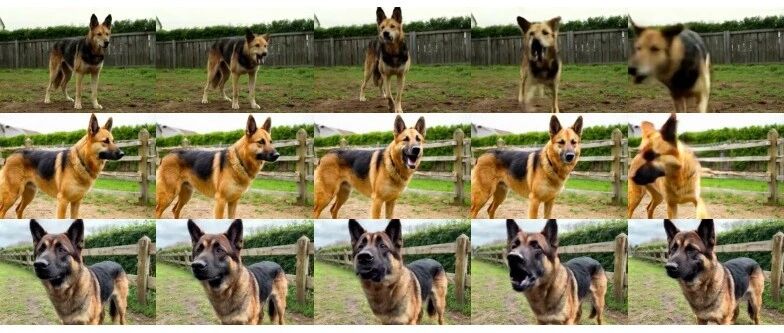
作者在中文新闻播报、风格化角色说话、双人对话、狗叫四类场景下,对比了基座 LTX-2、OmniNFT 和本文方法(每组展示 5 帧时序画面)。
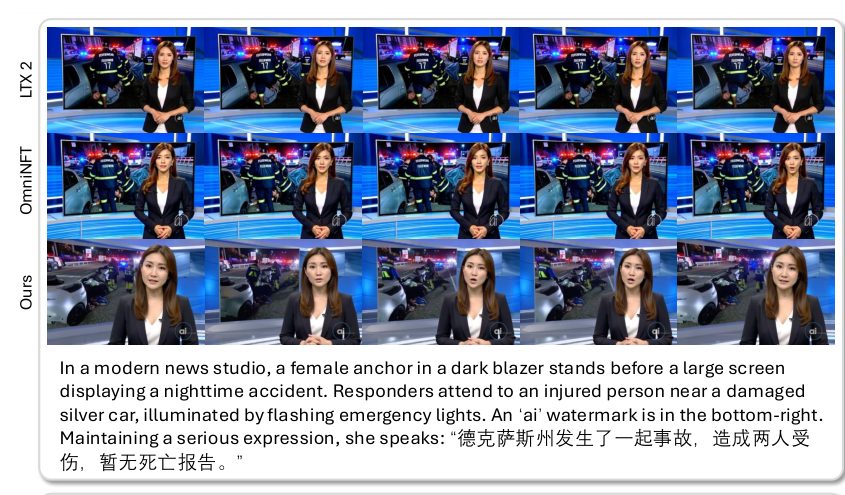
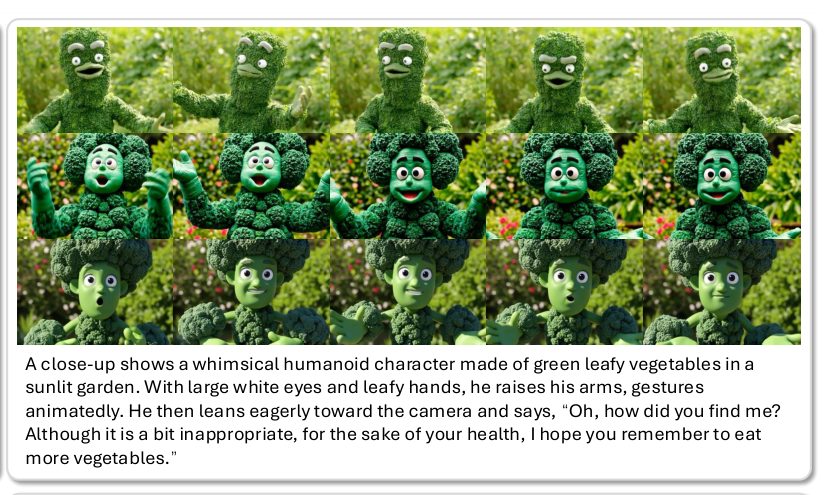
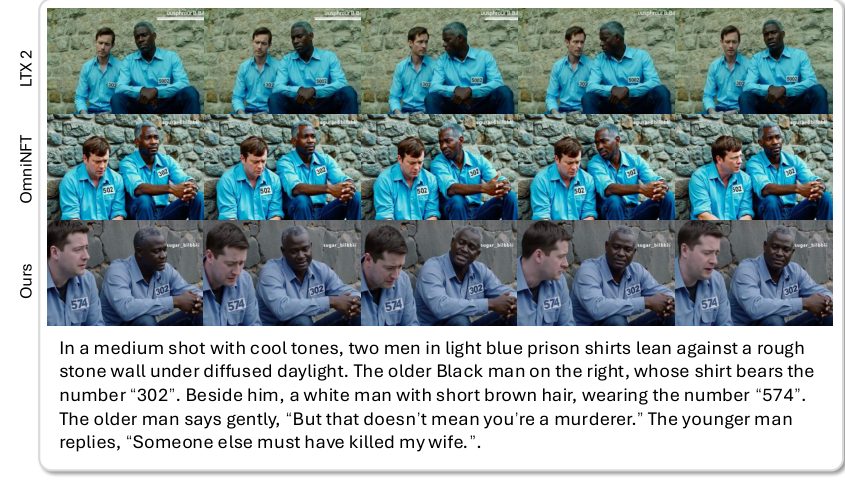
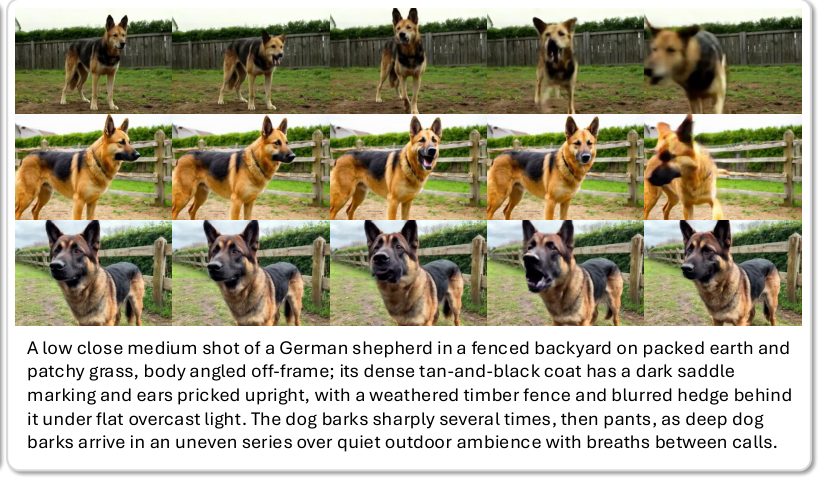
论文观察到:LTX-2 在角色和动物案例里有明显的主体与外观漂移;OmniNFT 提升了提示词遵循,但仍有时序不一致;本文方法在保持身份和场景结构稳定的同时,保留了说话、对话、吠叫对应的视觉动作。
量化结果:两大底座,9/10 指标第一
在包含 10,140 条提示词 的完整 JavisBench 上,作者在 LTX-2(19B) 和 LTX-2.3(22B) 两个底座上评测了 10 项指标。所有可训练方法均使用相同数据、LoRA 与优化预算,各跑 3 个随机种子取均值。
| 方法 | VQ↑ | AQ↑ | TA-IB↑ | CLAP↑ | AV-IB↑ | AVHScore↑ | JavisScore↑ | DeSync↓ |
|---|---|---|---|---|---|---|---|---|
Base | 1.883 | 5.201 | 0.143 | 0.358 | 0.180 | 0.177 | 0.153 | 0.604 |
+GDPO | 2.722 | 5.450 | 0.138 | 0.347 | 0.174 | 0.175 | 0.155 | 0.671 |
+MARBLE | 2.384 | 5.100 | 0.138 | 0.365 | 0.182 | 0.182 | 0.158 | 0.618 |
+OmniNFT | 3.136 | 5.614 | 0.145 | 0.416 | 0.222 | 0.219 | 0.195 | 0.390 |
| +Ours | 3.336 | 5.868 | 0.167 | 0.425 | 0.235 | 0.234 | 0.206 | 0.341 |
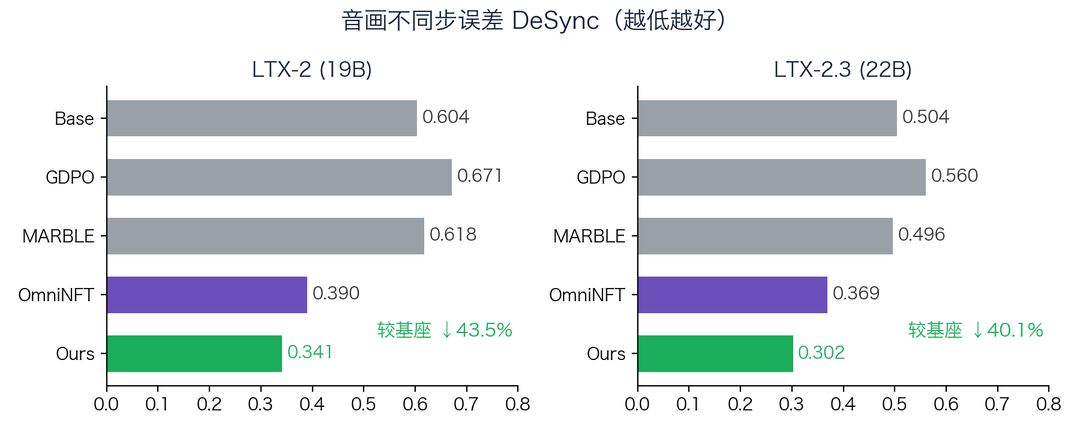
表1|LTX-2 底座 JavisBench 主要结果(节选 8 项,3 个种子均值)
几个值得划重点的数字:
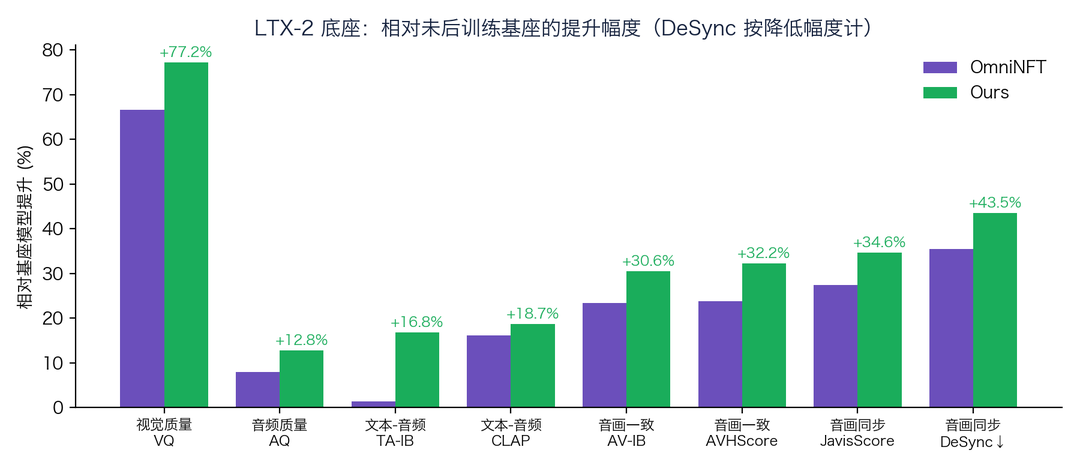
▸ 音画同步:LTX-2 上 DeSync 较基座 降低 43.5%,较 OmniNFT(0.390)再降 12.6%;LTX-2.3 上降至 0.302,较 OmniNFT(0.369)再降 18.2%。
▸ 音频质量:AQ 在 LTX-2 / LTX-2.3 上分别达到 5.868 / 5.979,两个底座均为最优。
▸ 「偏科」现象:GDPO 拉高了画质,却让 DeSync 从 0.604 恶化到 0.671——固定权重导致的失衡一目了然。
训练曲线:不是「拆东墙补西墙」
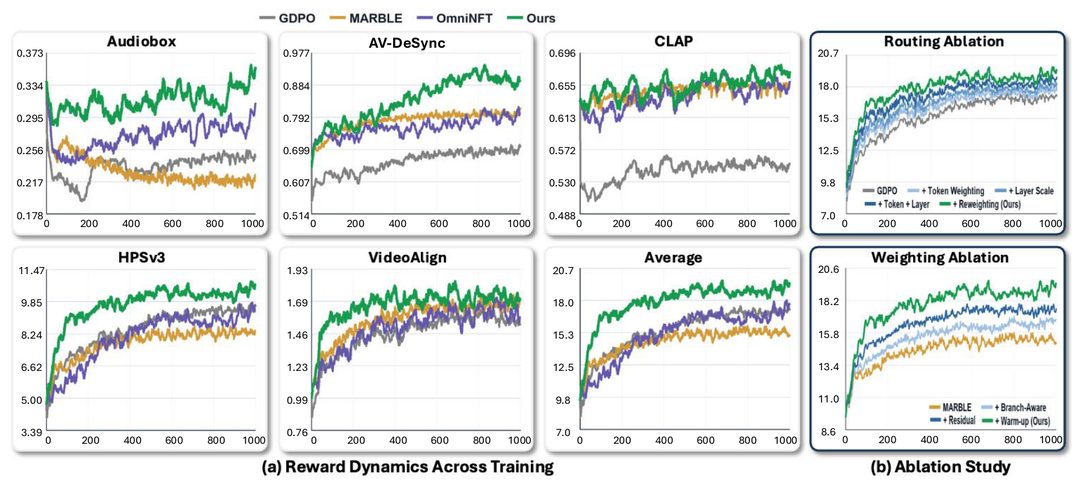
从训练动态看,本文方法的五项奖励平均值最高,而且每一条单项奖励曲线都保持了良好的上升趋势;而基线方法在音频、视频、同步之间的进展明显不均衡。这说明最终的提升来自协同优化,而不是牺牲某个目标换来的。
04 硬核验证:代理信号真的靠谱吗?
消融实验显示,Token 级加权、层级缩放、分支感知、残差混合和预热机制各自都带来增益,组合后效果最好——说明「往哪儿改」和「怎么平衡」解决的是两类互补的失效模式。
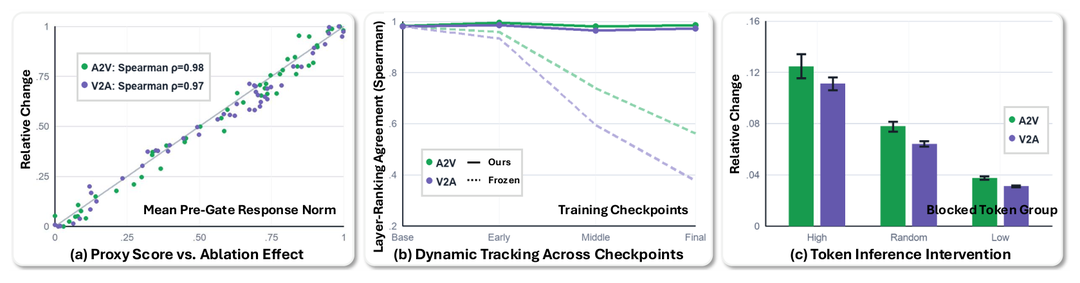
更有说服力的是机制分析。作者在 4 个训练检查点上,逐个关闭 48 个 A2V / V2A 跨模态块,用真实干预效果来检验代理信号:
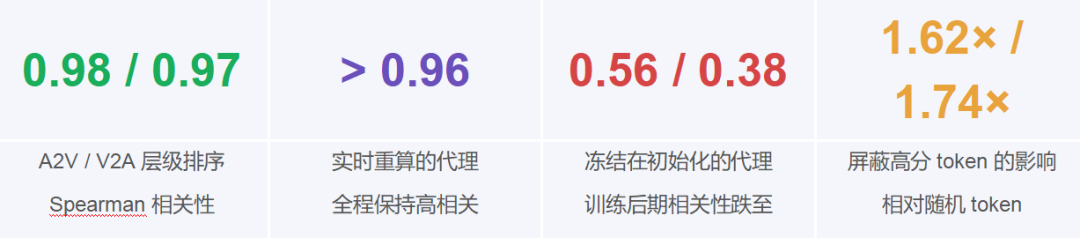
▸ 层级保真:代理信号几乎完美复现了真实干预得到的层级排序。
▸ 动态追踪:实时重算的代理全程相关性在 0.96 以上;而冻结在初始化的路由图,相关性分别跌到 0.56 和 0.38——直接证明了「静态路由会过期」。
▸ Token 识别:屏蔽得分最高的 10% token,对最终预测的影响是同等数量随机 token 的 1.62 倍(A2V)和 1.74 倍(V2A)。
05 写在最后
这篇工作最值得玩味的,不只是刷新了几项指标,而是一个观念上的转变:多模态模型的反馈,不该按一份固定「菜谱」分配,而应该随着模型能力的成长持续重组。
作者也坦诚讨论了局限:目前还没有一个能统一刻画模态质量、语义一致性和时序同步的音视频奖励模型;路由机制需要模态 token 可识别、跨模态交互响应可分离。作者表示方法已在双流 LTX 底座和单流 JavisDiT++ 底座上验证,奖励协调部分本身与架构无关,可推广到其他扩散 RL 目标。
随着音视频一体化生成走向短视频、虚拟主播、影视预演等真实场景,「口型对得上、声音配得准、人物不变脸」将是绕不开的门槛。让训练过程「与模型同步进化」,或许正是迈过这道门槛的关键一步。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。