MedReaMM:面向专家级临床诊断综合能力的评测
原创 52CV 2026-10-15 22:27 江苏
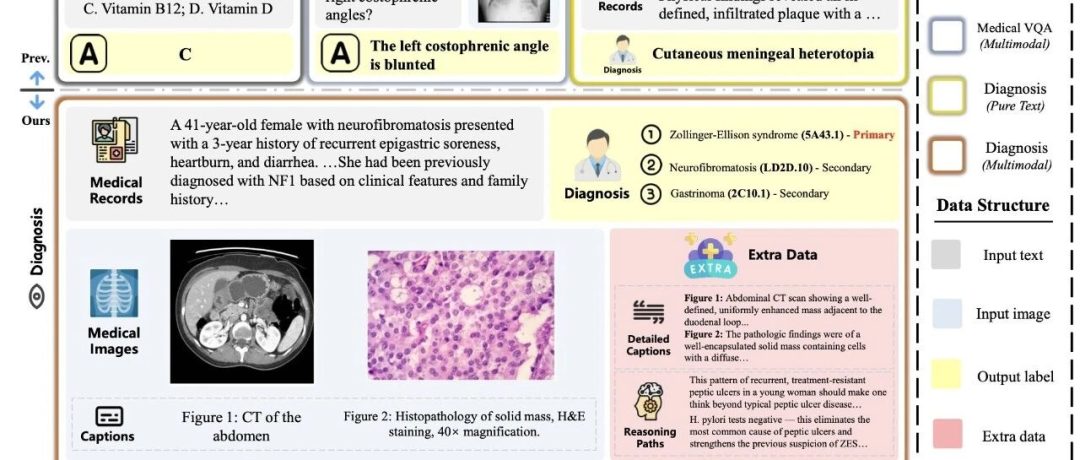
随着大语言模型和视觉语言模型不断进入医学场景,模型能不能“看懂一张片子” 已经不再是唯一问题。真实诊断往往同时依赖病史、症状、实验室检查、医学影像和病理结果,医生需要把这些来源不同、粒度不同的证据放在一起,形成一份有优先级的鉴别诊断。
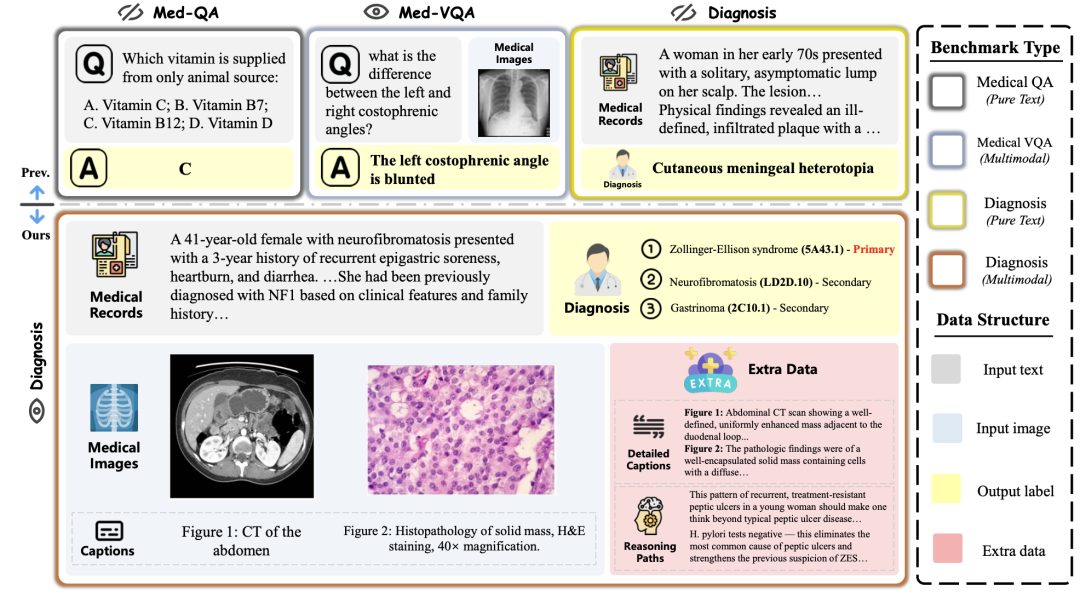
然而,已有不少医学基准仍停留在纯文本问答或局部视觉问答:模型回答一个知识点,或者识别一张图中的局部信息。这些任务难以检验模型是否真正具备“从完整临床证据中得出诊断” 的能力,尤其难以覆盖罕见、非典型和多系统病例。
正是基于这个观察,华中科技大学联合复旦大学、南京医科大学第一附属医院(江苏省人民医院)等单位的研究团队提出了 MedReaMM:面向专家级临床诊断综合能力的评测数据集。其中所有数据均来自公开发表的医学病例报告:期刊来源部分选自影响因子(IF)大于 40 的高水平医学期刊,如 NEJM 和 The Lancet;同时也包括 Eurorad 等专业病例平台。平均每例包含 2.79 张医学影像,文本信息平均约 833 个词,并覆盖 13 种医学影像类型;79% 的病例还包含两个及以上最终诊断。
论文标题:MedReaMM: Evaluating Large Multimodal Models on Expert-Level Clinical Diagnostic Synthesis
数据来源:影响因子(IF)> 40 的高水平医学期刊(如 NEJM 、The Lancet)及 Eurorad 等专业病例平台。
1. 面向专家级诊断的高难度病例
MedReaMM 的第一个亮点,是病例本身就足够难。它不是把常见疾病做成图文问答,而是从medical case reports 中筛选经过专家复核的复杂病例:病例往往罕见、非典型,或同时涉及多个器官系统,需要把病史、症状、检查结果和多张医学影像放在一起,才能形成可靠的鉴别诊断。
每个病例同时提供较长的临床记录和多张医学图像,模型不能依赖固定选项,而要输出按可能性排序的前10 个诊断。对于存在合并症或多种诊断的病例,模型还需要尽可能覆盖完整诊断集合。
这种开放式设置更接近临床中的鉴别诊断过程,也避免了多选题把候选空间提前限定的问题。为了减少名称差异带来的误判,研究团队同时使用ICD-11 编码匹配和医学语义相似度匹配。
2. 从病例收集到专家复核
研究团队从影响因子(IF)大于 40 的高水平医学期刊(如 NEJM 、The Lancet)和公开病例平台(如 Eurorad)收集了 2,867 份 medical case reports,其中 2,359 份来自医学期刊,508 份来自公开病例平台。经过多模态信息抽取、图像与文字对齐、标签泄漏筛查、诊断拆分与 ICD-11 编码,最终由临床专家复核,保留625 个高质量病例。
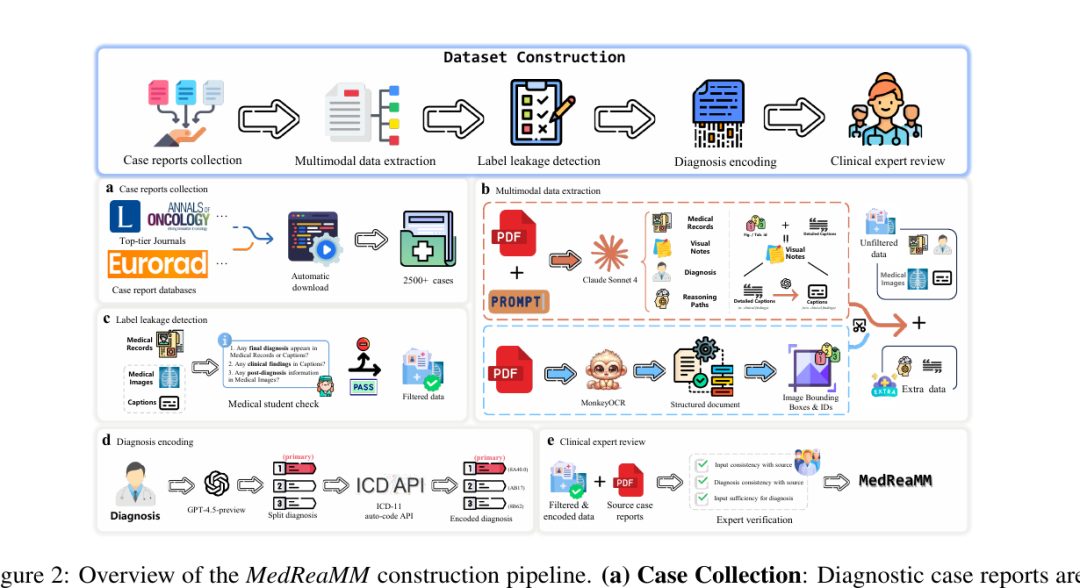
其中,标签泄漏筛查专门检查三类问题:最终诊断是否已经出现在病历或图注中,图注是否直接给出了临床解释,图像是否包含诊断之后的信息。这样的处理让评测更聚焦于证据整合,而不是识别题目中已经露出的答案。
3. 23 个模型的成绩仍有明显差距
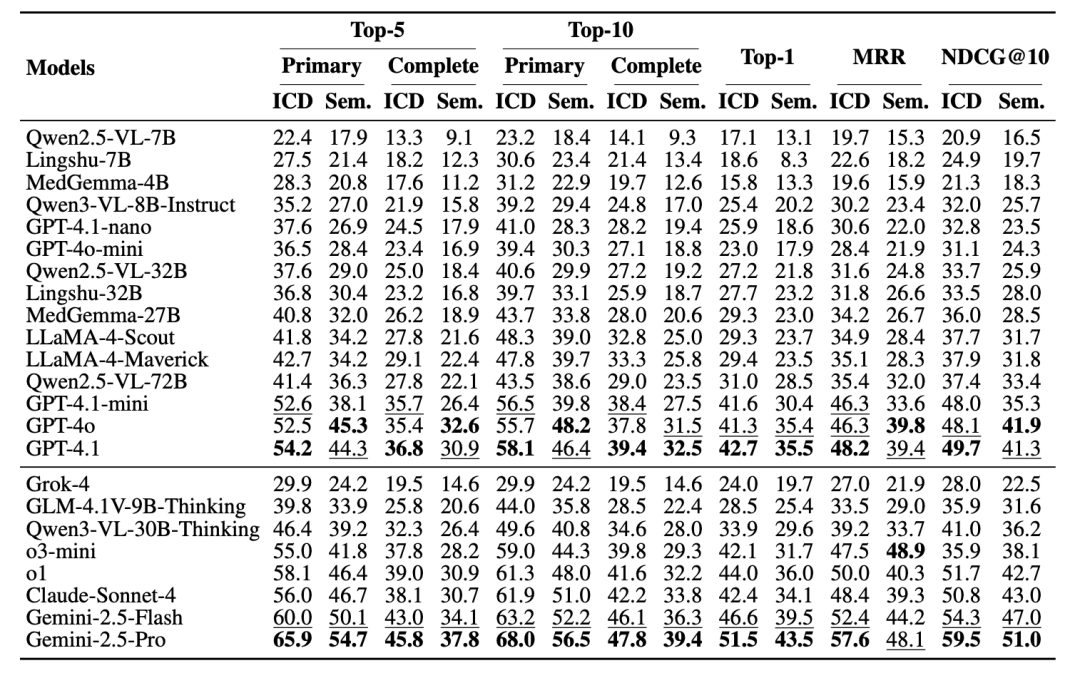
论文在 625 个病例上评测了23 个多模态模型。结果显示,在 Top-10 首要诊断指标上,Gemini-2.5-Pro 的 ICD-11 匹配得分达到 68.0%,语义匹配得分为 56.5%;Gemini-2.5-Flash 和 GPT-4.1 也表现较好。但即使允许模型给出10 个候选诊断,多数模型仍没有超过 50%。
4. 多方面能力共同影响诊断表现
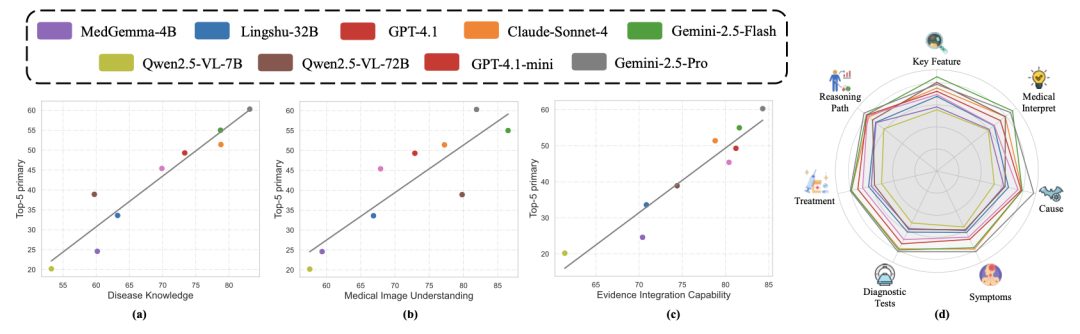
研究团队进一步分析了影响诊断表现的多方面因素。结果显示,模型的医学影像视觉感知能力、医学疾病知识能力和多模态信息联合推理能力,都会影响最终诊断成绩,而且三项能力均与诊断表现呈正相关。任何一方面存在明显短板,都可能限制模型的整体表现。
这意味着,模型即使看见了关键影像特征,也需要知道这一特征与哪些疾病相关,并结合病史、症状、实验室检查和其他影像进行联合推理。只有视觉感知、医学知识和多模态推理相互配合,模型才能形成更可靠、更完整的鉴别诊断。
5. 典型病例
论文给出了一例 35 岁女性反复肺部感染的病例。最终诊断包含肺内隔离症和放线菌感染两个部分。在模型输出中,较强模型通常能够识别主病“肺内隔离症” ,但对放线菌感染并不稳定。
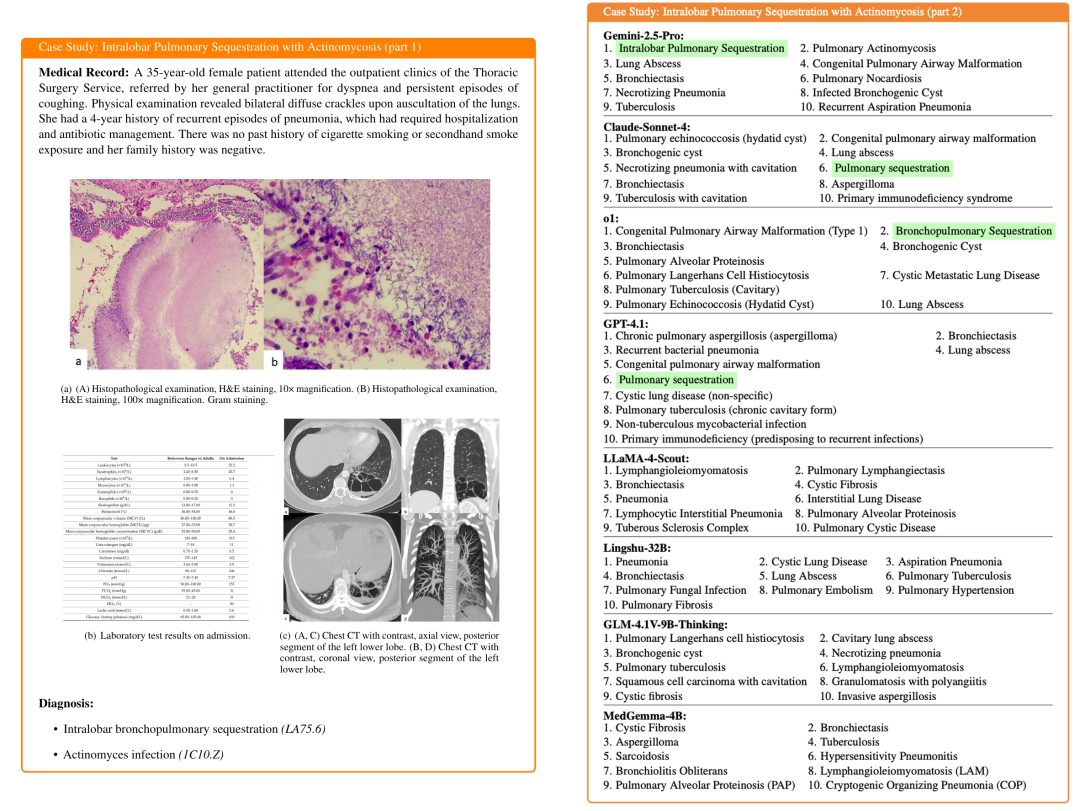
这个案例说明,模型当前的困难并不总是"完全不会诊断”,而是容易抓住最显眼的主病,却漏掉病理细节或并发症里的第二个答案。对于临床诊断支持而言,能否覆盖完整诊断集合,可能比只猜中一个主病更重要。
结语
MedReaMM 提供了一条清晰的评测基线:多模态医疗模型既要具备医学疾病知识和医学影像视觉感知能力,也要能够对临床文本与多张医学图像进行联合推理,最终组织成一份有优先级的诊断列表。论文同时提醒我们,基准中的高分不能直接等同于临床可用性,因为真实诊疗还涉及追问、复查、不确定性和风险管理。
但在模型真正进入复杂临床场景之前,先用这样一套公开、可复现、经过专家核验的基准回答"模型到底会不会综合判断”,仍然是非常必要的一步。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。