Memfit 的 Action 契约与原生 Function Call:一次协议层重构
原创 Yak 2026-10-16 17:06 四川
Memfit架构又又又优化啦~
Memfit 的主循环不复杂:组装上下文、让模型决策、执行动作、把观察写回,进入下一轮。真正难的是第二步——模型输出什么,程序才能既信任又执行?
Memfit 使用的是一套我们自研的 Action 契约:它是一段 JSON,也是一个约定——模型负责决策,程序负责解析、校验、执行与回放。
这篇文章讲三件事:
1.为什么这套契约必须保留;
2.原生 Function Call 作为一层表达优化带来了什么;
3.aiprojection——夹在内部 prompt 与模型服务之间的那个中间件——到底解决了什么问题。
一、Action:Memfit 的 JSON 执行契约
Memfit 每向前走一步,都需要模型给出一个"可执行的决定"。我们的做法是:让模型输出一段 JSON,第一个字段 @action 说明这是哪类动作,其余字段是参数和标识。例如一次直接的工具调用:
JSON
1  {
2      "@action": "directly_call_tool",
3      "directly_call_tool_name": "read_file",
4      "directly_call_tool_params": {
5          "file": "./config.yaml"
6      },
7      "human_readable_thought": "读取配置文件"
8  }
这套契约有三个明确的设计目标。
•通用。只要模型能输出文本,就能驱动 Memfit 的循环。协议不要求服务端提供额外能力。
•显式。动作名、参数、标识符都写在同一个对象里;解析、校验、拒绝都发生在确定的位置,而不是散落在自然语言里。
•可回放。一段 JSON 就是一条可持久化的动作记录。测试可以构造脚本化的模型响应,把"解析 → 校验 → 执行 → 观察"整条链路逐段锁死。
动作按用途分成几类:
•工具类(require_tool 加载定义、directly_call_tool 执行)、
•能力类(load_capability、loading_skills)、
•规划类(request_plan)、
•协作类(dispatch_sub_react_agents 及配套的观察、等待、取消)、
•交互与收尾类(directly_answer、ask_for_clarification、finish)。
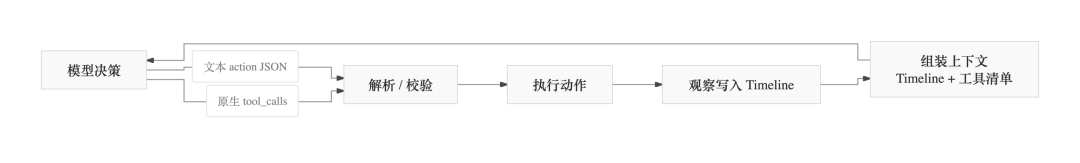
一轮循环的骨架,代码上非常轻:
Plain Text
1  # one ReAct iteration (pseudocode)
2
3    prompt  = build_prompt(timeline, tools, task)
4    output  = call_model(prompt)
5
6    action  = parse_action(output)   # text JSON or native tool_calls
7    validate(action)                 # name, params, permissions
8    result  = execute(action)        # tool / plan / sub-agent / ...
9    timeline.append(result)          # feed the next iteration
契约的意义在于:它把"模型说了什么"变成"程序可以验证的数据结构"。这一步稳定之后,表达方式才有可能被替换——这正是下一节要讲的事。
二、原生 Function Call:契约之上的一层表达优化
契约不动,换的是表达。在支持原生 Function Call 的模型服务上,Memfit 会让同一个动作换一种形式提交:函数名就是动作名,arguments 就是动作参数,JSON 里的 @action 字段由函数名承担。
JSON
 1  // 文本表达
 2  {
 3      "@action": "directly_call_tool",
 4      "directly_call_tool_name": "read_file",
 5      "directly_call_tool_params": {
 6          "file": "./config.yaml"
 7      }
 8  }
 9  // 原生表达(tool_calls)
10  {
11      "name": "directly_call_tool",
12      "arguments": {
13          "directly_call_tool_name": "read_file",
14          "directly_call_tool_params": {
15              "file": "./config.yaml"
16          }
17      }
18  }
我们支持它,是为了三件事。
YAK
2.1 收益一:思考时长优化
这一条来自两个层面的叠加:服务端的终止语义,以及 Memfit 这边的回放结构。
第一层:服务端的 stop reason。
每一次模型调用结束,服务端都会给出一个 stop reason:其中tool_use 表示这轮以"要求调用工具"结束。对纯文本请求来说,这只是一个分类标签;但在 Agent 场景里它是有实际效果的——一旦模型产出了工具调用请求,生成就在那里终止。
实践中很多模型服务看起来为 Agent 场景做了这个隐藏优化:模型输出工具调用之后,下一次的AI调用会有明显的思考时间降低。
不同服务对这个机制的实现并不完全一致,有的严格截断、有的只是语义标记,但方向是统一的:工具调用本身就是一个天然的终止点,不需要靠模型"自觉"停下。下一轮的思考长度会天然降低
第二层:动作的回放结构。
原生模式下,一轮动作会被记成一个不可变的消息组:assistant 消息携带 reasoning_content、content 与 tool_calls;每个调用只配一条极短的受理回执;真正的执行结果照常作为普通时间线事件写入。
Plain Text
1  Timeline 中记录的动作组(投影前)
2
3    assistant: { reasoning_content, content, tool_calls: [call_1, call_2] }
4    tool:      { tool_call_id: call_1, content: {"status": "accepted", "detail": "outcome follows in timeline"} }
5    tool:      { tool_call_id: call_2, content: {"status": "accepted", "detail": "outcome follows in timeline"} }
aiprojection 在发送前把它展开成标准的 assistant / tool 消息(下一节细说)。于是下一轮模型看到的是"自己上一轮做了什么 + 工具已受理",而不是一段需要重新解析的长文本;动作参数在 arguments 里,也不再占用自然语言内容。上一轮推理同样会被还原成 assistant 的 reasoning_content,模型可以直接接上自己的思路,而不必重新想一遍。
两层合起来:服务端把工具调用当作终止点,少生成;回放结构又让下一轮不必重新读一遍自己的话。 思考长度就这样一轮一轮降下来。
YAK
2.2 收益二:批量调用优化
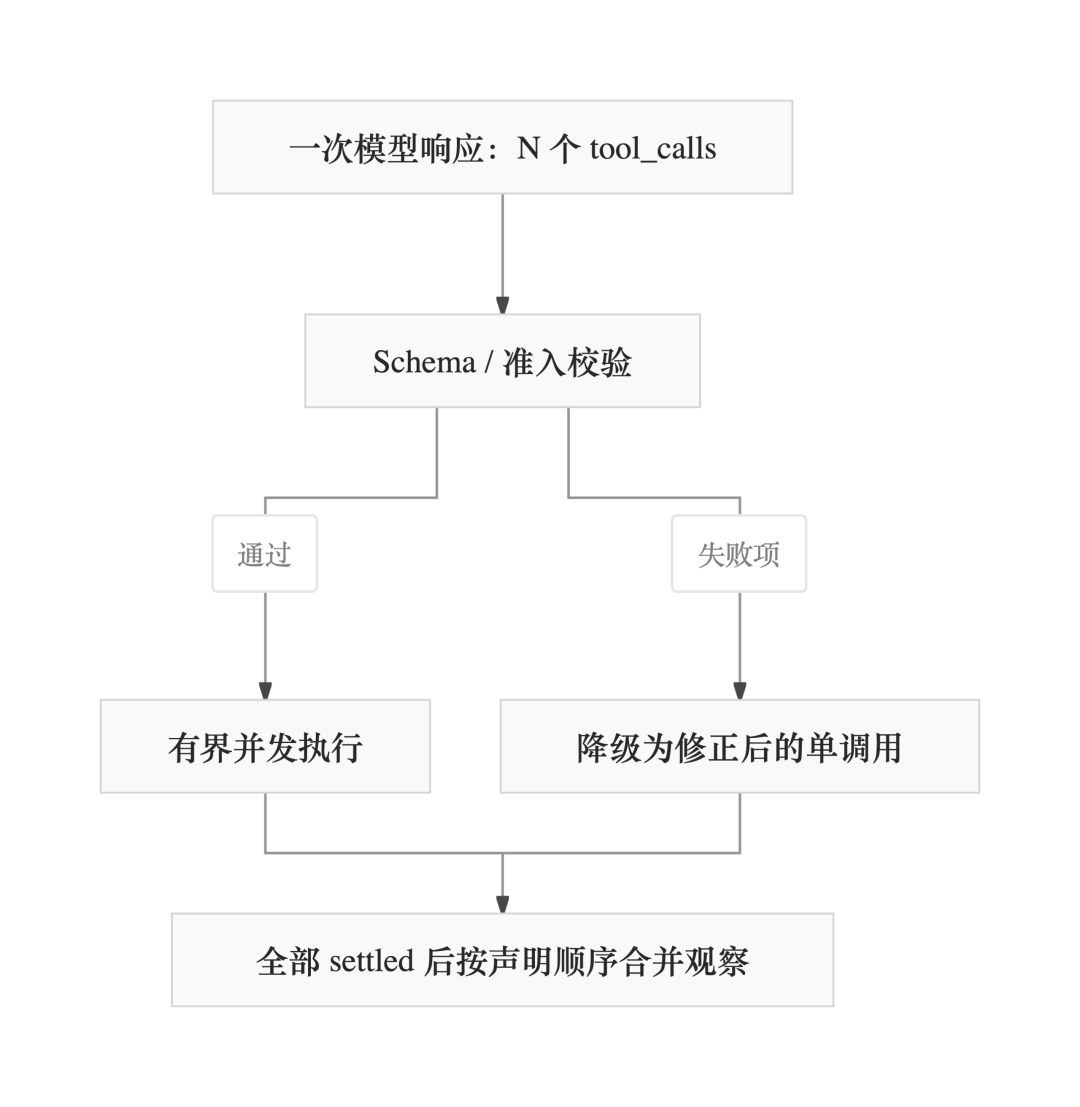
一次响应可以携带多个 tool_calls。程序把它们当成同一批动作:Schema 侧把单批上限收在 8 个;执行侧有界并发,等全部结束后按模型声明顺序合并观察结果。批量是延迟优化,不是正确性要求——只有低风险、相互独立、互不干扰的调用才适合放在一批。任何一项出现准入或参数错误,保留成功项,只把失败项改为修正后的单调用,不允许原样重发整批。
YAK
2.3 收益三:消除内部参数生成
这是三个收益里最容易被忽略、但对缓存最重要的一条。
旧路径分两跳:模型用 require_tool 选定工具(R1),运行时再发起一次模型请求,专门为这个工具生成参数(R2),然后执行。多一跳模型调用,也多了一条每轮都在变化的时间线内容。
现在,require_tool 与 load_capability 对工具只做一件事:把完整参数 Schema 加载到缓存块 CACHE_TOOL_CALL,不生成参数、不执行工具。下一轮,模型依据 Schema 自己构造完整参数,用 directly_call_tool 一次提交。
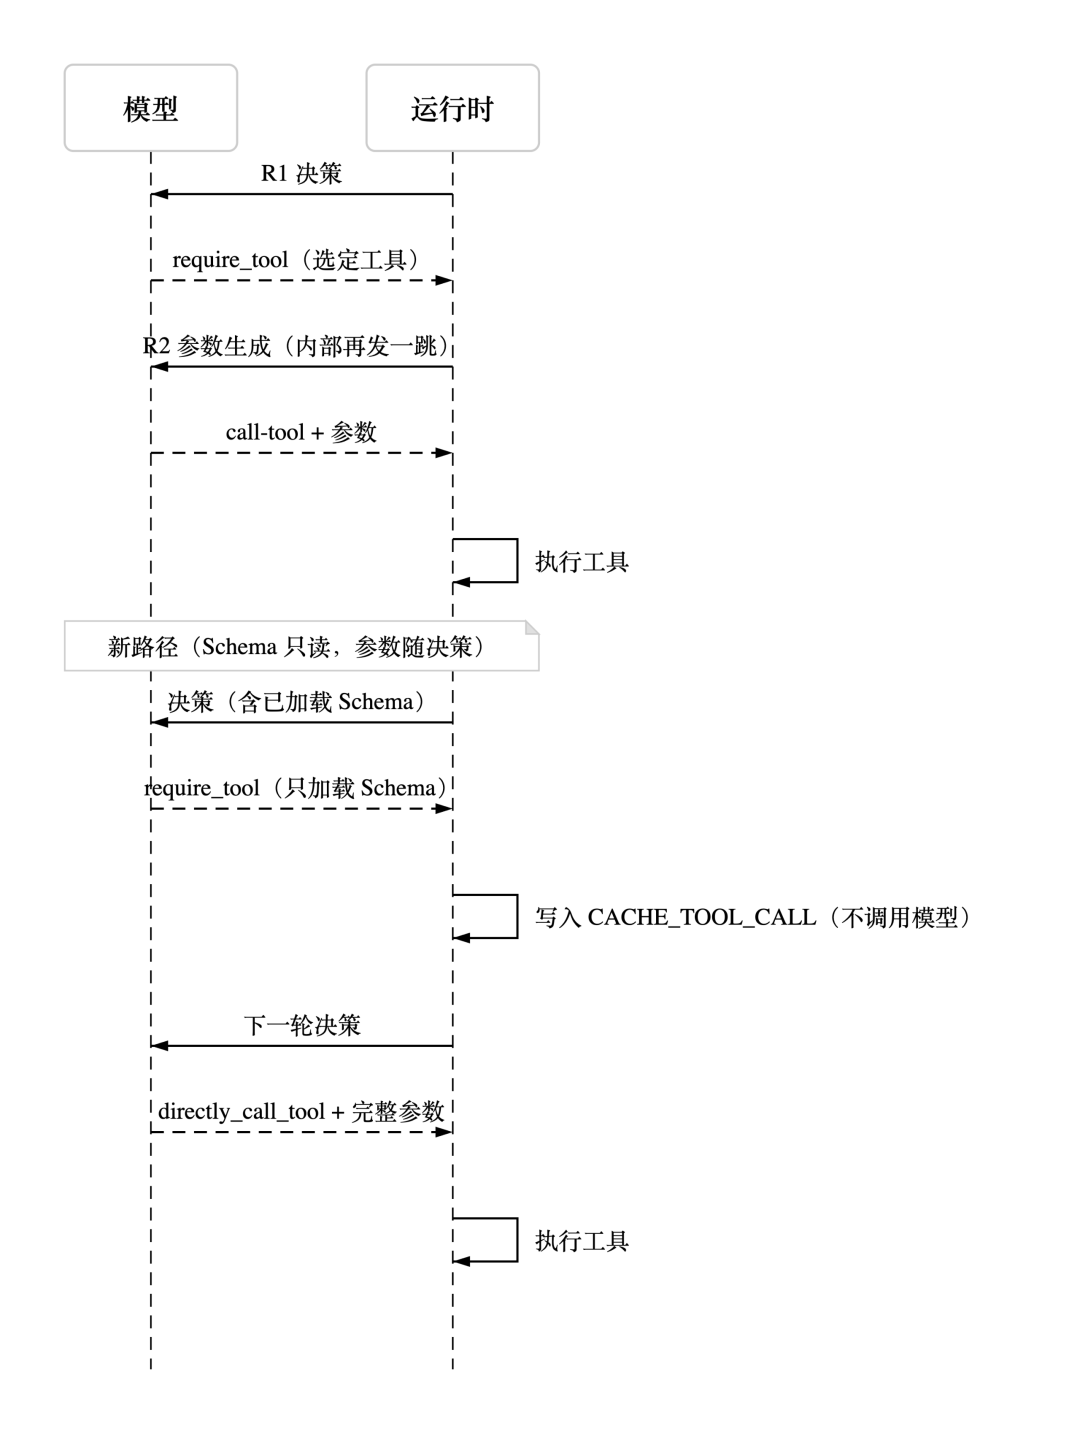
收益是三重的:少一跳模型调用、少一条每轮都变化的动态条目、加载的 Schema 进入稳定块,落在可复用的前缀范围内。少一跳、少一条、稳定一段,叠加起来就是缓存命中率的改善。
小结:原生 Function Call 没有替换 JSON 契约,它让同一份契约在支持的通道上跑得更省、更顺。
三、aiprojection:prompt 与模型服务之间的中间件
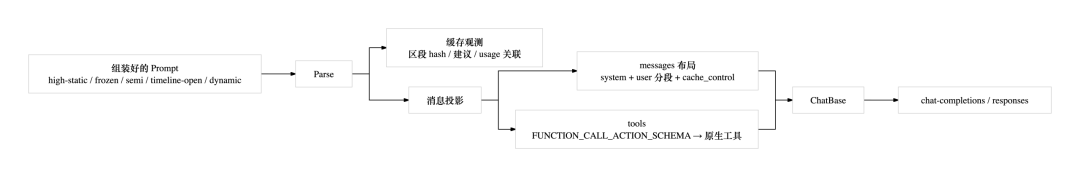
Memfit 内部的 prompt 是一整段带区段标记的文本;模型服务要的是 messages(以及可选的 tools)。两者之间的格式转换、缓存策略与协议差异,由 aiprojection 承担。它挂在请求发送前的 hook 上,一次 Parse 产出两份视图:一份用于缓存观测,一份用于消息投影。
YAK
3.1 显式缓存
先说"显式"是什么意思。 请求发给模型服务时,服务端可以把重复出现的提示词前缀缓存起来,后续请求直接复用,省下重复 prefill 的开销。
复用有两种路子。
•显式缓存:我们在消息的某个位置打一个断点标记 cache_control: {"type": "ephemeral"};服务端从消息开头一直回溯到这个断点,把这一段前缀做成一个缓存块。以 dashscope 为例:缓存块有 5 分钟 TTL;首次创建按输入单价 125% 计费,命中时按 10% 计费;请求结束后的 usage 里会返回本次新建了多少(cache_creation_input_tokens)和命中了多少(cached_tokens),成本可以逐次核对。
•隐式缓存(自动前缀缓存):不需要任何标记:服务端自己识别请求之间的公共前缀并复用,命中与否由服务端决定,通常也不单独暴露建块与命中的计费字段。
两者的差别可以直接列成一张表:
维度 | 显式缓存 | 隐式缓存(自动前缀) |
|---|---|---|
触发方式 | 我们在指定位置打断点 | 服务端自动识别公共前缀 |
控制力 | 断点位置由我们决定 | 无法指定断点 |
命中范围 | 从消息开头到断点的那一段前缀 | 服务端实际匹配到的最长前缀 |
计费口径 | 建块更贵、命中更便宜(dashscope:125% / 10%) | 通常不单独计费,命中不保证 |
可观测性 | 建块与命中 token 出现在 usage 里 | 依服务端实现,可能不可见 |
适合场景 | 前缀结构稳定、长度可控 | 前缀持续增长、断点之外仍在变化 |
在Memfit中会尽量使用显示缓存,隐式缓存是服务端的不透明优化:命不命中、按什么粒度、什么时候失效,都由服务端决定,也没有承诺。显式缓存把这些变量变成确定的:断点由我们选,生命周期与计费口径已知,每次建了多少、命中了多少都随 usage 返回。 所以只要条件允许就优先开显式。
显式缓存是客户端来完成缓存的命中切分,所以自然会有更多的工作需要客户端承担,显式缓存下如果什么都不做,所内容作为一条 message 发出去——任何一个字节变化(时间戳、nonce、工具观察、用户输入)都会让变化点之后的所有内容离开可命中前缀。
而Memfit的prompt有明确的成分分块 固定指令、冻结历史、技能与 Schema、任务指令、开放时间线、本轮动态。
所以 中间件 的做法在处理的时候遵循:按"跨请求是否字节稳定"给内容排序,稳定的放前面、变化的排到最后,再明确告诉服务端在哪里可以切缓存。
此外显式缓存本身还有两个应用约束。
•断点要足够长才有意义:dashscope 的建块阈值实测在 1024–1500 token 量级(Qwen BPE),低于这个量级的段就算打了断点也不会建块,Memfit 在投影侧用 1024 字节作为"太短就别打断点"的保守门槛。
•断点匹配的是完整前缀与消息边界:断点之前的内容必须逐个字节一致,断点之后的变化才不会影响前面那一段的复用。再加上不同服务的行为差异——qwen 的显式缓存会关闭自动前缀缓存,并且只按完整消息边界匹配,而 Memfit 的开放时间线会持续增长、越过冻结边界。
我们大致上分了三步骤完成这个工作:
1.渲染期稳定区块位置。
prompt 按 high-static → frozen → semi-1 → semi-2 → timeline-open → dynamic 排序,每段用 AITAG 包裹;稳定段使用稳定 nonce(同样的语义输入 → 同样的 6 字符 nonce → 同样的字节),跨请求前缀才有可能逐字节一致
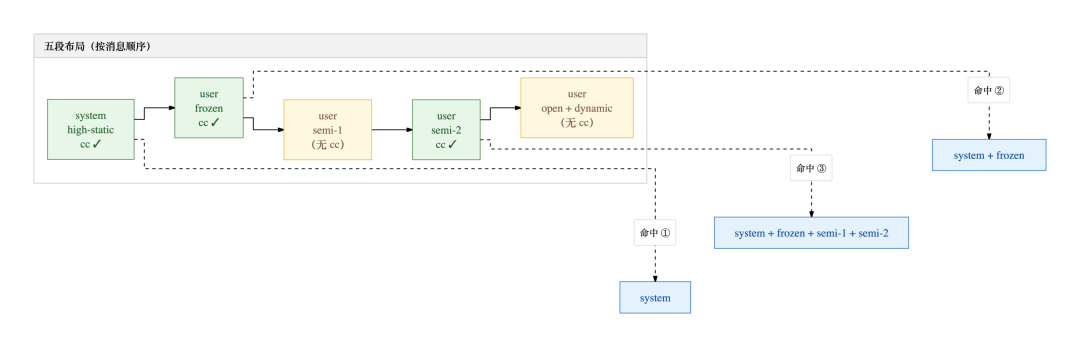
2.解析prompt选择合理布局。
布局按 5 → 4 → 3 → 2 段的优先级挑最宽可用的一种;cache_control 只打在稳定前缀上。五段布局里 semi-1 不打断点,但前缀仍然跨过它、直达 semi-2 的断点——等价于把 semi-1 + semi-2 当作一个合并前缀;实际可用命中点是 system、system+frozen、system+frozen+semi1+semi2。
Plain Text
1  def choose_layout(sections):
2      if all_three_boundaries: return "5-segment"
3      if two_boundaries:       return "4-segment"
4      if frozen_exists:        return "3-segment"
5      return "2-segment"
6
7  # merge stable segments shorter than 1024 bytes:
8  # a breakpoint that short never creates a cache block
3.按服务分支。
Memfit 默认走显式断点;在使用不支持显式缓存的模型时移除 cc、保留消息切分与全部内容,改走隐式缓存,让持续增长的历史前缀参与自动匹配;协议本身不携带 cache_control 的路径(例如 /responses)按该 API 自身的缓存语义处理。这个字段只对文本内容生效,不识别它的服务会直接忽略,不会产生副作用。
YAK
3.2 原生Functioncall
在我们的设计中,Memfit 的 prompt 渲染层不知道、也不需要知道最终发给模型的是文本 action JSON 还是原生 tool_calls。它只做一件事:把本轮的动作定义写成 AITAG 块,标签后缀就是动作名,内容是这份工具的完整 JSON Schema。
两类渲染产物对应两种通道,但都只是文本:
•文本模式:渲染 <|SCHEMA|> 的 JSON Schema,留在消息正文里,模型按 @action 输出动作;
•原生模式:渲染一组 FUNCTION_CALL_ACTION_SCHEMA 块,等待中间层把它们变成 tools。
动作集合本身来自同一处:先按本轮的可见性、禁用与必须使用规则过滤出动作列表,再决定渲染成哪种文本。所以切换文本/原生只是切一个开关,prompt 的构建逻辑不用动——最终形态由中间层在发送前决定。
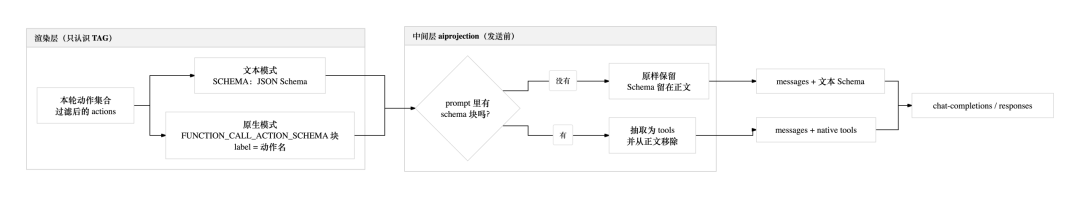
请求模型之前: 中间层扫描 Schema 槽位,把块解码成 native tools 并从正文移除。任一块畸形、名字不符或重名,就整份放弃、保持原样——不发送半个工具集,否则模型看到的工具与 prompt 声明不一致。正文里只要还有文本模式 Schema,投影整体跳过,两种表达不会相互冲突。
模型响应之后: 原生响应以两类 AITAG 信封存入时间线,只在投影时还原:
Plain Text
1  FUNCTION_CALL_ACTION_RESPONSE → assistant(tool_calls) + N × tool 回执
2  TIMELINE_MODEL_THINKING_V1    → assistant(reasoning_content)
动作组在处理前整组写入:assistant 携带 reasoning_content、content 与全部 tool_calls,每个调用配一条"已受理、结果随后"的回执;执行结果仍是普通时间线事件,不伪装成协议消息。推理回放把上一轮的 reasoning_content 还原成 assistant 消息。
YAK
3.3 Prompt工程的各司其职
这套分工的直接好处是解耦。prompt 构建侧只需要做一件事:把内容放进正确的区段,保证稳定段的字节不变。至于切成几条消息、断点打在哪里、哪个模型走隐式缓存、Schema 怎么变成 tools,全部由投影层决定。新增 provider、调整缓存布局、切换 Function Call 模式,都不需要改 prompt 的构建逻辑。
四、结语:分层之后
契约层(JSON Action)保证任何模型服务都能驱动 Memfit。
表达层(原生 Function Call)在支持的通道上换取更短的下轮思考、更顺的批量调用、更少的一次参数生成;
中间件层(aiprojection)把 prompt 翻译成 messages,把缓存策略和协议差异收进自己。
三层各自独立,又可以逐层替换。这次重构删掉的从来不是 Action 契约,而是运行时内部那一跳参数生成;新增的也不是另一套协议,而是同一份契约上更高效的一种表达。
一句话:通用性留在契约里,性能优化收在表达层,复杂度沉到中间件。
END
Memfit:是万径安全旗下Yaklang团队研发的面向长程渗透测试、漏洞挖掘、应急响应等全链路攻防任务的生产级安全领域Agent系统
Yakit:是万径安全旗下Yaklang 团队开源的一款完全国产的交互式安全测试平台
YAK官方资源
Yakit官网下载地址:
https://yaklang.com/
Github地址:
https://github.com/yaklang/yakit
Yakit 视频教程:
https://space.bilibili.com/437503777
Memfit下载地址:
https://memfit.ai/
IRify下载地址:
https://ssa.to/
YTray下载地址:
https://yaklang.io/ytray/
本文转载自微信公众号「Yak Project」,查看原文。版权归原作者所有,如有侵权请联系删除。