复旦大学计算与智能创新学院CodeWisdom团队两篇论文同时荣获ACM SIGSOFT杰出论文奖
CodeWisdom 2026-10-15 21:40 上海
CodeWisdom团队两篇论文荣获ISSTA2026 ACM SIGSOFT杰出论文奖。
点击蓝字 关注我们
近日,复旦大学计算与智能创新学院CodeWisdom团队(复旦大学软件工程实验室)的两篇研究论文在美国加利福尼亚州奥克兰举办的国际软件测试与分析研讨会(ACM SIGSOFT International Symposium on Software Testing and Analysis,ISSTA 2026)上,双双荣获ACM SIGSOFT杰出论文奖(Distinguished Paper Award)。ISSTA是中国计算机学会(CCF)推荐的A类国际会议,也是软件工程领域的重要国际学术会议。本届大会共收到888篇论文投稿,最终录用210篇。CodeWisdom团队的两篇论文从中脱颖而出,展现了团队在软件测试与分析领域的研究积累。
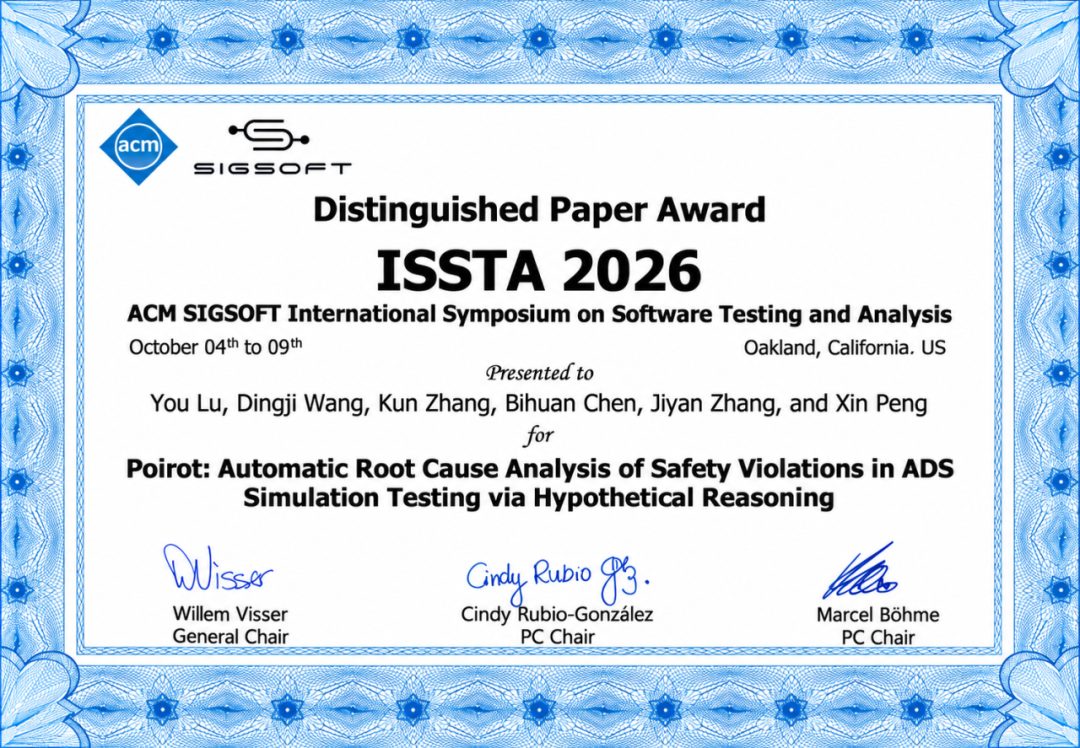
Poirot论文获奖证书
研究背景
随着自动驾驶技术的发展,仿真测试已成为发现系统安全问题的重要手段。通过构造复杂交通场景,研究人员能够发现碰撞、闯红灯、越过黄线和无法到达目的地等违规行为。然而,发现问题之后,如何进一步找出系统内部的故障原因,仍然需要大量人工分析。自动驾驶系统通常由定位、感知、预测、规划和控制等模块协同工作,一个模块中的细微错误可能沿着消息传递链条逐步扩散,最终表现为车辆的不安全行为;模块内部又包含众多模型、算法和配置,使故障排查更加困难。
针对上述问题,CodeWisdom团队提出了基于假设推理的自动化根因分析框架Poirot。其核心思路是:如果某个模块或组件能够正确工作,同一场景中的安全违规是否还会发生?围绕这一问题,Poirot在仿真环境中构造并检验反事实执行,逐步将故障范围从系统模块缩小到具体组件。
方法概述
Poirot采用两阶段分析流程。首先,重放可复现的违规场景,从仿真器中获取理想化信息,构造理想化模块并依次替换实际模块,观察违规是否仍然发生,从而定位故障模块。随后,针对定位、感知和预测模块,比较实际输出与理想化输出,计算组件的可疑程度,并通过可疑度引导的搜索减少重复尝试;针对规划和控制模块,则采用因果分析进一步定位故障组件。通过这种由粗到细的分析方式,Poirot将场景中的异常行为与系统内部的故障联系起来。
实验评估
团队在Apollo和Autoware两个自动驾驶系统上开展了实验评估,构建了包含80个真实及注入故障的评测基准,覆盖五类模块及四类安全违规。实验结果表明,Poirot在模块级和组件级的平均定位准确率分别达到91.87%和90.62%。在面向实际测试结果的应用评估中,团队利用AVFuzzer和MoDitector生成的425个违规场景检验Poirot的分析能力。这些场景涉及8个不同的故障组件,Poirot正确完成了其中382个场景的组件级归因,准确率为89.88%;相较人工分析,分析耗时减少至少94.59%。这一结果表明,自动化根因分析能够帮助开发者从大量违规场景中识别关键故障,减少重复排查工作,提高自动驾驶系统的调试效率。
CodeWisdom团队AI系统工程组长期致力于复杂AI系统的可信保障工作,此次研究进一步推进了团队在自动驾驶系统测试与安全保障方向的探索,为复杂多模块系统的故障定位提供了方法支撑。
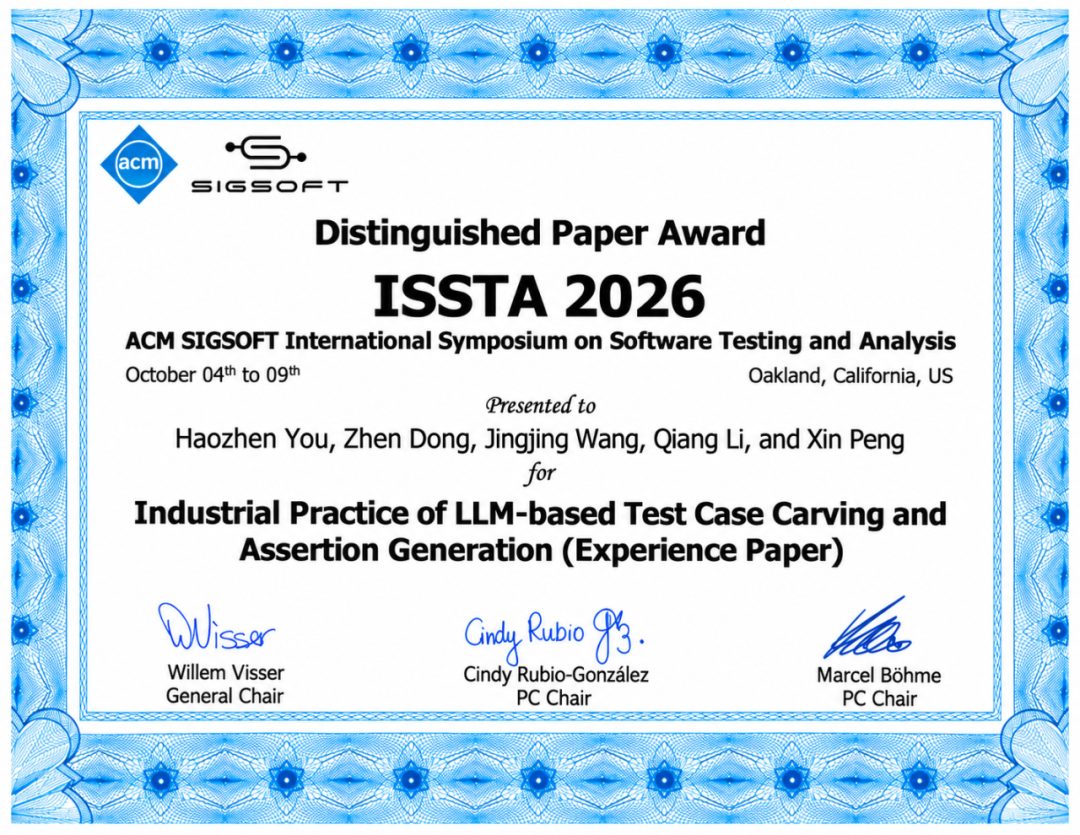
NL2Test论文获奖证书
研究背景
随着企业软件向大规模微服务架构演进,跨服务业务流程的回归测试面临日益突出的效率与质量挑战。接口与业务需求快速变化,文档却常常缺失或更新滞后,测试工程师不得不从真实执行流量中识别关键接口、恢复调用顺序,并手动处理动态参数与业务断言。这一过程不仅耗时,而且容易出错。大语言模型虽具备语义理解和代码生成能力,但直接用于测试生成时,仍可能选错接口、虚构字段或生成不稳定断言。针对这些问题,复旦大学CodeWisdom与字节跳动研究团队提出NL2Test,以自然语言场景描述和实际流量记录为输入,自动生成可供工程师审核的API回归测试草稿,探索智能化测试在工业环境中的落地路径。
方法概述
NL2Test将生成流程划分为测试脚本雕刻与断言生成两个阶段,核心思路是让大语言模型负责语义判断,让确定性程序负责精确处理与校验。首先,系统通过规则过滤静态资源、预检和后台轮询等噪声,再由模型将场景步骤与业务请求对齐。随后,模型识别潜在动态参数,系统结合历史响应中的值一致性与模型的语义一致性检查确认依赖,将固定标识符替换为运行时变量,并通过模板组装脚本。在断言生成阶段,模型先提出结构化检查候选,系统校验响应路径、规范预期值,剔除无效或不稳定检查,最后在预设位置生成断言代码。通过分阶段生成与验证,NL2Test力求兼顾业务语义、脚本可执行性与重放稳定性。
实验评估
研究团队在字节跳动的五类业务中选取51个工业回归场景开展评估。结果显示,NL2Test在42个场景中实现接口序列、动态参数传递和断言逻辑与人工基准严格一致,精确匹配率为82.4%;允许少量人工修改时,可用草稿比例达到98.0%。单个场景平均生成耗时265秒,平均消耗约4.26万词元。在论文报告的九个月生产部署期内,系统共生成3196个测试用例,其中2730个被工程师采纳,采纳率为85.4%。这些结果展现了该方法辅助工业测试的应用潜力,但其对实时动态内容、非标准协议及高噪声重复请求的处理仍有限,跨企业适用性也有待进一步验证。
目前,NL2Test Agent已在字节跳动公司多条业务线部署应用,并取得显著成效:85.4% 的生成用例被集成到 CI/CD 工作流中;新增用例里,平均值约25%来自 Agent 生成,个别业务团队峰值可达50%+,且比例仍在持续提升;Agent用户月活率达到30.7%;工具平均每双周为部门节省约 30 人天投入。
本文转载自微信公众号「CodeWisdom」,查看原文。版权归原作者所有,如有侵权请联系删除。