CVPR 2026 Oral | WorldLens:驾驶世界模型,怎样才算可靠?
原创 52CV 2026-10-22 22:24 江苏
一段生成的行车视频,可能有清楚的车道线、自然的光照,以及相当逼真的车辆纹理。但如果镜头稍微偏移,道路旁的物体会不会散开?如果驾驶策略根据这些画面连续作出决策,车辆还能否沿路线行驶?当视频被交给三维感知模型,道路和交通参与者又能否被准确识别?
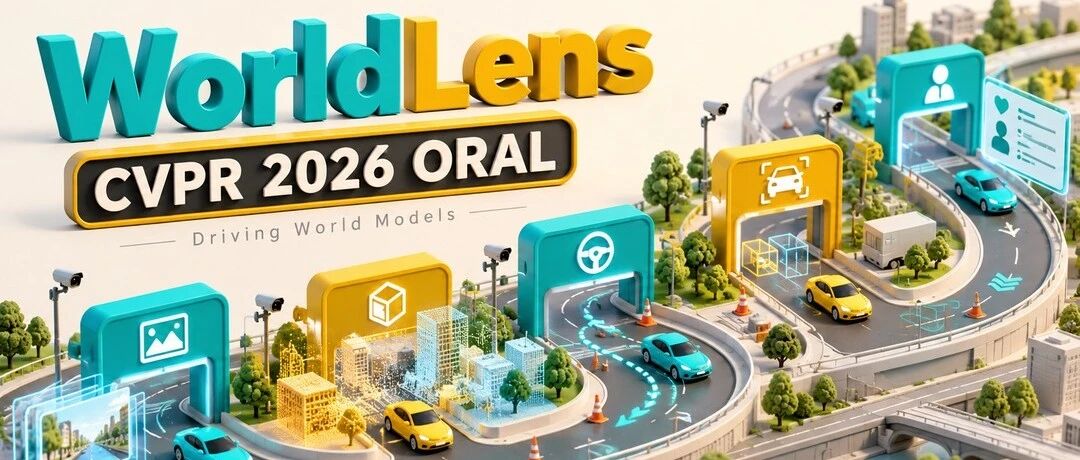
这些问题决定了生成场景能承担什么用途。展示一段视频、恢复一个三维场景,以及让车辆在生成环境中持续行动,需要的能力并不相同。收录于 CVPR 2026 Oral 的 WorldLens 将评测范围扩展到五个方面、24 个细分维度,把画面、几何、控制、下游感知和人的判断放在同一套框架中考察。
论文题目: WorldLens: Full-Spectrum Evaluations of Driving World Models in Real World
录取会议: CVPR 2026 Oral · 论文已接收并入选口头报告
从一段视频,追问它背后的世界
现有视频指标可以回答部分重要问题。例如,生成视频与真实视频的分布有多接近,画面是否稳定,物体外观是否自然。但它们很难单独说明:不同摄像头看到的是否是同一个空间,车辆在遮挡之后能否保持身份,以及场景对驾驶动作的响应是否足以支撑连续控制。
WorldLens 的五个方面对应五类可检验的问题:生成 (Generation) 检查对象、时间和多视角的一致性;重建 (Reconstruction) 检查视频能否恢复出连贯的四维场景;动作跟随 (Action-Following) 观察预训练规划器在生成世界中的表现;下游任务 (Downstream Task) 检查现成感知模型能否读取有效信息;人类偏好 (Human Preference) 则补充对真实性、物理合理性和行为安全的判断。
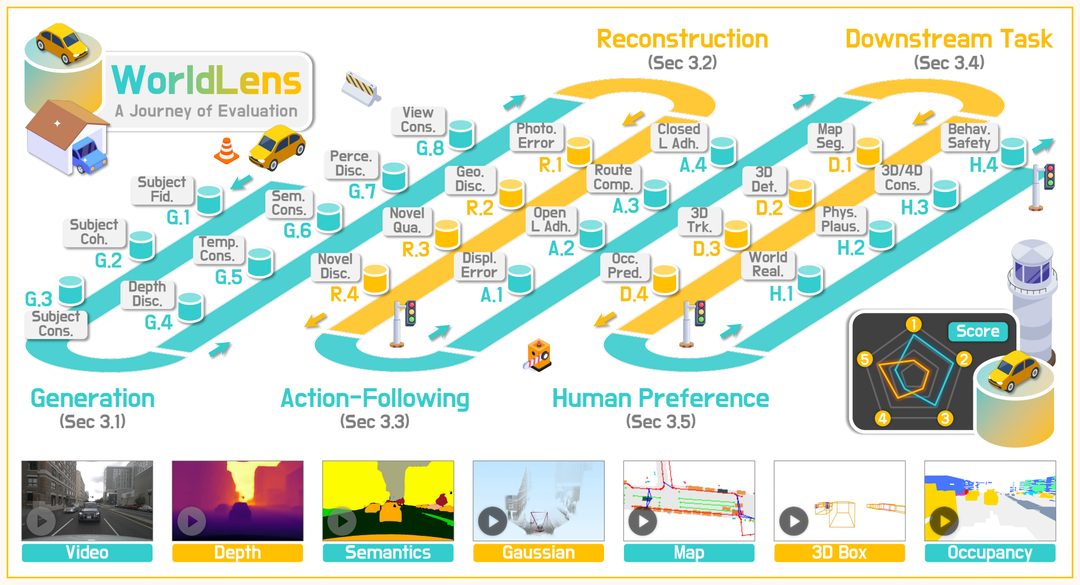
这套设计的用途,在于说明模型在哪一环出了问题。同一个方法可以生成比较自然的纹理,却缺少稳定几何;也可以保留道路结构,却无法支持长时间控制。仅比较一项总分,很容易掩盖这种能力分布。
生成质量,要看物体怎样随时间变化
在生成评测中,WorldLens 不仅观察整帧画面,也检查车辆、行人等具体对象。外观真实的车辆,是否能在连续帧里保持形状、颜色和身份;场景语义和深度变化,是否与运动过程相容;相邻摄像头的重叠区域,是否存在合理的对应关系,都是独立的检查项。
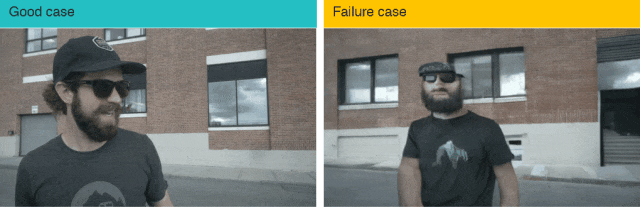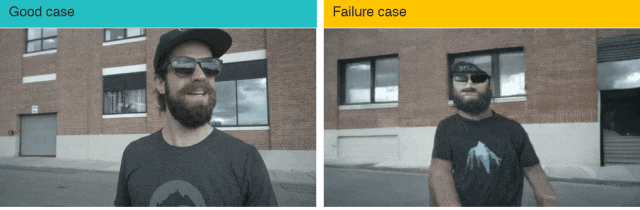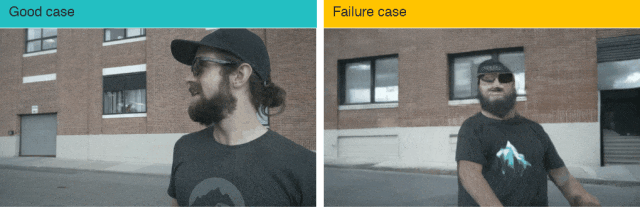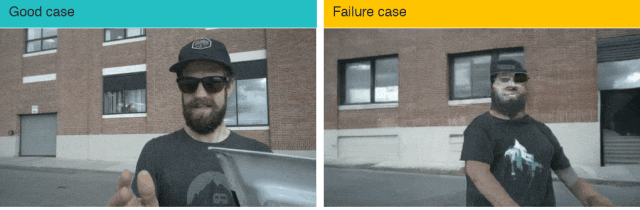
项目主页给出的时序一致性对比,将同一评价维度下的良好案例放在左侧、失败案例放在右侧。连续播放有助于观察单帧截图不容易暴露的变化,但某个案例的表现仍需和整体指标一起判断。
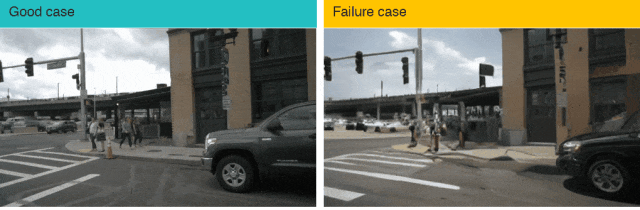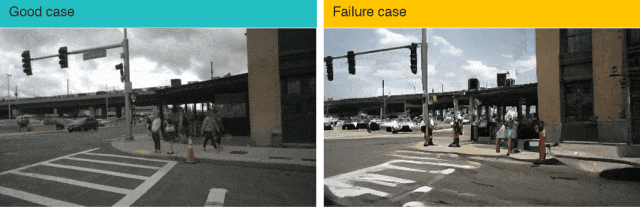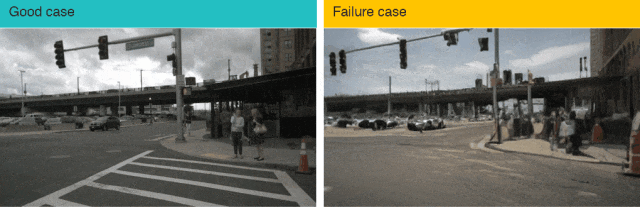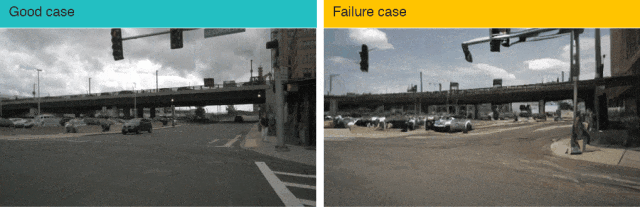
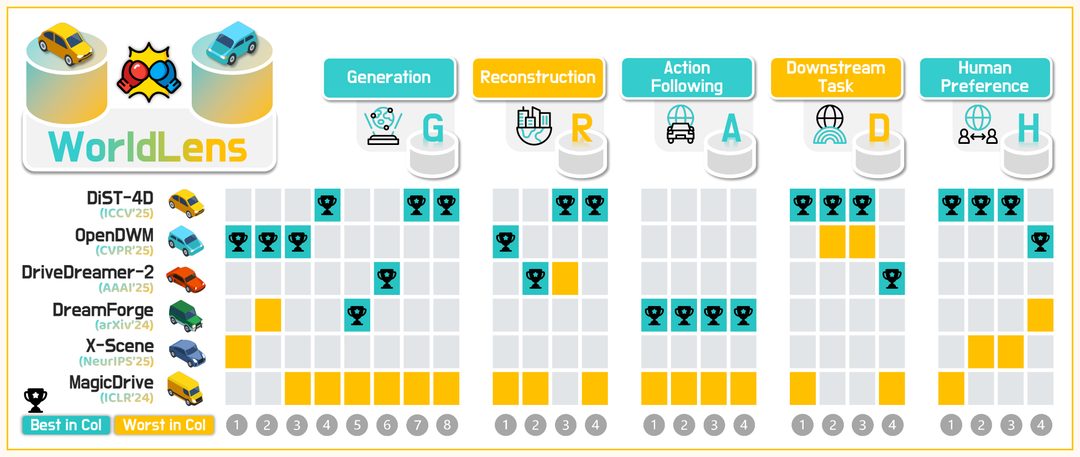
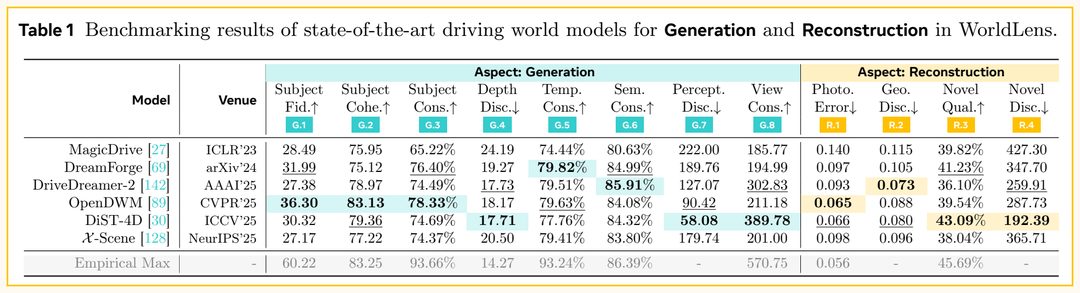
论文中的生成与重建结果也表明,不同指标会选出不同的领先方法。例如,DiST-4D 的感知分布差异为 58.08,低于 OpenDWM 的 90.42;对象保真度一项则是 OpenDWM 的 36.30 高于 DiST-4D 的 30.32。这些结果分别对应不同能力,不能互相代替。
视角一变,几何问题才显现出来
WorldLens 将生成视频重建为四维高斯场 (4D Gaussian Field),再沿原始相机和新的相机轨迹渲染。前者检查能否解释输入画面,后者进一步观察视差、遮挡和结构在新视角下是否成立。
在包含货车的对比场景中,原视角的视频、侧向偏移后的重建渲染和深度图被放在一起。部分模型的重建出现悬浮伪影和形变,而另一些模型保留了更连贯的结构。画面清晰度难以单独揭示的缺陷,在这一过程中更容易被发现。

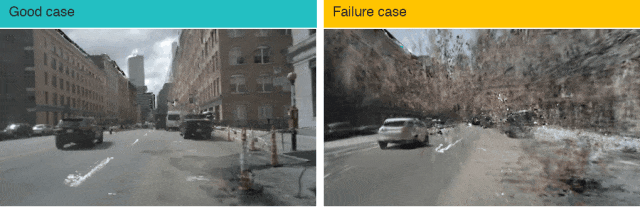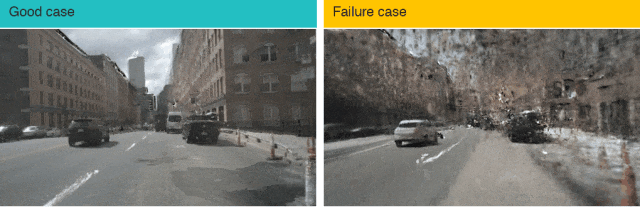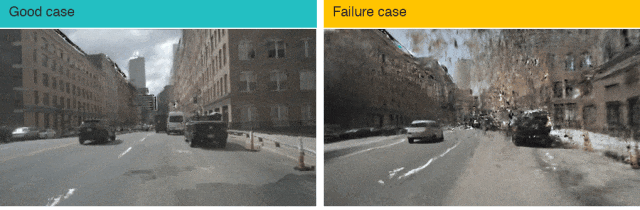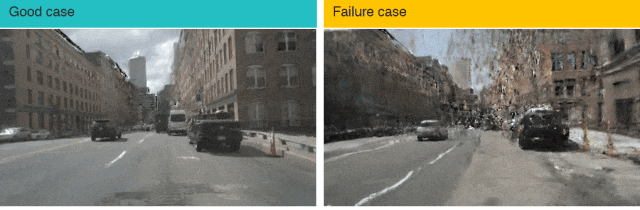
重建质量同时受生成内容、重建方法和相机设置影响。因此,这项测试提供的是统一协议下的几何证据,需要结合生成指标和其他任务共同解读,不能把一次重建失败直接等同于对模型内部表示的完整判断。
规划分数不错,路线却未必走得完
动作跟随评测进一步引入预训练规划器。开环 (Open-Loop) 评测中,预测动作不改变后续观测;闭环 (Closed-Loop) 中,规划器的决策会控制自车,进而影响接下来看到的环境。后者更容易暴露连续生成和连续决策相互作用时的误差累积。
在论文给定的生成仿真设置下,MagicDrive-V2 的开环得分为 78.91%,路线完成率为 12.31%;RLGF 的对应数值为 78.45% 和 13.51%。这两组数值度量的是不同任务结果,不能简单相减,但它们清楚地说明:短时规划表现与长程路线完成能力存在明显差距。
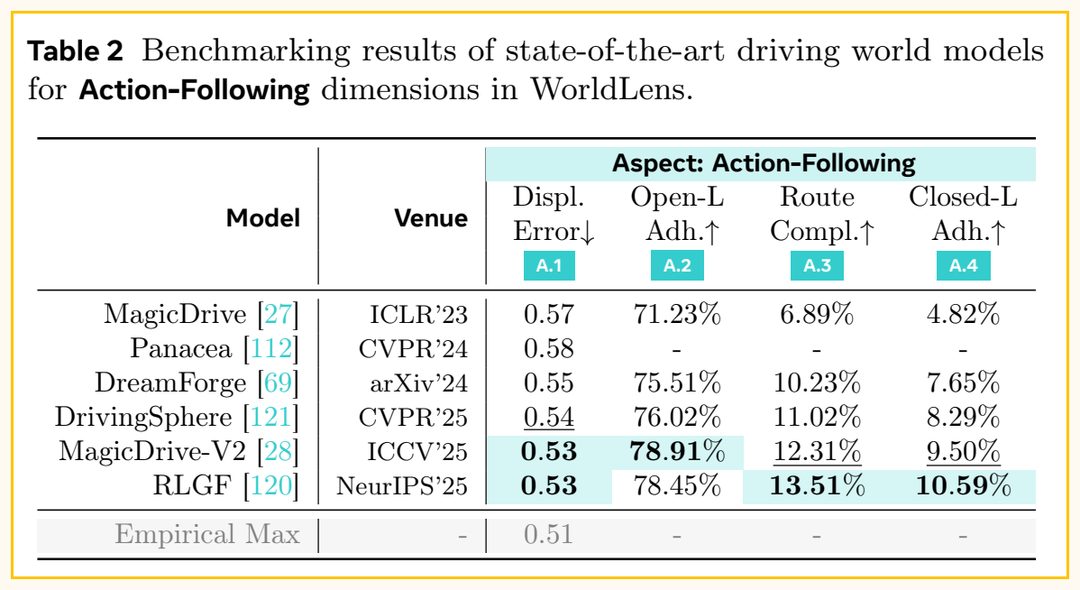
这里检验的是生成环境与既定规划器共同组成的系统。碰撞、驶离道路等失败,是该模拟协议下的观察结果,并非真实道路上的安全认证,也不能据此把责任全部归给单个组件。
下游模型能否读懂生成场景
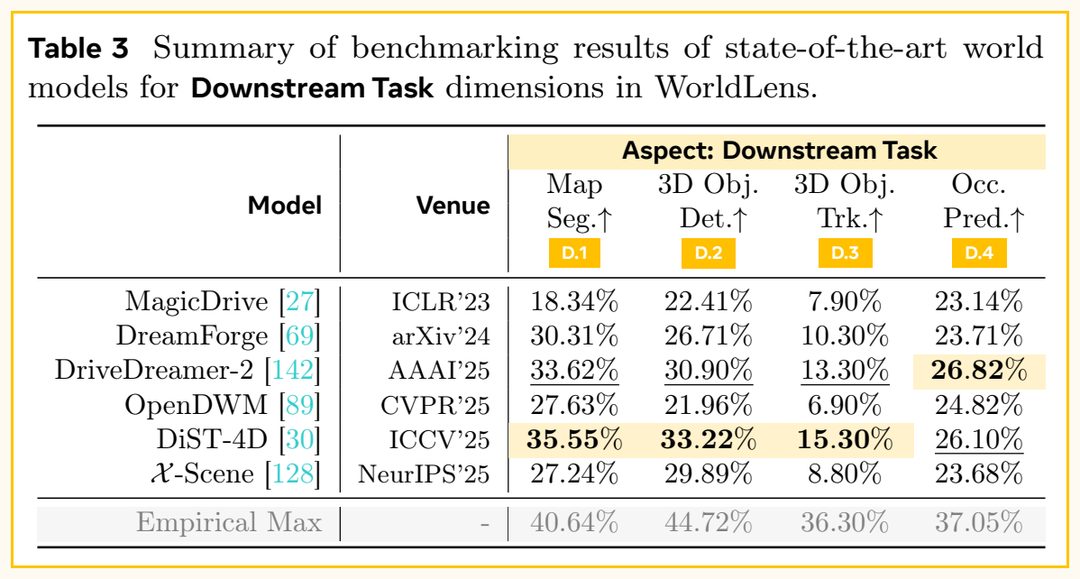
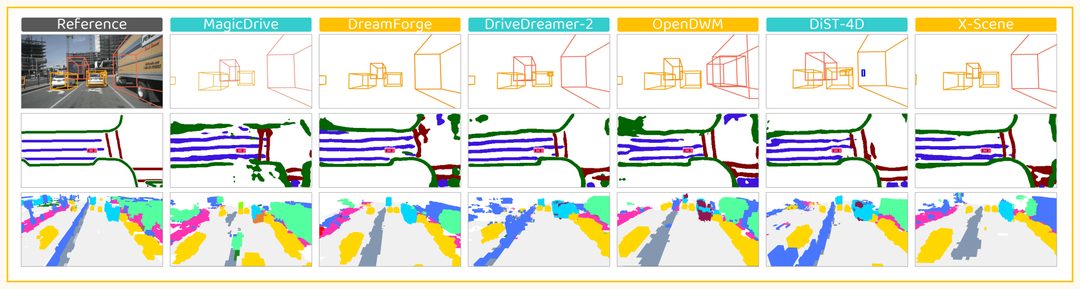
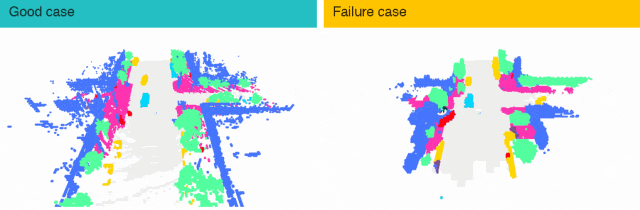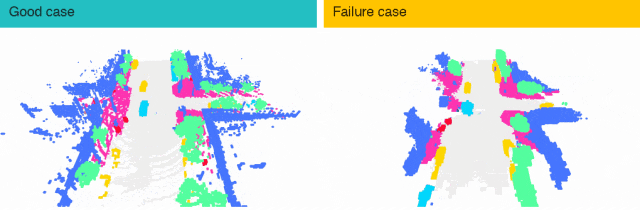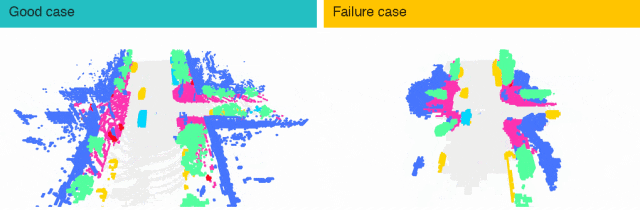
对于下游任务,WorldLens 把在真实数据上预训练的感知模型应用于生成视频,考察地图分割、三维检测、三维跟踪和占用预测的表现。这是在测量合成场景提供的信息是否可用,不能直接解读成“用合成数据重新训练后,真实任务提高了多少”。
OpenDWM 的三维检测得分为 21.96%,DiST-4D 为 33.22%;三维跟踪对应为 6.90% 和 15.30%。而占用预测的领先方法是 DriveDreamer-2,得分 26.82%,高于 DiST-4D 的 26.10%。任务不同,优势方法也会变化。
人的判断,也应当留下理由
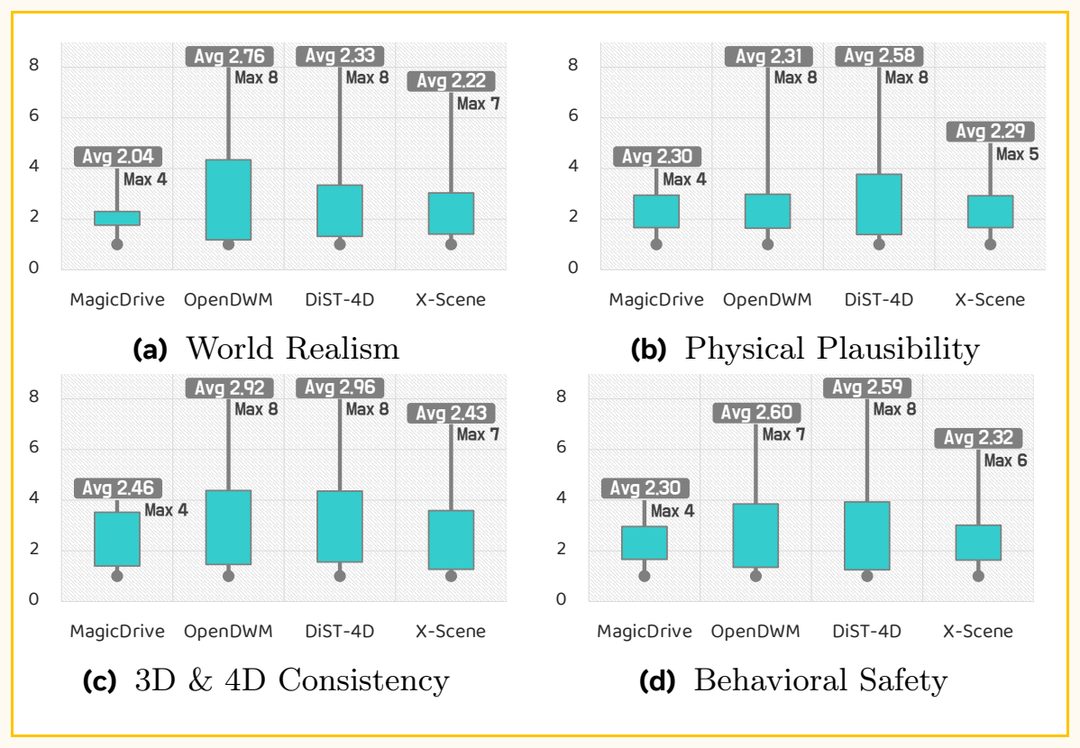
视频中的物理合理性和行为安全,还有一部分难以由既定指标充分表达。WorldLens 为此建立了人工标注流程:标注员同时查看视频、语义、深度和三维框,按明确维度评分,并写下简短理由。行人的比例、动作和遮挡变化,也因此能够进入讨论。
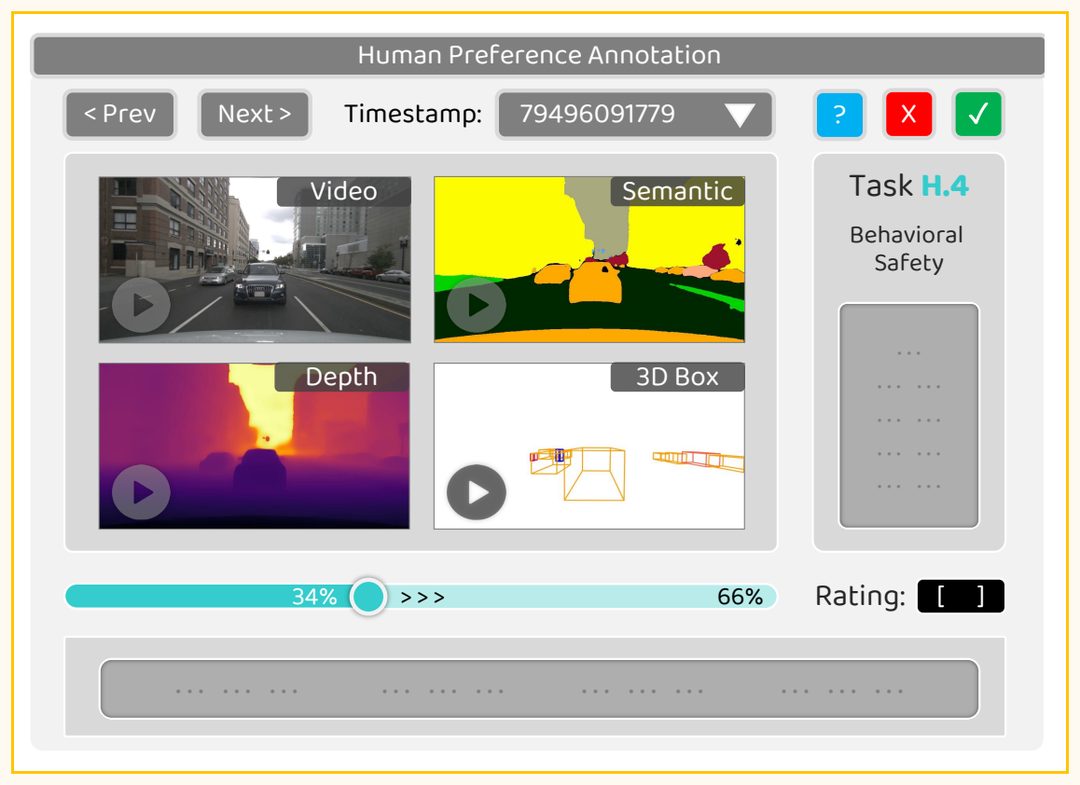
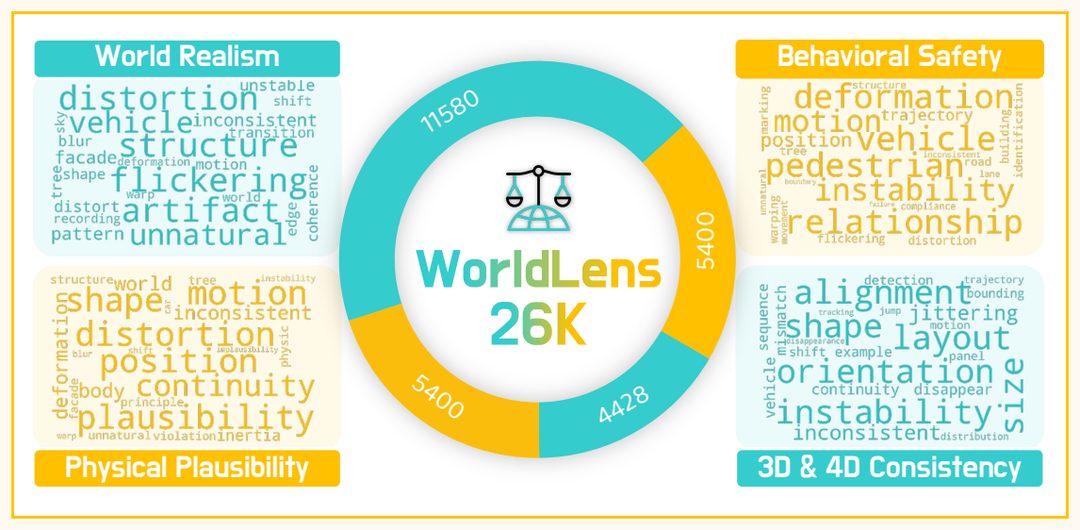
WorldLens-26K 包含 26,808 条评分记录,每条记录由分数和文字理由组成。这一数量指评分记录,并非 26,808 段独立视频。WorldLens-Agent 则以这些标注为监督,对 Qwen3-VL-8B 进行 LoRA 微调,学习输出分维度的评分与解释。
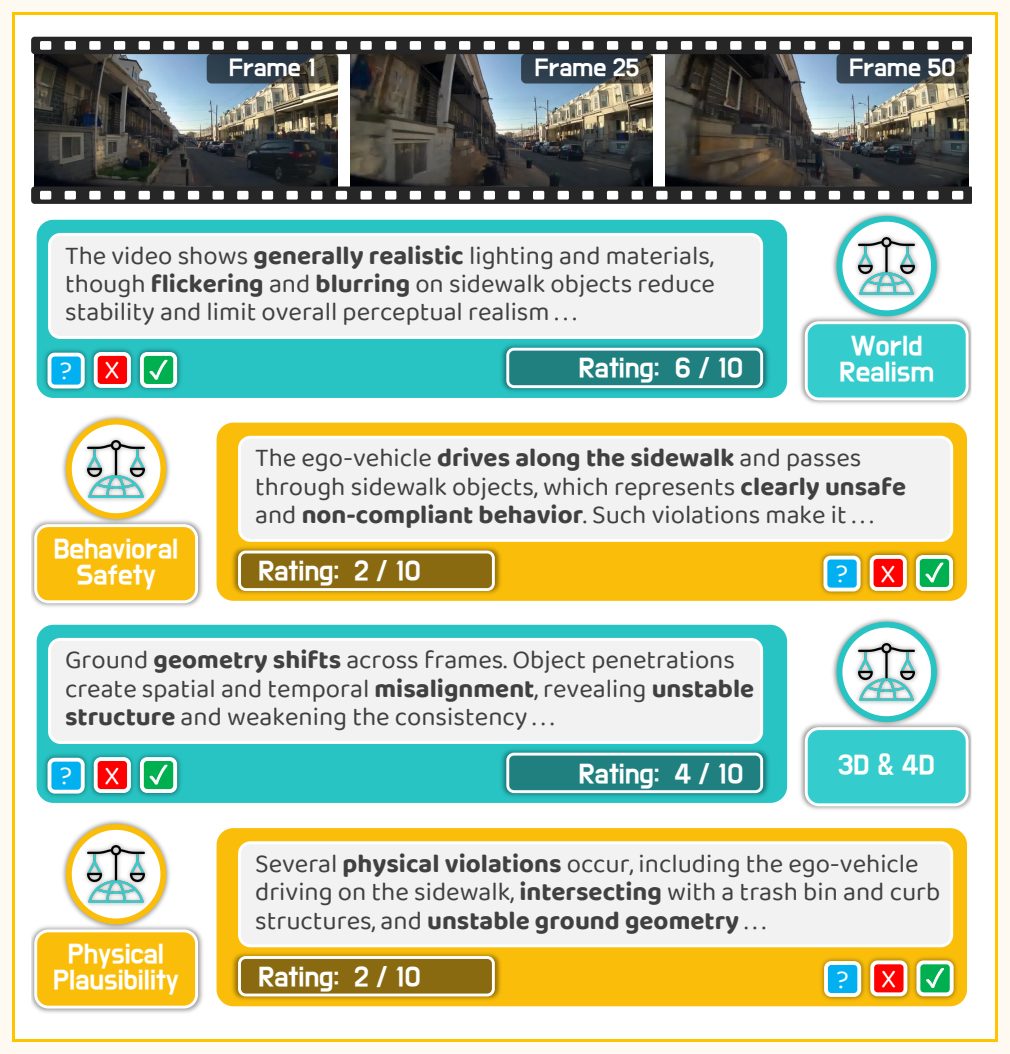
在来自 Gen3C 的未见视频上,论文给出了自动评估案例:同一段视频的外观可以获得较高评价,行为安全和物理合理性却得到较低评价,并分别附上理由。这样的输出比单个“总体不错”的判断更有助于定位问题;其泛化能力仍应结合更多模型和场景继续验证。
WorldLens 提供了一条更完整的评测路径:先确认画面质量,再检查几何和时间结构,继续测试规划与感知,最后对照人的判断。对研究者而言,这些结果能够帮助选择下一步优化对象,也让不同方法的比较更有依据。项目已提供评测代码和在线榜单,欢迎驾驶世界模型研究者按相应协议参与评测;WorldLens-26K 与 WorldLens-Agent 的发布进度可关注项目仓库更新。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。