不写思维链,多转几圈就更准?Lev:让同一份权重按题决定“想多深”的循环决策模型
原创 52CV 2026-10-22 22:24 江苏
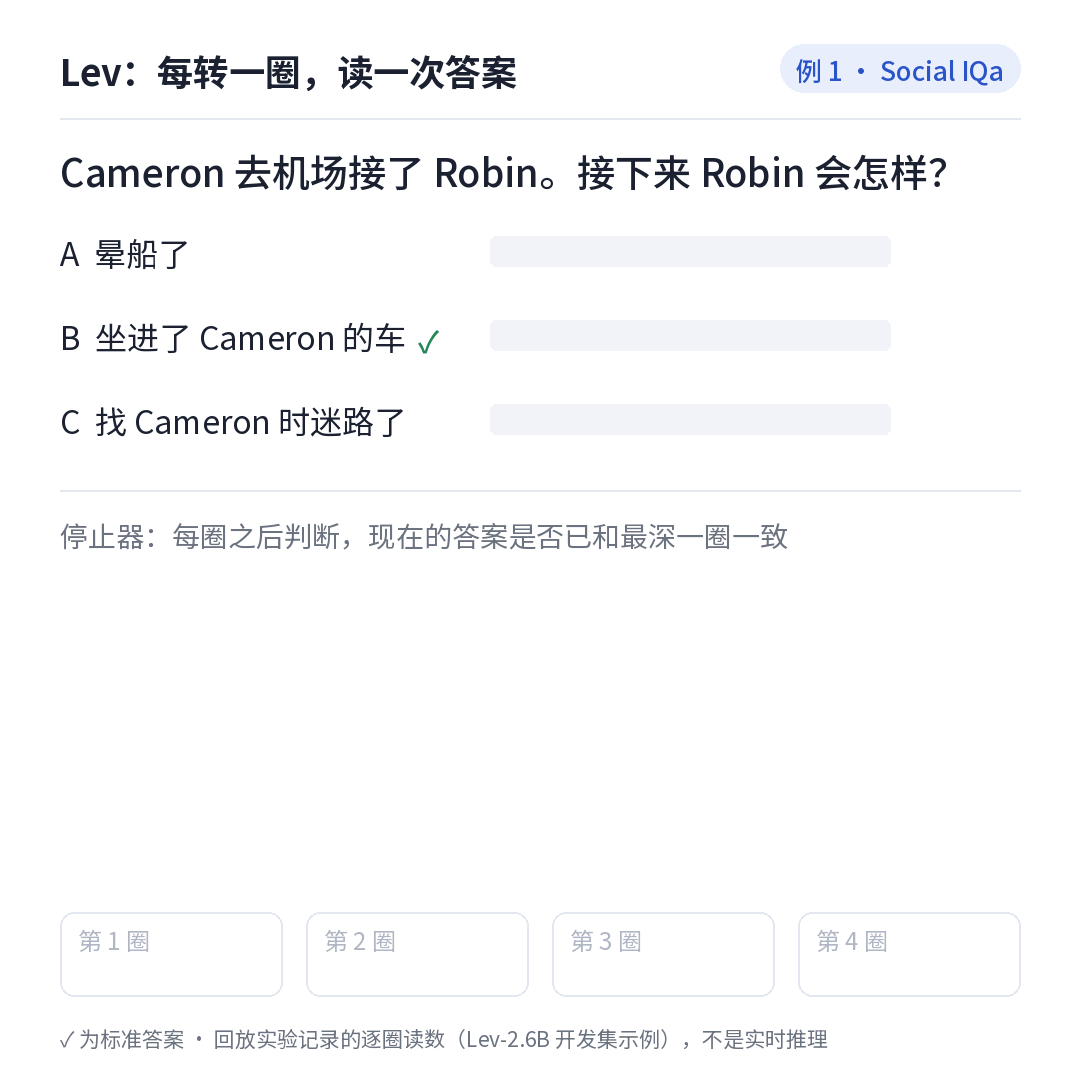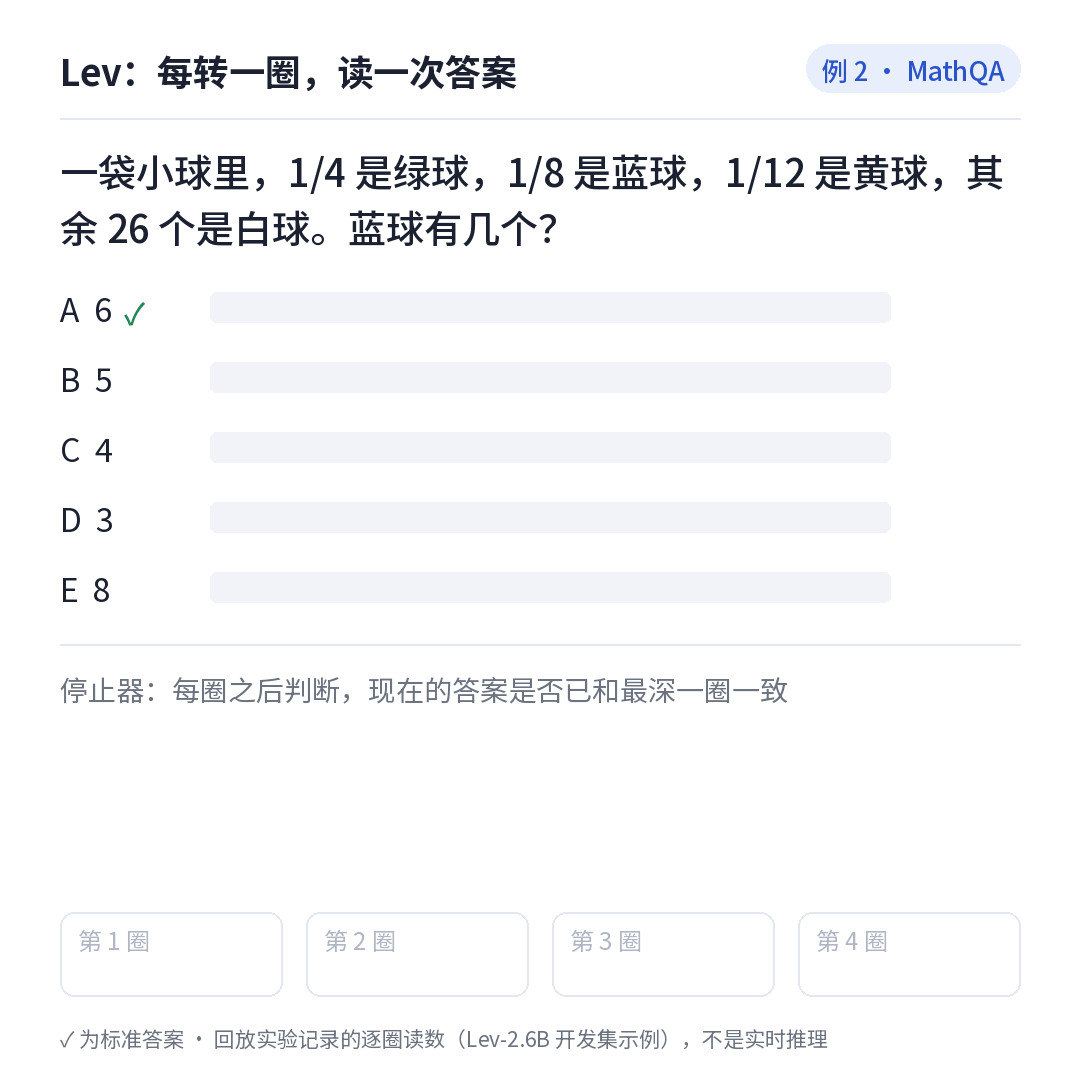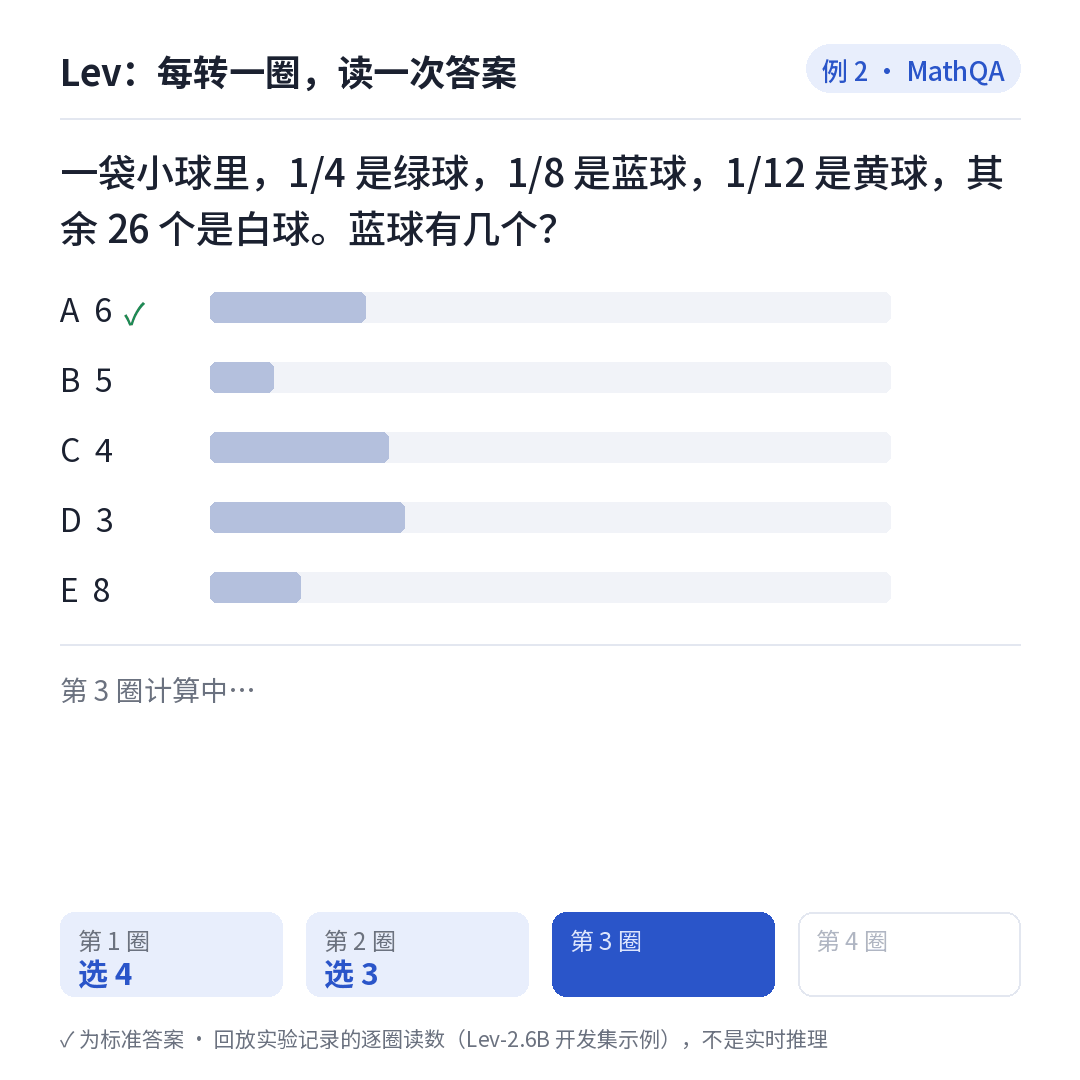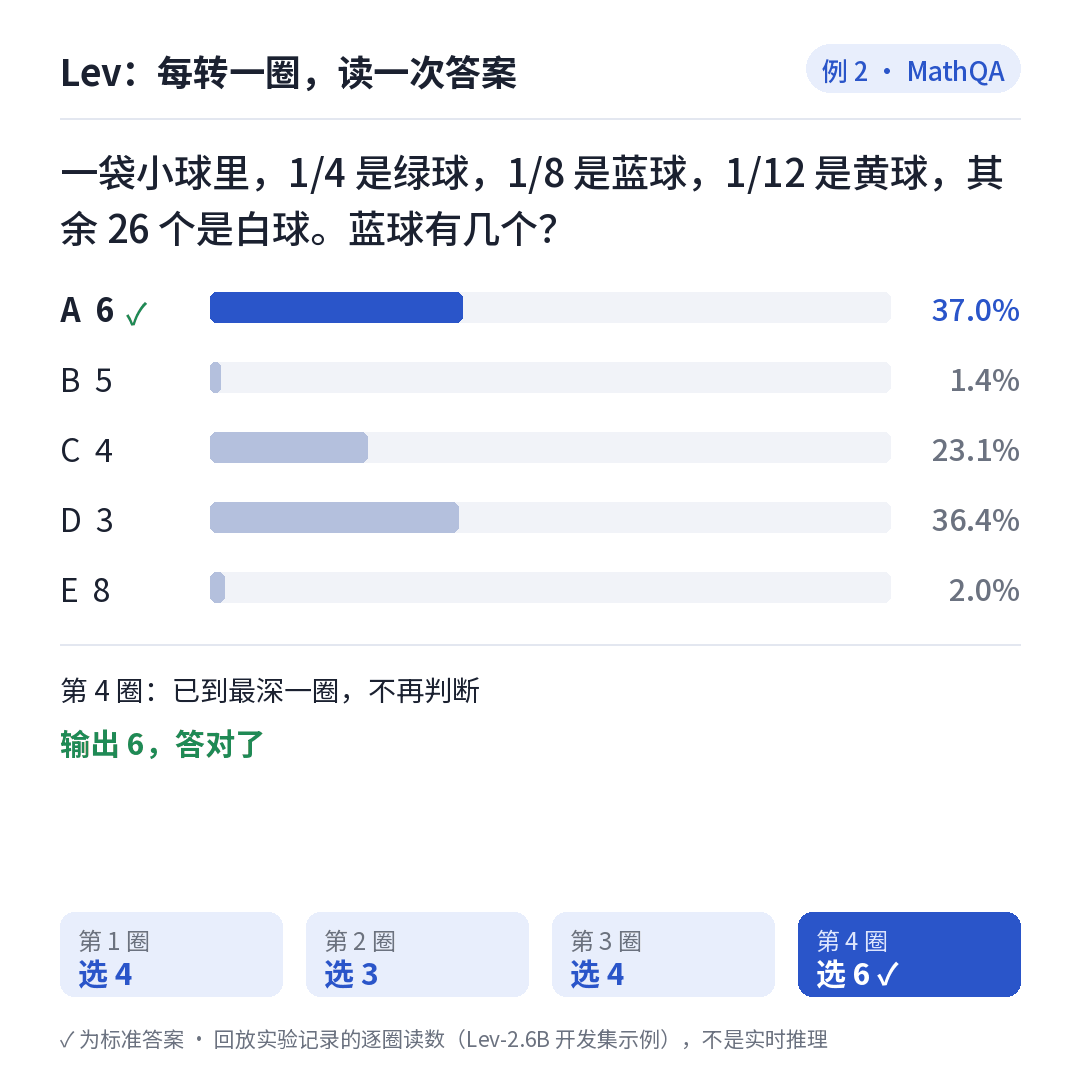
“想得更多”通常意味着“写得更多”:模型先生成一段思维链,再给出答案。
但对于路由、分类、工具选择这类答案就在给定选项里的任务,模型并不一定需要把思考写出来。一个更直接的问题是:能不能让模型在隐藏状态里多算几遍,而且只在难题上多算?
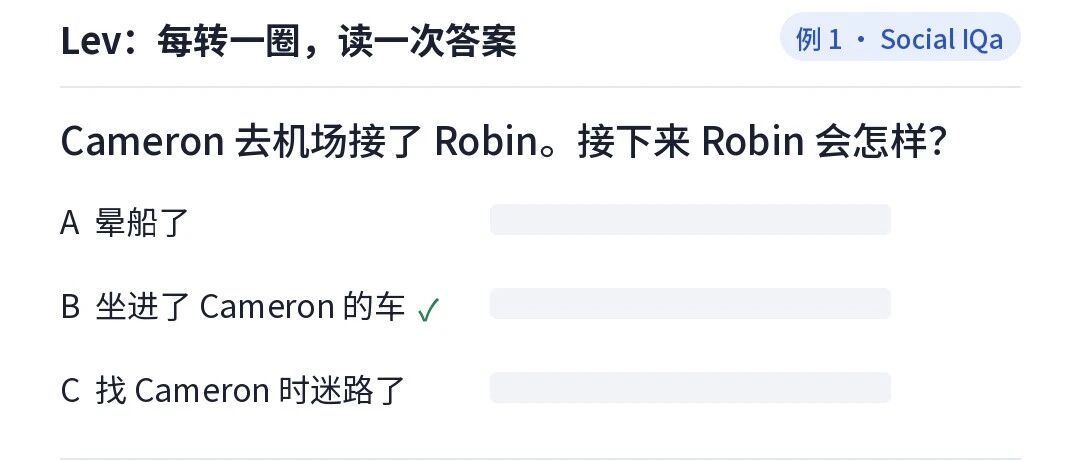
近日,来自 Lehigh University、University of British Columbia 和 Vector Institute 的研究团队提出了 Lev,一个用循环(loop)而不是 token 来加深思考的决策模型。同一组网络层反复运行,每一圈都能读出一次答案;一个轻量的停止器按题决定算几圈。
先说结论:同一个 Lev-2.6B checkpoint,在公开 JevBench 的 231 道题上从 1 圈的 63.2% 提升到 4 圈的 76.2%;按需深度在离线统计中少算 15% 到 24% 的循环计算,准确率损失不到 1 个点。
论文标题:Lev: Thinking Fast and Deep with Looped Decision Models
作者单位:Lehigh University;University of British Columbia;Vector Institute
代码仓库(已开源):https://github.com/OpenLAIR/lev
1. 问题背景:决策模型的“固定深度”
决策模型(如 Jev 及其开源复现 Kev)接收一个请求和若干候选项,用 pointer head 一次前向给出每个选项的概率,延迟在几十毫秒量级。它们的深度在训练时就固定了,对所有问题花同样多的计算。
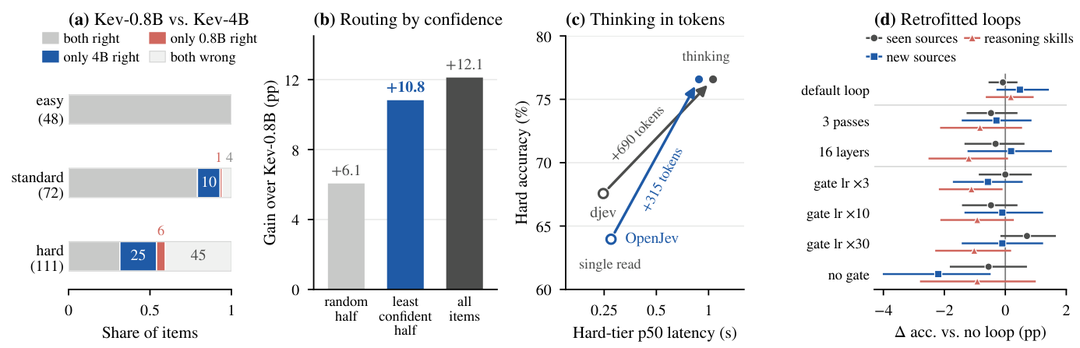
作者用两个公开模型 Kev-0.8B 和 Kev-4B 做了逐题对比:在 JevBench 的 231 道公开题上,Kev-4B 多答对的 28 道全部来自标准题和难题,两者只在 42 道题上结果不同。若把 Kev-0.8B 最没把握的一半交给 Kev-4B,准确率几乎追平 Kev-4B 全量作答。
额外计算只在少数题上有用,而一次便宜的初读就能找到它们。
2. 为什么现有方案“不香”了?
级联:被转交的题要从头重读。Kev-0.8B 的中位延迟已有 79 ms,Kev-4B 为 108 ms,级联走到大模型时比直接用大模型还慢。
生成推理:在同一 26B 底座的两个开源 Jev 式服务上,打开思考让难题准确率提高 9 到 13 个点,难题中位耗时变成三到四倍。
加装循环:在 Qwen3.5-0.8B 上把中间 8 层接成零初始化门控的循环,准确率变化不到 0.5 个点,门控始终接近零。
第三点说明,循环需要在预训练阶段就学会。因此 Lev 选择原生循环语言模型做底座:Ouro-1.4B / 2.6B(4 圈)与 Nanbeige4.2-3B(2 圈)。
3. 方法
3.1 逐圈读出
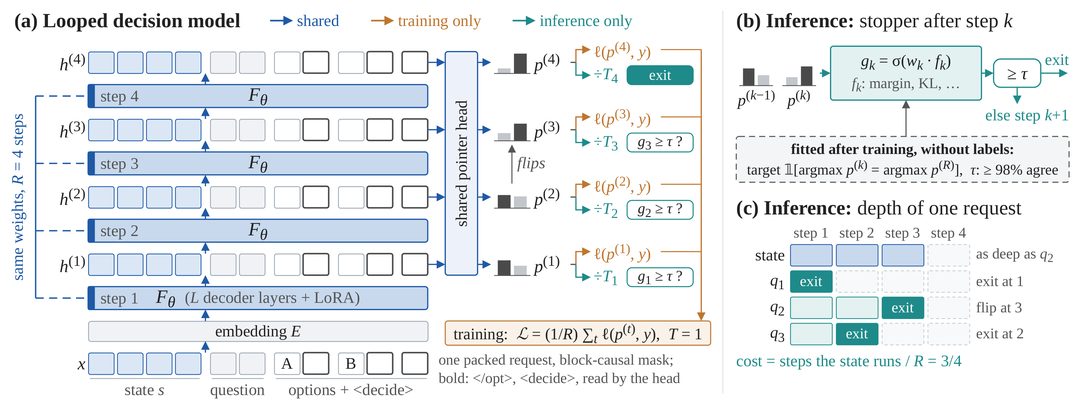
记解码层为 ,从词嵌入 出发,第 圈计算 。每一圈之后,共享的 pointer head 读取各选项结束符和 <decide> 位置的隐藏状态,得到读出 。
用 圈服务只需算前 圈,成本约为全深度的 ;多算一圈直接从上一圈的隐藏状态继续,输入不用重读。
3.2 联合训练
pointer head 与 LoRA 适配器在各圈共享,损失对所有圈取平均:
因此每个深度都是一个可用的决策模型。浅层与深层的校准程度不同,作者为每个深度单独拟合温度。
3.3 停止器:预测一致性,而非正确性
常规早退在有标签数据上为置信度选阈值。作者指出这在决策模型上迁移很差:Lev-2.6B 在 1 圈停下的题,校准集上 94.8% 正确,新数据源上只有 78.9%,置信度却几乎相同;置信度区分“多算能改对的错误”的 AUROC 只有 0.46 到 0.61。
Lev 的停止器沿用 CATs 的一致性目标,在第 圈预测当前答案是否与最深一圈一致:
每个深度一个逻辑回归,阈值取能让至少 98% 的最终答案与最深答案一致的最小值。目标来自模型自身,拟合与选阈值都不需要人工标签,可直接在目标流量的无标签请求上完成。
4. 实验结果
三个 Lev 模型与三个非循环对照(Qwen3-1.7B、Qwen3.5-2B、Qwen3.5-4B)使用相同的 31,329 条训练数据和配方。评测包括两个 held-out 测试集(其中 LevBench 在任何模型读取前已冻结)和 JevBench 的 231 道公开题。
4.1 深度带来的提升
Lev-2.6B 在 JevBench 上 1 到 4 圈依次为 63.2%、71.0%、75.3%、76.2%,提升 13.0 个点(95% CI 7.4 到 19.0),第 2 圈贡献最大。
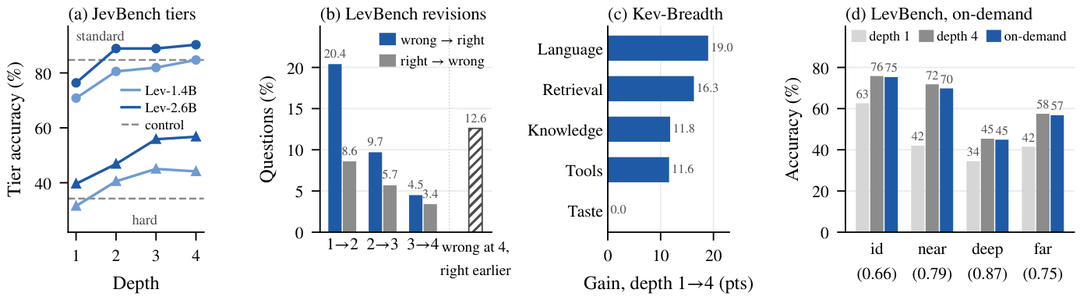
提升集中在难题:111 道难题净多答对 19 道,72 道标准题净多答对 10 道。按领域看,语言理解类提升 19.0 个点,幽默、颜色偏好这类“品味”任务没有提升。需要注意,更深不总是更对:LevBench 上第 2 圈改对 20.4% 的题,也改错 8.6%。
4.2 按需深度
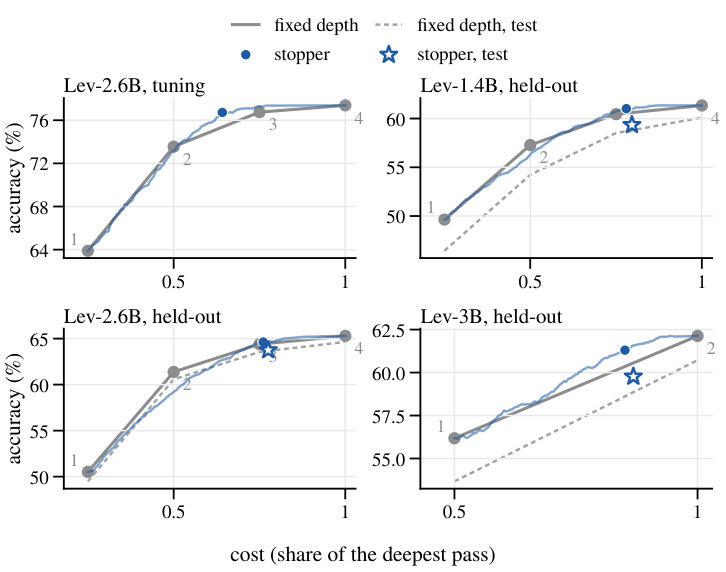
在两个 held-out 测试集上,停止器使用最深一圈 76% 到 85% 的计算,准确率损失 0.3 到 0.8 个点;在 JevBench 简单、标准、难题上平均分别用 1.2、2.4、3.0 圈。与同成本的固定深度混合相比,增益较小:Lev-2.6B 高 0.2 个点,Lev-3B 高 1.0 个点。
4.3 停止规则消融
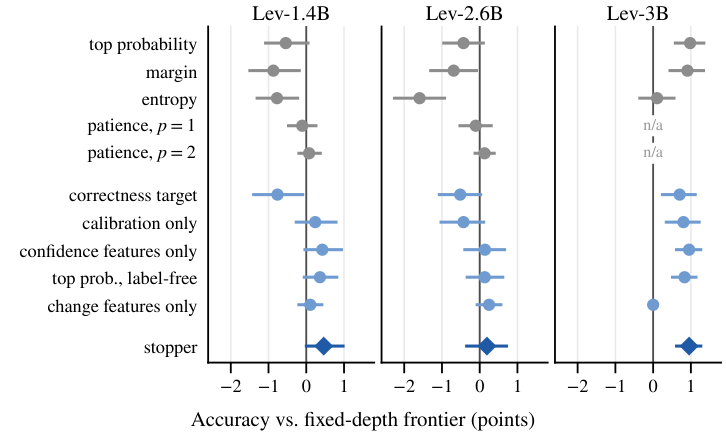
置信度、间隔、熵阈值和 patience 等早退规则在 Ouro 模型上都没有超过固定深度前沿;而在无标签目标请求上按一致率选阈值的单一最高概率阈值,与停止器只差 0.2 个点。真正起作用的是“用目标流量校准”,而不是特征设计。
4.4 延迟
在锁定测试上,39 到 46 ms 处按需的 Lev-1.4B 和 Lev-3B 比同延迟最好的非循环方案高 5.4 到 7.5 个点。延迟在单张 H200、bf16、一次一个请求下测得;按 FLOPs 计算,Lev 与非循环模型持平或更差,优势在延迟而不在计算量。
5. 总结与思考
Lev 展示了原生循环底座的一种用法:通过逐圈读出和联合训练,让“深度”成为推理时按题选择的设置;通过一致性目标和无标签阈值,让停止器在目标流量上自行校准。
几点值得关注的开放问题:
停止器以最深一圈为目标,救不回“浅层答对、深层答错”的 12.6% 的题,更好的停止目标有望超过最深一圈;
15% 到 24% 的节省是循环圈数,要转化为墙钟时间,需要支持不同深度请求打包的推理系统;
目前公开的循环底座只有 1.4B 到 3B。循环深度与逐圈读出的思路能否迁移到视觉或多模态模型,论文没有涉及,是一个开放问题。
论文、代码、三个模型和三个数据集均已开源(数据集为按来源条款筛选的子集)。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。