同一个 AI Agent,凭什么既能查张三的工资又能看李四的订单?——OAuth 令牌在 AI 时代的三个致命缺口
安全牛 2026-10-23 12:10 北京
从"人访问系统"到"Agent代人访问系统",这是技术架构的演进,更是安全范式的重构。身份安全正在成为AI时代企业安全建设的基础设施,也将成为未来AI安全竞争的核心能力。
点击蓝字 关注我们
引言:AI从工具变成了"数字员工"
现在的AI已经不只是回答问题那么简单了。你看,企业里的AI客服在自动处理退货,AI编程助手在帮开发人员写代码,HR系统里的AI在查询员工工资。这些AI Agent已经从辅助工具变成了能独立干活的"数字员工"。
但问题来了:当一个AI Agent访问企业核心数据时,系统真的知道"是谁"在访问吗?
这可不是小事。网络安全公司CrowdStrike最近发布的研究报告指出:现在广泛使用的OAuth访问令牌,根本没法准确表达"这个AI是谁、它代表哪个用户、它为什么能代表这个用户"。这意味着企业可能无法精准控制权限,审计日志也会失效,更难发现AI越权访问的异常行为。
对中国企业来说,这事儿更急。《网络安全法》《数据安全法》《个人信息保护法》卡得很严,数据访问必须精确追踪。AI身份管理要是有漏洞,不光可能数据泄露,还会惹上合规麻烦。
一、问题出在哪:从"人用系统"到"AI代人用系统"
传统模式很简单
过去二十年,企业的身份认证体系建立在一个清晰的假设上:访问者要么是员工本人,要么是明确注册的应用程序。
员工访问:张三输入账号密码 → 系统认证 → 分配权限 → 登录OA
应用调用:财务系统用API密钥 → 服务认证 → 获得权限 → 访问数据库
在这种模式下,OAuth访问令牌工作得很好,它能证明"你是谁"以及"你能干啥"。
AI Agent把事情搞复杂了
但AI Agent完全不一样。它不只是"又一个应用程序",而是可能在不同时刻代表不同用户干不同的事。
场景一:开发人员的AI编程助手
小李让Claude Code帮他重构代码。这时:
实际用户是小李
AI是Claude Code
AI在执行小李明确交代的任务
这是直接的委托关系
AI应该只有小李本人的权限,不能更多。
场景二:HR系统的AI助手
员工小王问:"查查我这个月工资多少。"这时:
AI自动接收请求
AI要调用HR系统
AI查询工资数据库
AI把结果返回给小王
关键问题:这个HR AI不应该是能查所有人工资的"超级管理员",而应该在处理小王的请求时,只能看小王自己的工资。
换句话说,同一个AI软件,在处理不同员工请求时,需要有完全不同的访问权限。这正是传统OAuth令牌表达不了的。
合规压力很大
《个人信息保护法》明确要求"最小必要原则"——只能访问必需的最少信息。如果AI因为身份管理缺陷拿到了过多权限,企业就得担合规风险。
《数据安全法》要求对数据访问行为进行审计。如果搞不清"AI代表哪个具体用户在访问数据",审计日志就没用了,出了事都查不清楚。
二、AI身份管理的三大漏洞
CrowdStrike研究团队指出,当前OAuth令牌在AI场景下有三个关键信息缺失。
漏洞一:缺少AI实例的身份标识
传统OAuth能识别客户端,比如:
client_id = hr-ai-agent
client_name = 企业HR智能助手
系统知道"这是HR AI发起的请求"。
但问题是,同一个AI应用可能同时跑好几个完全独立的任务。比如Claude Code可能同时在:
为用户A重构支付模块
为用户B分析安全漏洞
为用户C生成测试用例
这三个任务用的是同一个软件,但代表完全不同的工作上下文,权限应该完全隔离。
现在OAuth标准里没有规范化的字段来描述:这次具体跑的是哪个AI任务实例?
缺了实例级身份,企业就没法精确追踪每个具体AI任务的行为。
漏洞二:缺少用户身份的标准表达
如果OAuth令牌只发给AI客户端,系统能知道"AI获得了权限",但不知道"AI当前代表谁在干活"。
还是那个HR AI的例子:它被授权访问工资数据库。当它发起查询时,数据库系统懵了:
是AI自己要看全部工资数据吗?
是AI代表张三查张三的工资吗?
是AI代表李四查李四的工资吗?
系统要是区分不了这三种情况,就只能粗暴授权。
最后往往是:为了保证AI能完成任务,不得不给它远超需要的访问权限。这直接违背了最小权限原则,安全风险敞口巨大。
漏洞三:缺少委托关系的描述
即使系统同时知道"AI是谁"和"用户是谁",还缺一个关键信息:两者是什么关系?AI为啥能代表这个用户?
不同的委托关系意味着完全不同的授权逻辑:
委托类型一:直接用户授权
开发人员明确说:"用我的GitHub账号,帮我在项目里创建新分支。"→ AI是用户的直接代理工具,执行用户明确指定的任务。
委托类型二:企业流程自动化
企业部署的财务报销AI,按既定规则自动处理员工的报销申请。→ AI不是某个员工的私人助手,而是企业业务流程中的自动化角色。
委托类型三:系统服务调用
企业安全中心的AI,自动分析安全告警并调用安全工具执行响应。→ AI作为系统级服务主体,不直接代表某个具体用户。
这三种关系授权逻辑完全不同,但现在OAuth令牌没有标准方式来表达这种差异。下游系统没法根据委托类型动态调整访问控制,只能"一刀切"授权。
三、真实风险:同一个AI可能导致越权访问
来看一个实际场景。
案例:电商平台的客服AI
某大型电商平台部署了智能客服AI,处理订单查询、物流追踪、退换货等。这个AI连接了:
CRM客户关系管理系统
订单管理数据库
物流追踪系统
用户账户系统
正常业务:客户A问:"我的订单啥时候发货?"AI需要:识别客户A身份 → 查客户A的订单 → 获取物流状态 → 返回发货时间
理想情况下,AI只应该看到客户A的订单,不应该看到客户B、C或其他任何人的订单。
身份管理缺陷导致的问题
如果系统只能识别出:
client_id = customer-service-agent
scope = read:orders, read:logistics
系统只知道"这是客服AI"和"它被授权读订单和物流",但不知道"当前这次请求在处理哪个客户的问题"。
企业就面临两难:
选择一:给AI访问所有客户订单的权限
优点:AI能完成所有客户的服务请求
缺点:严重违反最小权限原则,一旦AI被黑或程序有漏洞,可能导致大规模数据泄露
选择二:严格限制AI权限
优点:降低数据泄露风险
缺点:AI可能没法完成基本业务,影响客户服务
这就是缺乏精细化身份管理的典型困境。
审计追溯也成问题
审计日志里看到:
[2026-10-13 14:32:18] customer-service-agent 访问订单数据库
[2026-10-13 14:32:19] 查询订单 order_id=202610130001
这条日志回答不了关键问题:
这次访问是AI自主行为还是响应客户请求?
代表哪个客户执行的查询?
是否存在越权访问?
要是发生数据泄露,企业很难完成有效溯源和责任认定。
四、AI的四种运行模式与风险递增
从身份安全角度,AI Agent可以分为四种运行模式,复杂度逐级提升。
模式一:交互式(Interactive)
用户直接与AI实时交互,逐步给指令。比如在ChatGPT里输入:"帮我写封商务邮件",AI立即生成供你审阅。
这种模式下:
用户始终在线参与
每步操作都能得到用户确认
用户可以随时中止
身份管理相对简单,因为用户与AI的关系始终清晰。
模式二:离线式(Offline)
用户启动任务后离开,AI在后台自主完成。
例如:数据分析师说:"分析这批客户数据,明天上班给我报告。"然后下班走人,AI在夜间自动跑数据处理。
这时:
用户不再实时参与
AI需要自主完成多个中间步骤
AI可能要访问多个不同系统
身份管理重要性显著提升。系统必须明确记录:这个后台跑的AI任务代表哪个用户启动的,权限应该继承该用户的边界,不应该有超出该用户职责范围的访问能力。
模式三:自动化式(Automated)
AI完全自主运行,无需用户逐次触发。
典型场景是企业安全运营AI:
持续监控安全告警
自动分析威胁情报
创建安全调查任务
调用防火墙、EDR等工具执行响应
这类AI接近"数字员工"角色。它不再是某个用户的工具,而是企业业务流程中的独立执行主体。
身份管理成为核心安全问题:
AI应该有怎样的系统权限?
AI的行为是否符合企业安全策略?
如何防止AI被恶意利用执行未授权操作?
模式四:传递式(Transitive)
一个AI在执行任务时调用其他AI,形成调用链。
例如:企业客服AI处理复杂投诉时:
1. 调用数据分析AI,分析客户历史行为
2. 调用知识库检索AI,查找解决方案
3. 调用工单系统AI,创建跟进任务
4. 调用邮件发送AI,向客户发送通知
这种模式会进一步放大身份安全风险,因为每次AI间调用都涉及:
权限的传递与继承
身份上下文的延续
责任链的追溯
如果身份信息在调用链中丢失或被错误解析,就容易产生"混淆代理问题"——一个高权限组件被低权限主体利用,执行了超出授权范围的操作。
五、最大威胁:混淆代理问题
什么是混淆代理问题
混淆代理问题(Confused Deputy Problem)是信息安全领域的经典攻击模式:一个拥有较高权限的中间组件(代理),被权限较低的主体诱导,从而执行了超出请求者实际授权的操作。
传统案例:
用户A只能读自己的文件
系统管理程序能读所有文件
用户A向管理程序提交请求,诱导它读用户B的文件
如果管理程序只检查"请求者是合法用户"而不检查"请求者是否有权访问目标资源",就会导致越权访问
AI场景中的混淆代理风险
场景示例:企业文档管理AI
某企业有个智能文档管理系统,AI帮员工检索和总结内部文档。
员工C只能访问市场部文档
文档管理AI能访问所有部门文档(因为它要服务所有员工)
员工C问AI:"总结公司最新产品研发计划"
如果系统只验证:
1. 员工C是合法用户 ✓
2. AI有权访问文档 ✓
而没有验证:
3. AI当前代表员工C执行任务 ✗
4. 员工C本人是否有权访问产品研发文档 ✗
那么AI可能会访问研发部机密文档并返回给员工C,形成数据泄露。
系统混乱的后果
CrowdStrike研究指出,当OAuth令牌缺少标准化身份信息时,不同系统会采取不一致的处理方式:
有些从HTTP请求头找用户身份
有些靠应用层自定义字段
有些完全忽略AI身份,只关注用户
有些只验证AI身份,忽略背后的用户
有些直接把AI与用户身份搞混
这种混乱直接导致:企业不得不采用粗粒度权限控制,给AI远超实际需要的访问权限,埋下安全隐患。
六、企业应对策略
最佳实践一:建立"三位一体"身份识别
未来的AI访问控制体系,必须同时明确回答三个问题:
1. Agent身份:哪个AI在执行任务?
AI的应用类型(HR助手、客服Agent、开发工具等)
AI的具体实例标识(任务ID、会话ID、执行上下文)
AI的版本和部署位置
2. 用户身份:AI代表谁行动?
实际用户的员工ID或客户ID
用户所属组织单元(部门、团队)
用户的角色和职责范围
3. 委托关系:AI为啥能代表这个用户?
直接用户授权(用户主动委托AI执行特定任务)
企业流程委派(企业部署的自动化流程)
系统服务调用(AI作为系统级服务主体)
只有这三个维度信息完整结合,才能支撑精细化访问控制。
最佳实践二:实施动态权限控制
原则一:AI权限 ≤ 用户权限
当AI代表用户执行任务时,访问权限不应超过该用户本身的权限。
原则二:实施任务级权限隔离
不同AI任务实例应该有相互隔离的权限上下文,避免权限泄露和任务间干扰。
原则三:建立审批与监控机制
对高敏感操作(数据导出、系统配置变更、财务操作等),即使AI和用户都有权限,也应引入额外审批或实时监控。
最佳实践三:构建可追溯审计日志
完整的审计日志应该记录:
时间戳: 2026-10-13 14:32:18
Agent标识: customer-service-agent-instance-7f3a2b
用户标识: employee_id=10086, name=张三, department=客服部
委托关系: 企业流程自动化
操作行为: 查询订单数据
目标资源: order_id=202610130001, customer_id=500234
操作结果: 成功返回订单状态
风险等级: 正常
这样的日志可以支持事后溯源、异常检测、合规审计和安全调查。
最佳实践四:部署AI行为监控
企业应该建立专门针对AI的安全监控:
监控维度一:权限使用模式
AI是否访问了超出任务范围的资源?
数据访问量是否异常?
是否尝试访问被拒绝的资源?
监控维度二:行为模式异常
调用频率是否异常?
是否在非工作时间执行敏感操作?
任务执行流程是否偏离预期?
监控维度三:调用链分析
AI调用链是否存在异常深度?
是否存在循环调用风险?
权限在调用链中的传递是否合规?
七、行动建议:分阶段建设路线图
第一阶段:评估现状(1-2个月)
盘点现有AI Agent部署情况
识别每个Agent访问的系统和数据
评估当前权限配置
检查身份管理缺陷
评估合规风险
第二阶段:试点实施(3-6个月)
制定企业AI Agent身份管理规范
选择1-2个高敏感场景(如HR、财务)进行试点改造
部署支持扩展身份信息的令牌机制
改造后端资源系统访问控制逻辑
实施增强审计日志
部署AI行为监控
第三阶段:全面推广(6-12个月)
推广到所有AI Agent应用
建立持续监控和优化机制
定期审查Agent权限配置
持续优化异常检测规则
加强人员培训和意识提升
第四阶段:持续优化
参与行业标准制定
分享最佳实践
持续技术创新
结语:重新定义"身份"
AI Agent正从实验室走向企业核心业务,从简单工具变成自主决策的数字工作主体。这给企业带来价值的同时,也对传统身份安全体系提出了根本挑战。
当AI访问企业核心数据时,系统必须清楚回答:谁在调用?代表谁调用?为什么可以调用?
这不只是技术问题,更是企业安全治理的基础。缺乏精细化身份管理,企业将面临数据泄露、越权访问、审计失效等风险,也难以满足严格的合规要求。
对中国企业来说,在《网络安全法》《数据安全法》《个人信息保护法》的监管环境下,建立完善的AI Agent身份安全体系不是可选项,而是必答题。
AI Agent时代的安全建设,不只是限制Agent能做什么,更重要的是明确Agent到底是谁。只有建立清晰、标准化的身份表达机制,企业才能真正实现精细化授权、可信审计、风险检测和安全扩展。
从"人访问系统"到"Agent代人访问系统",这是技术架构的演进,更是安全范式的重构。身份安全正在成为AI时代企业安全建设的基础设施,也将成为未来AI安全竞争的核心能力。
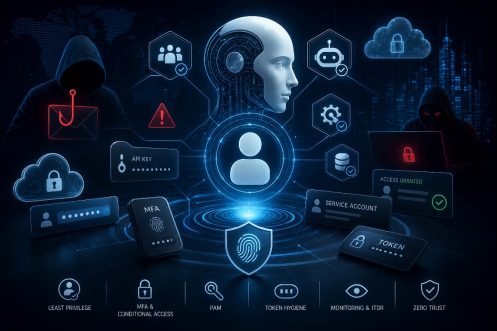
中国企业需要立即行动:评估现状、识别风险、建立标准、试点实施、全面推广。只有前瞻布局,才能在AI浪潮中既享受技术红利,又确保安全合规。
AI Agent正在重塑企业数字化未来,而身份安全,正是这一未来的坚实基石。
相关阅读
联系我们
合作电话:18610811242
合作微信:aqniu001
联系邮箱:bd@aqniu.com
本文转载自微信公众号「安全牛」,查看原文。版权归原作者所有,如有侵权请联系删除。