看懂、听懂,还要找准:OmniCompass评测50个MLLMs的全模态视频定位与理解能力
原创 52CV 2026-10-25 23:29 江苏
作者简介:本文第一作者为香港理工大学VC Lab博士生刘旭洋,通讯作者为IEEE Fellow、香港理工大学讲席教授、OPPO研究院AI科学家张磊教授。实验室VC Lab长期关注计算机视觉、多模态、图像复原、生成模型与端侧落地,多项成果已落地数款OPPO旗舰机型。
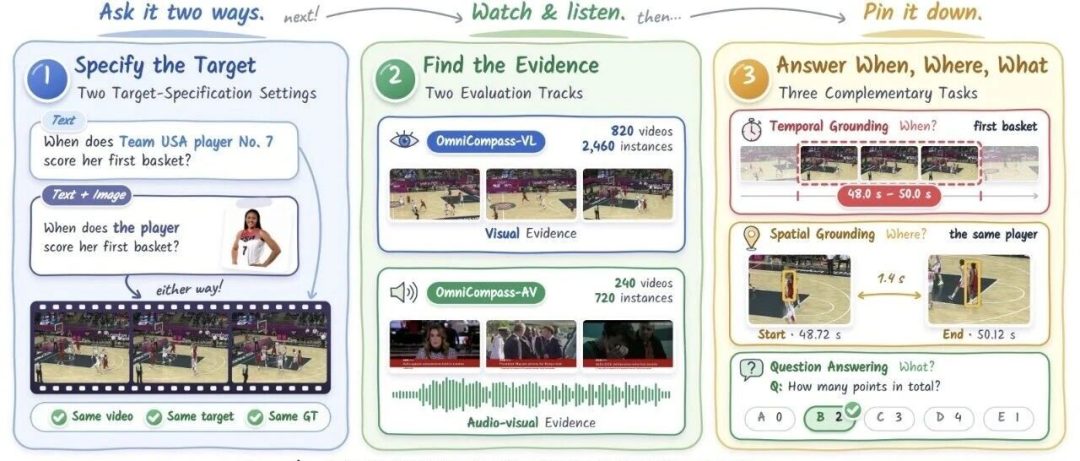
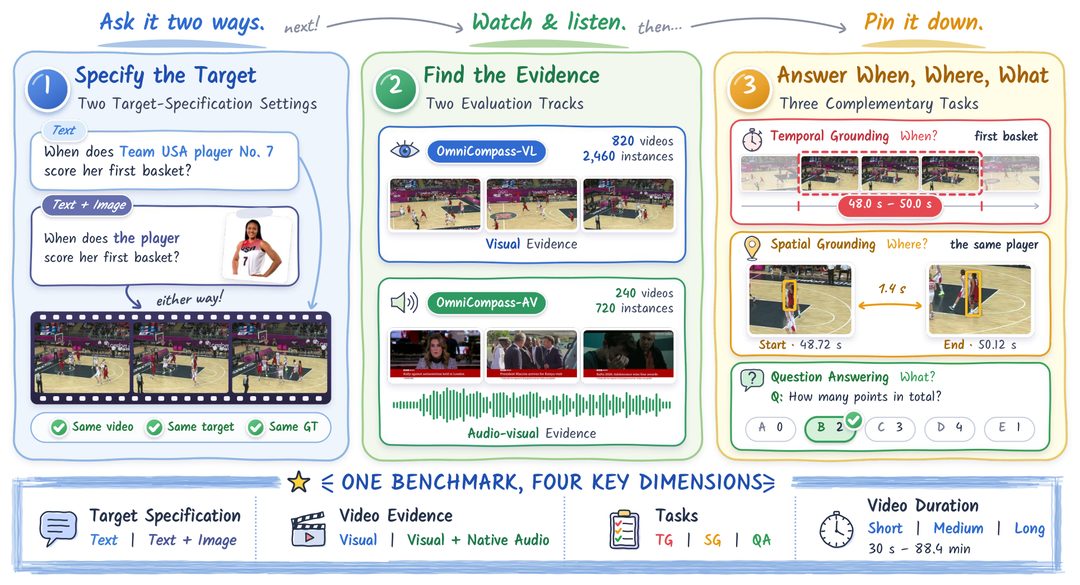
给模型一段篮球比赛视频,问它:“美国队7号球员第一次得分发生在什么时候?”再附上一张球员照片,把问题改成“这位球员第一次得分发生在什么时候?”
视频没变,要找的人没变,正确的时间段也没变。模型能两次都找对吗?如果继续要求它框出球员的位置,或者判断这名球员一共得了几分,它的表现还会一样好吗?
香港理工大学 VC Lab、OPPO 研究院等机构的研究团队提出了 OmniCompass,一个面向全模态视频定位与理解的综合评测基准。团队投入约1,800人工小时,围绕820个视频构建任务标注,并评测了50个主流多模态大语言模型(MLLMs)的任务表现与跨指代一致性。
评测发现,模型在视频问答上已经能拿到不错的分数,精确时空定位仍有明显短板;图像参考并不总能带来提升;开源与闭源模型的差距,在音视频轨道上尤其突出。
标题:OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
评测定位与基准对比
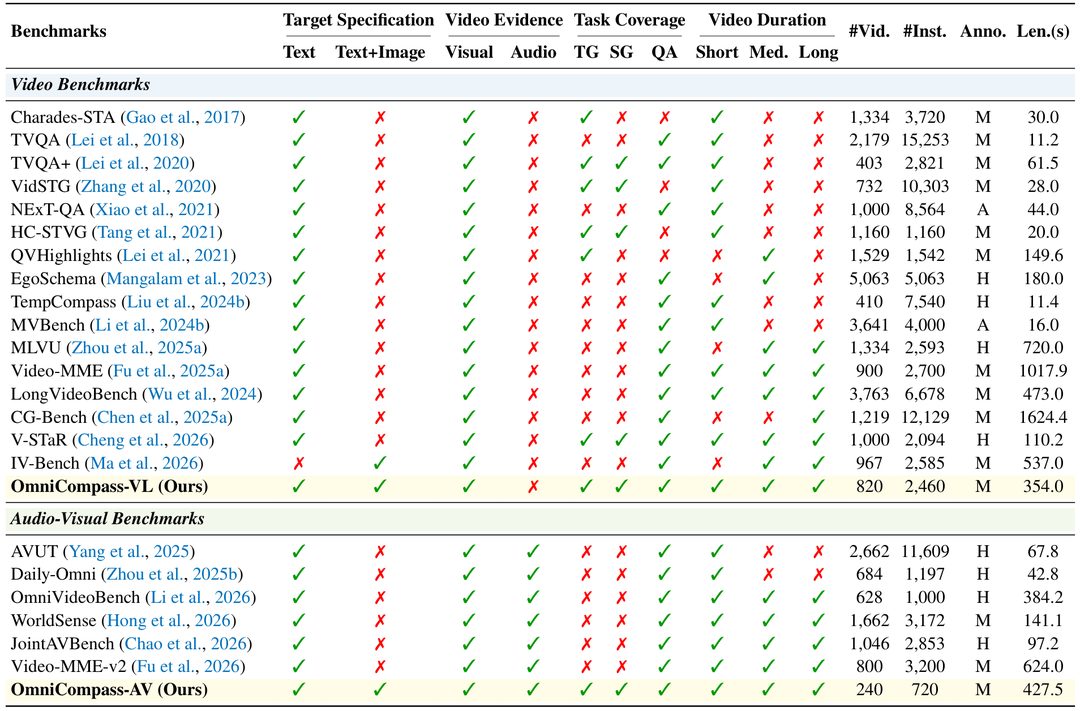
已有视频基准从不同侧面检验模型能力:Video-MME、LongVideoBench等侧重视频问答,Charades-STA等关注时间定位,V-STaR同时评测时间定位、空间定位和问答;Daily-Omni、OmniVideoBench等进一步考察音视频理解。目标如何指明、模型能使用哪些证据、需要输出什么,以及视频有多长,决定了各个基准实际测到的能力。
OmniCompass把这些维度放在同一套评测协议中:同一目标同时提供纯文本和图文两种指代,分别设置依赖视觉证据的VL轨道、需要原生音频的AV轨道,并在短、中、长视频上统一评测TG、SG和QA。这样既能比较任务成绩,也能追问换一种指代后,模型是否还能认对目标、找准证据。
数据标注
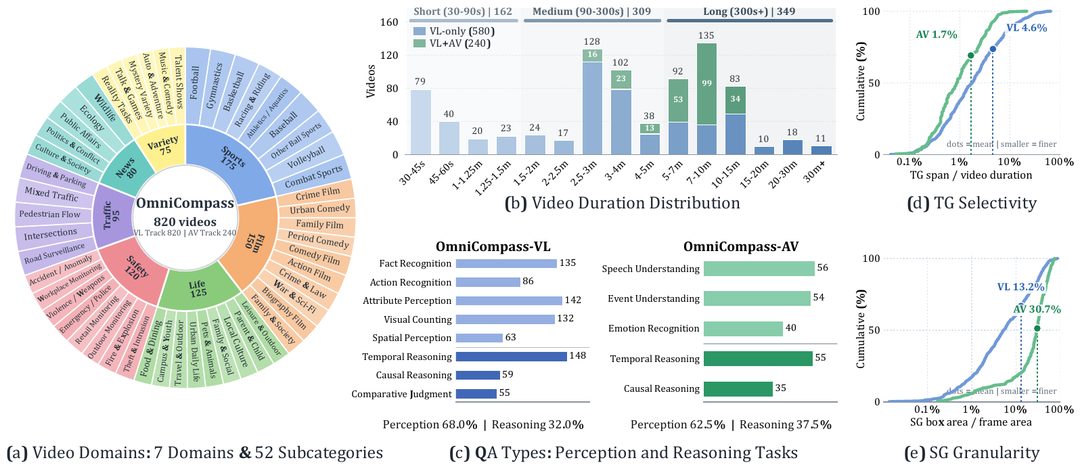
OmniCompass包含820个视频,覆盖体育、交通、公共安全、生活、影视、综艺和新闻7个大类、52个小类。视频总时长80.6小时,最短30秒,最长88.4分钟,包含短视频162个、中视频309个、长视频349个。
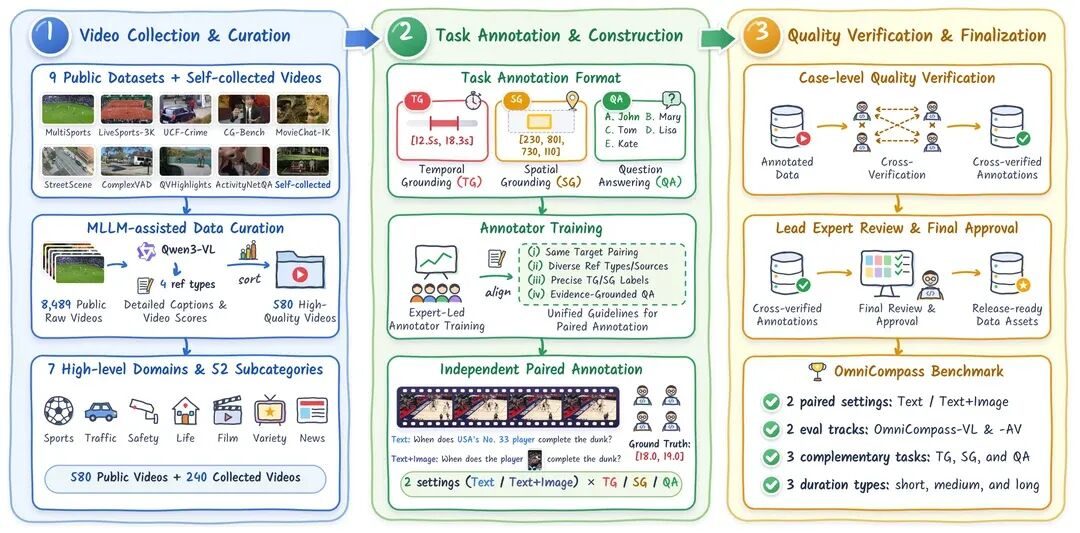
基准设置了两条互补轨道。OmniCompass-VL包含820个视频、2,460个任务实例,题目依赖视觉证据;OmniCompass-AV从中选取240个视频,额外构建720个需要结合原生音频的任务实例,考察模型能否把声音与画面中的人、动作和事件对应起来。
两条轨道都覆盖三项任务:时间定位(TG)要求模型给出目标事件的起止时间;空间定位(SG)给定相关时间区间,要求模型在起止两帧中框出目标;视频问答(QA)要求模型依据视频证据,从五个选项中选出正确答案。
每道题都有纯文本(Text)和图文结合(Text+Image)两种目标指代。例如,“美国队7号球员”可以改成配有照片的“这位球员”。两种版本共享视频、目标、任务语义和标准答案,用来检验模型换一种指代后,是否还能找到同一份证据。
数据构建从视频筛选开始。团队汇集9个公开数据集中的8,489个候选视频,使用模型辅助整理内容线索、筛选和排序,再经人工复核选出580个视频,与240个自行收集的影视、综艺和新闻视频共同组成最终数据集。
全部任务标注均由人工完成。 4名标注员经过专家培训和试标校准,逐一构造两种指代版本、时间区间、空间框、问答选项及其证据,再交叉检查,最后由负责人复核、修订和验收。约1,800人工小时覆盖了培训、标注、交叉复核、返修和最终审核。
审核需要逐项确认:文字和图片是否指向同一个目标,时间段是否完整覆盖目标事件,边界帧中的框是否找对人或物,五个选项是否只有一个得到视频证据支持,以及AV题目是否确实需要用到声音。参考图也要能帮助辨认目标,同时避免直接暴露答案。
数据分布兼顾场景、视频时长和问题类型。52个视频小类各有10至43个视频;VL的8类QA每类有55至148题,AV的5类QA每类有35至56题。感知与推理问题在两条轨道中均有覆盖。
定位标注保留了细粒度要求。VL轨道中的目标时间段平均只占视频时长的4.6%,空间框平均占画面的13.2%;AV轨道中的目标时间段平均只占1.7%。面对几十秒甚至几十分钟的视频,模型需要找到的事件可能只持续片刻。
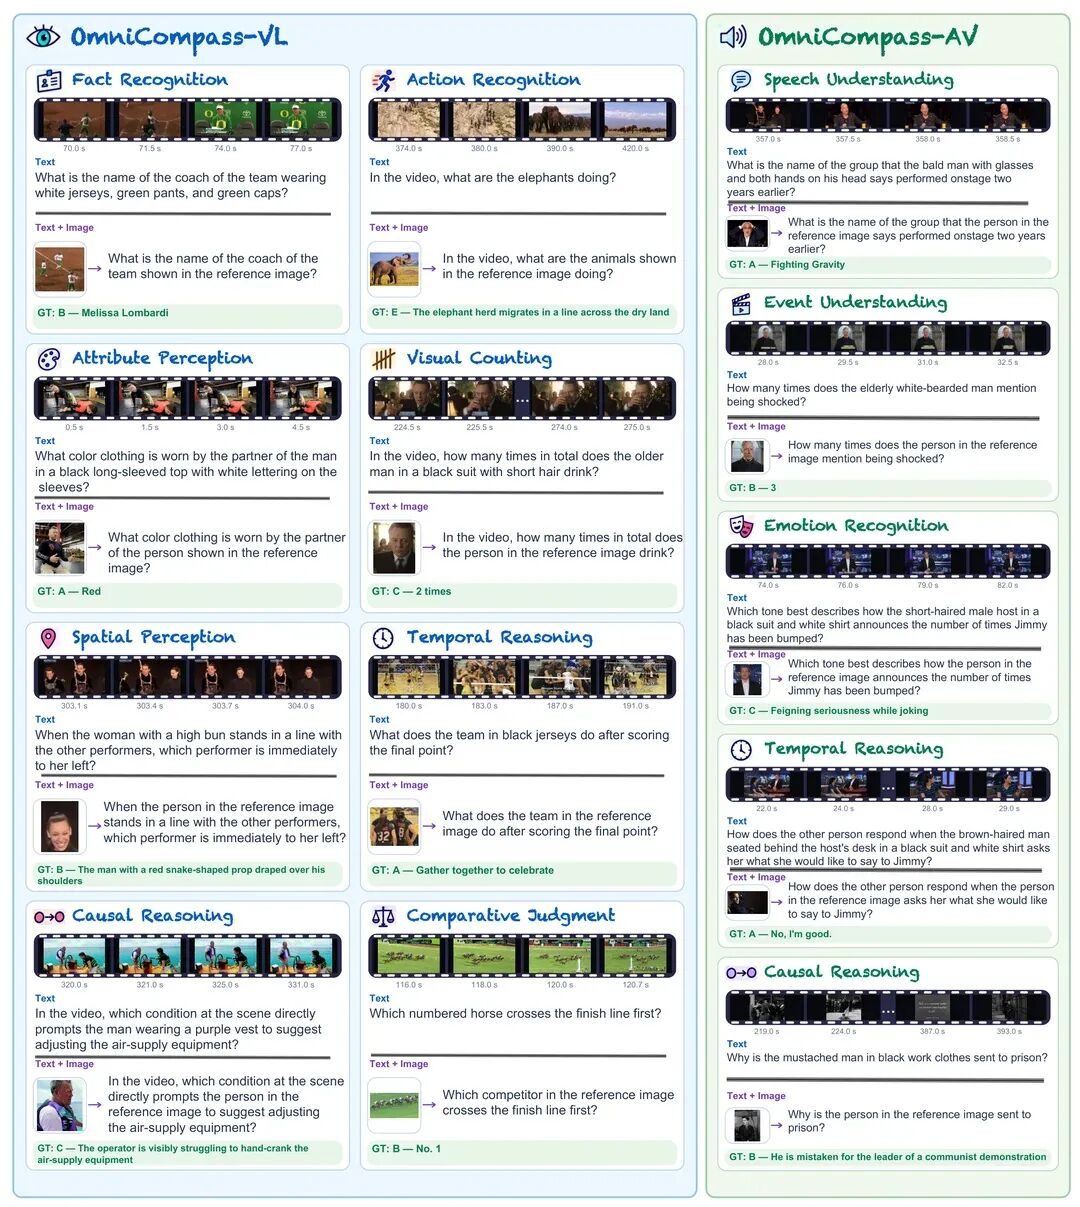
QA进一步细分了模型需要完成的判断。VL覆盖事实识别、动作识别、属性感知、视觉计数、空间感知、时间推理、因果推理和比较判断8类;AV覆盖语音理解、事件理解、情绪识别、时间推理和因果推理5类。每一类都给出配对指代和可核查的答案证据,便于分析模型究竟在哪类问题上出错。
模型评测
团队共评测50个不同模型,其中36个参加VL评测,17个参加AV评测,部分模型同时出现在两条轨道中。评测同时报告两种指代下的任务成绩,以及跨指代一致性分数CS(Cross-Specification Consistency Scores)。
CS联合衡量任务正确性与两种指代下的预测一致性。对于QA,同一道题只有在两种版本中都回答正确,才计入CS;对于TG和SG,分数同时考虑两次预测各自与标准答案的重合程度,以及两次预测之间的重合程度。综合CS取三项任务CS的平均值,用于比较模型在配对条件下的整体表现。
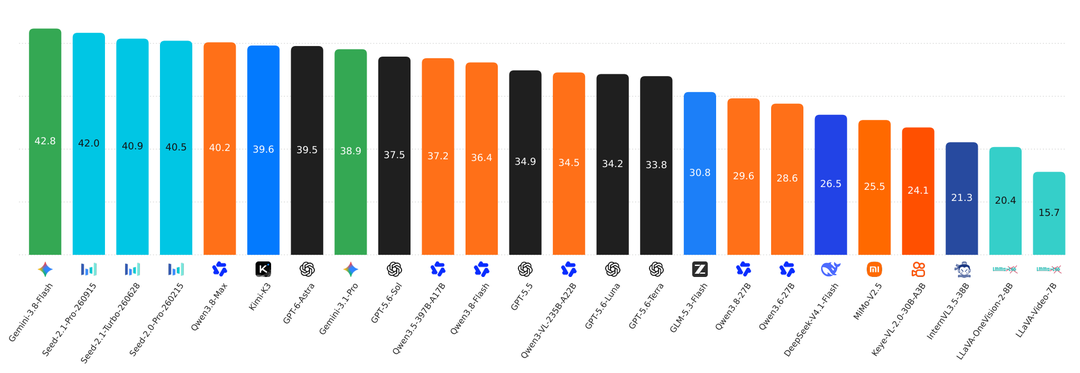
按综合CS排名,OmniCompass-VL的闭源前两名为Gemini-3.8-Flash(42.8%)和Seed-2.1-Pro-260915(42.0%);开源前两名为Kimi-K3(39.6%)和Qwen3.5-397B-A17B(37.2%)。
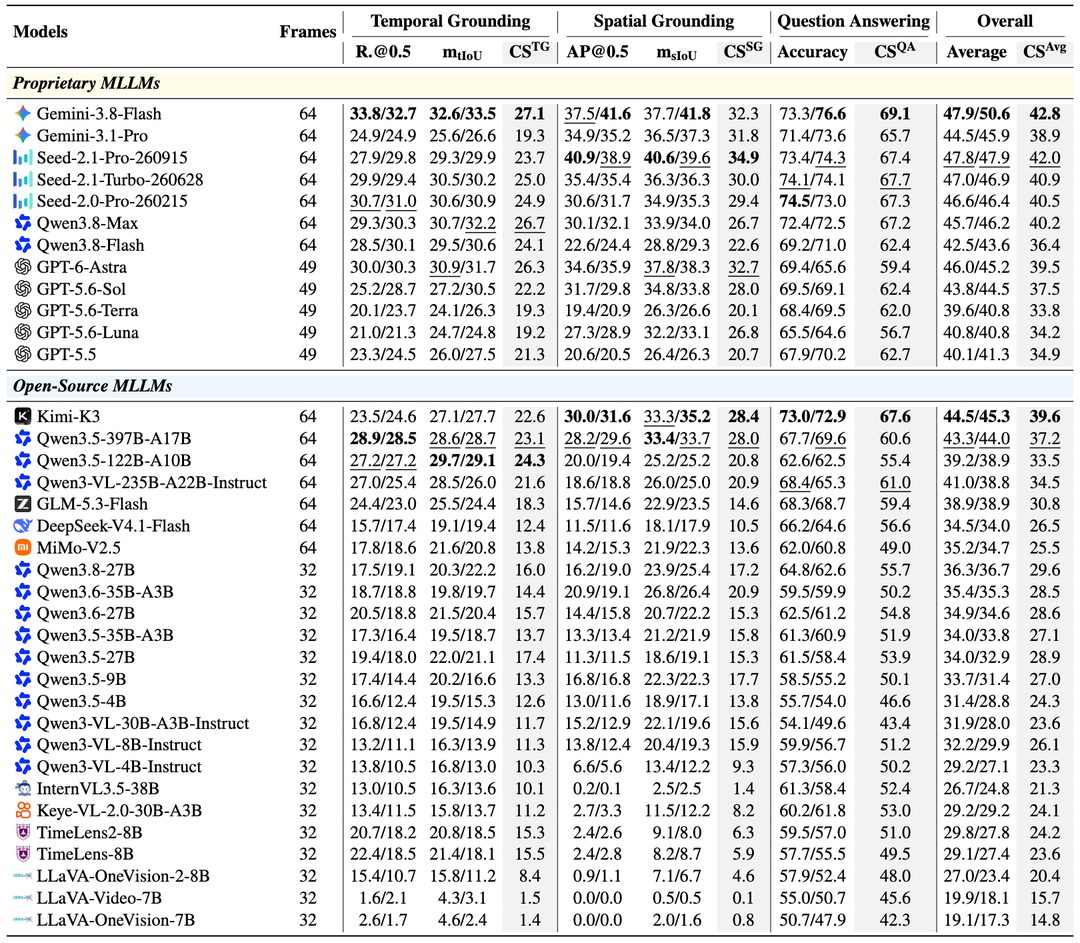
在OmniCompass-AV上,闭源前两名是Gemini-3.8-Flash(57.4%)和Qwen3.8-Omni-Flash(48.6%);开源前两名是MiMo-V2.5(24.6%)和Qwen3-Omni-30B-A3B(22.9%)。
闭源与开源榜首之间的差距,在VL上为3.2个百分点,在AV上达到32.8个百分点。音视频轨道对跨模态理解与定位提出了更高要求。参与AV评测的10个开源模型,时间定位CS均不超过3.5%,将声音与具体事件的时间边界对应起来仍然很难。
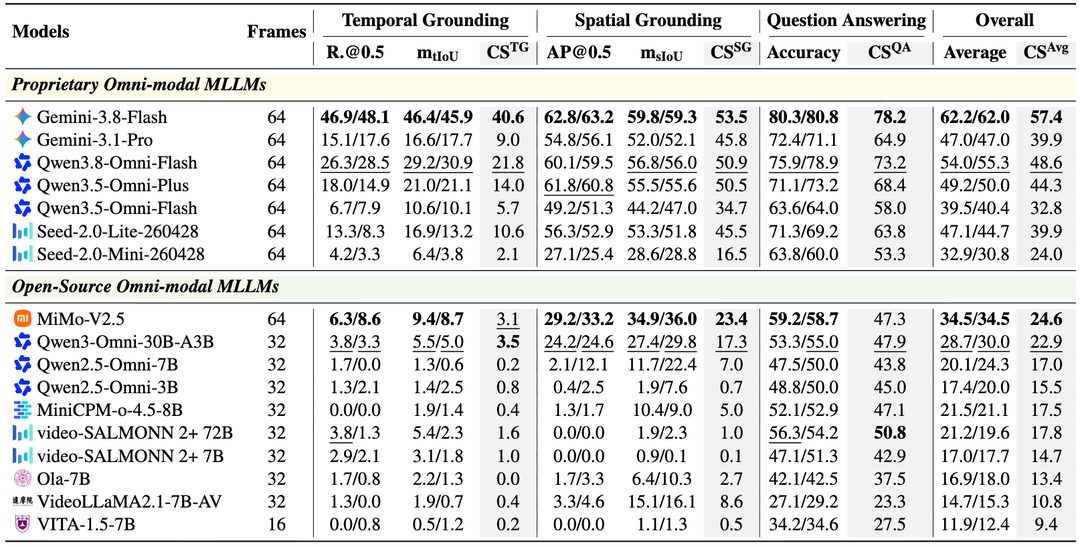
上述成绩对应论文给定的输入预算:大部分闭源模型及超过100B的开源模型使用64帧,其余多数模型使用32帧,GPT系列和VITA另有输入限制。排名需要结合表中的帧数阅读;VL与AV的题目和证据要求也不同,二者分别比较各自轨道内的表现。
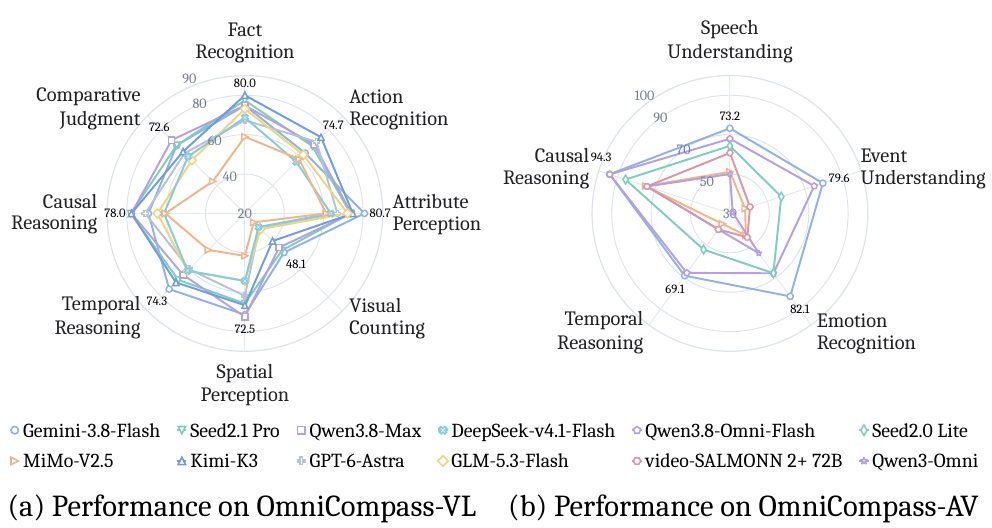
分任务看,VL轨道上36个模型中有29个的问答CS超过50%,最高达到69.1%;时间定位CS的最高值为27.1%,空间定位为34.9%。进一步拆开QA类别,图中8个VL模型的最低分都出现在视觉计数,得分为26.4%至48.1%;AV的6个模型中有5个在时间推理上得分最低。较高的问答总分仍可能掩盖某一类问题上的短板。
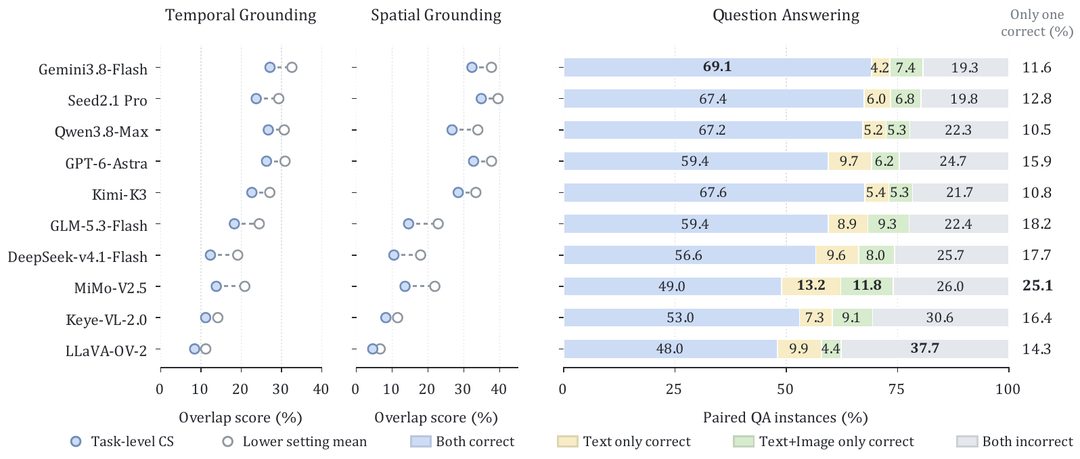
视觉参考的效果也因任务而异。Qwen3.8-27B从Text切换到Text+Image后,时间定位和空间定位平均IoU分别提高1.9和1.5个百分点,问答准确率却下降2.2个百分点。这里的参考图替代了部分文字描述,实验考察的是模型使用不同指代找到同一目标的能力。
配对评测还揭示了总分接近时容易被忽略的问题。Kimi-K3在VL问答的Text与Text+Image条件下分别取得73.0%和72.9%的准确率,两种指代下都答对的比例却只有67.6%。对应的808对题目中,有87对只在其中一种指代下回答正确。
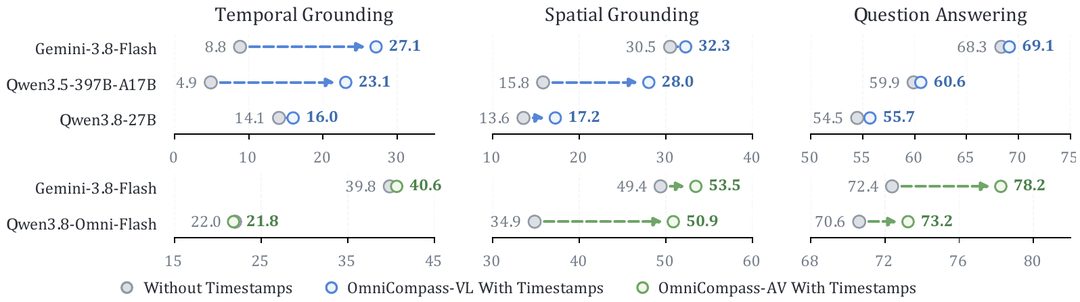
消融实验首先检验了帧级时间戳的作用。 在论文测试的5组模型与轨道配置中,加入时间戳后,综合CS全部提高,15项任务比较中有14项提升。VL和AV的平均综合增益分别为6.5和4.9个百分点;Gemini-3.8-Flash与Qwen3.5-397B-A17B在VL时间定位上的增益分别达到18.3和18.2个百分点。
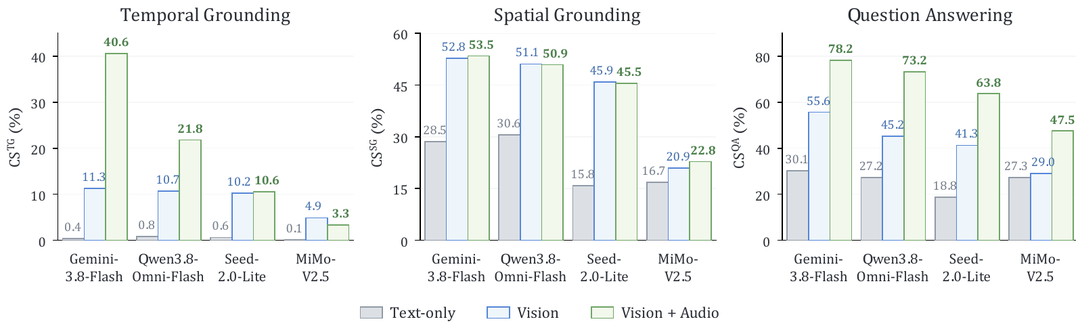
输入模态对照实验比较了仅文本、视觉和视觉加音频三种条件。 给4个受测模型加入音频后,问答CS全部提高,平均增益为22.9个百分点;定位收益却因模型而异,MiMo-V2.5的时间定位CS下降了1.5个百分点。听到声音有助于回答问题,把声音对应到准确的时间段和画面位置仍需更强的跨模态对齐能力。
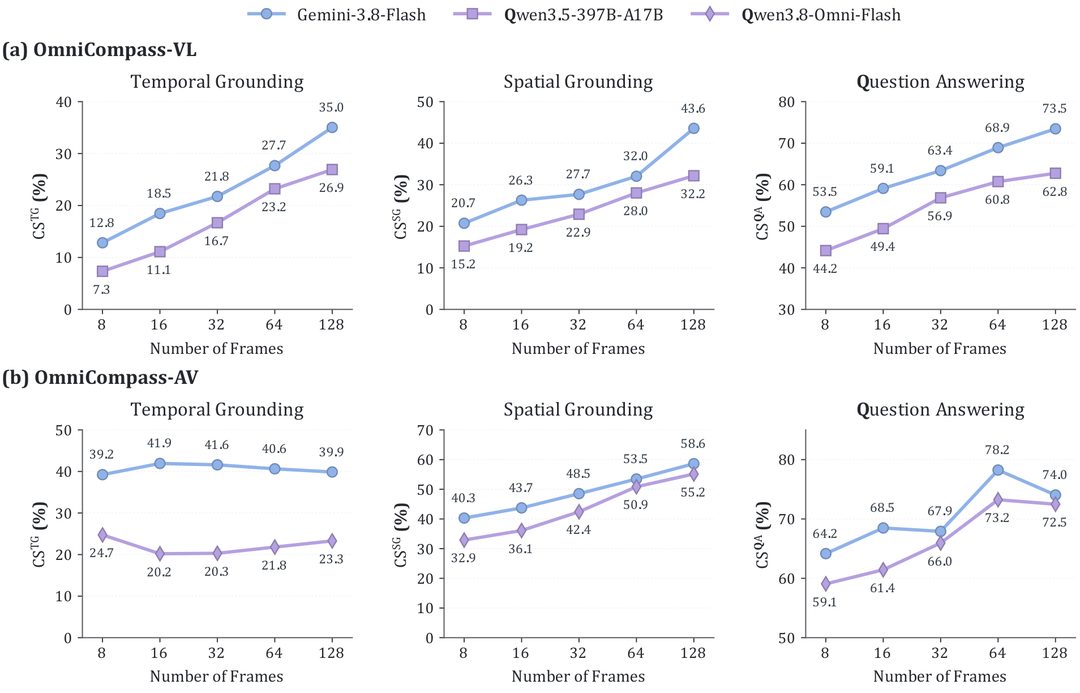
帧数也会影响成绩。将均匀采样预算从8帧增加到128帧后,受测模型在VL的三项任务上均有提升;AV的空间定位和问答总体受益,时间定位变化较小。更多帧带来更充分的视觉信息,也增加了输入和推理成本,因此成绩需要连同帧预算一起解读。
结论
精确时空定位与细粒度感知仍是模型短板,视觉计数、时间推理等问题需要单独检验。
开源与闭源模型的差距在音视频轨道上尤为突出,声音与画面中具体事件的对应仍然困难。
视觉参考的收益取决于模型和任务;从Text切换到Text+Image后,VL轨道仅11个模型的单一设置平均分提高。
单一指代下的高分不保证跨指代的一致正确,配对评测能揭示总分掩盖的样本级变化。
时间戳普遍改善受测模型的表现;增加音频和视频帧数的收益,则取决于任务与模型。
OmniCompass将目标指代、视觉与音频证据、时空定位和问答放到同一套评测中,让模型的能力差异可以落到具体问题:有没有认对目标,能否找到事件的准确时间和位置,以及换一种指代后能否继续答对。论文、数据和评测代码已公开,欢迎使用OmniCompass评测更多模型。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。